现在评价一个大模型,最容易看到的是榜单分数、发布会演示和几段精心挑选的对话。
这些信息当然有用,但它们很难直接回答一个更现实的问题:
当我把一个完整任务交给模型,不再逐步教它怎么做,最后能不能拿到一个真正可用的结果?
这也是我做这次评测的原因。
我给 14 个模型布置了同一个任务:
创建一个html,设计并实现一个3D 波音747飞机模型,要可以切换不同的涂装
没有额外拆分任务点,也没有规定必须采用哪种前端框架。每个模型都需要自行理解需求、选择实现方式、完成文件并判断任务是否结束。每次运行的 Token 上限统一为 2,000,000。
最终结果的分差很大:最高 95 分,最低 10 分。
但这次评测最值得讨论的,不是某个模型拿了第一,而是同一句需求经过不同模型之后,竟然变成了完全不同层级的产品。它们之间的差距,让“为什么要评测大模型”这件事变得非常具体。
为什么选择一架 3D 波音 747
这道题看起来只是做一个网页,但它同时考验了几种不能轻易用文字包装掩盖的能力。
首先,模型要理解什么是波音 747。
页面标题写着“747”并不够。前部驼峰、四台翼下发动机、后掠主翼、尾翼和宽体机身,共同构成了这架飞机最基本的识别特征。只要缺少几个关键部分,或者比例和装配明显错误,最终成品就很难让人相信它是一架 747。
其次,模型要把这种理解变成真正的空间结构。
一张静态图片可以挑选最有利的观察角度,但一个可旋转的 3D 模型不行。用户把飞机转到正面、侧面或底部之后,机头是否封闭、机翼方向是否正确、发动机是否挂在合理位置、零件是否互相穿插,都会直接暴露出来。
再次,它还要完成真实交互。
题目要求切换涂装。按钮文字从“经典蓝”变成“夕阳红”不算完成,必须能够看到机身、尾翼、图案或材质实际发生变化。旋转、缩放、视角和重置等功能,也必须在操作后产生真实反馈。
因此,这不是一道单纯的代码题,也不是一道单纯的审美题。它同时涉及需求理解、空间关系、程序实现、交互设计和完成判断。
正因为结果可以被实际打开、旋转和操作,这道题也很适合检验模型究竟是在“描述完成”,还是在“真正完成”。
评测不能只看模型怎么说
14 个模型在完成任务时,几乎都会给出一份看起来很专业的交付说明。
常见的表述包括“高精度建模”“生产级实现”“完整起落架”“真实物理光影”“多套经典航司涂装”。如果只阅读这些说明,很容易认为多数模型都完成得相当不错。
但模型的自述不是验收结果。
这次我把 14 份入口全部放进真实浏览器中加载,并逐个检查最终画面、不同观察角度、涂装变化、交互反馈和控制台错误。评分分为五项:
- 可运行性:20 分。
- 747 识别与几何准确性:25 分。
- 涂装功能:20 分。
- 视觉渲染:20 分。
- 真实交互:15 分。
代码量、按钮数量、界面是否华丽,都不作为独立得分依据。Three.js 不会因为是现成框架而被扣分,原生 WebGL 也不会因为更底层而自动加分。最终比较的始终是用户真正拿到的产物。
这也是我认为真实任务评测最重要的一步:
大模型可以非常流畅地描述一个它并没有真正做成的产品,所以评测必须从阅读回答,走向验收结果。
同一道题,模型交出了四种不同层级的答案
如果不急着看完整排行榜,而是从任务完成程度观察,这 14 份作品大致呈现出四种不同结果。
第一种:核心目标真正成立
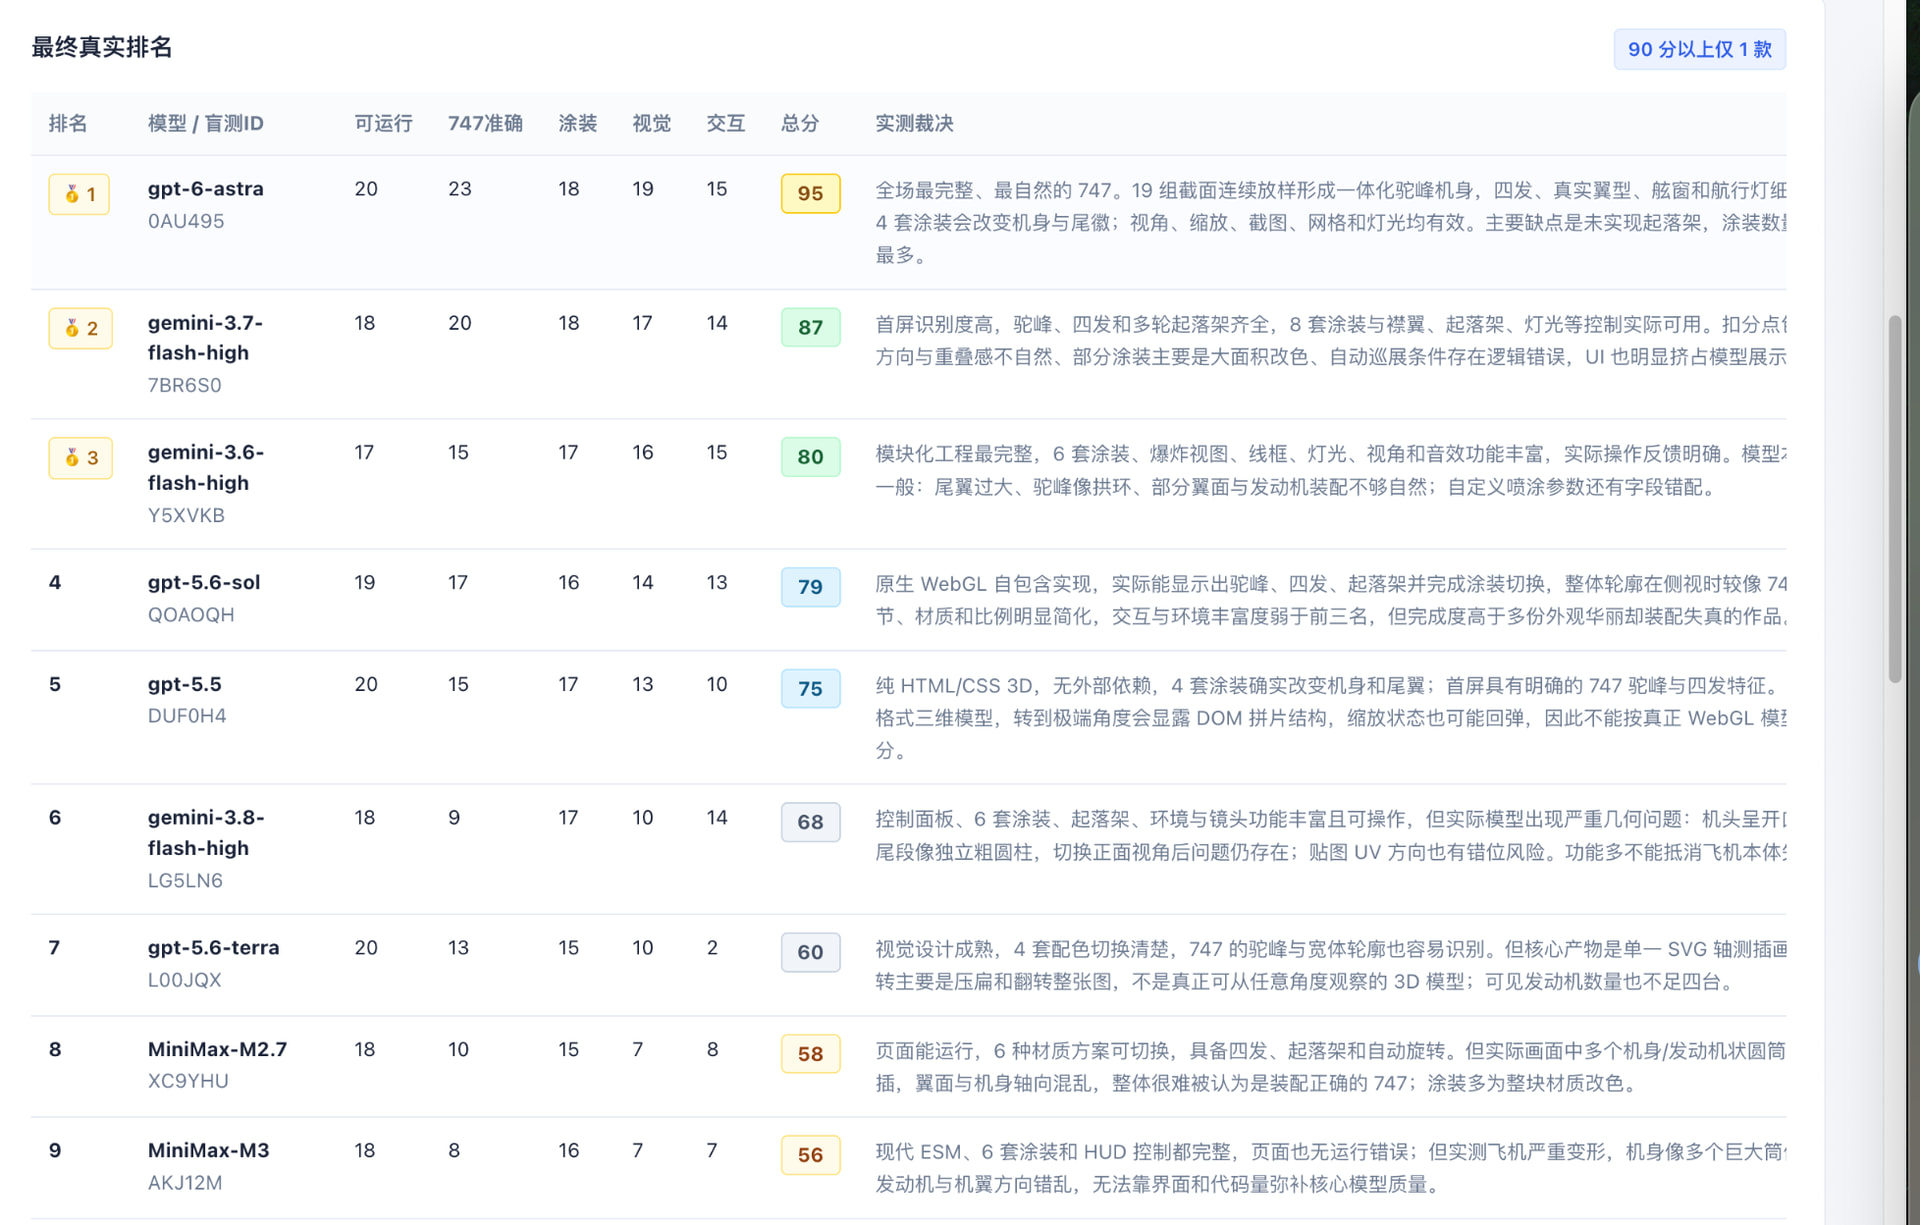
本次第一名是 gpt-6-astra,盲测 ID 为 0AU495,人工实测得分 95。
它最明显的优势不是界面按钮多,而是飞机本体做得最好。机身轮廓连续,747 标志性的驼峰没有被处理成简单贴在圆柱上的装饰;四台发动机、主翼、尾翼、舷窗和航行灯之间的关系也较为自然。四套涂装能够真实改变机身和尾部标识,旋转、缩放、视角、截图、网格和灯光控制均可使用。
它仍然没有拿到满分,因为成品中缺少起落架。
这个扣分很重要。评测不是先选出冠军,再为冠军寻找满分理由。即使是本次最好的作品,也应该明确告诉用户:它做到了什么,还缺少什么。
第二种:产品可以使用,但质量边界很明显
第二名 gemini-3.7-flash-high 得到 87 分。它有清晰的驼峰、四台发动机、多轮起落架和 8 套涂装,襟翼、灯光和视角等控制也能实际使用。
但在不同角度观察时,垂尾形态和重叠关系仍不够自然;部分涂装更接近大面积改色,自动巡展逻辑也存在问题。它完成了一个功能丰富的产品,却没有把核心几何做到第一名的水平。
第三名 gemini-3.6-flash-high 得到 80 分。它的工程结构和交互功能较完整,但尾翼偏大,驼峰形态、部分翼面和发动机连接仍显得不自然。
gpt-5.6-sol 和 gpt-5.5 分别得到 79 分和 75 分。前者交付了能够运行的原生 WebGL 实现,具备驼峰、四发、起落架和涂装切换,但材质、比例和细节较为简化;后者采用 HTML/CSS 3D,首屏识别度不错,涂装也会真实变化,但旋转到极端角度后会暴露 DOM 拼片结构。
这组结果说明,模型能力不是简单的“会做”或“不会做”。更常见的情况是:模型可以完成任务,但只能把某些部分做到可用,另外一些部分仍需要人工修正。
第三种:附加功能很多,核心对象却没有做好
gemini-3.8-flash-high 是本次最典型的案例之一。
它有丰富的控制面板、6 套涂装、起落架、环境切换和镜头功能,实际操作也有反馈。如果只看功能清单,它很容易被判断为高完成度作品。
但把飞机旋转到不同角度后,问题非常明显:机头呈开口筒状,尾段像独立的粗圆柱,核心机身的连接和封口没有正确完成。最终它得到 68 分。
问题并不是这些附加功能没有价值,而是它们不能代替任务最核心的部分。
用户要求的是一架可以切换涂装的 3D 波音 747。正确的优先级应该是先把飞机做好,再增加灯光、音效、起落架和控制面板。如果飞机本体严重失真,按钮再多也不能把产品推入高分段。
这也是大模型生成产品时很容易出现的一种偏差:它会积极补充容易列举、容易展示的功能,却不一定会优先解决最难、最影响结果的核心问题。
第四种:页面存在,但任务实际上没有完成
最后一名是 deepseek-v4-flash-0731,盲测 ID 为 61K1KU,得分 10。
它的页面框架和涂装侧栏能够出现,但核心 3D 构建没有成功。浏览器控制台报错:
THREE.CapsuleGeometry is not a constructor
文件中还出现了两个 </html> 结束位置,部分 JavaScript 被直接显示在页面上。最终用户并没有得到一架成功渲染的 3D 飞机。
这个案例把“页面能打开”和“任务已完成”的区别表现得非常清楚。
一个 URL 能返回内容,不代表核心程序已经运行;一个控制面板能够显示,也不代表它所控制的对象真实存在;模型在最后声称已经完成,更不能代替浏览器中的实际结果。
这次评测真正测出了什么
如果只把这次实验理解为一次前端模型排行榜,就会错过它更重要的意义。
它至少暴露了五种与真实使用直接相关的能力差异。
1. 理解文字,不等于理解任务目标
所有模型都知道自己要做“波音 747 网页”,但不同模型对核心目标的判断并不相同。
有些模型优先保证驼峰、四发和机身比例;有些模型优先制作控制台、音效和涂装卡片;还有模型把单一 SVG 轴测插画包装成可以旋转的“3D”展示。
这说明模型是否复述了需求并不重要,重要的是它有没有识别出需求中真正不能妥协的部分。
2. 会生成代码,不等于能交付产品
部分作品包含大量结构完整、命名专业的代码,但最终画面仍然出现严重几何错误。也有作品页面和画布都能加载,却在核心对象构建阶段报错。
代码生成能力只能说明模型能够组织程序文本,不能自动证明程序实现了正确目标。
3. 功能数量不等于完成质量
更多涂装、更多按钮、更大的控制面板确实可以提高产品丰富度,但这些都建立在核心目标成立的前提上。
如果核心对象错误,附加功能越丰富,有时反而越容易制造“已经做得很完整”的错觉。
4. 视觉任务必须通过真实观察验收
这次 14 份产物中,有 12 份采用 Canvas 或 WebGL,另有一份 CSS 3D 和一份 SVG 2.5D。它们在代码结构和首屏观感上可能都像“3D 展示”,但实际旋转后的空间表现完全不同。
仅靠检查代码、页面标题或 Canvas 是否存在,无法判断飞机是否装配正确。视觉任务必须进入真实浏览器,从多个角度观察,并实际触发交互。
5. 失败方式比一个总分更能指导使用
同样是低分,原因可能完全不同:
- 有的模型没有理解 747 的关键特征。
- 有的模型理解了,但空间几何实现错误。
- 有的模型用 2.5D 效果替代真正的三维模型。
- 有的模型做了大量附加功能,却没有修好飞机本体。
- 有的模型最终代码直接运行失败。
这些差异会直接影响后续使用方式。几何能力不足需要更强的参考和人工设计;工程运行失败需要自动测试与浏览器检查;容易堆叠附加功能的模型,则需要在任务中明确核心验收项和优先级。
单一分数只能告诉我们结果高低,失败类型才能告诉我们应该如何使用这个模型。
所以,我们为什么要评测大模型
评测的目的不应该只是宣布一个冠军。
模型更新很快,同一个模型重新生成同一道题,结果也可能变化。某个模型在 3D 前端任务中表现优秀,不代表它在数学、后端开发、资料研究或长文写作中同样领先。
真正有用的评测,应该帮助用户回答下面这些问题:
- 哪个模型更适合当前这类任务。
- 它通常能把任务完成到什么质量层级。
- 哪些部分可以直接采用,哪些部分必须人工检查。
- 它最容易在哪些环节失败。
- 出现什么信号时,不能相信模型的完成声明。
对于这次任务,结论不是简单的“gpt-6-astra 最强”。更准确的说法是:在评测编号 121 的这一次运行中,它交付了质量最高的 3D 波音 747 页面,但仍缺少起落架;其他模型则分别暴露了比例、装配、三维真实性、核心优先级和运行稳定性等不同问题。
这才是排名能够提供的实际价值:不是给模型贴上永久标签,而是逐步画出它们的能力边界。
评测不是为了证明大模型有多强,而是为了降低把真实任务交给大模型时的不确定性。
完整排名
评测边界
这份排名只针对评测编号 121 中保存的这一批生成产物,不代表这些模型的永久能力。同一个模型重新运行后,可能得到明显不同的结果。
本次检查属于网页产品级验收:关注页面能否运行、飞机是否可识别、几何装配是否基本可信、涂装和交互是否有效。它不是航空工程级尺寸测量,也不能替代专业 CAD 验证。
但这次结果已经足以说明,真实任务评测不能停留在模型回答、代码长度或页面截图上。只有把产物真正运行起来,才能知道模型究竟完成了多少。
结语
如果只问这次谁赢了,答案是 gpt-6-astra。
但如果问这次评测为什么值得做,答案不是排行榜本身。
它让我们看到,同一句看似清楚的需求,经过不同模型后,可以变成一件接近完整的产品,也可以变成一个外观华丽但核心失真的演示,甚至可以变成一个根本没有运行成功的页面。
一个好的大模型评测,不应该只告诉我们谁排在第一。它还应该告诉我们:哪些工作可以交给模型,交付之后必须检查什么,以及模型失败时通常会留下哪些信号。
真正值得评测的,不是模型能说得多好,而是它可以被安全地委托到什么程度。