AI 快讯 | DeepSeek V4.1 Flash 正式发布:非对称新架构,价格直降 70%+,V4-Pro 将退役
 一句话核心:DeepSeek 于 2026-09-10 发布 V4.1 Flash——552B MoE 全新「因果编码器-解码器」非对称架构(输入仅激活 8B、输出 16B),原生多模态 + 1M 上下文 + MIT 开源,官方称全面超越 V4-Pro,并宣布 9/14 起退役 V4-Pro、全部请求按 Flash 价格计费。
 核心亮点
- 全新非对称架构:V4.1 Flash 是新架构家族的最小成员,采用 Causal Encoder–Decoder 设计——prefill 阶段仅激活 8B 参数、decode 阶段激活 16B 参数。用「非对称激活」在推理性能和成本之间做平衡,而不是一味堆大激活量。
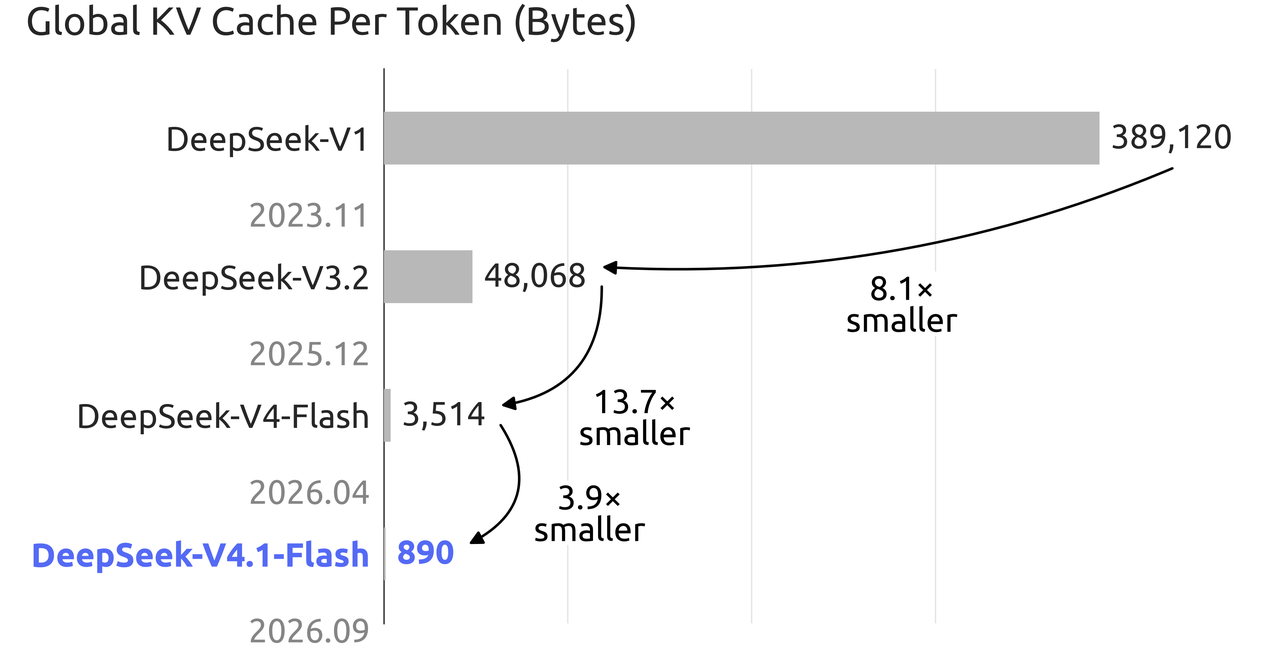
- KV Cache 压缩 4 倍:相比前代,KV Cache 只需 1/4 的 HBM 和 1/8 的 SSD 存储。官方特别点出:Agent 场景里 cache-hit 费用占比极大,压缩 cache 直接砍长期运行成本。
- V4-Pro 退役:官方称多方测试显示 V4.1 Flash 在性能、成本、速度、总耗时上全面超越 V4-Pro。北京时间 9/14 12:00 起,所有
deepseek-v4-pro请求路由到 V4.1 Flash 并按 Flash 价格计费,直至 V4.1 Pro 发布。 - 原生多模态 + 开源:V4.1 Flash 原生支持视觉理解(V4-Pro 不支持),MIT 协议开源权重(HuggingFace 公开),API 模型名即日切换为
deepseek-flash。
 为什么是「非对称架构」值得关注
传统 MoE 大模型 prefill 和 decode 用同一套激活逻辑,但这两个阶段的计算压力其实完全不同:prefill 要一口气吞下长 prompt,decode 则逐 token 生成。V4.1 Flash 把它拆成两个不同激活量——输入 8B、输出 16B——相当于「读得快、写得准」分而治之。
这个设计的实际意义不在纸面参数,而在成本曲线:552B 总参数、却只用 8B/16B 激活,意味着同等显存能跑更大的模型、服务更多并发(官方并发上限 2500,对比 V4-Pro 的 500,5 倍提升)。
配合 KV Cache 4 倍压缩,长链 Agent 任务(反复调用工具、多轮对话)的边际成本被明显压下来——这对积木云这类 Agent 平台是直接利好。
 官方 Benchmark
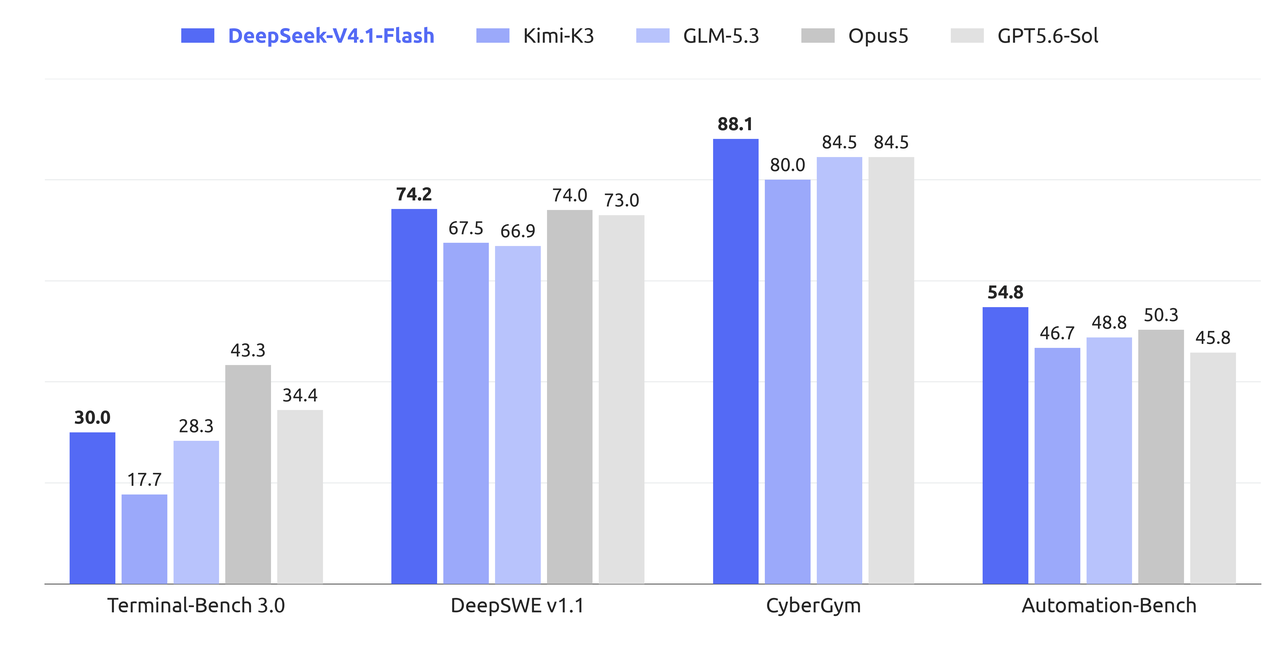
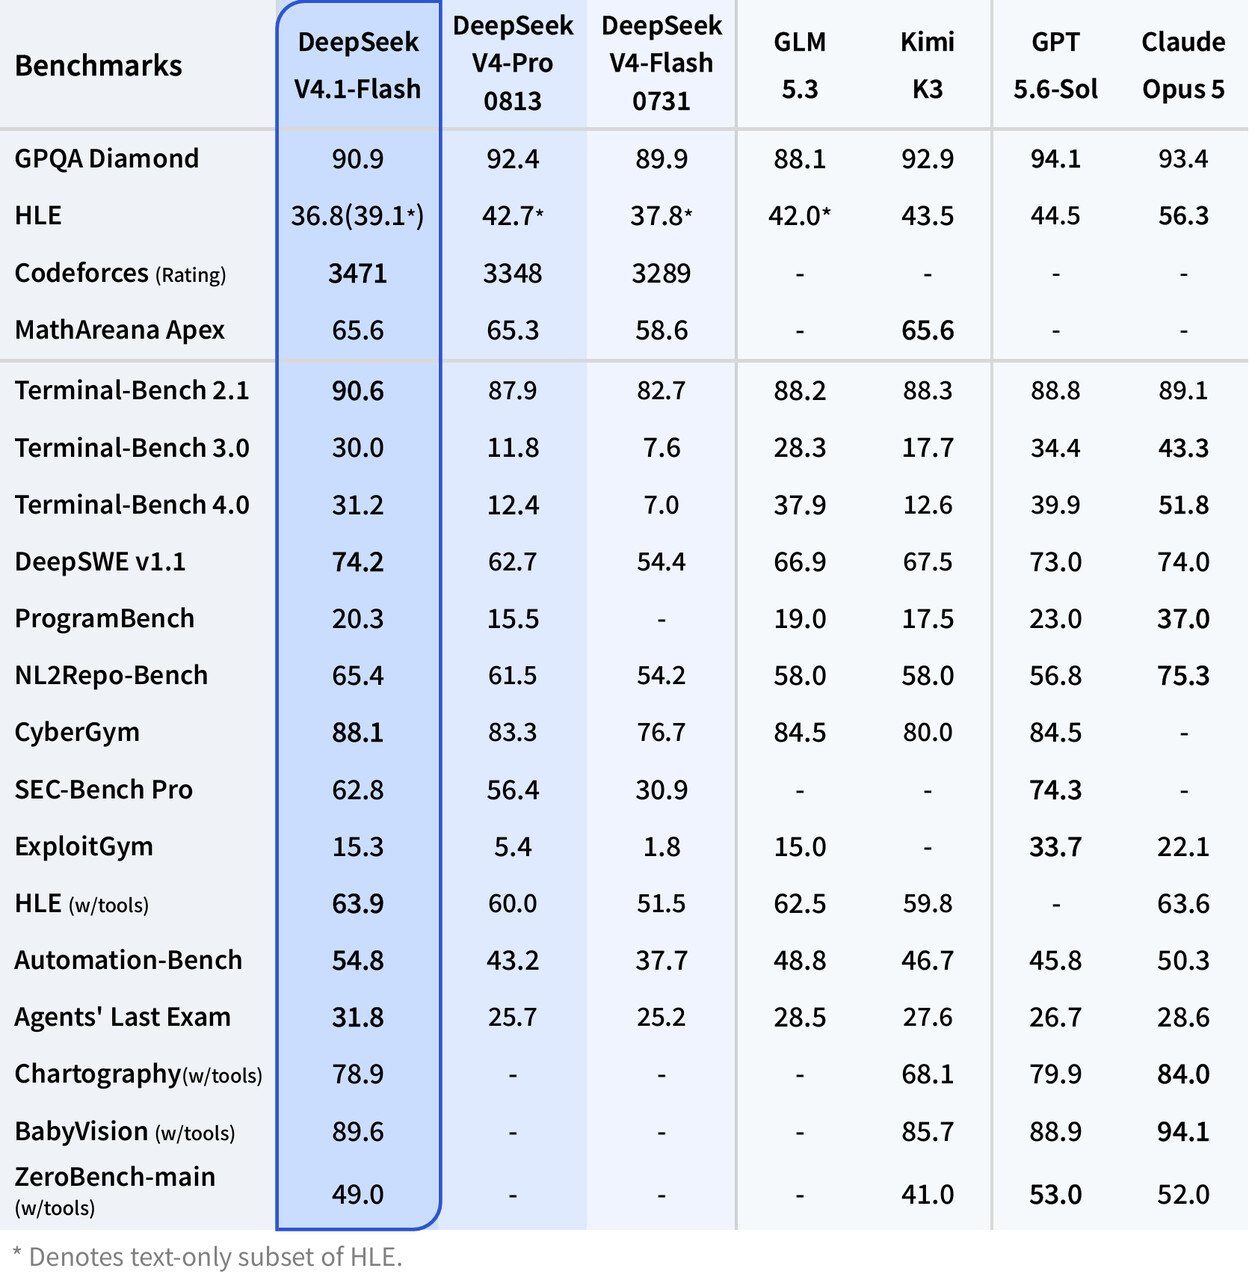
以下为 DeepSeek 官方公告自报值。模型 9/10 刚发布,第三方独立评测(Artificial Analysis / tbench.ai)尚未出炉,本节数据需以「官方口径」看待。
| Benchmark | V4.1 Flash(官方) | 测什么 |
|---|---|---|
| GPQA Diamond | 90.9 | 博士级科学问答 |
| HLE | 36.8 | 人类终极考试(最难 benchmark 之一) |
| Codeforces Rating | 3471 | 算法竞赛水平(相当于顶级人类选手) |
| MathArena Apex | 65.6 | 高难数学推理 |
| Terminal-Bench 2.1 | 90.6 | 终端/工具使用能力 |
| DeepSWE v1.1 | 74.2 | 真实软件工程任务 |
| NL2Repo-Bench | 65.4 | 自然语言转代码仓库 |
| CyberGym | 88.1 | 网络安全攻防 |
| Agents’ Last Exam | 31.8 | 长程 Agent 任务 |
| Chartography (w/tools) | 78.9 | 图表生成(带工具) |
| BabyVision (w/tools) | 89.6 | 视觉理解(带工具) |
解读几个关键数字:Codeforces 3471 意味着算法能力已到顶级人类选手水平;Terminal-Bench 2.1 的 90.6 说明终端操作/工具调用是它的强项;GPQA Diamond 90.9 在科学问答上逼近满分级。但 HLE 36.8 和 Agents’ Last Exam 31.8 也提醒:最难的推理和长程 Agent 任务,即使是新旗舰也仍有明显天花板。
 KV Cache:Agent 成本的隐形大头
官方公告里最容易被忽略、但实际最「省钱」的一点是 KV Cache 压缩:只需前代 1/4 的 HBM 和 1/8 的 SSD。
为什么重要?在 Agent 长链场景里,每次工具调用都要重新带上完整上下文,cache-hit 的计费占比会迅速膨胀。把 cache 体积压到 1/4,等于把「多轮 Agent 任务」的长期运行成本直接砍掉一大截——这是比单 token 降价更隐蔽、但对重度用户更实在的省法。
 价格:降幅 70% 起步
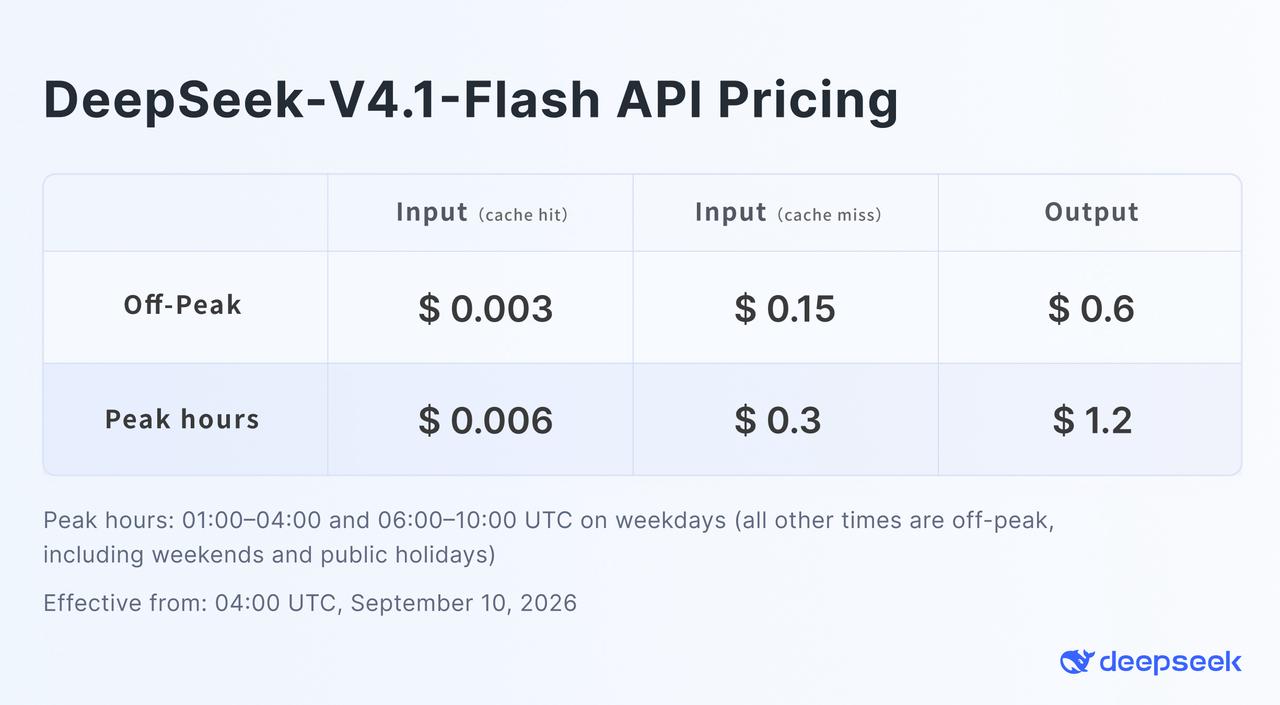
以下价格已核对 DeepSeek 官方定价页(2026-09-10 更新),单位为每 1M tokens。
| 计费项 | V4.1 Flash (Peak) | V4.1 Flash (Off-Peak) | V4-Pro (Peak) | 降幅 |
|---|---|---|---|---|
| 输入 Cache Hit | $0.006 | $0.003 | $0.044 | ~86% |
| 输入 Cache Miss | $0.3 | $0.15 | $1.32 | ~77% |
| 输出 | $1.2 | $0.6 | $3.96 | ~70% |
实操换算:一个典型的 Agent 长任务跑 100 万输出 token,V4-Pro 高峰价要 $3.96,V4.1 Flash 高峰价只要 $1.2,省 70%;如果挪到 off-peak(非高峰时段),输出再对半到 $0.6。Peak 时段是 UTC 周一至五 01:00-04:00 和 06:00-10:00,其余全是半价——把批量任务排到 off-peak 是最直接的省钱姿势。
 已知 vs 待验证
已证实(官方一手来源):
- 552B MoE 非对称架构、8B/16B 激活、1M 上下文、384K 最大输出、原生多模态、MIT 开源 —— 官方公告 + 定价页一致确认。
- API 模型名
deepseek-flash,V4-Pro 9/14 退役路由 —— 官方定价页明确。 - 价格表 —— 官方定价页逐项核实无误。
待独立验证:
- 所有 benchmark 分值是官方自报值,模型发布不到 24 小时,Artificial Analysis / tbench.ai 等独立排行榜尚未收录,「全面超越 V4-Pro」的结论目前只有官方口径,需第三方复现后才能坐实。
- 非对称架构在真实 Agent 长链任务中的稳定性、原生多模态的实际观感,同样缺乏独立实测。
一句话:架构和价格是硬事实,可以直接信;「超越 V4-Pro」的 benchmark 结论,建议等独立测评出来后再下最终判断。
 给读者的实操建议
- 要尝鲜的开发者:模型已上线,直接把 API 模型名切成
deepseek-flash即可,兼容 OpenAI 和 Anthropic 两种调用格式,无需改代码结构。 - Agent 平台 / 重度用户:现在就可以把批量任务切到 off-peak 时段跑,输出成本从 $3.96 降到 $0.6/1M,实打实省 85%。
- 还在用 V4-Pro 的:不用手动迁移,9/14 起自动路由到 V4.1 Flash 并按更低价格计费,但建议先在自己的业务评测集上验证一轮,确认无回归。
- 观望的:等 Artificial Analysis 等独立榜单收录后再做迁移决策也不迟——毕竟「官方超越」和「独立验证超越」是两回事。
来源链接
官方来源
- DeepSeek 官方公告:DeepSeek-V4.1-Flash: Smarter, Faster, More Efficient | DeepSeek API Docs
- 官方定价页:Models & Pricing | DeepSeek API Docs
- 开源权重:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
- 技术报告 PDF:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/main/DeepSeek_V41_Tech_Report.pdf
说明:第三方独立测评(Artificial Analysis / tbench.ai)数据待模型被收录后补充。