AI 快讯 | GPT-Live-1 上线 API:全双工语音模型,单模型取代 ASR→LLM→TTS 三件套
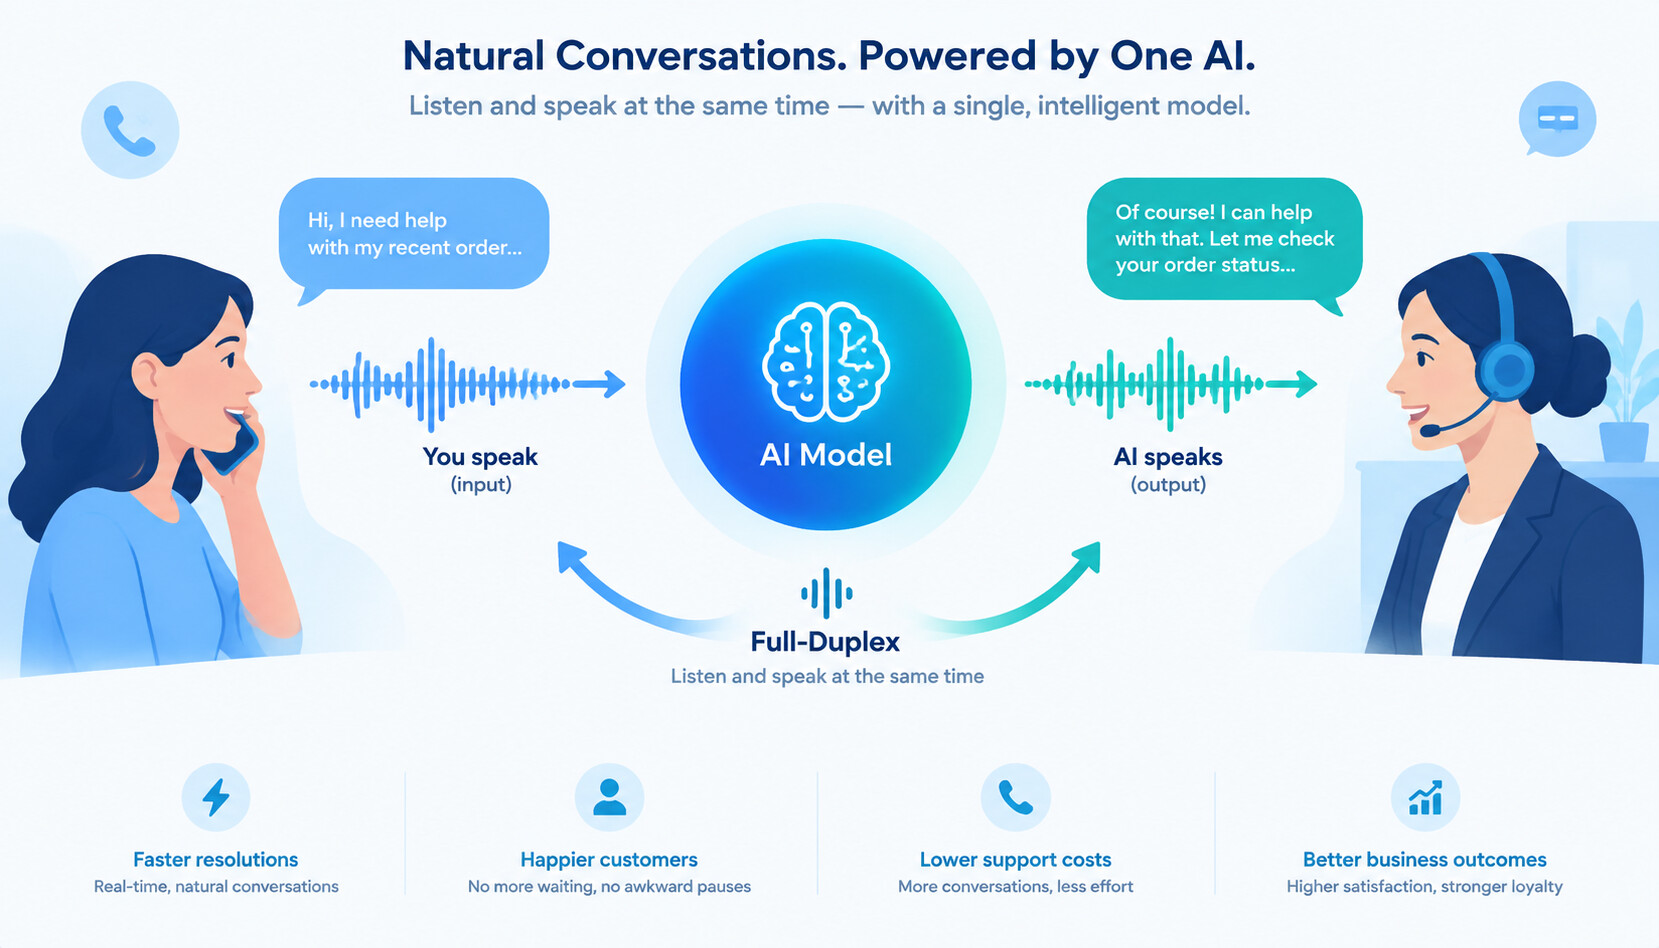
 一句话核心:OpenAI 将 GPT-Live-1 全双工实时语音模型正式上线 API——将传统「ASR→LLM→TTS」三步管线压缩为单一模型,支持打断处理、背景噪声过滤和工具调用,前端语音 $0.05/分钟,可连接 Codex 构建企业级语音 Agent。
 核心亮点
- 单模型全双工:一个模型同时完成语音理解与语音输出,省去了 ASR→LLM→TTS 的三段衔接延迟。复杂推理和工具调用可交由后端文本模型(如 GPT-6 Astra)处理。
- 实战效果已验证:语言学习平台 Speak 使用后误打断次数减少约 80%;医疗服务平台 CTO 称代码量减少 80%、删除约 2.3 万行代码。
- 企业工作流集成:可连接 Codex 和 OpenAI Presence,构建能查询企业系统、执行获批操作、必要时转交人工的语音工作流。12 种新声音同步上线(Quartz、Ripple、Vesper 等)。
- 定价清晰:前端语音层 $0.05/分钟(约每小时 $3),后端模型和工具调用费用另计。
 官方评测数据
| 指标 | 结果 |
|---|---|
| Full Duplex Bench | 比 GPT-Realtime-2.1 高 30 个百分点 |
| Tau3 端到端语音 Agent(配 GPT-6 Astra 中等推理) | 排名第一 |
| Speak 误打断 | 减少约 80% |
| 医疗平台代码量 | 减少 80%(删约 2.3 万行) |
解读:Full Duplex Bench +30pp 是这次最硬的数据——它直接衡量「同时听和说」的能力,传统流水线架构在这个指标上天然吃亏。单模型架构的延迟优势在这里完全体现。
 价格
| 计费项 | 价格 |
|---|---|
| 前端语音层 | $0.05 / 分钟(约 $3/小时) |
| 后端文本模型 | 另行计费(按所选模型定价) |
| 工具调用 | 另行计费 |
实操换算:一个典型的客服通话如果是 5 分钟,前端语音成本约 $0.25。如果后端接的是 GPT-6 Astra 做复杂推理,就要叠加文本模型的 token 费用。对于需要 Codex 工具调用的企业场景(预订餐厅、查库存、转人工),工具调用费用另算。
 为什么这次升级值得关注
过去语音 Agent 最大的痛点是延迟和「机械感」——ASR 转文字再送 LLM 再 TTS 念出来,每一步都是延迟叠加。GPT-Live-1 把三步压成一步,延迟降下去了,但更关键的是「打断处理」和「噪声过滤」让语音交互不再像对讲机。
对企业来说,$0.05/分钟的价格意味着语音 Agent 从「技术演示」阶段进入了「商业化」阶段。配合 Codex 工具链,电话预订、客服查询、语音下单这些场景可以开始算 ROI 了。
但有一点值得注意:前端 $0.05/分钟看起来便宜,但如果任务需要频繁调用后端文本模型做复杂推理,总成本会明显上升。适合「高频简单交互」(如预约、查询状态),不适合「低频深度推理」(如语音编程辅助)。
来源链接
- IT之家报道(一手核实):https://www.ithome.com/1/001/091.htm(2026-09-11)
- ai-bot.cn 每日 AI 快讯(2026-09-11)