AI 快讯 | NeoHorse-1:首个 Agent-Native 模型发布,RSI「执行经验→模型能力」闭环首次验证
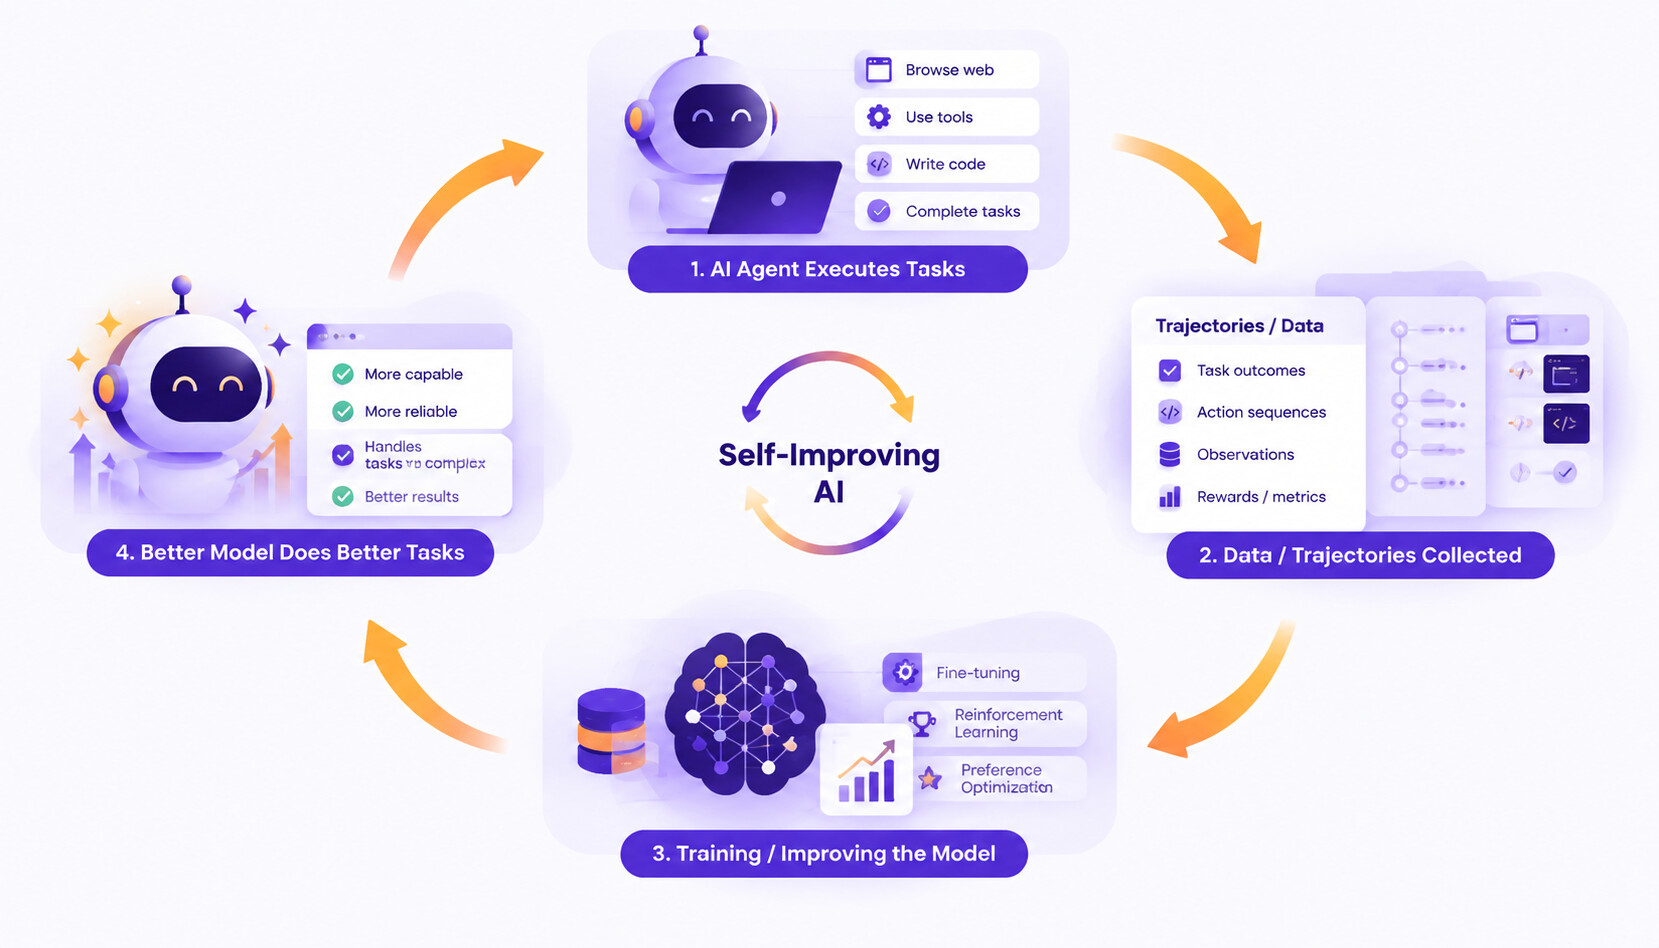
 一句话核心:基元律动联合无问芯穹、清华、北大、港中文、阿里发布自研 Agent-Native 模型 NeoHorse-1(4B/9B 两版),训练数据来自 Harness 结构化执行轨迹而非传统问答语料,4B 版本在多个 Agent 子任务上同规模第一,并首次跑通 RSI(递归自改进)——「模型执行任务→产生轨迹→反哺训练」的闭环。
 为什么「Agent-Native」这个词值得认真看
传统模型训练逻辑是「海量文本预训练 → 指令微调 → 聊得好就是好模型」。但 Agent 场景不一样——Agent 不是来聊天的,是来完成任务的。它需要调用工具、处理错误、理解环境反馈、在多轮中保持目标不漂移。
NeoHorse-1 的训练数据不是「人写的问答对」,而是 Harness 框架里真实 Agent 执行轨迹——包含了工具调用成功失败、错误恢复路径、多轮状态变化。这意味着这个模型从第一天就是在「做事」而不是「说话」的环境里训练出来的。
 关键数据
| 项目 | NeoHorse-1-4B | NeoHorse-1-9B |
|---|---|---|
| Agent 子任务宏平均 | 64.87(4B 同规模第一) | 69.04 |
| 后训练增益 | 集中于 Agentic 任务 | 底座 65.60→69.04 |
| 核心能力 | 工具调用、任务规划、代码生成 | 复杂推理、长程规划 |
| 开源 | ✓ | ✓ |
 RSI 闭环:这次的方法论突破比参数更重要
NeoHorse-1 的论文同时验证了两条 RSI 路径:
- Data-RSI:模型在 Harness 里执行任务 → 产生轨迹数据 → 轨迹成为训练语料 → 喂给下一轮模型
- Model-RSI:评测定位短板 → 调整训练数据配比 → 更新模型 → 放回 Harness 继续执行并验证
这相当于在实验室里验证了「Agent 用得越多、变得越好」的逻辑——不是靠更大的预训练语料,而是靠自己的执行经验。
对积木云这类 Agent 平台来说,这个思路天然匹配「多 Agent 协作产生大量执行轨迹 → 轨迹反哺模型能力」的场景。虽然 4B/9B 的规模还远不足以替代通用基座,但路径被跑通了,剩下的就是把同样的方法论推到更大规模。
 适用边界
- 当前是在 4B/9B 小规模上验证的方法论,离直接商用还有距离
- 「同规模 SOTA」是有意义的,但不能和 GPT-6 Astra 这类千亿参数模型比绝对能力
- RSI 闭环的「改进幅度」和「收敛速度」还需要更多轮次的公开数据
来源链接
- 基元律动官方公众号:https://mp.weixin.qq.com/s/8mJRNtwty4s_SQfAlWOerA
- HuggingFace:https://huggingface.co/collections/TokenRhythm/neohorse-1
- GitHub + 技术报告:GitHub - TokenRhythm/NeoHorse: NeoHorse-1: Towards Recursive Self-Improvement via Agentic Post-Training with Routing Harness. · GitHub
- ai-bot.cn 每日快讯(2026-09-11)