 一句话核心:华为在 9 月 17 日开幕的第十一届华为全联接大会 2026 上更新昇腾路线图——昇腾 960DT 从原定 2027 Q4 提前三个季度到 2027 Q1、960PR 提前一个季度到 2027 Q3,路线图首次延伸到 2029 年的 970/980;配套的 Atlas 960 超节点单节点互联 4096 颗 NPU、最大 8E FP8 算力、RTT 最低 2 微秒,成为全球首个采用 NPO(近封装光学)的超节点。
 背景脉络
华为 2025 年曾罕见公开昇腾未来三年的技术路线图,当时昇腾 960 的规划上市时间是 2027 年 Q4。一年之后,华为把这份时间表往前挪,并把路线图再延伸到 2029 年。
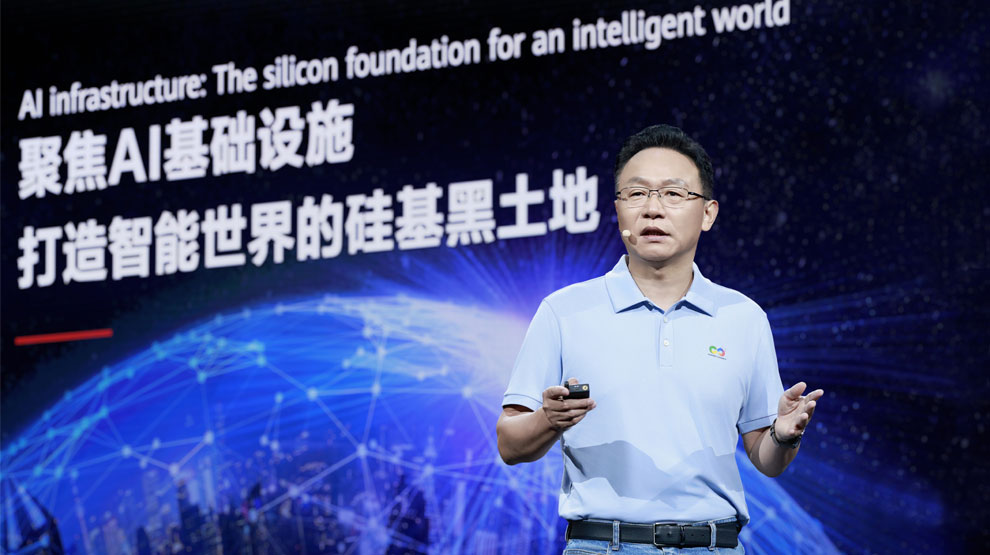
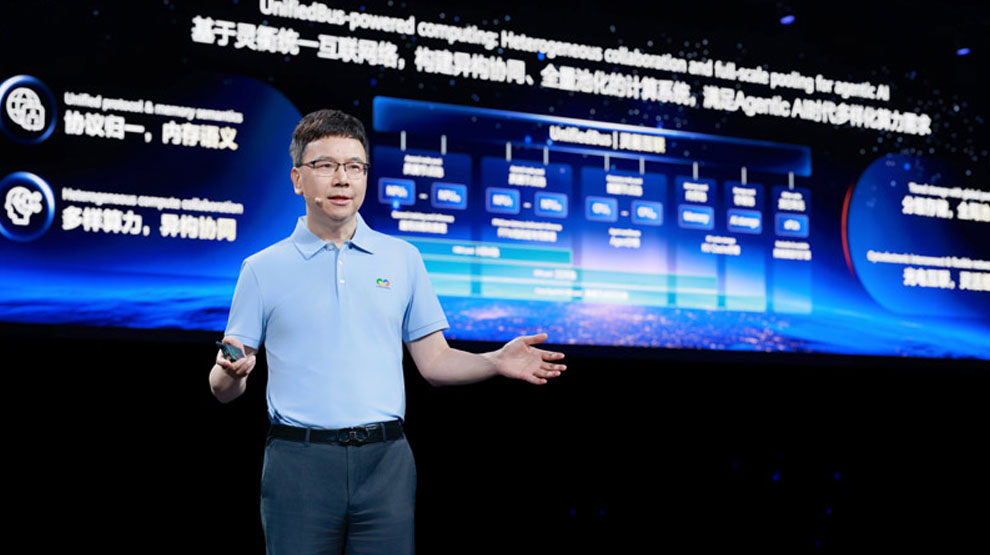
这条路的现实约束是先进工艺的获取。从 2025 年发布灵衢(UnifiedBus)起,华为就把突破点放在「把更多计算资源联接在一起」而不是单颗芯片性能上。芯片规模从千卡走向万卡、十万卡之后,集群内通信开始吃掉有效算力——华为给出的数字是:一个由 8 卡服务器组成的 10 万卡集群,训练过程中集群内通信超过训练时间的 40%。这决定了这一轮竞争的焦点从「单卡参数」转向「互联、光、存储、液冷」这套系统工程。
 关键细节
- 时间表全面提前:华为副董事长、轮值董事长汪涛披露,昇腾 960 研发进度超预期、性能倍增;960DT 比原计划提前三个季度,2027 年 Q1 就绪;960PR 比原计划提前一个季度,2027 年 Q3 就绪。2028、2029 年将陆续推出昇腾 970、980,坚持「一年一代」的节奏,依托 τ(韬)定律实现算力规格继续翻倍。
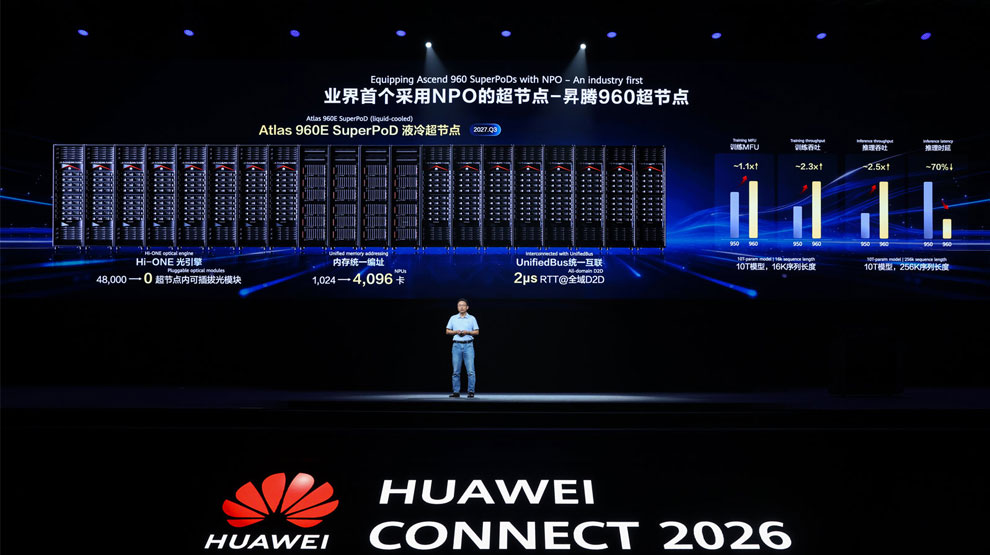
- Atlas 960 超节点首用 NPO:单超节点 4096 颗 NPU 高速互联,最大 8E FP8 算力,依托灵衢架构与 Hi-ONE 光引擎,RTT 最低 2 微秒;液冷超节点计划 2027 年 Q3 推出,是全球首个采用 NPO 近封装光学的超节点。
- 已经进入规模商用:昇腾 910C 超节点累计部署超 1000 套,昇腾 950 超节点已规模商用;围绕灵衢已开发 11 颗关键芯片,覆盖计算、互联、存储与管理。
 参数与数据解读
| 项目 | 官方口径 | 怎么读 |
|---|---|---|
| 960DT / 960PR 就绪时间 | 2027 Q1 / 2027 Q3 | 是「就绪」而非量产交付时间;原规划 960 为 2027 Q4 |
| Atlas 960 超节点规模 | 单超节点 4096 颗 NPU 互联 | 官方发布页在「内存统一编址」一项标注的对比为 1,024 卡 → 4,096 卡 |
| 算力 | 最大 8E FP8 | FP8 精度下的峰值,不等于通用算力 |
| 时延 | RTT 最低 2 微秒 | 数千颗 NPU 频繁交换数据时,「等待通信」的时间明显减少 |
| NPO 收益 | 5500 个 Hi-ONE 替代原本需要的 4.8 万颗 800G 光模块,降超 550 kW 功耗,系统无故障运行时间提升 1 倍 | 官方口径;收益主要落在功耗与可维护性,不是算力 |
| 集群效率 | 同为 10 万卡规模,4K 规模超节点集群 MFU 为传统 8 卡服务器集群的 2.75 倍 | 华为马尔可夫实验室仿真结果,非第三方实测 |
| 存储配套 | 多层 KV 缓存架构;基于灵衢的 PB 级 KV 缓存 OceanStor M900 集群,混合介质 + Retention 算法使 SSD 读写寿命提升 16 倍 | 面向百万级上下文与 Agent 高频交互 |
| 生态 | 鲲鹏开发者超 416 万、支持 560+ 开源项目、openEuler 装机超 2000 万套;CANN 外部开发者首次超过内部,占 61%;基于昇腾 + CANN 原生训练的模型超 40 个 | 统计口径与海外厂商不一致,不能直接横向比较 |
最有信息量的是「通信占训练时间 40%」这个读数:它解释了为什么这次 NPO 光互联、统一内存编址、KV 缓存集群与液冷被放在与芯片同等的位置。汪涛另外给了一个换算:MFU 每提升 1 个百分点,模型迭代时间可提前约 3 天——这类系统层收益,恰恰是后续部署中最容易被验证的部分。
 价格与使用成本
本次没有披露昇腾 960、Atlas 960 的报价、计费方式或云上实例价格。可量化的成本口径只有两项,且都是官方口径:功耗(NPO 方案下减少超 550 kW)与可靠性(系统无故障运行时间提升 1 倍、SSD 读写寿命提升 16 倍)。这两项属于能耗与运维口径,不能读成产品降价。
对选型更现实的成本变量是迁移:CANN 适配、算子覆盖、模型重训与运维人力,本次发布会均未涉及。
 辩证评估
机会:这份更新里真正有价值的信息不是「提前几个季度」,而是国产算力把竞争焦点放到了系统层。在先进工艺受限的前提下,「超节点 + 光互联 + 存储分层」是能拿到实际收益的方向,并且已经有 910C、950 的规模部署作为铺垫——路线图提速说明这条路被验证到可以扩大投入。
反向视角:
- 提前的是时间表,不是交付。2027 Q1/Q3 是「就绪」节点,量产节奏、供货结构与客户名单都未披露。
- 关键收益数字来自单一信源。MFU 2.75 倍是华为自家实验室仿真结果,不是第三方实测;550 kW 功耗下降与故障间隔翻倍同样是官方口径,尚无复现报告。
- NPO 是首次商用形态。全球首个 NPO 超节点意味着可靠性与运维经验需要规模验证,早期采用者会承担这部分头期风险。
- 生态仍是短板。CANN 外部开发者占比 61% 是结构性好消息,但「超 40 个原生训练模型」的绝对量仍然不多,模型迁移成本没有消失。
- 口径存在差异。路透社同日只拿到「2027 年两颗新芯片、超节点出货超 1000 套」的说法,未给出单超节点可连接芯片数与出货结构;双方报道在开发者统计口径上也不可直接比较。
 已知 vs 待验证
官方已证实:960DT 2027 Q1、960PR 2027 Q3 的就绪时间;路线图延伸至 2029 年的 970/980;Atlas 960 的 4096 卡、最大 8E FP8、最低 2 微秒 RTT、NPO 方案与液冷超节点 2027 Q3 时间点;910C 超节点超 1000 套部署、950 规模商用;灵衢 11 颗关键芯片;存储与生态数字。
待独立验证:MFU 2.75 倍(仿真结果)、550 kW 与故障间隔收益(官方口径)、8E FP8 的实际可达算力、量产交付节奏与客户结构。
 给读者的建议
- 正在规划 2027 年扩容的团队:可以把 960DT/960PR 与 Atlas 960 液冷超节点放进候选清单,但先算迁移账——现有 CANN 适配、算子覆盖与运维经验能否复用,比芯片规格更影响实际成本。
- 已经在昇腾上有训练负载的团队:优先验证与硬件迭代无关的部分,即 KV 缓存分层(M900)与超节点互联带来的推理侧收益,这部分今天就能测。
- 不适合的场景:小规模、低延迟的单机部署;供货周期敏感、必须今年内交付的项目,不宜等 2027 年的 960。
 来源
官方来源
- 华为全联接大会 2026 官方页面:华为全联接大会 2026 | HUAWEI CONNECT 2026
独立来源
- 每日经济新闻《华为更新昇腾路线图:960DT 上市比原计划提前三个季度,首次引入 NPO 方案》(2026-09-17):https://www.mrjjxw.com/articles/2026-09-17/4584260.html
- Reuters《China’s Huawei to launch two new AI chips in 2027》(2026-09-17):https://www.reuters.com/world/asia-pacific/chinas-huawei-launch-two-new-ai-chips-2027-2026-09-17/