 一句话核心:Claude Code v2.1.269(9 月 11 日发布)新增
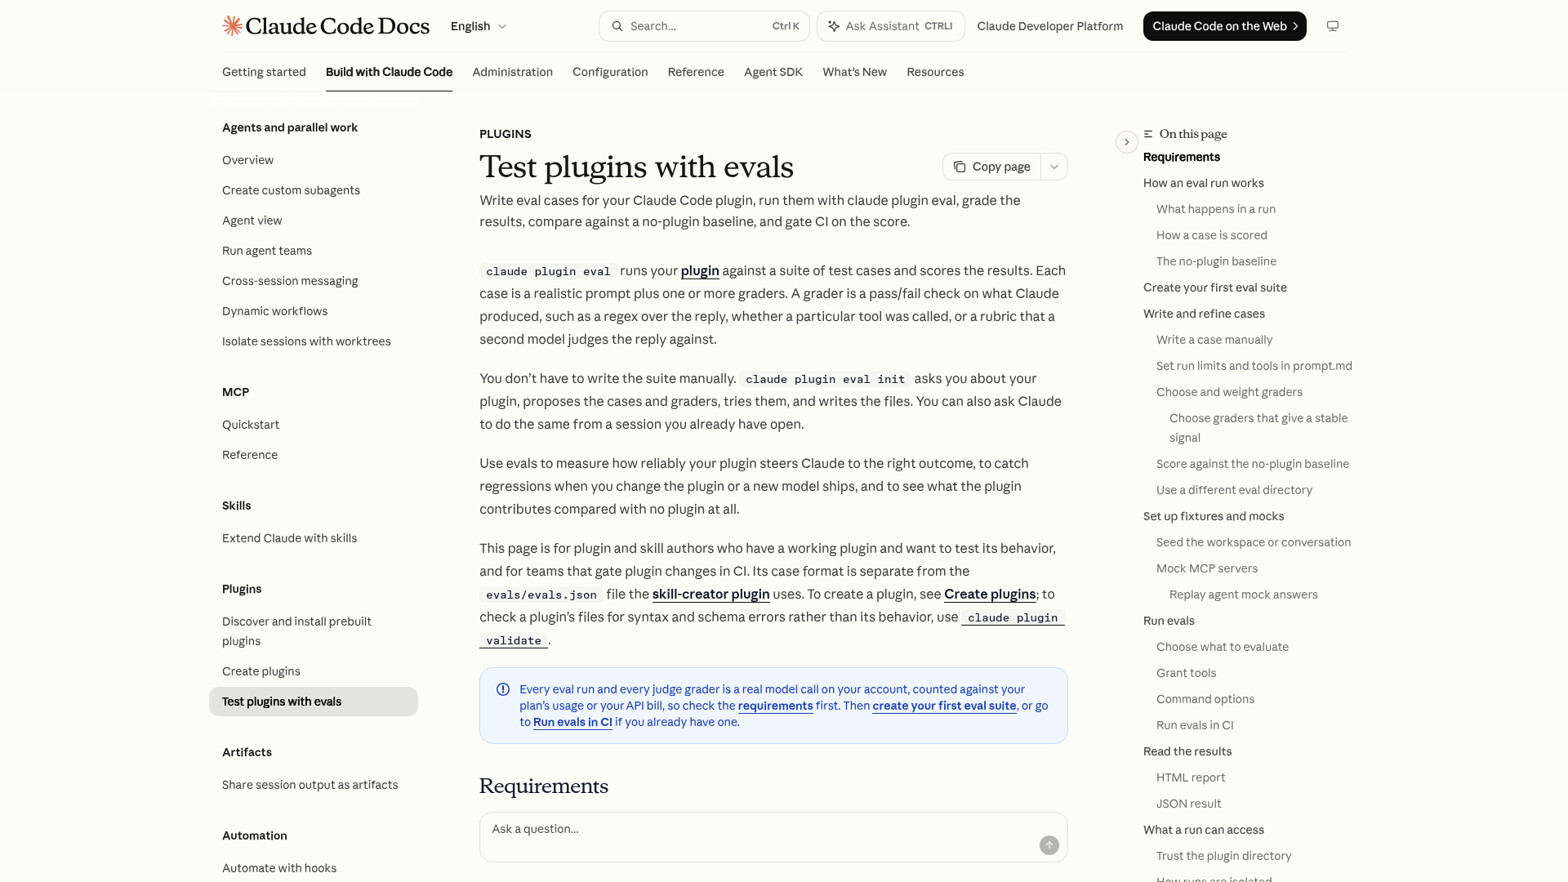
claude plugin eval——它把插件跑在真实提示上,并同时跑「加载插件」和「不加载插件」两臂,两者分数之差 Δ 才是插件的真实贡献。官方文档点出作者最常见的首个发现:Δ 接近 0,且 tool_used: Skill 判否——意思是 Claude 在自然措辞下压根没选中你的 skill。而这恰好是 claude plugin validate 查不出来的问题,它只校验 manifest 语法与 schema,不校验行为。
 它解决什么问题
高分配套本身不说明插件有用,因为 Claude 不加载插件也可能拿一样的分。官方为此把每个 case 的运行默认重复一遍——多跑一臂「不加载插件」,从而把「模型本身的能力」和「插件带来的增量」分开:
- WITH:加载插件时的分数;
- W/OUT:不加载插件时的分数;
- Δ = WITH − W/OUT:插件贡献的增量。
如果一个 case 在两臂都拿满分,那说明通过不是插件的功劳。这也是它与 claude plugin validate 的分工:validate 查语法,eval 查行为。
 关键机制
六种 grader,四种不花钱
| grader | 是否调用 judge 模型 | 检查什么 |
|---|---|---|
regex |
否 | 对回复做正则匹配 |
tool_used |
否 | 某个工具(含 Skill)是否被调用,可匹配 插件名:skill名 的命名空间形式 |
tool_order |
否 | 工具调用的先后顺序 |
file_exists |
否 | 是否产出了指定文件 |
llm |
是(计费) | 按你写的文字标准打分 |
baseline |
是(计费) | 与参考答案比较 |
前四种直接从 transcript 与磁盘结果算出来,不产生额外模型费用;后两种每次运行会额外产生 3 次短 judge 调用。
一个 case 长什么样
- eval 套件放在插件内的
evals/目录,每个 case 是一个子目录,包含prompt.md与graders/。 prompt.md的 frontmatter 可以设max_turns(默认 10)、timeout_seconds、model、tags,以及该 case 允许使用的allowed_tools。- 官方提醒:提示词要写得像真实用户会打的话,不要在提示里点名你的 skill——否则测不出模型能否自己找到它。
- 每个 case 从空工作目录开始,任务要用的材料要么写进提示,要么通过 fixture 预置。
 跑一次要花多少
官方文档给出的示例:单 case、6 次运行(两臂 × 3 次)、74 秒、约 $0.41,结果 WITH 1.00 / W/OUT 0.33 / Δ +0.67,报告输出到 evals/results/<时间戳>/report.html。
需要说清楚的是:这是文档示例,不是基准值。每条 eval 与每次 judge 都是真实模型调用,计入你的套餐用量或 API 账单;成本随 case 数、运行次数与 grader 类型线性增长。官方给了两条控成本建议:日常「每次改动都跑」的套件只用不调 judge 的 grader;不需要 Δ 时用 --ablation none 关掉对照臂。
单次运行噪声较大,官方建议以默认的 3 次运行来确认改动是否真实有效。
 放进 CI
claude plugin eval init --bare <name>:在无终端的环境里生成空白模板(交互式的init需要终端)。--json:输出机器可读结果,便于门禁做判断。- 报告默认会发布到一个 claude.ai 链接,加
--no-publish可以只留在本地。
 辩证评估
- 价值:它把「skill 会不会被触发」「改一处描述或换个模型后是否退化」「是否真的胜过裸模型」这三件原本靠感觉的事,变成了可复现的分数。对正在写 skill 的读者,
tool_used: Skill这一项几乎可以立刻用上——它检出的正是 description 路由失败这一类问题:skill 写得再好,模型不选它就是零。 - 分数不能横比:Δ 来自你自己的 case 与 grader,不同插件的 Δ 不是同一把尺子,不构成榜单。
- 有使用前提:需要 Claude Code v2.1.269 或更高版本;需要一个带
plugin.json/.claude-plugin/plugin.jsonmanifest 的插件目录(或 skills-directory 形式的插件);使用与日常相同的鉴权与模型提供方。若提示「currently in early access」,说明本地版本过旧,claude update后重开会话即可。 - 官方保留了服务端开关:文档的故障排查里写明,若提示「plugin eval is currently unavailable」,是 Anthropic 在服务端关闭了该命令,本地无法打开——也就是说这条能力并非任何时刻都可用。
- 成本随套件规模上升:想用 judge 类 grader 做语义打分,就要接受相应的模型费用。
 已知 vs 待验证
官方已证实:版本号与命令、两臂对照与 Δ 的定义、六种 grader 及计费差别、prompt.md 字段与默认值、CI 相关参数、报告输出路径、使用前提与两条故障提示。
待独立验证:$0.41 / 74 秒 与 1.00 / 0.33 / +0.67 均为官方文档示例,不是基准;Δ 在不同模型下的稳定性、以及跨插件的可比性,目前没有第三方数据。
 上手难度与推荐理由
- 上手难度:中。需要已有插件 / skill 项目,写 case 与 grader 是 Markdown 与 YAML;跑一次约一分多钟、几毛钱。
- 推荐理由:这是目前少见的、针对 skill 行为 的官方验证手段,直接补上了「语法校验通过、但模型根本不用」这个缺口。它回答的是 Skills 生态里最缺的一环——我怎么知道这个 skill 起了作用。
 官方来源
- 官方文档《Test plugins with evals》(命令、对照臂、grader 类型、CI 用法):https://code.claude.com/docs/en/plugin-evals
- Claude Code v2.1.269 发布说明(2026-09-11,首条即
claude plugin eval):Release v2.1.269 · anthropics/claude-code · GitHub