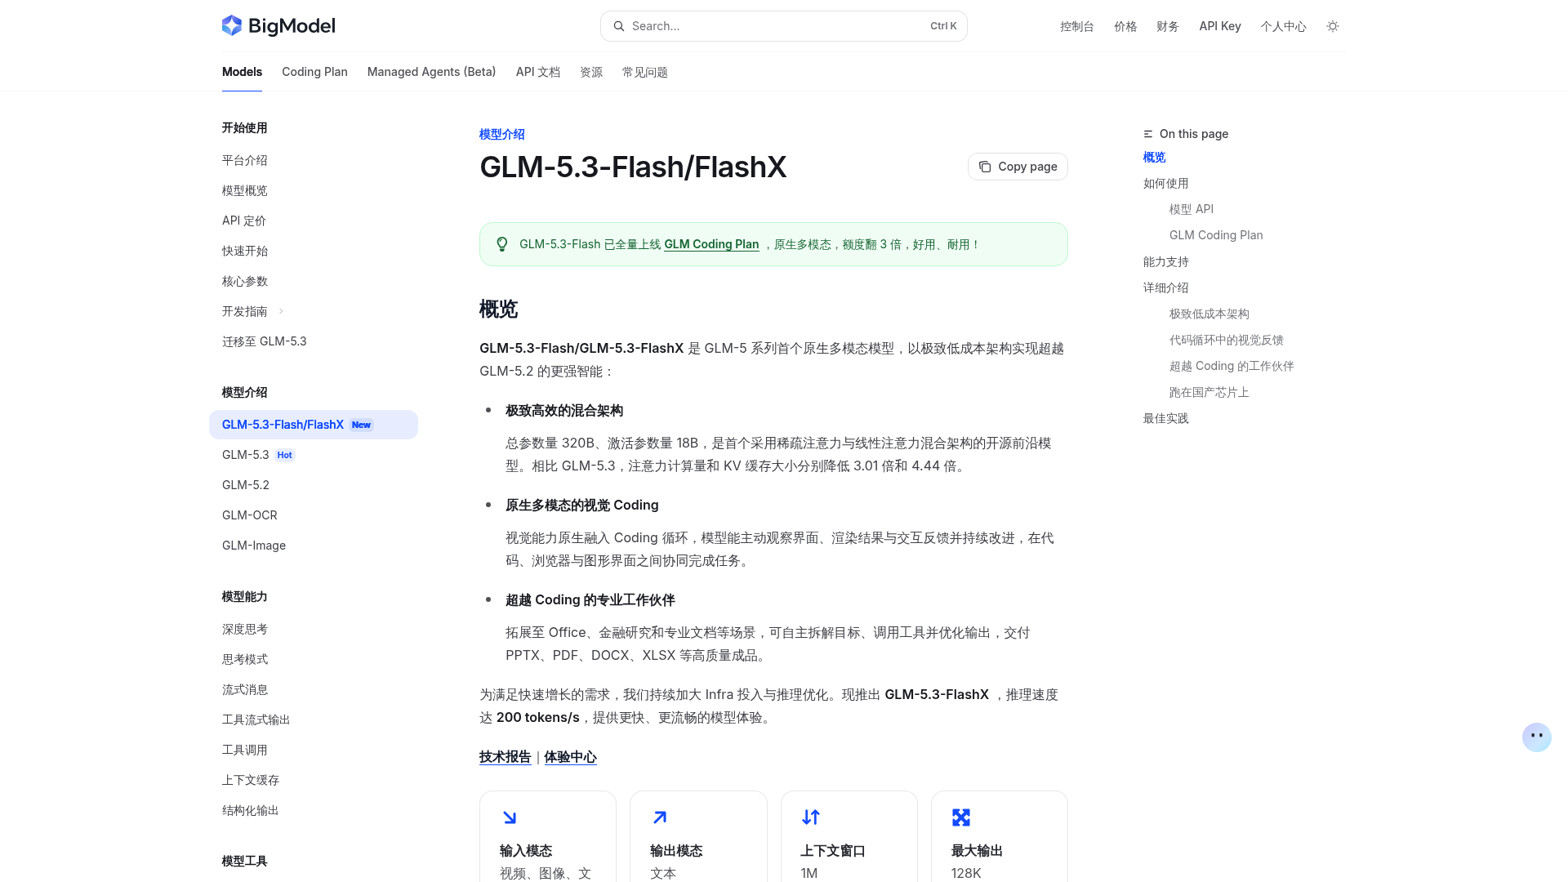
 一句话核心:9 月 18 日,智谱上线 GLM-5.3-FlashX——官方文档给出的定位是「更快更流畅的 GLM-5.3-Flash」,推理速度达 200 tokens/s。它把「速度」做成了一个可单独购买的项:在官方定价页上,FlashX 的输入 2 元、输出 7 元、缓存命中 0.57 元(每百万 Token),正好是 Flash 版的 2.5 倍(Flash 为 0.8 / 2.8 / 0.23 元)。
 背景脉络
这次上新的基座并不新。GLM-5.3-Flash 是 GLM-5 系列首个原生多模态模型:总参数量 320B、激活 18B,官方称它是首个采用稀疏注意力与线性注意力混合架构的开源前沿模型,相比 GLM-5.3,注意力计算量与 KV 缓存大小分别降低 3.01 倍和 4.44 倍。它的使用形态是输入视频、图像、文本、文件,输出文本,上下文窗口 1M、最大输出 128K。
FlashX 是在同一基座上做 Infra 侧推理优化的结果:官方表述是「为满足快速增长的需求,我们持续加大 Infra 投入与推理优化」而推出,模型代码为 glm-5.3-flashx。
另有一条被媒体反复引用的口径:据引述智谱官方技术文档,该模型的推理服务运行在超过 10 万张国产芯片的集群上,并称「硬件效率及单 token 成本已达到与主流英伟达 GPU 相当的水平」。这属于官方技术文档口径,本轮未见第三方复现。
 关键细节
- 速度:官方文档写「推理速度达 200 tokens/s」;智谱模型概览页把 FlashX 概括为「更快更流畅的 GLM-5.3-Flash」。
- 规格与基座一致:1M 上下文、128K 最大输出、输入模态为视频/图像/文本/文件、输出为文本。
- 定价是 2.5 倍:官方 API 定价页给出 FlashX 输入 2 元、输出 7 元、缓存命中 0.57 元(元/百万 Token)。
- Coding Plan 暂未覆盖:官方文档明确「套餐当前暂未开放 GLM-5.3-FlashX」,而 GLM-5.3-Flash 已全量上线 Coding Plan,可用额度为 GLM-5.3 的 3 倍;新版 Coding Plan 采用积分配额,非高峰时段(含周末全天)调用仅消耗标准积分的 50%。
 价格与速度:一页表看清它换来了什么
| 模型(官方定价页) | 上下文 | 输入(元/百万 Token) | 输出(元/百万 Token) | 缓存命中 | 输入模态 |
|---|---|---|---|---|---|
| GLM-5.3(旗舰) | 1M | 8 | 28 | 2 | 文本 |
| GLM-5.3-Flash | 1M | 0.8 | 2.8 | 0.23 | 图片、视频、文件、文本 |
| GLM-5.3-FlashX | 1M | 2 | 7 | 0.57 | 图片、视频、文件、文本 |
怎么读:
- 价格差异是整数倍:FlashX 相对 Flash,输入 2.5 倍、输出 2.5 倍、缓存命中约 2.48 倍。也就是说,这不是降价,而是把速度单独标价——你多付的 1.5 倍,买的是官方口径下最高 200 tokens/s 的输出速度。
- 与旗舰的关系:FlashX 的输入仍只有旗舰 GLM-5.3 的 1/4(2 元对 8 元),输出是它的 1/4(7 元对 28 元)。定位很清楚:在通用任务上用 Flash 的架构,按「更高吞吐」重新定价,而不是替代旗舰。
- 缓存命中价的绝对值仍然很低:0.57 元/百万 Token,对长上下文与重复前缀场景(长文档、代码库、多轮追问)依旧是最省的路径。
 价格与使用成本
上述价格均为智谱官方 API 定价页原价,按输入与输出 Token 分别计费,另有缓存存储费用项(官方定价页对 GLM-5.3 系列标注为「限时免费」)与缓存命中价。真实成本还需要叠加两类变量:一是任务本身对速度的敏感度(交互式场景值得为速度付费,离线批处理不值得),二是缓存命中率(命中 0.57 元 vs 未命中 2 元,差 3.5 倍)。
需要注意的是,本次官方未披露 200 tokens/s 对应的模型尺寸、硬件配置与批处理条件,因此这个速度值不能与其他厂商公布的「tokens/s」直接横比。
 辩证评估
- 机会:把「速度」做成独立定价项,是国产模型服务层面一个务实的产品动作——同一基座、两种价格,让用户按场景自选,而不是让所有人都在一条定价上做折中。对需要交互式低延迟的场景(实时代码补全、界面操作、语音对话),这是一个不用换模型就能拿到吞吐提升的选项。
- 反向视角:其一,200 tokens/s 是峰值口径,官方未给出硬件与并发条件,横向比较没有意义;其二,速度溢价 2.5 倍意味着成本必须由场景收益来覆盖——批处理、离线生成类任务继续用 Flash 更划算;其三,Coding Plan 套餐暂未开放 FlashX,订阅制用户拿不到这个版本,只能走 API 按量付费;其四,国产芯片承载推理的「硬件效率与单 token 成本相当」是官方技术文档口径,本轮无第三方复现;其五,本轮未见第三方对延迟与吞吐的独立实测。
- 对生态的意义:如果「同一基座 + Infra 优化 + 分层定价」成为常规做法,用户面对的选型问题会从「选哪个模型」变成「同一模型选哪档服务」,这也会让评测需要补充速度与服务等级维度,而不只是基准分。
 已知 vs 待验证
官方已证实(智谱官方文档与定价页):GLM-5.3-Flash/FlashX 的 320B-A18B 规格、混合注意力架构与相对 GLM-5.3 的 3.01 倍/4.44 倍降幅;1M 上下文与 128K 最大输出;FlashX 的 200 tokens/s 表述与模型代码 glm-5.3-flashx;三个模型的官方单价与缓存价;Coding Plan 的覆盖范围(Flash 已上线、FlashX 暂未开放)与积分规则。
待核实:200 tokens/s 的测试条件(硬件、并发、批处理)与实际可达速度;国产芯片承担的流量比例与「单 token 成本相当」的结论(官方技术文档口径,无第三方复现);第三方对延迟、吞吐与品质的独立测评;活动优惠后的实际结算价。
 给读者的建议
- 做交互式产品的团队:值得先用真实交互链路测一次首字延迟与吞吐,再决定是否切到 FlashX——它是「同基座换档」,迁移成本低于换模型,但价格是 2.5 倍,必须由体验收益买单。
- 做离线批处理、数据生成的团队:继续用 GLM-5.3-Flash(0.8 / 2.8 元)更划算,除非产出速度直接决定业务周期。
- 用 Coding Plan 订阅的用户:注意官方口径——套餐暂未开放 FlashX,想用需要走 API 计费。
- 做选型的团队:把「速度档位」加入对比表,同时要求厂商给出速度对应的测试条件,否则不同厂商的 tokens/s 无法比较。
- 部署侧决策者:若关注国产算力承载情况,可把「官方技术文档披露的集群规模与硬件效率口径」作为观察点,但结论要等第三方复现或自有压测。
 来源
官方来源
- 智谱官方文档《GLM-5.3-Flash/FlashX》(概览、规格、模型代码、Coding Plan 说明):https://docs.bigmodel.cn/cn/guide/models/vlm/glm-5.3-flash
- 智谱官方 API 定价页(GLM-5.3 / GLM-5.3-Flash / GLM-5.3-FlashX 单价与缓存价):API 定价 - 智谱AI开放文档
- 智谱模型概览页(FlashX 定位「更快更流畅的 GLM-5.3-Flash,推理速度达 200 tokens/s」):模型概览 - 智谱AI开放文档
独立来源
- 华尔街见闻《智谱新模型「牛来」跑在 10 万国产卡上》(引述智谱官方技术文档口径):华尔街见闻
- 观点网《智谱 AI 9 月 18 日推出 GLM-5.3-FlashX 最高 200 tokens/s》(2026-09-18):智谱AI9月18日推出GLM-5.3-FlashX 最高200 tokens/s - 观点网