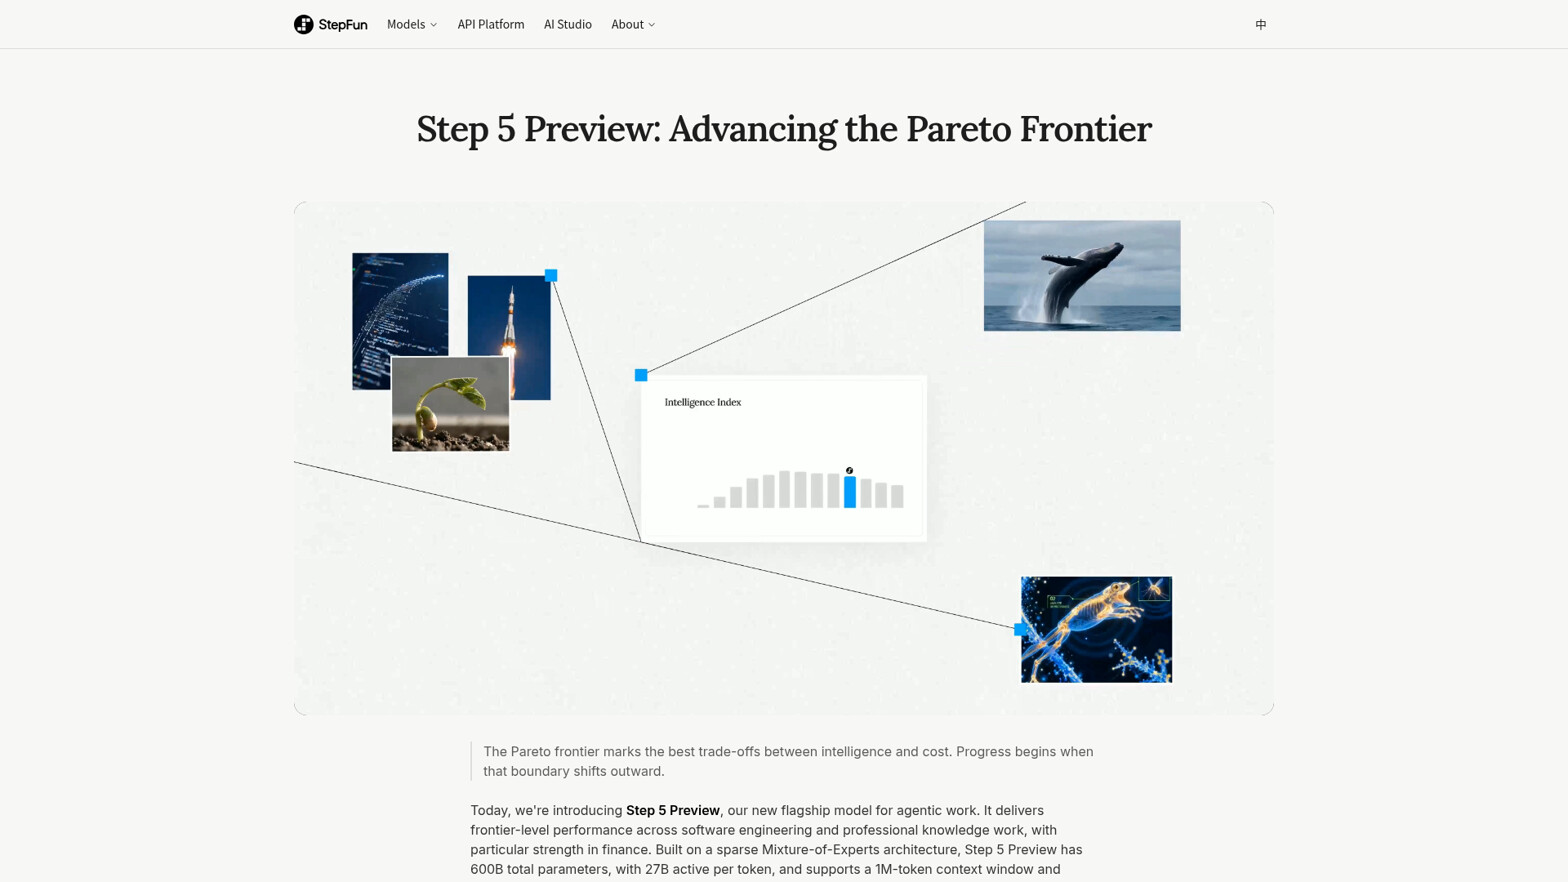
 一句话核心:9 月 20 日,阶跃星辰发布并全量开放旗舰基座模型 Step 5 Preview——稀疏 MoE 架构,总参数 600B、每 token 只激活 27B,支持 100 万 Token 上下文与原生视觉输入,模型 ID 为
step-5-preview。它的路线很明确:不靠堆参数,而是把「计算转化为智能的效率」当作竞争点——600B 总参数只激活约 4.5%,这也是它宣称「单任务成本仅为 Claude Opus 5 的八分之一」的结构基础。
 背景脉络
阶跃星辰在官方材料里把这条路线讲得很直白:Scaling 的重点正从「增加算力投入」转向「提升计算转化为智能的效率」,而从 Step 3.5 Flash、Step 3.7 Flash 到 Step 5 Preview,连续三代基座模型都围绕这一目标优化。
这一定位对应的是今年国产旗舰的共同处境:一边是万亿级 MoE 的开源模型(如 Kimi K3 的 2.8 万亿总参数),一边是闭源前沿模型的价格与推理成本压力。在「同等智能水平下谁的推理更便宜」这个问题上做文章,是国产模型目前最有把握的差异化方向。
 关键细节
- 规格(官方页面):稀疏 MoE;总参数 600B、激活 27B(每次推理仅调用约 4.5% 的参数);1M Token 上下文;原生文本 + 视觉输入。
- 定位场景:面向真实世界的 Agentic 任务——AI 编程、软件工程、专业知识工作、金融;官方强调其适合需要长上下文、长期规划与持续工具调用的任务。
- 可用性与开源计划:9 月 20 日全量开放 API(模型 ID
step-5-preview);官方稿写明将于 10 月 15 日释放完整权重(界面新闻、IT 之家等多家口径一致;解放日报「模速生态」栏目转载的即阶跃 StepFun 官方稿)——即先开放 API,后开源权重。在 10 月 15 日之前,不要写成「已开源」。 - 自建评测集:官方为该模型自建了代码评测集 StepCodeBench(官方演示中用于展示编程场景表现)。
- 第三方性能观测(AA 口径,供对照):输出速度 99.8 tokens/s(其同档中位 74.1);首 token 延迟 2.96 秒(中位 3.68 秒);智能指数排名 #24 / 200;评测中生成 1.6 亿输出 token(同档中位 9200 万,AA 评价为「very verbose」——即回答偏长)。注意 AA 页面自己的「Released」字段写的是 September 18, 2026,那是 AA 收录/评测时点,与官方 9 月 20 日发布并存而不矛盾,引用时不要合并成一个日期。
 数据解读:榜单与成本口径
| 口径 | 数值 | 来源与状态 |
|---|---|---|
| Artificial Analysis 智能指数 | 44 分 | 第三方评测机构 Artificial Analysis 的结果(其 changelog 于 2026-09-18 收录该模型,早于 9 月 20 日发布——即发布前评测) |
| 参照:GLM-5.3 | 45 分 | 同上;AA 明写「GLM-5.3 是排名最高的开源权重模型」 |
| 参照:Kimi K3 | (AA 榜单并列展示,总参数 2.8 万亿) | 同上 |
| 价格(第三方转引,非官方定价页) | 输入 1.00 美元/百万 token;输出 2.70 美元/百万 token;混合价(7:2:1 缓存命中/输入/输出)0.51 美元/百万 token | AA 基于阶跃 API测得,并注明「价格可能因供应商而异」;对照其同档中位数:输入 1.88、输出 10.00 美元 |
| 每任务成本(成本,不是价格) | 0.72 美元 / 每个 Intelligence Index 任务 | AA 的加权平均口径;单位是「任务」,不可与上面的单价混用 |
| 单任务成本 | 官方称约为 Claude Opus 5 的 1/8 | 厂商自述口径,非第三方实测 |
怎么读这两行:
- 44 分是第三方评测结果,不是厂商自报。这很关键:它意味着「600B/27B 的激活规模能达到这一档智能水平」这句话,有独立评测机构的数据支撑(AA 于 9 月 18 日收录,比正式发布早两天,属发布前评测)。如果这一点成立,它说明参数规模与智能水平之间的换算关系正在松动——激活参数少,意味着单位推理的算力与显存占用都更可控,这对自建推理的团队比榜单名次更实际。
- 但要给「开源」加限定,而且这条有 AA 的明文口径:AA 在该模型页的常见问题里直答——「Is Step 5 Preview open source? No, Step 5 Preview is proprietary. The model weights are not publicly available.」;同一页也写明「AA 当前排名最高的开源权重模型是 GLM-5.3(45 分)」,Step 5 Preview 以 44 分紧随其后。而官方稿称其完整权重将于 10 月 15 日释放。因此现在不能写「已开源」,准确表述是:已全量开放 API,AA 当前将其归类为专有模型,官方计划 10 月 15 日释放完整权重;把它算进开源模型排名,是以其开源承诺为前提的表述。
- 价格这一栏要看清单位:AA 给出的是输入 1.00 美元 / 输出 2.70 美元每百万 token(混合价 0.51 美元/百万 token,基于阶跃 API);它与「每任务成本 0.72 美元」是两个不同口径——前者是单价,后者是把输入、缓存命中/写入、推理与回答 token 都算进去后、按 Intelligence Index 权重加权的单任务成本。把两者混用会得出完全不同的成本判断(这正是本栏此前一处口径错误的来源)。
- 厂商的「1/8 成本」仍须按自述看待:官方没有给出该结论的计算方式(是否含缓存、是否以输出 token 计价、任务选取为何),因此不能直接当作可用成本模型;真正的成本要按自己的任务分布实测。
 价格与使用成本
该模型的官方定价页本轮未取到,因此正文的价格采用第三方评测机构 AA 的转引口径(基于阶跃 API):输入 1.00 美元/百万 token、输出 2.70 美元/百万 token;按 7:2:1(缓存命中/输入/输出)计,混合价 0.51 美元/百万 token。AA 同时给出同档中位数(输入 1.88、输出 10.00 美元)以便看量级。
必须分清的两个口径:上面是单价;而 0.72 美元/任务是 AA 的单任务成本(把输入、缓存命中/写入、推理与回答 token 都计入后按指数权重加权)。两者数值接近、含义完全不同,混用会得出错误的成本判断——AA 评测整个 Intelligence Index 的总花费为 924.68 美元。
结构性口径仍然可用:激活参数仅为总参数的约 4.5%(600B 中的 27B),这是「低成本推理」主张的技术基础;但真正的成本仍须按自己的任务分布实测。另外官方推出了限免订阅(据媒体口径),若属实属于促销而非定价,不能当作长期成本。
 辩证评估
- 对做 Agent 与编程场景的团队:这条的价值在于**「长上下文 + 持续工具调用 + 低成本」这个组合**是否有官方宣称的那么完整。前两项可以在 API 上直接验证;第三项必须自己压测。建议先用真实 Agent 任务(多轮工具调用、长上下文)跑对照,而不是用单轮问答比较。
- 对关注开源生态的人:**先 API、后权重(10 月 15 日)**的节奏值得记录——这已成为国产旗舰的常见做法:先用 API 建立使用与评测数据,再放权重。权重释放后,社区复现的评测才是第一份真正的第三方数据。
- 反向视角:
- 其一,44 分是第三方评测(AA)的指数,可信度高于厂商自报;但**「单任务成本 1/8」仍是厂商自述**,两者不宜混用;且 AA 指数之外尚无场景化第三方测评;
- 其二,「效率路线」并非独有:混合注意力、稀疏激活、KV 缓存优化在过去几个月里已是国产模型的标准动作(见本专区 153 篇智谱 FlashX 的定价思路),这条的差异化需要实测支撑;
- 其三,「Preview」意味着能力与服务等级可能变化,用于生产前要确认稳定性与限流政策;
- 其四,成本优势的另一面是能力上限:小激活参数在部分推理密集任务上的天花板,需要与同类模型对比后再判断。
- 一个务实的判断:如果它的 API 价格确实落在行业中位数以下,那么最直接受益的是「把长上下文 + 多轮工具调用当作常态」的 Agent 应用——这类负载对单次调用成本最敏感。
 已知 vs 待验证
官方已证实(官方发布页):稀疏 MoE 架构、总参数 600B、激活参数 27B、1M Token 上下文、原生文本与视觉输入、面向 Agentic 场景的定位、模型 ID step-5-preview。
已由第三方评测证实(Artificial Analysis 模型页与 changelog):Intelligence Index 44 分(changelog 于 2026-09-18 收录);价格口径:输入 1.00、输出 2.70 美元/百万 token、混合价 0.51 美元/百万 token(基于阶跃 API,注明可能因供应商而异);单任务成本 0.72 美元/任务;该页常见问题直答「Step 5 Preview 不是开源模型,属专有,权重未公开」;同页写明「排名最高的开源权重模型为 GLM-5.3(45 分)」;输出速度 99.8 tokens/s、首 token 延迟 2.96 秒、智能指数 #24/200、评测输出 token 1.6 亿。
待核实:「单任务成本为 Opus 5 的 1/8」(厂商口径,未见计算方法);官方 API 定价页(未取到,正文价格采用 AA 转引口径并已标注);AA 的「开源模型」名次分类(未直接从其开源榜单页取到,故本文不使用「开源前三」这类名次表述);限免订阅的范围与期限;AA 指数之外的场景化第三方测评(尚无)。
 给读者的建议
- 正在做 Agent / 编程助手的团队:先用你自己的任务分布测两件事——长上下文下的稳定性、多轮工具调用的成功率;成本只在测算通过后再评估,因为官方没有给成本模型。
- 自建推理的团队:等 10 月 15 日的权重释放(如属实),激活参数量决定你的显存与并发规划;在权重到手前,不要按宣传倍数做容量预算。
- 做选型的团队:把「激活参数」加入对比表,与总参数、上下文、价格并列——它对推理成本的影响通常比总参数更直接。
- 读者提醒:把本条的分数与成本倍数当作待复现的主张;等权重释出与第三方评测出现后再做采购决策。
 来源
官方来源
- 阶跃星辰官方发布页《Step 5 Preview: Advancing the Pareto Frontier》(含 600B/27B/1M/视觉输入规格):阶跃星辰
独立来源
- Artificial Analysis(第三方评测机构):changelog 载明 2026-09-18 收录 Step 5 Preview、Intelligence Index 44;模型页给出价格(输入 1.00、输出 2.70 美元/百万 token,混合价 0.51)与每任务成本 0.72 美元,并写明「排名最高的开源权重模型为 GLM-5.3(45 分)」及「Step 5 Preview 属专有模型、权重未公开」:Changelog | Artificial Analysis | Step 5 Preview - Intelligence, Performance & Price Analysis | Artificial Analysis
- 界面新闻《阶跃发布旗舰模型 Step 5 Preview》(2026-09-20,含「10 月 15 日释放模型权重」):阶跃发布旗舰模型Step 5 Preview|界面新闻 · 快讯
- 品玩《阶跃星辰发布 Step 5 Preview 旗舰模型,单任务成本仅为 Claude Opus 5 的 1/8》(2026-09-20):阶跃星辰发布Step 5 Preview 旗舰模型 单任务成本仅为Claude Opus 5的1/8-品玩
- 每日经济新闻(经凤凰网转载)《阶跃星辰发布旗舰模型 Step 5 Preview》(2026-09-20):https://news.ifeng.com/c/8wZLR560Ohs