 一句话核心:9 月 21 日,xAI(官方页面以 SpaceXAI 名义运营)发布 Grok 4.7,定位为「面向编程与知识工作最强的模型」,官方称它「速度是同类模型的两倍、价格只有一半」。定价与上一代 Grok 4.6 持平:每百万输入 token 2 美元、输出 6 美元。第三方评测机构 Artificial Analysis 给出 Intelligence Index 46 分,称这一成绩把 SpaceXAI 带进全球前四的 AI 实验室。
 背景脉络
Grok 4.7 是 Grok 4.6 的下一代,官方给出的发布日是 2026 年 9 月 21 日。据 36氪/APPSO 的记述,它的发布比马斯克最初的预告晚了不少——7 月下旬开始吹风,之后是「再等几周」「十天之内」,最后变成「模型还得再调校调校」。因此这次发布没有把篇幅放在聊天体验或多模态上,而是集中强调四件事:长时间执行、自我检查、专业知识工作、价格性能比。
一句话概括它的位置:不是一次让所有人闭嘴的跨代更新,而是 xAI 在前沿模型混战区的一次补位(36氪/APPSO 的归纳)。
 关键细节
模型侧改动(官方页口径):
- 相比 Grok 4.6 换用更大的基础模型;强化学习训练更长、任务更难,其中相当一部分需要数小时才能完成;
- 加强了长上下文管理与结果核查能力,自称更擅长验证自己的工作;
- 针对 Grok Bot 运行环境做了原生训练,以提升对话任务与通用知识工作效率;
- 官方称其与 4.6 同价同速。
可用范围(发布当日):Cursor 与 Grok Build;同时通过 Grok API、第三方编码 harness、模型路由与云平台提供。另提供**「快速版」——输出速度为两倍、价格为两倍**。
安全能力(厂商自述):使用全新的安全防护体系;自称在其测过的模型里拒答与越狱抵抗力最强;LatchBio 生物安全基准 62.4%;在自建的高风险网络安全基准 HackerBench v0.3 上只放行 3.3% 的危险双重用途提示,同时尽量减少对正常安全研究的误拒;已向部分网络安全伙伴发放邀请制的红队能力访问。
第三方评测(Artificial Analysis,与厂商口径分开看):
- Intelligence Index 46 分(按 xhigh 推理档评测),比 Grok 4.6 高 2 分;
- AA-Briefcase(长程智能体知识工作)1657 Elo,比 Grok 4.6(high)高 111 分,仅次于 Claude Opus 5 与 Claude Fable 5.1;
- GDPval-AA 1695 Elo,比 Grok 4.6(high)高 90 分;
- Coding Agent Index 56 分(搭配 Grok Build),比 Grok 4.6(xhigh)高 9 分,在「使用各自原生 harness」的模型里排第 4,仅次于 Claude Fable 5.1、GPT-6 Astra、Claude Opus 5;分项为 DeepSWE v1.1 65%→73%、Terminal-Bench 4.0 18%→33%、SWE-Atlas-QnA 58%→63%;
- 有回退:AA-LCR −3.7 个百分点、AutomationBench-AA −1.1 个百分点;
- 上下文窗口 500k token,与 Grok 4.6 持平;推理档位可在 low 到 xhigh 之间配置。
 数据解读
一、厂商自测与第三方测出的数不一致,不能混用。
| 基准 | xAI 官方页(厂商自测) | Artificial Analysis(独立 harness) |
|---|---|---|
| Terminal-Bench 4.0 | 38.0% | 33% |
| DeepSWE v1.1 | 71.0% | 73% |
同一个基准、同一个模型,两家给出的百分数并不相同——原因是评测 harness 不同(AA 明确区分「用各自原生 harness 的结果」与「标准化 harness 的 Intelligence Index 结果」)。跨来源的分数不可直接拼接比较。
二、官方页并列了竞品价格,价格战意味明显。
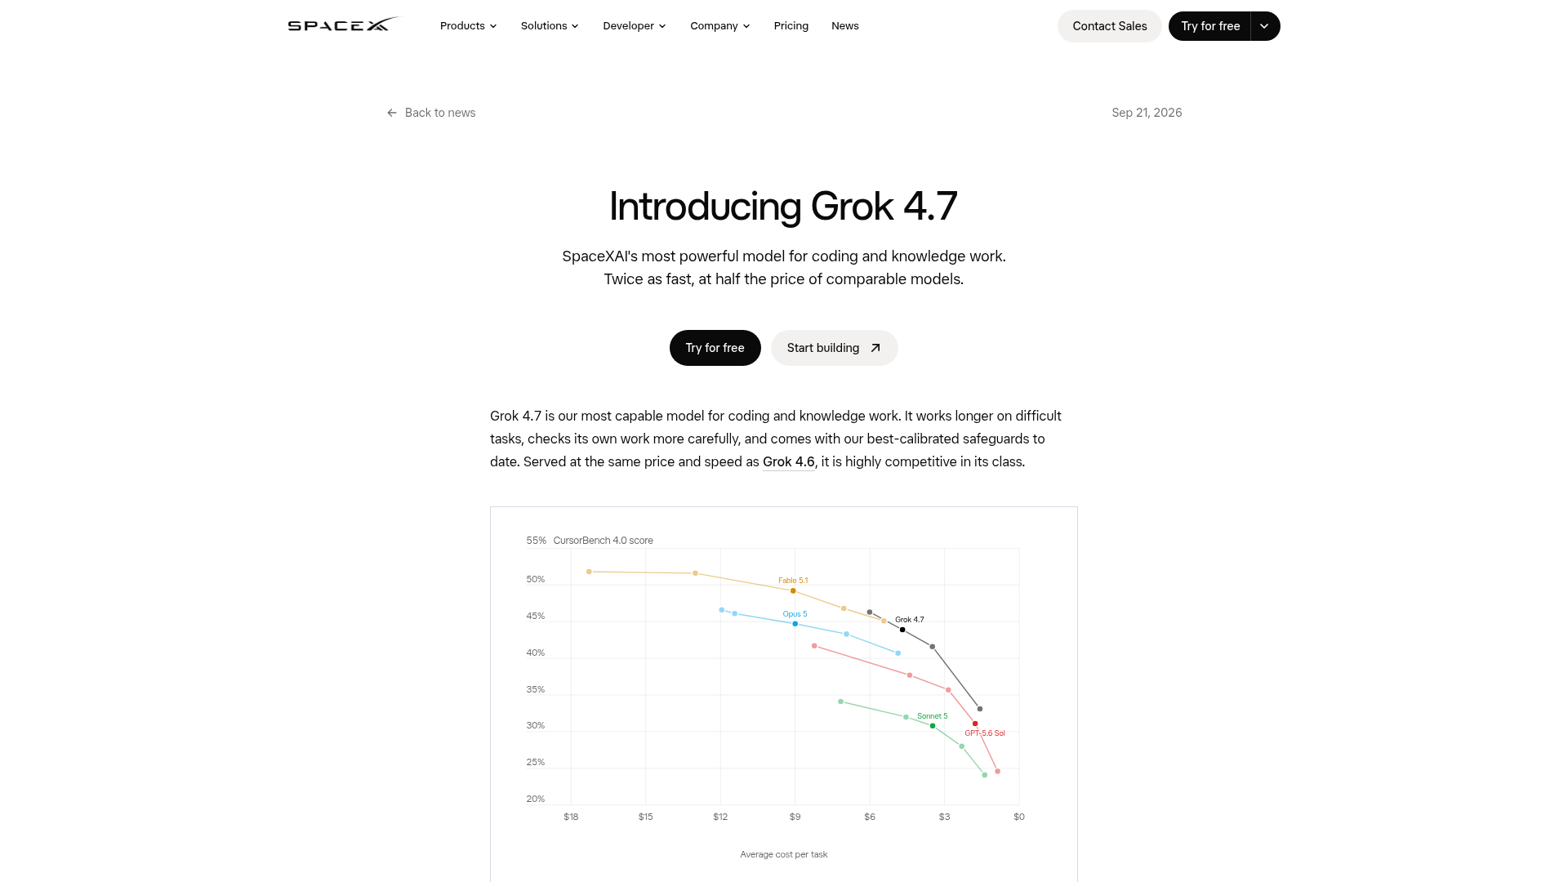
官方对比表同时列出:Grok 4.7(xHigh)$2 / $6、Grok 4.6(High)$2 / $6、GPT-5.6 Sol Max $4 / $20、Fable 5.1 Max $10 / $50(单位:美元/百万输入、输出 token)。这四列数字出自 xAI 官方页,其中竞品价格系厂商引用,本文未独立核实。
三、便宜不等于总成本低:它的 token 用量显著更高。
AA 测得 Grok 4.7(xhigh)每个 Intelligence Index 任务约消耗 81k 输出 token,而 Grok 4.6(high)约 36k、GPT-6 Astra(max)约 27k——分别高出 125% 与 196%。AA 同时测得长提示下输出速度约 188 token/秒、每个 Intelligence Index 任务平均耗时约 7.1 分钟。
结论:单价与上一代持平,但单任务用量翻倍以上,所以「接入一个任务要花多少钱」要按 token 用量重算,不能只看每百万 token 标价。
 价格与成本
- 输入 2 美元/百万 token,输出 6 美元/百万 token——与 Grok 4.6 相同(官方新闻页与 AA 两处一致);
- 缓存命中 0.50 美元/百万 token——此项由 Artificial Analysis 列出,官方新闻页未列,本文未在官方定价文档中核到;
- 快速版:输出速度两倍、价格两倍(官方页;正式名称与独立定价未披露);
- 成本重算提醒:若按 AA 测得的 token 用量(+125%~196%)估算,单价持平并不等于单位任务成本持平。
 辩证评估
- 为什么值得跟:这是 9 月里少见的、同时给出官方定价与第三方评分的模型发布——价格有官方页与 AA 双向一致,能力有 AA 的独立 harness 数据,读者可以据此做初步选型,而不是只看厂商跑分。
- 反向视角:
- 其一,厂商自测的「全面进步」经第三方复核后打了折扣:36氪/APPSO 对照官方表指出,Grok 4.7 在 CursorBench 4.0 与 Terminal-Bench 4.0 上低于 Fable 5.1 Max,在 DeepSWE v1.1 上略低于 GPT-5.6 Sol Max——优势主要集中在价格与部分专业任务,综合成绩并未全面领先;
- 其二,AA 的数据也显示它是「偏科」的提升:agentic 知识工作与编码代理明显前进,但其他 Intelligence Index 任务基本与 4.6 持平,且有两项回退;
- 其三,开发者实测口碑两极:正面如用《帝国时代 II》演示项目对比 4.6/4.7、按平面图搭 Blender 结构再导出 Three.js、模拟单行道交通灯;AI/ML API 在四个 Three.js 太空场景上比较 Grok 4.7 与 Claude Opus 5,称前者约花 0.20 美元、后者约 2.05 美元且在三个场景中更快。负面则有开发者认为其3D 与前端表现低于预期——物理效果生硬、提示理解不稳定、token 消耗过快,另有 Airbus H145 直升机模型逊于 4.6、鹈鹕骑车 SVG 动画受诟病(以上均为 36氪/APPSO 汇总的开发者个案,非受控评测);
- 其四,「两倍速、一半价」是厂商的相对声称,未给出可比对象的选取标准,读者不宜直接当结论引用。
- 与本周其他条目的关系:把这条与 163(Grok Voice Transcribe 2.0,同为 xAI 但属语音转写品类)分开看,两者不是同一件事,不应合并;而与 162(阶跃 Step 5 Preview)、153(智谱 GLM-5.3-FlashX)并置,可以看到**「低价+长任务+可核查」正在成为这一轮模型发布的共同卖点**。
 已知 vs 待验证
已证实:发布与官方页日期(2026-09-21);定价 $2/$6 每百万 token(官方页与 AA 一致);发布当日可用范围(Cursor、Grok Build、Grok API 等);「快速版」双速双价;官方页所述的技术方向(更大基座、更长强化学习、长上下文与自我核查、Grok Bot 原生理解);AA 的第三方评分(46)、Code Agent Index 56、上下文 500k、输出速度 约 188 token/秒、缓存价 $0.50。
待验证 / 未公布:
- 参数规模不是官方规格——官方新闻页未载;「2.1 万亿」出自马斯克本人此前的表述与部分媒体转写,本文不将其列为官方数据(另有消息称下一代 Grok 4.8 约 2.5 万亿并采用新的 C++ 训练栈,同为马斯克口径);
- 模态能力官方页未列,本文不推断;
- 官方定价文档未在本次核实——缓存计费与「快速版」正式定价以官方文档为准;
- 无第三方对该模型「长任务」卖点的受控复现,AA 给的是基准分,不是真实工作流验证。
 给读者的建议
- 已在 Cursor / Grok Build 上的开发者:Grok 4.7 与 4.6 同价,可以直接做 A/B;但请按 token 用量重算成本——第三方测得其单位任务用量比 4.6 高出一倍以上,用量大的批处理场景未必更省。
- 做模型选型的技术负责人:不要拿厂商自测表跨模型拼排名;本条的可用依据是 AA 的独立 harness 数据(46 分 / Coding Agent Index 56 / 4th)。若任务集中在长程编码与文档类知识工作,它进入候选;若涉及复杂 3D、前端视觉与物理效果,开发者反馈并不一致,建议自测。
- 关注成本的团队:把「每百万 token 单价」与「每任务 token 用量」分开记账,缓存命中价($0.50)对可复用提示词场景影响较大。
- 内容写作者:请写「官方称速度两倍、价格一半」,不要写成已获独立验证的结论;引用竞品价格时须注明系 xAI 官方页并列列出、未经独立核实。
 来源
官方来源
- xAI(SpaceXAI)官方新闻页《Introducing Grok 4.7》(页标 Sep 21, 2026;含官方定位、技术说明、对比基准表与定价):https://x.ai/news/grok-4-7
独立来源
- Artificial Analysis《Benchmarking Grok 4.7》(第三方评测,含 Intelligence Index 46、Coding Agent Index 56、AA-Briefcase/GDPval-AA、token 用量、上下文 500k 与缓存价):Benchmarking Grok 4.7 | Artificial Analysis
- Artificial Analysis 模型页 Grok 4.7 (xhigh):Grok 4.7 (xhigh) - Intelligence, Performance & Price Analysis | Artificial Analysis
- 36氪/APPSO《刚刚,马斯克交卷 Grok 4.7,但这次吹牛吹大了》(2026-09-21 20:01;含发布推迟经过、与官方表的横向对照、开发者实测口碑):https://www.36kr.com/p/3993727976389381
说明:本条为 9 月 21 日的模型发布,非当日(9/22)事件,正文日期按官方页标注。凡厂商自测与第三方评测数据,本文均已分列标注;未获官方确认的参数与规格不作事实陈述。