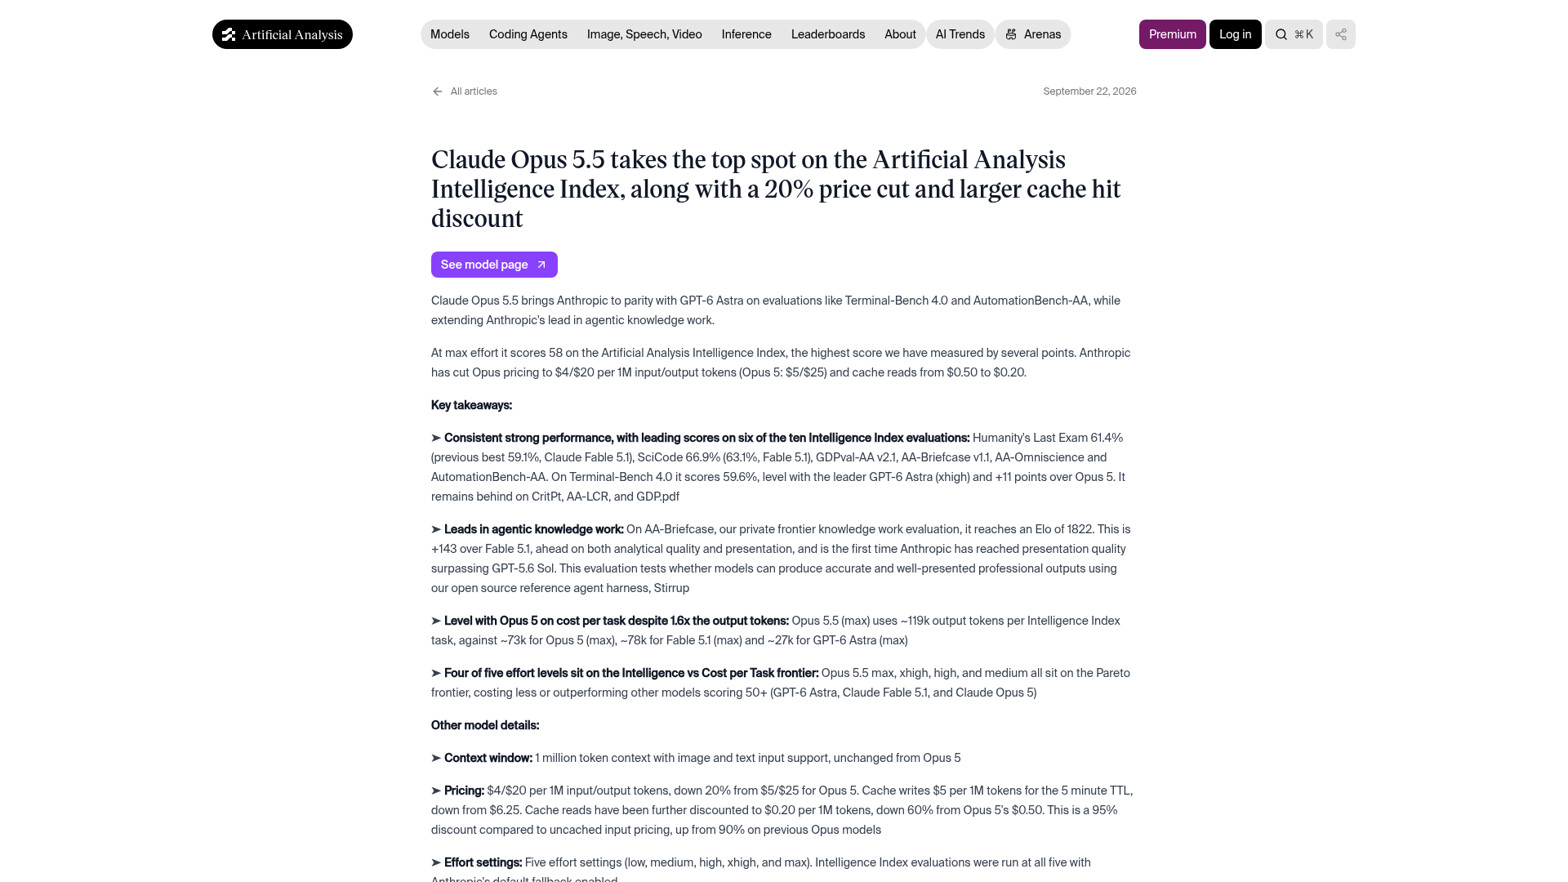
 一句话核心:9 月 22 日,Anthropic 发布 Claude Opus 5.5——官方称其为「Claude 5.5 家族的第一个模型」,「在多数工作上达到 Fable 5.1 的水平,运行成本比 Opus 5 低 40%」。第三方评测机构 Artificial Analysis 给出综合智能指数 58 分,是它迄今测到的最高分;同时输入 4 美元/输出 20 美元每百万 token(较 Opus 5 降 20%)、缓存读取降至 0.20 美元(降 60%)。
 背景脉络
- 这是 Opus 线,不是 Fable 线:Opus 5.5 是 Opus 5 的下一代;9 月初发布的 Claude Fable 5.1 属另一条产品线(且有读者可能记得的 topic 70/73)。官方明写 Opus 5.5「在多数工作上达到 Fable 5.1 的水平」。
- 它是 Anthropic 呼吁「为前沿发展减速」之后的第一次发布;官方称发布前经外部评估方测试,包括 Frontier Design 与 METR。
- 同一天的两场降价:约 90 分钟后(同日),OpenAI 发布 GPT-6 Sol 与 Luna 并把 API 价格较其 GPT-5.6 促销价下调 50%。两家把「价格与缓存成本」摆上了同一天的台面。
- 后续:官方称 Claude Sonnet 5.5 与 Haiku 5.5 将在未来数周跟进。
 关键细节
定价(官方页「Pricing」表,单位:每百万 token)
| 项目 | Claude Opus 5.5 | Claude Opus 5 | 变化 |
|---|---|---|---|
| 输入 token | $4 | $5 | −20% |
| 输出 token | $20 | $25 | −20% |
| 缓存写入 | $5 | $6.25 | −20% |
| 缓存读取 | $0.20 | $0.50 | −60% |
- 快速模式(Fast mode,Claude Code 与 Claude Platform):最高 2.5 倍速,$8/百万输入、$40/百万输出。
- 官方称输出速度比 Opus 5 快 30% 以上。
规格与可用性
- 1M token 上下文,支持图像与文本输入(与 Opus 5 一致,AA 亦确认);
- 五档 effort:low/medium/high/xhigh/max(AA 五档全测,启用官方默认回退);
- 订阅侧:Pro/Max/Team/席位制 Enterprise 的 5 小时用量上限提高,并提供可保存的速率限制重置;
- 安全口径:生物与网络安全能力「与 Claude Mythos 5.1 相当」,故采用与 Fable 5.1 相似的防护部署;已开放生命科学验证计划申请,未来数周扩大网络安全验证计划。
第三方读数(Artificial Analysis,独立 harness)
- 综合智能指数 58 分(max 档)——AA 迄今最高分,比此前榜首「高出数分」;
- 十项评测中六项领先:Humanity’s Last Exam 61.4%(此前最佳 59.1%,即 Fable 5.1)、SciCode 66.9%、GDPval-AA v2.1、AA-Briefcase v1.1、AA-Omniscience、AutomationBench-AA;
- Terminal-Bench 4.0:59.6%,与榜首 GPT-6 Astra(xhigh)持平,比 Opus 5 高 11 分;
- AA-Briefcase 1822 Elo(比 Fable 5.1 高 143);GDPval-AA v2.1 1846 Elo;
- 仍落后于三项:CritPt、AA-LCR、GDP.pdf;
- 五个 effort 档中有四档(max/xhigh/high/medium)落在「智能 vs 每任务成本」帕累托前沿上。
 数据解读
一、两个百分比不能混——它们的「分母」不同
| 说法 | 出自 | 口径 |
|---|---|---|
| 运行成本低 40% | Anthropic 官方 | 工作负载级(含 token 效率),官方原文限定「在默认设置下、典型工作负载」 |
| 每 token 价格降 20% | Artificial Analysis(并可据官方价格表复算) | 单价级($5→$4、$25→$20) |
⇒ 不得写成「降价 40%」。 两个数字都对,但回答的不是同一个问题。
二、厂商自测与第三方测出的数不一致,不能拼接
| 基准 | Anthropic 官方页(厂商自测) | Artificial Analysis(独立 harness) |
|---|---|---|
| Terminal-Bench 4.0 | 66.4%(xhigh effort) | 59.6% |
官方页另注明:该行的 GPT-6 Astra 与 GPT-5.6 Sol 数字「取自 OpenAI 的报告」(as reported by OpenAI),不是同条件对测。跨来源分数不可直接比较。
三、单位任务 token 用量:官方与第三方给出的方向相反
- 官方:Opus 5.5「每 token 更便宜且每任务用的 token 更少,合计成本下降 40%」;
- AA(max 档):每任务输出 token 约 119k,而 Opus 5(max)约 73k、Fable 5.1(max)约 78k、GPT-6 Astra(max)约 27k。
两者不是同条件(官方默认档/典型工作负载 vs AA 的 max 档/AA Intelligence Index 任务集),不能直接对撞;但可以确定的是:「更省」这个结论强依赖你跑的是什么任务、用哪一档 effort。AA 的净结论是——每任务成本与 Opus 5 持平(不是更低)。
 价格与成本
- 四项计价全部下调:输入 $4(−20%)、输出 $20(−20%)、缓存写 $5(−20%)、缓存读 $0.20(−60%);
- 缓存读相对未缓存输入是 95% 折扣(此前 Opus 系列为 90%)——这一项对长上下文、反复复用上下文的 agent 与编码工作影响最大,AA 亦指出「缓存读取占 agent 与编码工作成本的大头」(官方表述);
- 快速模式:2.5 倍速对 $8/$40(即 2 倍单价)——速度是按倍数单独出售的,与已发的 153(智谱 GLM-5.3-FlashX「速度按 2.5 倍价格单独出售」)属同一产品设计思路;
- 同日横比(据两家官方页,均为每百万 token):Opus 5.5 $4/$20;GPT-6 Sol $2/$10。同一日两家旗舰的挂牌价差一倍,但各自的能力结论不同(见本条的辩证评估)。
 辩证评估
- 为什么值得跟:这是当天最完整的一条「模型发布 + 计价结构」信息——输入、输出、缓存写、缓存读四项全有对比基准,且首次出现 AA 与官方同时可用的第三方读数;对本社区读者,缓存读取的价格变化比榜单分数更有实际影响。
- 反向视角:
- 其一,「登顶」是单一评测机构(AA)的结论,且 AA 自己在同一篇里明列它仍落后于 CritPt、AA-LCR、GDP.pdf 三项;
- 其二,厂商自己给分数加了限:官方原文写「在这些能力水平上,benchmark 的边际差异已不再是现实差异的可靠指引」,并称「Opus 5.5 与 Fable 5.1 之间的差距比这些分数看起来更小」——这话出自厂商,值得记住;
- 其三,每任务 token 用量更高(AA 数据)意味着高用量、长任务场景未必更省;「成本降 40%」是官方在其选定工作负载上的口径;
- 其四,官方对比表中的竞品数字取自竞争对手的公开报告,非同条件对测;而官方自己的部分基准(AutomationBench、Gray Swan 提示注入)是由第三方机构执行,可信度分层不同,须逐项看;
- 其五,安全类结论(行为审计「史上最佳」、越狱抵抗力)主要为厂商自述,本次未取到系统卡全文;
- 其六,同日 OpenAI 也降了价——单看一条会误以为降价是 Anthropic 的单方面动作,两条要并读。
- 与本周其他条目的关系:与 165(美中 AI 对话机制)、148(广电总局视听 AI 规范)等治理类条目不同,本条是纯产业与成本线;与 152/153(千问、智谱的定价结构)可组成「模型定价结构怎么读」的一组:输入/输出之外,缓存、速度、Batch 都是独立计价项。
 已知 vs 待验证
已证实(官方页 + AA 双向):发布与日期(2026-09-22);输入 $4/输出 $20、缓存写 $5、缓存读 $0.20;快速模式 $8/$40、最高 2.5 倍速;1M 上下文、图像+文本输入;五档 effort;Sonnet 5.5/Haiku 5.5 将在数周内跟进;订阅用量上限提高;AA 的 58 分与各项第三方读数(HLE 61.4%、Terminal-Bench 4.0 59.6%、AA-Briefcase 1822 Elo、GDPval-AA 1846 Elo、五项中四档上帕累托前沿)。
待验证 / 未取到:
- 参数量未公布;
- 系统卡(Opus 5.5 System Card)全文未读,安全结论按官方公告页表述转述;
- 「运行成本低 40%」的测算方法与工作负载构成未公开;
- Batch API 折扣:本次未在官方公告页核到,故本文不列;
- 官方对比表中的竞品分数取自对方公开报告,无法在同条件下复现。
 给读者的建议
- 重度使用缓存/长上下文的团队:先看缓存读取价。$0.50→$0.20 这一项对反复复用同前缀的 agent 与编码工作影响最大,可能比单价降 20% 更实质。
- 做模型选型的负责人:不要拿厂商自测表与第三方分数拼排名——本条的 Terminal-Bench 4.0 在两侧是 66.4% vs 59.6%;可用的排序依据是 AA 的独立 harness(58 分、十项中六项领先、三项落后)。若任务落在 CritPt/长上下文推理(AA-LCR)/GDP.pdf 一侧,不建议仅凭总分选型。
- 按量计费的采购:把「每 token 单价」与「每任务 token 用量」分开记账——官方说用量更少、AA 在 max 档测出用量更多,两者条件不同;请用自己业务的代表性任务实测再外推。
- 内容写作者:请写「官方称运行成本低 40%」与「每 token 价格降 20%」两句分开,不要合成「降价 40%」;引用「登顶」时须注明是 Artificial Analysis 这一指数的结论,并带上 AA 明列的三项落后。
 来源
官方来源
- Anthropic《Introducing Claude Opus 5.5》(页标 September 22, 2026;含定价表、快速模式价格、基准表与厂商口径说明):Introducing Claude Opus 5.5 \ Anthropic
- Anthropic Opus 5.5 系统卡(本文未读全文,列此备查):https://anthropic.com/claude-opus-5-5-system-card
- Anthropic Newsroom(标 Announcements Sep 22, 2026):Newsroom \ Anthropic
独立来源
- Artificial Analysis《Claude Opus 5.5 takes the top spot on the Artificial Analysis Intelligence Index, along with a 20% price cut and larger cache hit discount》(2026-09-22,58 分与全部第三方读数出自此处):Claude Opus 5.5 takes the top spot on the Artificial Analysis Intelligence Index | Artificial Analysis
- Artificial Analysis 模型页 Claude Opus 5.5:Claude Opus 5.5 (max with fallback) - Intelligence, Performance & Price Analysis | Artificial Analysis
说明:本条事件时间为 2026 年 9 月 22 日。厂商自测与第三方读数已分列标注;「运行成本低 40%」与「单价降 20%」两种口径均按原来源写明,未合成。