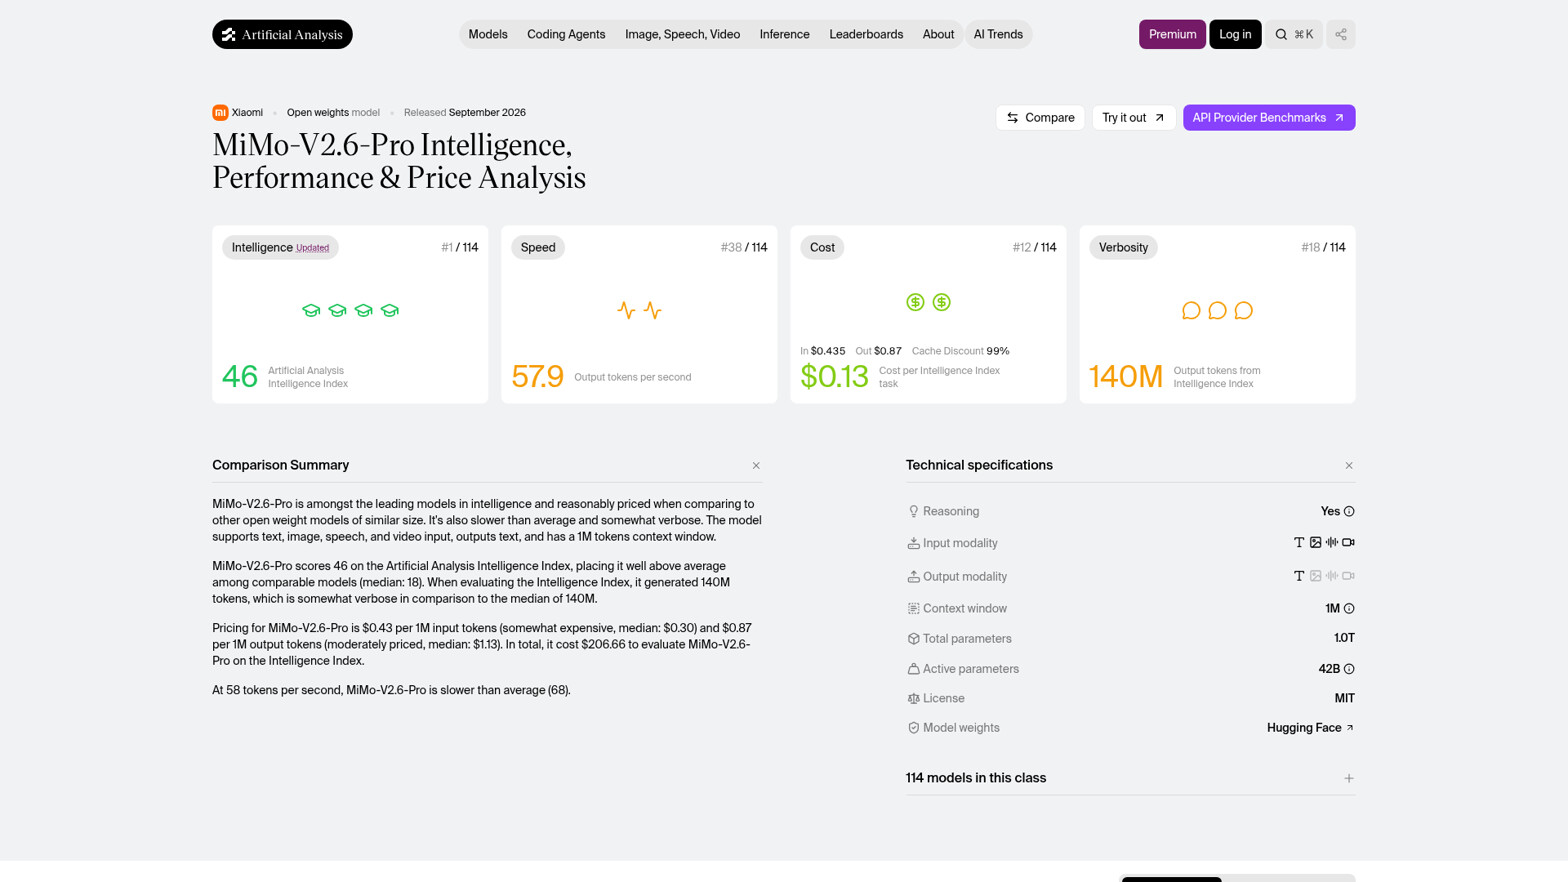
 一句话核心:9 月 22 日,小米发布并开源 MiMo-V2.6 系列(Pro/Flash,两款均为原生全模态)。第三方评测机构 Artificial Analysis 给 MiMo-V2.6-Pro 智能指数 46 分——这是其开源权重榜上的最高分。更少见的是小米把整轮强化学习的账公开了:6 天内两个模型各完成 30 步、约 75 万条轨迹,成本约 85 万美元(Flash)/262 万美元(Pro),并开源技术报告、训练环境与 RL 代码。API 定价沿用上一代 V2.5 不变。
 背景脉络
- 系列构成:MiMo-V2.6-Pro(官方称「迄今最强」)、MiMo-V2.6-Flash(智能/效率/成本平衡),以及 MiMo-V2.6-Pro-UltraSpeed(官方称同质量下输出速度最高 20 倍)。
- 官方给的定位是「RSI 路径上的一步」——在可验证的复杂任务上扩强化学习算力,让模型靠探索与反馈持续扩展能力边界。
- 开源范围:模型权重之外,还开放完整技术报告、训练环境与 RL 代码,官方邀请研究者复现与核验。
- 与前代的关系:V2.5 → V2.6,API 价格不变——本次是「同价买更高智能」,而非降价。
 关键细节
官方 API 定价(官方页表格,美元/百万 token)
| 模型 | 输入(缓存命中) | 输入(缓存未命中) | 输出 |
|---|---|---|---|
| MiMo-V2.6-Flash | $0.0028 | $0.14 | $0.28 |
| MiMo-V2.6-Pro | $0.0036 | $0.435 | $0.87 |
| MiMo-V2.6-Pro-UltraSpeed | $0.036 | $4.35 | $8.70 |
官方并注明:缓存写入限时免费;人民币价格另见其计价页。
规格(Artificial Analysis 模型页标注)
- 总参 1.0T/推理时激活 42B;上下文 1M;
- 输入模态:文本+图像+语音+视频;输出为文本;支持推理;
- 许可标注为 MIT;权重托管在 Hugging Face(
XiaomiMiMo/MiMo-V2.6-Pro-RL)。
强化学习:本条的独特价值在于「把账摊开」
- 6 天内,Flash 与 Pro 各完成 30 个 RL 步、累计约 75 万条轨迹,成本分别约 85 万美元与 262 万美元;
- 训练任务平均通过率相对提升 25%(Flash)与 12%(Pro);
- 样本外长程软件工程基准 DeepSWE v1.1 提升约 17 分(48.8→65.68)与约 14 分(58.4→72.57);
- 训练规模:单次更新 1,568 个样本、最高 1M 上下文训练、单步 3.5–3.7B token;
- 稳定性措施:冻结 MoE router 以抑制训练漂移;建立覆盖奖励设计、对抗评估、异常检测与验证器交叉核对的reward hacking 防线。
第三方读数(Artificial Analysis)
- 智能指数 46 分,为该榜 114 个模型中的第 1 名;
- 每个 Intelligence Index 任务成本 $0.13(该榜第 12 名);
- 输出速度 57.9 token/秒——AA 明写「低于平均(68)」;「啰嗦度」列它 1.4 亿输出 token(第 18 名);
- AA 的评语:在同类开源权重中「智能领先且定价合理」,但「偏慢、偏啰嗦」。
官方自测基准(厂商口径,仅供参照):DeepSWE v1.1 Pro 71.9/Flash 67.9;GDPVal 2.1 (AA) Pro 1673;Terminal Bench 4.0 Pro 34.9;OSWorld-Verified Pro 82.0;CyberGym Pro 94.0/Flash 95.1。
 数据解读
一、「最强开源」的口径要看清楚
- 官方表述:「超越 Kimi K3 与 Qwen3.8 Max,成为迄今最强开源模型」;
- Artificial Analysis 的开源对比页则写「MiMo-V2.6-Pro 与 GLM-5.3(max)是智能最高的开源模型」,随后是 Kimi K3(max)与 GLM-5.3-Flash;两者的分数是 46 与 45——只差 1 分。
- ⇒ 可写的结论是「在 AA 智能指数上为开源权重最高分(46),第二名 GLM-5.3(max)45」,而不是无条件的「最强开源」。
二、「46.32」与「46」不是矛盾,是口径
官方页写 46.32,AA 标 46(取整)。同一个指数、不同精度,写稿取整并注明来源即可。
三、三种「价格」不是一回事,不能互相换算
| 口径 | 数值 | 出处 |
|---|---|---|
| 每 token 单价(缓存未命中) | 输入 $0.435/输出 $0.87 | 官方定价表 |
| 每 Intelligence Index 任务成本 | $0.13 | Artificial Analysis |
| 混合价(榜上单价列) | $0.2 | Artificial Analysis(混合口径,本文不采用) |
「$0.13 一次任务」不等于「$0.13 每百万 token」——前者含任务 token 用量,后者只是单价。
四、与同日两家闭源旗舰的对照值得记一笔
同一天(9/22)Anthropic Opus 5.5 与 OpenAI GPT-6 Sol/Luna 都是降价(单价分别 −20%、−50%);小米这条路走的是「价格不变、把智能抬上去」。三种做法都指向同一件事:前沿能力的单位成本在快速下降,只是降的路径不同。
 价格与成本
- 三档定价见上表;UltraSpeed 是速度档——单价约为 Pro 的 10 倍($4.35/$8.70 对 $0.435/$0.87),换的是最高 20 倍输出速度。这与已发的 153(智谱把速度按 2.5 倍价格单独出售)、168(Opus 5.5 的 2.5 倍速档 $8/$40)是同一产品设计思路。
- 缓存命中价极低(Flash $0.0028/Pro $0.0036 每百万 token)——对同一前缀反复复用的 agent 场景意义大;官方另称缓存写入限时免费。
- 本次不降价:官方明写「沿用 V2.5 的价格」。所以该看的不是价格,而是同价位上智能指数从 26(MiMo-V2.5-Pro)抬到 46。
 辩证评估
- 为什么值得跟:这是少见的「发布即给全套可复现材料」——权重的许可宽松(AA 标 MIT)、RL 的步数、轨迹量、真实成本与训练环境一并公开。在多数发布稿只给分数的环境里,这条对想自己跑 RL 的团队有直接价值。
- 反向视角:
- 其一,「最强开源」只对 AA 的智能指数成立,且与 GLM-5.3(max)仅差 1 分;放到全部模型里,46 分仍低于同日发布的 Opus 5.5(58)与 GPT-6 系列——「最强开源」不等于「最强」;
- 其二,AA 明确点出其短板:输出速度 57.9 token/秒,低于平均(68);输出偏啰嗦(1.4 亿 token)。对时延敏感的交互场景,这两点比分数更重要;
- 其三,官方基准表是厂商自测;引用时须标口径,不得与 AA 的独立读数拼接(本社区昨日已立此规则);
- 其四,能力类案例(材料科研、Lean 4 形式化、具身仿真)均为厂商口径,我未读技术报告全文;
- 其五,「MIT 许可」出自 AA 的模型页标注,我未在官方发布页或 Hugging Face 页核到许可文本——开源自托管前请以仓库里的 LICENSE 为准;
- 其六,RL 成本的数字是厂商自报(含口径未公布的「成本」构成),无第三方复核。
 已知 vs 待验证
已证实(官方页 + AA 双向):发布与开源(2026-09-22);三档模型的官方 API 单价与「沿用 V2.5 定价」;1.0T 总参/42B 激活、1M 上下文、文本+图像+语音+视频输入(AA 标注);RL 的 6 天/30 步/约 75 万轨迹与约 85 万/262 万美元(官方页);AA 的智能指数 46(#1/114)、每任务成本 $0.13、输出速度 57.9 token/秒(低于平均 68)。
待验证 / 未取到:
- 许可为 MIT —— AA 页标注,未见官方 LICENSE 文本核;
- 官方与 Hugging Face 的具体仓库内容、技术报告全文未读;
- RL「成本」的计量口径未公开(是否含集群折旧、评测开销等);
- 无第三方复现——官方邀请复现,但目前只有厂商自述。
 给读者的建议
- 想自托管或压成本的团队:先看两件事——许可(以仓库 LICENSE 为准)与速度(AA 测得低于平均)。智能分数领先不等于适合你的时延预算。
- 做选型的负责人:把「最强开源」这句话还原为「在 AA 智能指数上最高(46),第二名 45」;若你的场景在 Kimi K3 或 GLM-5.3 的优势区间,两者的分差不足以覆盖迁移成本。
- 做 RL / 后训练的研究者:技术报告 + 训练环境 + RL 代码已开源,且有步数、轨迹量、成本与样本外提升的完整曲线——这是本条最值得实际取用的部分。
- 内容写作者:写「在 Artificial Analysis 智能指数上是开源权重最高分」,不要写无条件的「最强开源模型」;引用价格时区分「每 token 单价」与「每任务成本」;「MIT 许可」请加「据 AA 标注」。
 来源
官方来源
- 小米《Introducing MiMo-V2.6 series》(页标 September 22nd, 2026;含开源范围、RL 训练细节与成本、官方 API 定价表与全部厂商自测基准):https://mimo.xiaomi.com/mimo-v2-6
- 小米官方技术说明(页末标更新时间 2026-09-22):https://mimo.mi.com/docs/zh-CN/news/latest/v2-6
独立来源
- Artificial Analysis 模型页 MiMo-V2.6-Pro(智能指数 46、#1/114、$0.13 每任务、57.9 token/s、1.0T/42B、1M 上下文、许可 MIT):https://artificialanalysis.ai/models/mimo-v2-6-pro
- Artificial Analysis 开源模型对比页(「MiMo-V2.6-Pro 与 GLM-5.3(max)是智能最高的开源模型」及完整开源榜):https://artificialanalysis.ai/models/open-source
说明:本条事件时间为 2026 年 9 月 22 日。厂商自测与第三方读数已分列标注;官方页与 AA 两处的「46.32/46」「每 token 单价/每任务成本」均已按各自口径写明,未做换算。