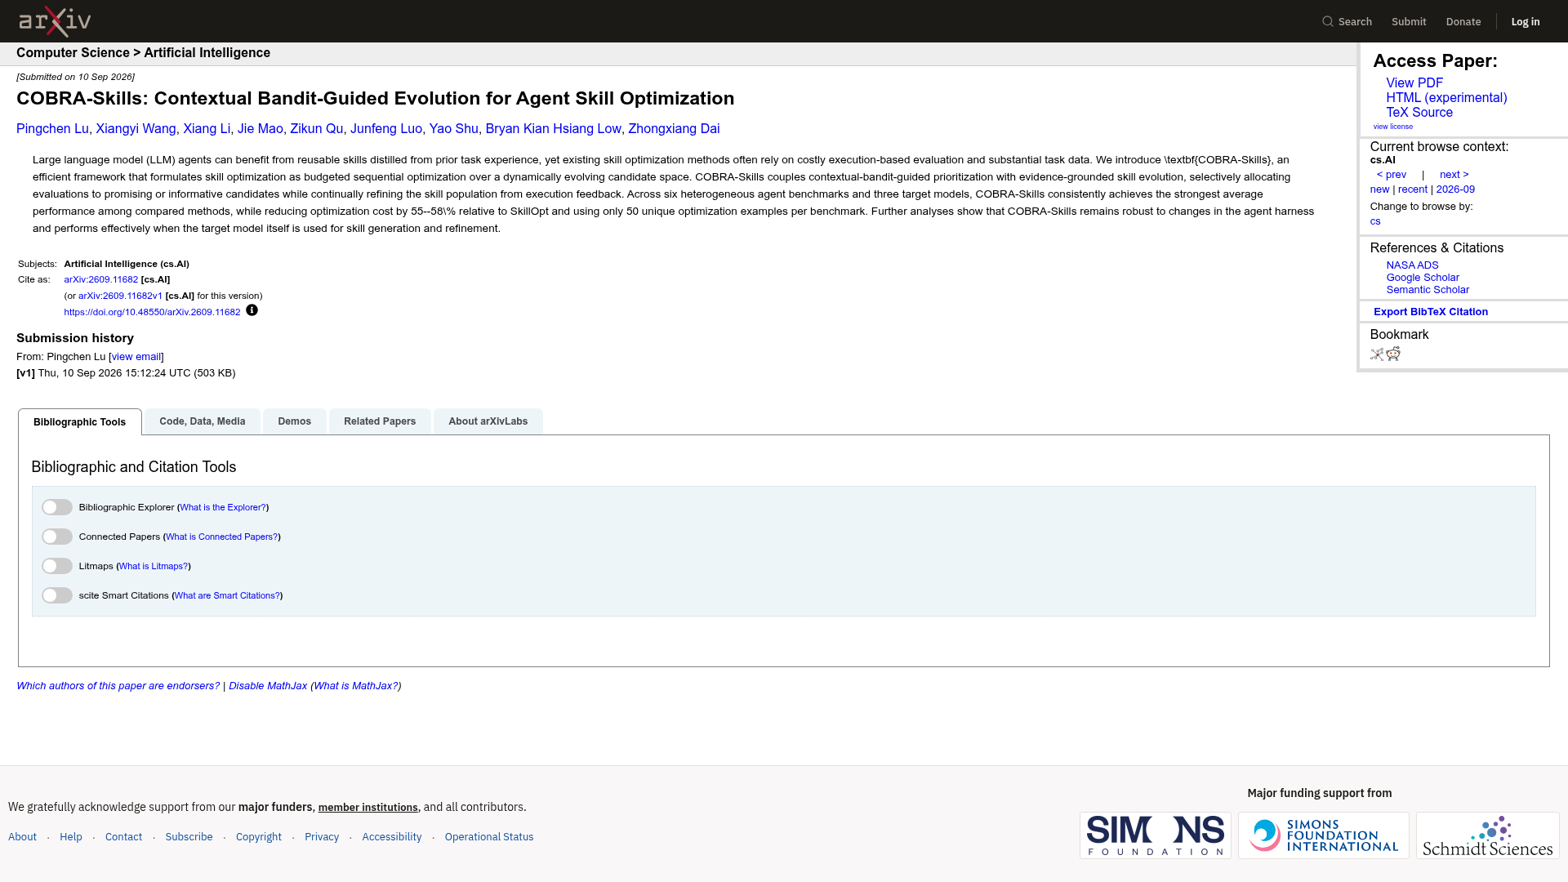
 一句话核心:这是一篇讲「怎么用最少的评测预算把 Agent 技能调好」的论文(arXiv:2609.11682,v1 2026-09-10)。它把技能优化建模为「在动态演化的候选空间上做预算受限的序列优化」——用上下文老虎机(contextual bandit)给候选技能排序、把评测预算优先分给有潜力或信息量大的候选,再据执行反馈持续演化技能种群。摘要称:在六个异构 agent benchmark、三个目标模型上平均表现最强,优化成本比 SkillOpt 降低 55–58%,且每个 benchmark 只用 50 个唯一优化样本。
 它要解决什么问题
技能(skills)能从既往任务经验里沉淀、复用,但现有技能优化方法普遍依赖昂贵的「执行式评估」与大量任务数据——「验证一个技能到底有没有用」这件事本身就是开销。
本站此前已经沿着这条线发过两篇:147(用 Δ 与 CI 门禁证明一个 Skill 真有用)讲的是「怎么证明」;本条回答的是同一问题的成本侧——评测预算有限时,怎么把技能调到最好。
 方法(据摘要)
- 形式化:把技能优化看作动态演化候选空间上的「预算受限序列优化」;
- 两个耦合机制:
- 上下文老虎机引导的优先级排序——把评测选择性地分配给有潜力或信息量大的候选,而不是平均地全测一遍;
- 基于证据的技能演化——用执行反馈持续精炼技能种群;
- 稳健性(摘要自述):对 agent harness 的变化保持稳健,且当目标模型本身被用来做技能生成与精炼时同样有效——这一点对自建流水线的团队尤其相关。
 关键数字(均出自摘要,正文未读)
| 项目 | 摘要给的数字 |
|---|---|
| 覆盖范围 | 六个异构 agent benchmark × 三个目标模型 |
| 相对表现 | 在所对比方法中平均表现最强 |
| 优化成本 | 比 SkillOpt 降低 55–58% |
| 样本量 | 每个 benchmark 只用 50 个唯一优化样本 |
| 稳健性 | 对 harness 变化稳健;可用目标模型自身做技能生成与精炼 |
 与本站已有内容的定位
- 147(Claude Code plugin eval 与 Δ 门禁)=怎么证明一个技能有用;
- 本条(COBRA-Skills)=怎么用更少预算把它调到有用;
- 146(SKILL.md 规范逐字段解读)=定义侧;159(NVIDIA SkillSpector)=安全扫描侧;155(Plugin4Shell)=供应链风险侧。
另附一条背景文献(本站尚未单独发过):学界已开始把「Agent Skills」当作独立抽象层系统化——arXiv:2602.12430《Agent Skills for Large Language Models: Architecture, Acquisition, Security, and the Path Forward》(v1 2026-02-12、最新版 v4 2026-06-02)沿四个轴组织该领域:架构基础(SKILL.md 规范、渐进式上下文加载、技能与 MCP 的分工)、技能获取(技能库上的强化学习、自主技能发现 SEAgent、组合式技能合成)、规模部署(CUA 栈、GUI grounding、OSWorld 与 SWE-bench 进展)、安全。其摘要中最常被引用的一句是:
recent empirical analyses reveal that 26.1% of community-contributed skills contain vulnerabilities(摘要原文)
并据此提出 Skill Trust and Lifecycle Governance Framework——一个四层、以「门」为单位的权限模型,把技能来源映射到分级部署能力;文末另列七项开放挑战。
两条引用纪律(本站已踩过同类坑,务必保留):
- 「26.1%」是摘要转引的「近期实证分析」结果,不是该综述自测 ⇒ 引用须写「据该综述引用的实证分析」;
- 该综述自称与既有的泛谈 LLM agent/工具调用的综述不同(摘要原文 “Unlike prior surveys that broadly cover LLM agents or tool use…”)⇒ 写「作者称」,不作学界定论。
 成本口径(这篇的成本是「评测预算」)
- 这里的「成本」是优化成本(跑评测与迭代的花费),对比基线是 SkillOpt,降幅 55–58%;
- 「50 个样本」= 每个 benchmark 的唯一优化样本数——不是「50 个 benchmark」,也不是「50 次调用」;
- 本文只读摘要,未读正文 ⇒ 成本的具体计量方式(是否含模型调用、跑多少次评估、SkillOpt 的版本与基线设置)须回全文核对后才能细写。
 辩证评估与局限
- 为什么值得看:专区此前的四篇(146 规范、147 验证、155/159 供应链与安全、157 政策要求上架审核)都在回答「技能该怎么写、怎么验、怎么防」,本条第一次把「评测预算」本身当成可优化的资源——对已经建了技能库、却被「每次都要跑一遍评测」拖住的团队,这是最实际的一问。
- 局限(务必与结论一起看):
- 其一,我只读了摘要,未读正文——「55–58%」「50 样本」「六个 benchmark」的具体口径(含 SkillOpt 的版本与成本如何计量)须回全文核对;
- 其二,论文未提供第三方复现,摘要中的「平均表现最强」是作者自测口径 ⇒ 不得写成「已被验证有效」;
- 其三,它是 v1(2026-09-10),距今 13 天——属选题而非新闻,正文日期已按 arXiv 提交日标注;
- 其四,「上下文老虎机」本身不是新算法,新意在于把它用在技能演化的预算分配上;这一点的细节我未读正文,仅按摘要表述;
- 其五,中文媒体解读中的表述须回论文原文核对后再引用(本社区此前已有「拿二手解读当论文结论」的教训)。
- 综述那条的局限:「26.1%」的原始研究我未定位;我只读摘要未读正文,四轴细节、七项挑战与权限模型的分层定义均须回全文核对;且该综述 v4 为 2026-06-02,此后生态已有变化(155/159 等事件即在其后),结论时效须按 v4 理解。
 给读者的建议
- 在维护技能库、被评测开销拖住的团队:这条的思路可先用小实验验证——把评测预算按「候选的潜力/信息量」分配,而不是对每个候选都跑全量评测;不要先按摘要的降幅做承诺。
- 做 Agent 平台的团队:摘要提到「用目标模型自身做技能生成与精炼仍然有效」,这关系到是否必须引入更强(更贵)的外部模型来做技能演化——值得对着自己的模型栈试一次。
- 想系统了解这个领域:那份四轴综述(v4 2026-06-02)是目前覆盖面较广的框架文献;但引用它的 26.1% 时须写「据该综述引用的实证分析」,引用其「第一篇」定位时须写「作者称」。
- 内容写作者:本条不是新闻,写日期(2026-09-10/2026-06-02),不要用「近日/最新」;不要转载论文图表(综述许可为 CC BY-NC-ND 4.0,禁演绎,本文只做文字转述)。
 来源
- COBRA-Skills《Contextual Bandit-Guided Evolution for Agent Skill Optimization》(arXiv:2609.11682,v1 提交 2026-09-10,cs.AI;本文只读摘要):https://arxiv.org/abs/2609.11682
- 综述《Agent Skills for Large Language Models: Architecture, Acquisition, Security, and the Path Forward》(arXiv:2602.12430;v1 2026-02-12、v4 2026-06-02;Comments 字段标「Accepted by Agent Skills '26 Workshop at ACM Conference on AI and Agentic Systems 2026」,即 Workshop 接收 ≠ 期刊发表;许可 CC BY-NC-ND 4.0):https://arxiv.org/abs/2602.12430
- 综述项目仓库:https://github.com/scienceaix/agentskills
说明:本条为选题,非当日新闻。两篇论文的日期分别为 2026-09-10 与 2026-06-02;两处关键限定均已写明——「26.1%」系该综述转引的实证分析、「第一篇」系作者自称。文中的降幅与样本量均出自摘要,正文核对前不作更细的断言。