 一句话核心:2026 年 9 月 15 日,TypeSafe AI 发布其首个「System One 模型」Jev——它不生成文本,只输出带校准概率的类型化决策(是/否、多选、打分)。官方称 Jev 在 System One 类任务上达到与现有 LLM 相近的智能水平,同时端到端快 40–200 倍;输入价 $0.042/百万 token,输出免费。它放弃的,是「生成字符串」这件事本身。
 背景脉络
- 这条最值得注意的地方不在「模型更强」,而在输出的形态:从「一段可读的字符串」变成「软件可以直接消费的类型化概率值」。官方把 Jev 描述为「一次前沿智能的函数调用:非结构化状态进,类型化概率决策出」。
- 作者 Diogo Almeida 在官方博文中自述:他此前在 OpenAI 参与过让语言模型学会遵循指令、与人对话的方法,并称那项研究后来成为 ChatGPT 背后的研究;但他认为「聊天模型通向 AGI」这条路缺了一块关键拼图,于是在 stealth 状态下做了两年。
- 命名:模型类别「System One」取自 Daniel Kahneman《思考,快与慢》中「快、直觉的系统 1」与「慢、审慎的系统 2」之分;「Jev」取自经济学家 William Stanley Jevons——官方用「蒸汽机效率提升反而推高煤炭需求」的杰文斯悖论,类比智能成本每降一个数量级会解锁数量级更多的用例。
- 热度可核:官方这篇博文在 Hacker News 上得 1,977 分(公开 API 读数)。围绕它已出现一批社区项目(《Jev in 25 Lines of Python》645 分、《Kev》459 分、逆向复刻、社区自建基准 JevBench 等)以及若干本地复刻实现。
 关键细节
1)三种问题类型,一次调用可混合
官方 API 的输入是「状态(state)+一组问题(questions)」,问题只有三种类型:
- Noul:是/否,模型给出概率;
- Choice:从预定义选项里选一个,给出选项分布与置信度;
- Score:在一个刻度上打分,给出分值、层级分布与置信度。
端点与模型名:POST https://api.typesafe.ai/v1/systemone,模型名 jev-latest(官方响应示例中返回 jev-1.13.0)。每个答案都带 confidence 与 probabilities。
2)技术栈:新架构 + 并行采样 + RLCD
官方给出的三件套是:新模型架构、并行采样器(parallel sampler)、训练方法 RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习)。与传统 LLM 的差别,官方用一张对照表说明:
| 现有 LLM | System One / Jev | |
|---|---|---|
| 训练优化目标 | RLHF/RLVR:人类偏好、可程序化验证的奖励 | RLCD:在 System One 任务上给出「认识论上诚实」的概率 |
| 输入侧重 | 非结构化数据,偏顺序消息 | 非结构化数据,偏结构化程序状态 |
| 输出 | 字符串/生成文本(软件使用前需解析与校验) | 类型安全的结构化值,可能输出与结构事先定义 |
| 采样 | 逐 token 串行 | 并行:一次查询生成全部输出 |
| 置信度 | 被要求时往往过度自信、不一致 | 每次输出都带置信度与不确定性,官方称「校准」 |
官方对「校准」的论述是:如果一个模型 95% 的时候能做对,却不说它何时落在那 5% 里,就无法自动化该任务。
3)官方列举的适用场景与两个演示
适用场景:人工在环任务(chatbot/copilot/编码 agent)、可验证问题(数学证明、内核优化)、AI 工作流/「智能 if 语句」(把结构化输出当作模糊决策规则:分类、路由、打分、抽取、分支)、大数据 map-reduce、实时应用(100ms 级)、以及验证一切(对 LLM 的 prompt/推理链/输出做打分、判定、护栏、越狱检测)。
两个官方演示:一是让 Jev 实时玩 Doom,工程师担心每秒 10 次查询(约 $7/小时)的成本;二是 Wikiracing(从一页维基百科只用链接走到指定页,每步在数百到数千个链接中选择)。两处官方都给了限定,见下节。
 数据解读与口径
一、官方评测站的四工作流等权平均(本次直取 evals.typesafe.ai)
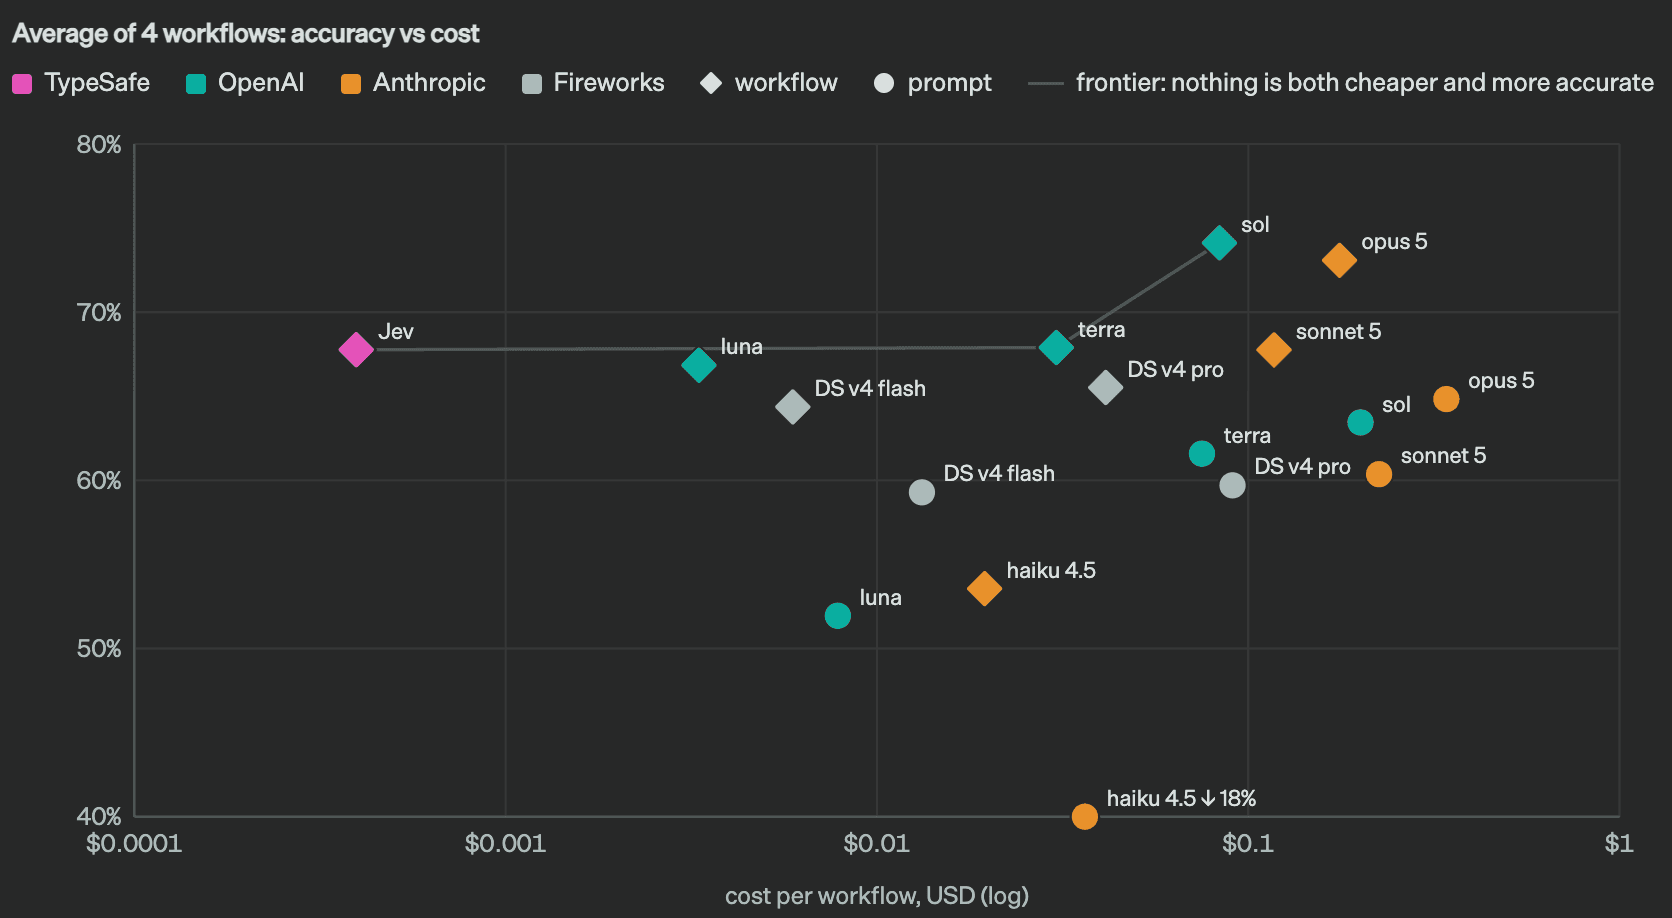
该站有四个工作流:安全事件、Agent 轨迹可观测性、发票处理、客服。口径是:每个点=一个模型配置在四个工作流上的等权平均(准确率/每例成本/每例耗时,对照「共识标签」);所有模型按各供应商默认推理档评测;官方注明「越靠左上越好」。
| 模型(workflow 模式) | 准确率 | 每例成本 | 每例耗时 |
|---|---|---|---|
| Jev | 67.8% | $0.0004 | 0.4 秒 |
| Opus 5 | 73.1% | $0.1761 | 37.8 秒 |
| Sol | 74.1% | $0.0836 | 23.3 秒 |
| Sonnet 5 | 67.8% | $0.1174 | 78.1 秒 |
| Luna | 66.8% | $0.0033 | 12.9 秒 |
| Terra | 67.9% | $0.0304 | 10.1 秒 |
| Haiku 4.5 | 53.6% | $0.0195 | 12.5 秒 |
| DS v4 flash | 64.4% | $0.0059 | 51.9 秒 |
| DS v4 pro | 65.5% | $0.0413 | 86.5 秒 |
表中后两行按图上原名列出(图例中着色为 Fireworks 一项),本文未进一步核其对应厂商,请以官方评测站为准。
Jev 的分场景读数:安全事件 61.7%/$0.0001/0.3 秒;Agent 轨迹可观测性 71.6%/$0.0003/0.5 秒;发票处理 61.8%/$0.0011/0.5 秒;客服 76.0%/$0.0001/0.4 秒。
二、这张表最要紧的读法:Jev 领先的不是准确率
- 在准确率上 Jev 并不领先:67.8% 低于 Opus 5(73.1%)与 Sol(74.1%),与 Sonnet 5(67.8%)、Terra(67.9%)大致同档。
- 它领先的是成本与时间:每例成本比 Opus 5(workflow)低约三个数量级,耗时 0.4 秒 vs 37.8 秒。
- 官方博文那句「拥有帕累托前沿近两个数量级」是就成本/时间轴说的;评测图上官方也自标了两条前沿线——「没有谁同时更便宜又更准」「没有谁同时更快又更准」。把它读成「Jev 比 Opus 5 更准」是错的。
- 另注意口径不能混用:同一站的单个工作流里,Opus 5 在发票处理上可到 78.4%、Sol 可到 79.1%——这是单工作流成绩,与上面的四工作流等权平均不是同一把尺子。
三、这是厂商自建自测,不是第三方评测
评测站与博文都写明方法论:参考标签由 GPT-6 Astra 与 Claude Fable 5.1(均为 high thinking)的回答取平均生成;其余模型按各家默认推理档评测;官方原话是「不争论 harness 与标签的正确性——我们假设代码是对的」。⇒ 参考答案由厂商选定,属厂商自建自测,官方自称「workflow evals」也是一类自建评测,不是公开基准。
四、官方自己披露的偏差(会直接影响上面的读数)
- 与 LLM 的对照数字取自 OpenRouter——官方称「几乎肯定存在偏差」(更复杂的查询可能被路由到更好的模型);
- 参考标签取 Astra 与 Fable 5.1 的平均,使评分偏向 OpenAI 与 Anthropic 的模型;官方并称「我们可能低估了自己模型与 DeepSeek 模型的相对表现」;
- 官方称评测「一般是在西海岸的笔记本上跑的」(其服务目前也在西海岸);
- 官方首页的「193.6x faster/444.6x cheaper」是官方自曝的上限(「我们预期这是真实收益的上限」),且评测工作流「由我们模型能力团队的成员制作,因此可能存在偏差」。
 价格与成本
官方口径:输入 $0.042/百万 token(即 $42/十亿 token);输出免费(官方原话 “too cheap to meter”)。作为对照,官方给出 LLM 的输入价为 $0.20–$10/百万 token,且输出价约为输入的 5 倍。
两点提醒:
- 「输出免费」是官方定价的一部分,官方没有给期限——不应把它读成促销;
- 评测站的「每例成本」(如 $0.0004)与「每百万 token 单价」不是同一把尺子,两者不可互相换算。
官方对定价可持续性自曝的一条:「我们无法证明它没有被补贴;需要长期来证明定价的可持续性(我们预期会降,而不是涨)」。
 辩证评估
为什么值得跟:它提出的不是「又一个更强的模型」,而是输出形态的一种新选择——把「需要解析和校验的自由文本」换成「软件可直接消费、且自带概率的类型化值」。对把模型嵌进代码的工程团队,这是实质性变量:成本与延迟下降带来的,可能是原本不划算的调用变得可行。
反向视角:
- 准确率不领先(见上),它换来的是成本与时间——如果场景对准确率极度敏感、且不在乎每例几毛钱,Jev 未必是更好的选择;
- 评测是厂商自建自测,参考标签由厂商选定,尚无第三方独立复现;
- 「不会幻觉」「不会出类型错误」是官方论断:官方称「这只要一个反例就能证伪,但它在数学上不可能」,并明确 0% 这个数字「不是经验性的(not empirical)」,而是来自「schema 匹配被保证」的推论——它不是实测出来的幻觉率;
- 定价可持续性存疑,官方自己也承认无法证明未被补贴;
- 它是专有模型,只提供 early access 与 API,未开放权重——不能写成「已开源」;官方 FAQ 中「Jev 是不是只是一个更小的 LLM」「公开基准表现如何」两节答案本次未取到,模型规模、上下文长度、模态、训练数据来源亦未公开。
两个官方演示的限定(避免过度解读):Doom 演示用的是「文本形式的结构化状态,不是图像(暂时)」,且官方称非 AI 的 Doom 机器人可能打得更好;Wikiracing 的加速明显低于其他演示(对比的是模型的非推理模式),Jev 支持的选择基数上限为 255,更高基数时改为「先独立打分、再显式选择」的两段式。
 已知 vs 待验证
已证实(官方一手,本次直取官方博文与官方文档):发布时间 2026 年 9 月 15 日、作者 Diogo Almeida、early access;API 端点 POST https://api.typesafe.ai/v1/systemone、模型名 jev-latest;三种问题类型;价格(输入 $0.042/百万 token、输出免费);速度口径(端到端 70ms–500ms、官方称同等级智能下快 40–200 倍);技术栈三件套(新架构+并行采样+RLCD);官方评测站的四工作流读数与分场景读数。
待验证 / 未取到:
- 官方 FAQ「Jev 是不是只是一个更小的 LLM」「公开基准表现如何」两节答案(疑为折叠组件,本次未取到);
- 模型规模、上下文长度、模态、训练数据来源——官方在已读部分未给出;
- 第三方独立评测——HN 上的 JevBench 是社区自建基准,本次未读其结果;亦未取到任何权威英文媒体(路透/彭博/The Information)的独立报道;
- 公司背景(2024 年成立于旧金山、CEO Diogo Almeida、$40M 种子由 DCVC 领投、约 $2 亿估值)目前只有二手来源(含培训/SEO 类站点),本文不据此下结论。
一个容易混淆的点:中文媒体近期有一篇把 Jev 与中科闻歌的 Decitron 作对照的分析——两者不是一回事:Jev 来自 TypeSafe AI,Decitron 是中科闻歌 2026 年 6 月发布的通用决策大模型。该文自己的归纳是「一个解决『此刻选什么』,一个解决『选完之后会发生什么』」。请勿把两家混为一条。
 给读者的建议
- 把模型嵌进代码/做 agent 工作流的工程团队:值得把它列进「智能 if 语句」的候选——先用你自己的工作流按「每例成本 × 每例延迟」算账,再决定是否替换现有 LLM 调用;不要直接套用厂商自测的倍数。
- 做采购与架构选型的人:不要据厂商自测替换;如果准确率是硬约束,先看它在你的任务上是否够用,而不是看总览平均。
- 关注评测方法的人:这张图值得学的是口径——等权平均与单工作流最好成绩不能混用(本文的对照数字统一取四工作流等权平均);厂商自建自测与第三方评测要分开呈现。
- 内容写作者:不要把「不会幻觉」当成已独立验证的结论;不要把成本/时间领先写成准确率领先;不要写「已开源」;不要把 Jev 与中科闻歌的 Decitron 混写。
 来源
官方来源
- TypeSafe AI 官方博文《Introducing System One Models & Jev》(页内日期 Sep 15, 2026,作者 Diogo Almeida, founder;含价格、速度、对照表、Nuance 与 FAQ 标题):https://typesafe.ai/blog/introducing-system-one-models-and-jev
- 官方文档《Quick start》(API 端点、
jev-latest、Noul/Choice/Score、请求与响应示例):https://docs.typesafe.ai/introduction/quickstart - 官方工作流评测站(四工作流读数与口径说明):https://evals.typesafe.ai/
- 官方首页(「193.6x faster, 444.6x cheaper」口径与偏差自述):https://typesafe.ai/
- 官方 agent skill 页(面向 Claude Code/Codex 的即插即用技能):https://docs.typesafe.ai/agent-skill
独立来源
- Hacker News 公开 API(官方博文帖 1,977 分及社区项目分数):https://hn.algolia.com/api/v1/search?query=Jev&tags=story
- 第三方本地复刻:https://github.com/afshinm/laya-mps 、https://github.com/r-ms/mini-jev
- 中文媒体对照分析:量子位《Jev vs Decitron:同为决策 AI,为什么不是一回事?》(2026-09-23):https://www.qbitai.com/2026/09/496352.html
本站相关(背景)
- topic 154(OpenAI 平台原生 Skills)、topic 171(COBRA-Skills)
说明:本条事件时间为 2026 年 9 月 15 日(官方博文页内日期),9 月下旬的中文报道只是后续讨论。配图为 TypeSafe 官方工作流评测图,图注已标来源;厂商自测口径与第三方可核事实已分层标注。