 一句话核心:一个由斯坦福等机构研究者组成的团队发布 CLM-8B——一个用对比学习训练的「System One」模型。代码与权重均以 Apache 2.0 开源(权重发布在 Hugging Face),一张 RTX 4090 就能跑;项目自测称在 computer-use、游戏与工具调用任务上与 Jev 表现相当,延迟最多低 9 倍。这与 topic 175 的 Jev 恰好构成同一品类的两条路线:一条专有、一条开源。
 背景脉络
- 9 月 15 日,TypeSafe AI 发布 Jev(本站 topic 175),把「System One 模型」这个品类带进视野:不生成文本,只输出带校准概率的类型化决策。
- 一周后,这条路线出现了开放实现。项目名为 Contrastive Language Models(CLM),本仓提供 CLM-8B;作者列表含 Christopher Ré、Azalia Mirhoseini、Marco Pavone 等(论文题《Contrastive Language Models: A System One Model for Fast and Generalizable Decision-Making》)。
- 项目明确把自己放在Jev 的对照位置上:它对外提供 TypeSafe 兼容 API——README 里,为 TypeSafe 写的请求可以直接重放为
client.system_one(state, questions)。⇒ 「开放实现兼容专有接口」,这本身是一个值得注意的策略选择。
 关键细节
一、开源范围(本条最硬的部分)
- 代码以 Apache 2.0 发布;CLM-8B 权重同样以 Apache 2.0 发布在 Hugging Face(
huggingface.co/Contrastive-LM/CLM-v0.1-8B);安装方式pip install contrastive-lm。  注意区分:开源的是代码与权重;训练数据本身(Nemotron 问答、合成负例)未随仓库发布,只有数据配方的描述。
二、架构与数据配方
- 架构:每个编码器=冻结的 LLM 主干 + 2,000 万参数的可训练投影头;参考头约 75 MB;编码器用 Qwen3-8B(vLLM pooling)。推理即「新文本一次嵌入 + 缓存候选做点积」。
- 数据配方:预训练 6,000 万条 Nemotron 问答对 → 中训练 3,000 万条合成困难负例 → 后训练 100 万条智能体轨迹;损失为双向 InfoNCE,README 称测试损失随训练算力、模型规模、数据规模呈幂律下降。
- 一条硬限制:状态超过 2048 token 会被截断(可通过同时抬高两处限制放宽,但需要更多显存)。
 数据解读与口径
一、零样本:优势主要在延迟,不在成功率
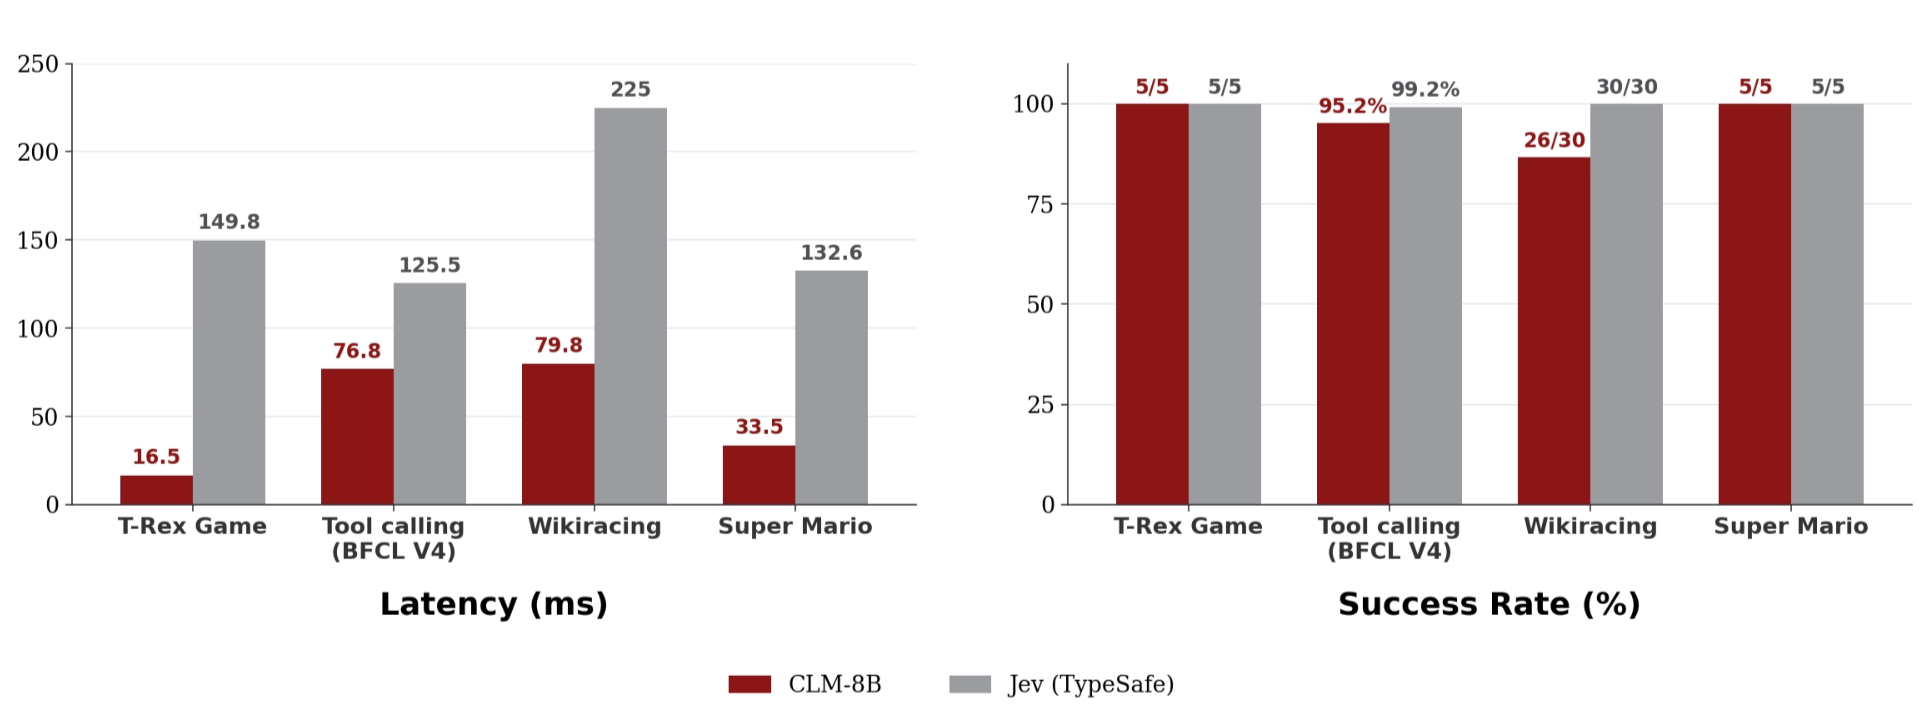
项目称在 computer-use、游戏与工具调用任务上「与 Jev 相当,延迟最多低 9 倍」。官方图里逐项给的是:
| 任务 | CLM-8B 延迟 | Jev 延迟 | CLM-8B 成功率 | Jev 成功率 |
|---|---|---|---|---|
| T-Rex Game | 16.5 ms | 149.8 ms | 5/5 | 5/5 |
| 工具调用(BFCL V4) | 76.8 ms | 125.5 ms | 95.2% | 99.2% |
| Wikiracing | 79.8 ms | 225 ms | 26/30 | 30/30 |
| Super Mario | 33.5 ms | 132.6 ms | 5/5 | 5/5 |
⇒ 延迟上 CLM-8B 全面更低;但成功率上 Jev 在工具调用与 Wikiracing 两项反而更高。「与 Jev 相当」这句话不能读成全面持平或占优。
二、作为 verifier:这是它的主打结果
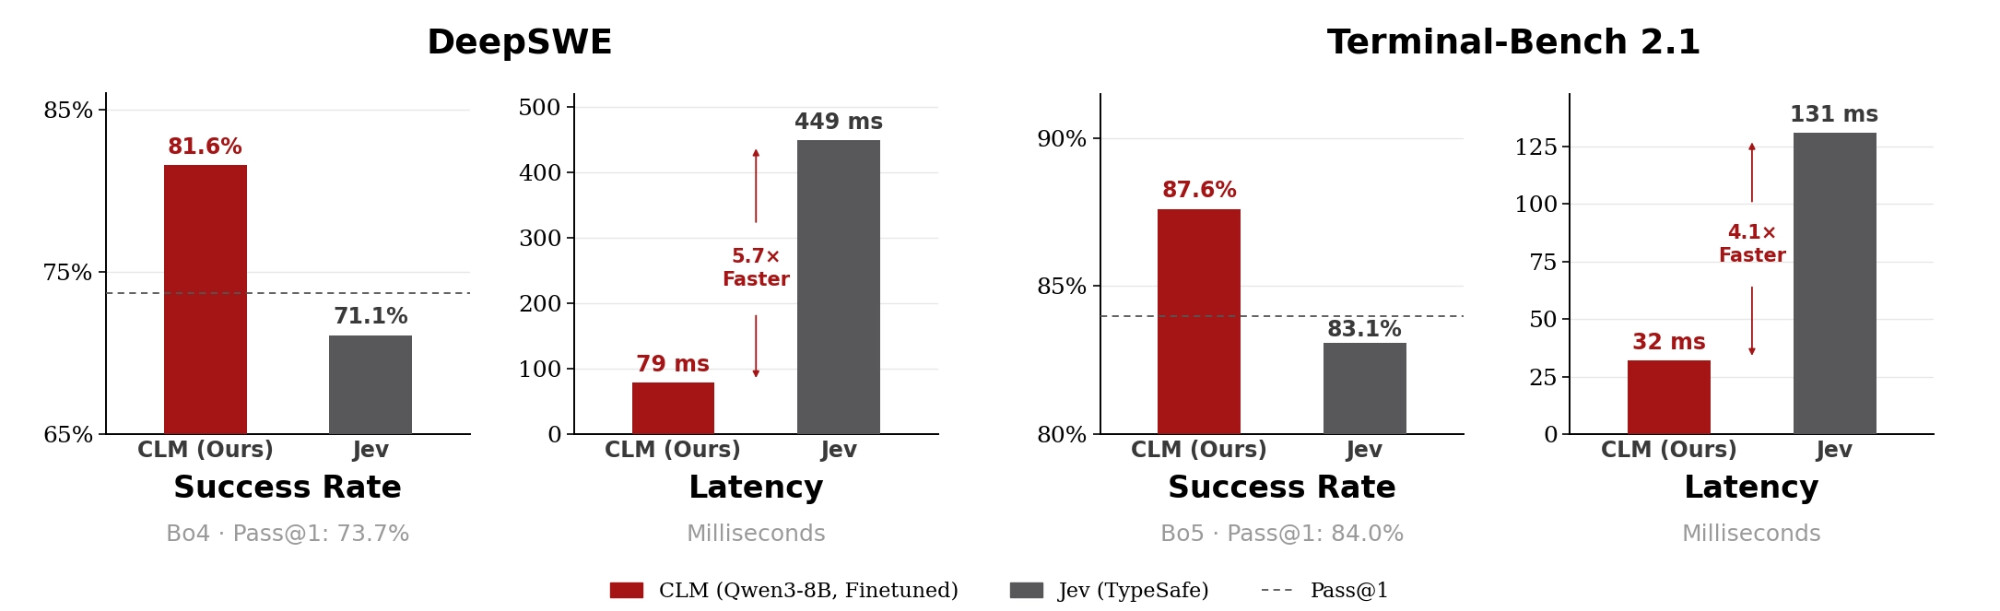
- 每个任务采样若干候选解(DeepSWE 用 Opus 5、Terminal-Bench 2.1 用 Fable 5),由 CLM 或 Jev 充当 verifier 挑出最好的一个。
- 轻量微调后,CLM 在 Terminal-Bench 2.1 得 87.6%、DeepSWE 得 81.6%,同时比 Jev 快 4.1–5.7 倍(图中:DeepSWE 79 ms vs 449 ms;Terminal-Bench 2.1 32 ms vs 131 ms)。
- 官方图同时给出 Jev 作 verifier 的成绩:DeepSWE 71.1%、Terminal-Bench 2.1 83.1%——均低于各自的 pass@1 基线(73.7%/84.0%),即项目所称「Jev 在这类长程任务上作 verifier 会低于 pass@1」。
三、三个必须一起读的限定
- 评测样本量小:DeepSWE 为 38 个留出任务(31/38 = 81.6%)、Terminal-Bench 2.1 为 30 个留出任务;延迟在 H100 上测得。⇒ 87.6%/81.6% 不宜读成通用能力。
- 全部为项目自测:README 未提任何第三方复测。
- 与 Jev 的对比是作者选择的对标,不是第三方同条件对测;Jev 侧的数字取自何处,README 未说明。
四、发布日期:来源不一,README 内无日期
二手来源对发布日的说法不一致(MarkTechPost 标 9/23、explainx 写 9/24、钛媒体写 9/23),而官方 README 内没有日期。⇒ 本文写「本周发布(日期未精确确认)」。
五、一处口径澄清:媒体引用的「最低延迟 16.5 毫秒」,就写在官方结果图里(T-Rex Game 的 CLM 延迟)——它不是媒体自造的二手数字。
 价格与成本
CLM-8B 是开源权重,没有 API 定价——成本结构是「自备硬件、零调用费」(官方演示用一张 RTX 4090 跑 Qwen3-8B 编码器)。
对照 topic 175 的 Jev:Jev 是专有 API(输入 $0.042/百万 token、输出免费,early access,未开放权重)。⇒ 两条路线的成本结构不同:一条是「按量付费、零运维」,一条是「一次性硬件投入、零边际调用成本」。哪条更便宜取决于调用量,不是一句话能比的。
 辩证评估
为什么值得跟:
- 它把「System One」这个品类从一家公司的专有产品变成可下载、可自建、可复现的东西——Apache 2.0 权重 + 一张 4090,门槛低到个人开发者可以试;
- 它主动兼容对手的 API:这不是技术必需,而是一个策略选择——「接口兼容=事实标准」的常见打法。
反向视角:
- 全部数字为项目自测,无第三方复测;
- 评测样本量小(38/30 个任务),87.6%/81.6% 不等于通用能力;
- 「与 Jev 同级」在成功率上并不总成立——工具调用与 Wikiracing 两项 Jev 更高;
- 架构上界:它是「冻结主干 + 小投影头」,能力受 Qwen3-8B 编码器限制,且状态超 2048 token 被截断——长上下文任务不是它的强项;
- 对标由作者选择,不是第三方同条件对测;
- 开源的是代码与权重,训练数据未开放。
 已知 vs 待验证
已证实(官方仓库一手,逐项核对):代码与权重均为 Apache 2.0;权重在 Hugging Face;架构(冻结主干+2,000 万参数投影头、Qwen3-8B 编码器、75 MB 参考头);数据配方(6,000 万/3,000 万/100 万);InfoNCE 损失与幂律缩放描述;2048 token 截断;TypeSafe 兼容 API;两张官方结果图上的全部数字。
待验证 / 未取到:
- 精确发布日期(三种二手说法不一,README 无日期);
- 第三方独立复测——未见;
- Jev 侧对照数字的来源与测量条件——README 未说明;
- 「16.5 ms」的测量条件(图注未给);
- 训练数据的可获取性——数据配方已描述,数据本身未发布。
 给读者的建议
- 想试「System One」类决策的团队:这是目前门槛最低的入口——Apache 2.0、
pip安装、一张 4090 可跑。建议先在自己的数据上做可行性验证,而不是直接替换生产。 - 做选型与采购的:先在自己的任务上复现「38/30 个任务」这个量级的评测,再决定;不要拿 README 的 87.6% 当通用能力,也不要只看延迟倍数(成功率上 Jev 有两项更高)。
- 关注开源的:明确区分「权重开源」与「数据开源」——本项目是前者;如果你的场景需要长上下文(>2048 token),先确认截断对任务的影响。
- 内容写作者:不要把「与 Jev 同级」写成「全面超过 Jev」;不要把 38/30 个任务的成绩写成通用能力;不要把「开源」写成「数据也开源」;引用的数字请标「项目自测」。
 来源
官方来源
- 项目官方仓库(一手,README 21,687 字节,含两张结果图):https://github.com/Contrastive-LM/CLM
- 权重页(Apache 2.0):https://huggingface.co/Contrastive-LM/CLM-v0.1-8B
- 作者博客(Notion,缩放律与拟合细节):https://contrastive-lm.notion.site
独立来源
- MarkTechPost(2026-09-23):https://www.marktechpost.com/2026/09/23/
- explainx(2026-09-24):https://explainx.ai/blog/contrastive-language-model-clm-8b-system-one-9x-faster-than-jev-2026
- 钛媒体 Edge AI 早报(9/25):https://www.tmtpost.com/8152365.html
本站相关(背景)
- topic 175(TypeSafe Jev:同品类的专有路线)、topic 171(COBRA-Skills)、topic 154(平台原生 Skills)
说明:本条为项目自测口径,性能数字均取自官方仓库 README 与其结果图;发布日期因来源不一,本文按「本周发布(日期未精确确认)」处理。配图为该项目官方仓库的结果图,图注已标来源。