 一句话核心:
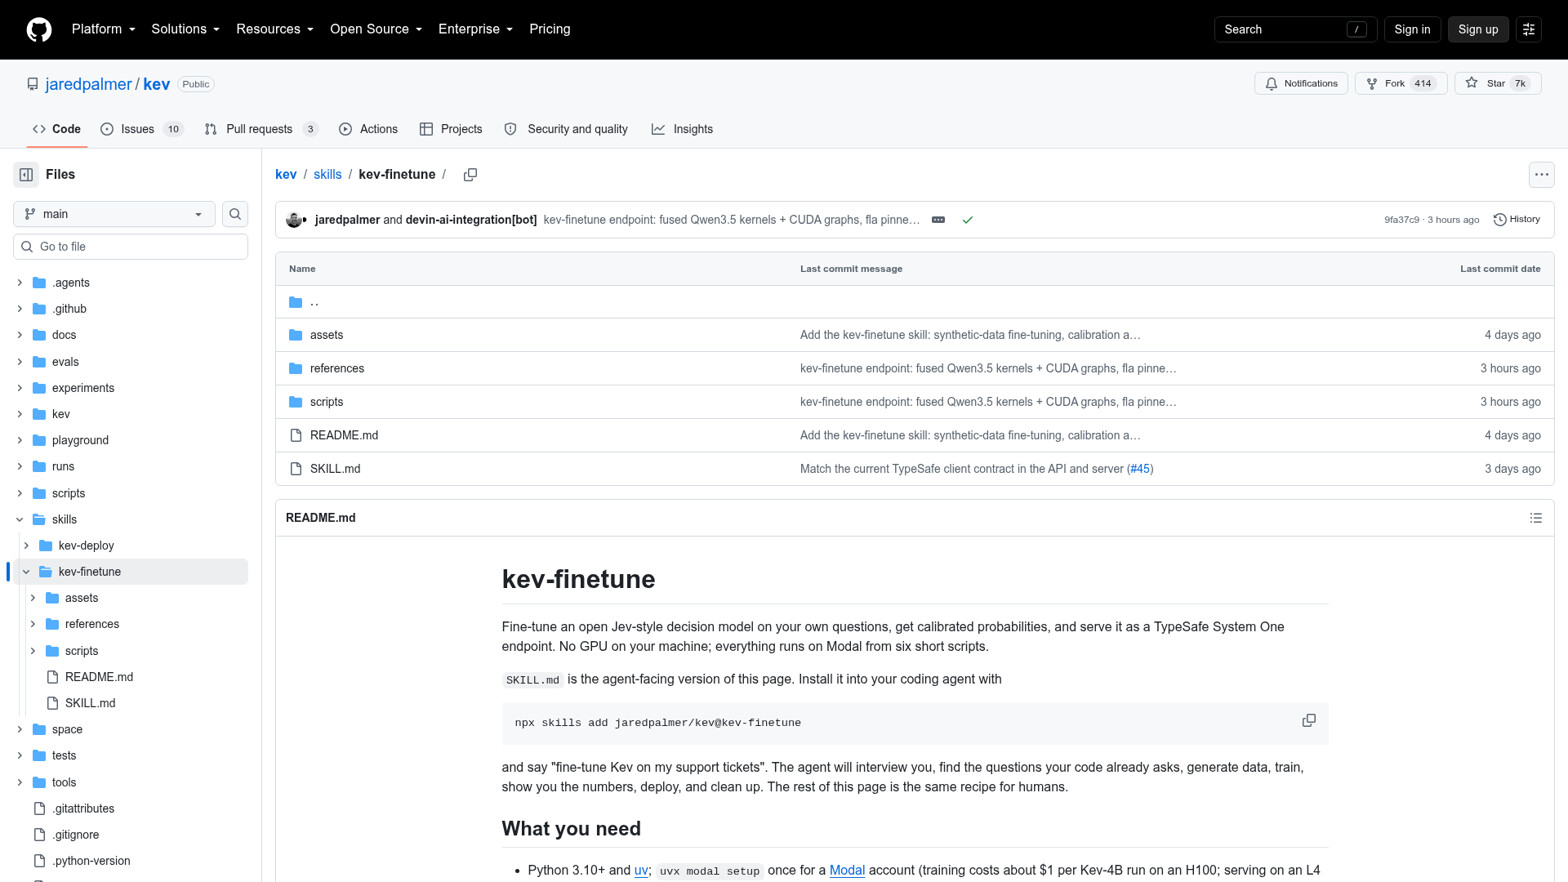
kev-finetune 是 Kev 项目里的一个编码 Agent 技能——装上它,对你的编码 Agent 说一句「用我的工单微调 Kev」,Agent 就会访谈你 → 在你代码库里找出已经在问 Jev/TypeSafe 的问题 → 生成训练数据 → 在 Modal 上训练与校准 → 与未微调模型对比打分 → 部署一个 TypeSafe 兼容端点 → 最后把资源拆干净。全程不需要本地 GPU,也不需要克隆仓库。
 它解决什么问题
Kev 的 SKILL.md 把动机写得很直白:
Jev(TypeSafe 的 System One 模型)是固定的托管模型——在你自己的数据上它是 out of distribution,而且它的概率无法重校准。 Kev 是开源重建;因为可以训练,你就能在自己几百到几千条标注样本上微调,并在自己的留出切片上拟合温度,让它给出的概率针对你的数据是校准的。
⇒ 这正是「为什么需要用一个技能来跑这件事」的答案:它不是一篇教程,而是把一整条工程链路封成一个可被 Agent 执行的流程。
 技能做什么
安装(README 原文):SKILL.md 是这一页「面向 Agent 的版本」;装进编码 Agent 用:
npx skills add jaredpalmer/kev@kev-finetune
然后说「fine-tune Kev on my support tickets」——Agent 会访谈你、找出你代码里已经在问的问题、生成数据、训练、把数字给你看、部署、清理。
Phase 0:访谈(SKILL.md 明确要求「在能回答这些之前不生成任何东西」)——决策是什么/今天跑在哪里/已有哪些标注数据/其余数据从哪来/用哪个基座尺寸/部署与预算。
六个短脚本 + 一个 Modal 应用:
| 脚本 | 作用 |
|---|---|
extract_workload.py |
扫代码库里已有的 Jev/TypeSafe//v1/systemone 调用与标注数据,草拟 workload.json |
convert_data.py |
已有的 CSV/JSONL 标注 → Kev 记录(列映射) |
generate_data.py |
按 workload 规格生成平衡的标注记录;--dry-run 先打印提示词 |
plan_size.py |
**算「需要多少条数据」**才够统计上有意义 |
split_data.py |
校验记录,按 state 切分 train/calibration/development |
kev_modal.py |
Modal 上的 validate / train / evaluate / compare / pull / publish / teardown + Serve 端点 |
读结果迭代:看 accuracy/brier/ece/confident errors/coverage at 5% error。
最后一步是「拆干净」:teardown 分三档——拆单次运行的权重与数据、只停部署端点、或连运行卷与基座权重缓存一起删。「把清理做成技能的最后一步」在 skill 制品里少见,值得单独点出来。
 最值得看的一点:它内置功效分析,且实例很诚实
plan_size.py 把「检出 +5 个百分点、80% 功效」换算成记录数(通常约 1000 条)。而 SKILL.md 里给的实例是:
- 同一 workload 上,400 条只带来 +0.6 个百分点、置信区间 ±6——等于没有;
- 1050 条带来 +5.9 个百分点、CI [+2.3, +9.7]。
⇒ 这个技能会主动告诉你「数据不够时别下结论」,而不是卖一个漂亮的提升数字。对专区读者,这是它最值得学的地方:把「统计功效」写进流程,而不是写进免责声明。
 上手门槛与成本(作者自述)
- 门槛:Python 3.10+、
uv、一个 Modal 账号(uvx modal setup);可选——一个 OpenAI 兼容的 chat 端点用于生成数据、一个 Hugging Face token 用于私有发布。 - 成本(两处口径,不要混):SKILL.md 的
compatibility写「Training uses one H100 (about $1-3 per run)」;Phase 0 另写「jaredpalmer/kev-4b约 12 分钟、400 条约 1 美元,1000 条约 15 分钟」。  以上均为作者自述,未见第三方复现。
 同仓的姊妹技能
skills/kev-deploy(首次提交 2026-09-23、共 7 次提交):把任意 Kev checkpoint 作为你自己的 System One 端点托管。- 两个技能一前一后:一个负责训出来,一个负责挂上去。
 辩证评估
为什么值得装:它是「skill 作为流程封装」的完整样本——把「从建数据到拆资源」的闭环写成一个可执行技能,而不是一篇要人照着做的教程。
反向视角:
- 它绑定外部依赖(Modal 必选,LLM 端点与 HF token 可选),不是纯本地技能;
- 训练只给了一条 Modal + 单张 H100 的路径,没有本地训练分支;
- 数据质量仍是瓶颈——技能只保证「按功效算清需要多少条」,不能替你判断标注对不对;
- 它服务的是 Kev/System One 这一族接口,换到别的模型上不通用;
- 成本与增益数字全部是作者自述。
与已发条目的关系:**171(COBRA-Skills)**回答的是「技能怎么被优化」,本条是「技能怎么封装一条流程」;**154(平台原生 Skills)**是「平台把技能收进产品」,本条更靠「把工程流程交出去让 Agent 跑」那一端。
 上手建议
- 想试的:先跑
plan_size.py估数据量——如果算出来需要上千条而你手上没有,就先别训(这正是技能想让你先知道的事)。 - 别指望它:替你标注数据,或替你判断业务上「值得自动化的比例」。
- 别把它当通用微调器:它面向 Kev/System One 接口。
 官方链接
- 技能所在仓库:https://github.com/jaredpalmer/kev (路径
skills/kev-finetune/) - SKILL.md:https://github.com/jaredpalmer/kev/blob/main/skills/kev-finetune/SKILL.md
- 姊妹技能
kev-deploy:https://github.com/jaredpalmer/kev/tree/main/skills/kev-deploy
本站相关
- topic 171(COBRA-Skills)、topic 154(平台原生 Skills)、topic 180(Kev 所在的决策模型开源生态)
说明:本条为选题(非当日新闻)——该技能首次提交 2026-09-21、更新至 2026-09-25(GitHub API 按路径提交历史,共 9 次提交)。配图为其仓库目录页截图,图注已标来源。