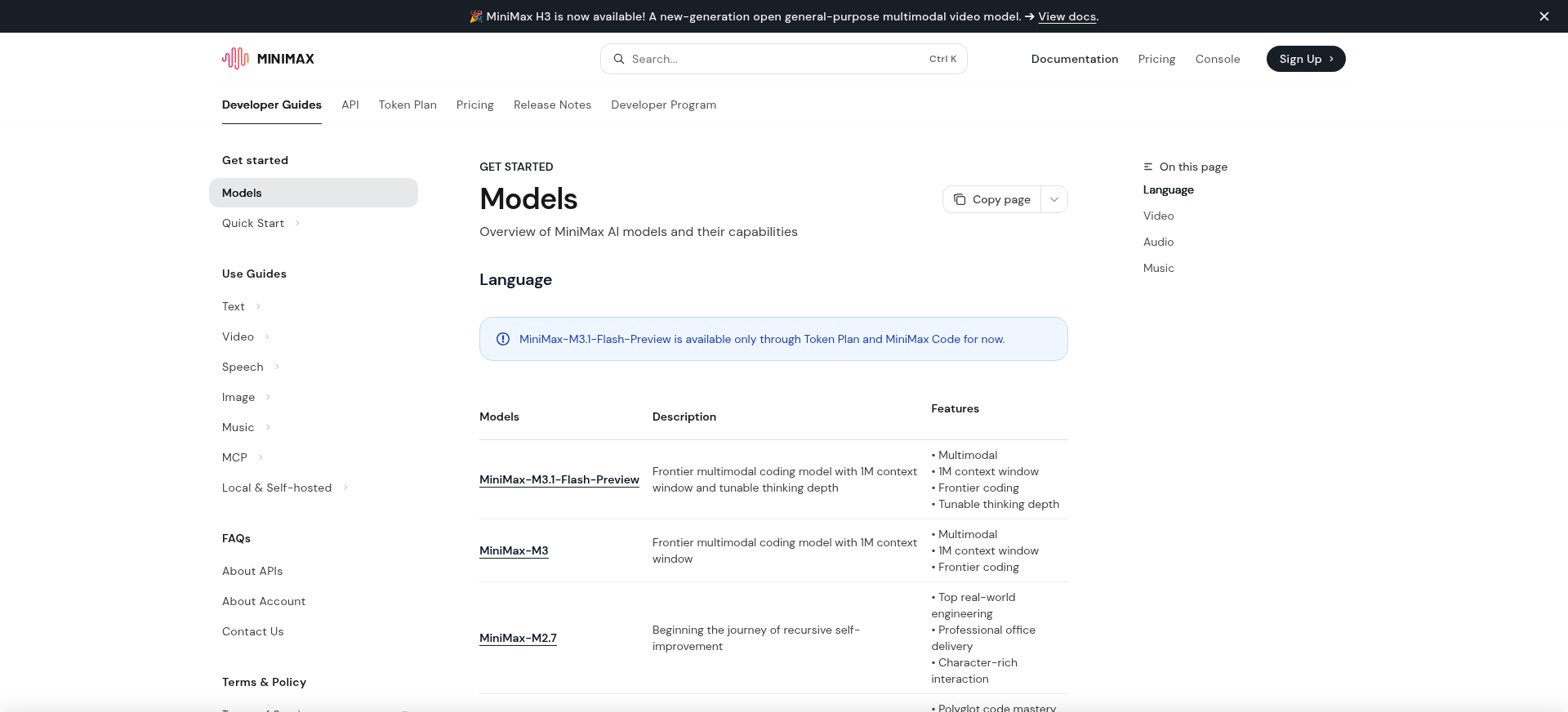
 一句话核心:MiniMax 在官方 API 文档中上线 MiniMax-M3.1-Flash-Preview——官方描述为「frontier multimodal coding model with 1M context window and tunable thinking depth」(前沿多模态编码模型,100 万上下文,可调思考深度),目前「only through Token Plan and MiniMax Code」(只经 Token Plan 与 MiniMax Code 提供,未开放普通 API 调用)。
 与旗舰 MiniMax-M3 相比,官方文档里唯一的功能差异就是「可调思考深度」——上下文、多模态、前沿编码三项特性两者相同;官方同时明确该模型的思考无法关闭。
 背景脉络
- 这是 MiniMax M 系列的一次「Flash 预览版」放量。按官方文档给出的谱系(含 Legacy 表):
| 模型 | 上下文窗口(官方文档) |
|---|---|
| MiniMax-M2 | 204,800(官方另注 max output 128k,含 CoT) |
| MiniMax-M2.1/M2.1-highspeed | 204,800(官方注:230B 总参数、每次推理激活 10B) |
| MiniMax-M2.5/M2.5-highspeed | 204,800 |
| MiniMax-M2.7/M2.7-highspeed | 204,800 |
| MiniMax-M3 | 1,000,000 |
| MiniMax-M3.1-Flash-Preview | 1,000,000 |
- 行业位置:与本站已发的国产模型发布线同族——topic 152(千问 Qwen3.8-Omni-Flash)、topic 153(智谱 GLM-5.3-FlashX)、topic 162(阶跃 Step 5 Preview)。本条真正的差异不在参数,而在「先在自家开发工具内放量、暂不开放普通 API」这个节奏。
- 时间: 官方文档页未标注发布日期;「2026-09-27 上线」来自媒体报道。
 关键细节(官方 API 文档原文)
一、可用范围(这是本条最硬的一条)
「MiniMax-M3.1-Flash-Preview is available only through Token Plan and MiniMax Code for now.」
⇒ 它不是普通的按量 API 模型:官方在文档顶部反复提示这一点,并把取密钥的入口指向 Token Plan 订阅控制台。
二、可调思考深度(官方称其为该模型的核心新增能力)
- 参数
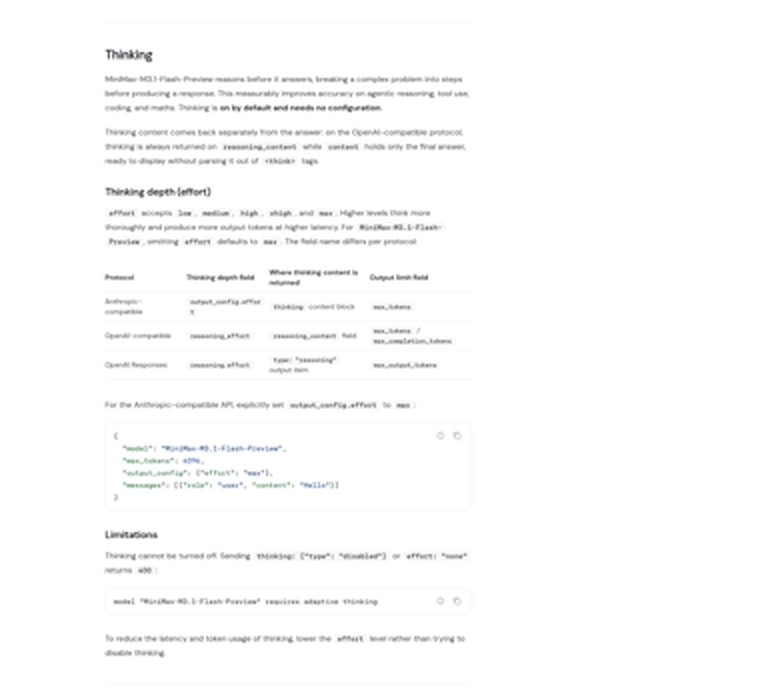
effort接受low、medium、high、xhigh、max;档位越高思考越充分,输出 token 更多、延迟更高。 - 省略
effort时默认max。 - 字段名随协议不同:Anthropic 兼容协议用
output_config.effort(思考内容在thinking块);OpenAI 兼容协议用reasoning_effort(思考内容在reasoning_content字段);OpenAI Responses 协议用reasoning.effort。
三、思考默认开启,而且关不掉
「Thinking is on by default and needs no configuration.」
「Thinking cannot be turned off. Sending
thinking: {"type": "disabled"}oreffort: "none"returns 400:」
model "MiniMax-M3.1-Flash-Preview" requires adaptive thinking
官方给出的替代做法是:要降低延迟与 token 消耗,就调低 effort 档位,而不是试图关闭思考。
四、接入方式
| 字段 | 值(官方文档) |
|---|---|
base_url(Anthropic 兼容,官方推荐) |
https://api.minimax.io/anthropic |
base_url(OpenAI 兼容) |
https://api.minimax.io/v1 |
官方称 Anthropic 兼容路径「supports thinking blocks, interleaved thinking, and other advanced features — this is the default path」。
 数据解读与口径
一、 与 M3 的官方差异只有一项——不要在标题或正文里把它写成「新旗舰」
官方文档的模型描述是逐字的:
| MiniMax-M3.1-Flash-Preview | MiniMax-M3 | |
|---|---|---|
| 描述原文 | Frontier multimodal coding model with 1M context window and tunable thinking depth | Frontier multimodal coding model with 1M context window |
| 特性栏 | Multimodal/1M context window/Frontier coding/Tunable thinking depth | Multimodal/1M context window/Frontier coding |
| 上下文窗口 | 1,000,000 | 1,000,000 |
⇒ 官方口径下,M3.1-Flash-Preview 相对 M3 唯一多出来的是「可调思考深度」,其余三项完全相同。本文不把它写成「1M 新模型」或「M3 的升级旗舰」。
二、日期只能按「官方文档未标日期」写
官方文档页不带发布日期(这与我们既有的纪律一致:文档类页面常不带日期,不得据抓取时间推定为「今日」)。⇒ 正文写「2026-09-27(据媒体;官方文档未标日期)」。
三、 不要拿 M3 的成绩当作 M3.1-Flash-Preview 的
MiniMax 的 M3 产品页(minimax.io/models/text/m3)有一整块 M3 的 benchmark 图表,并写「The first open-weight model with three frontier capabilities」「On BrowseComp, M3 scores 83.5, surpassing Opus 4.7 (79.3)」等——这些全部是 M3 的成绩,官方没有为 M3.1-Flash-Preview 发布任何基准分数。⇒ 两者不可混用。
四、参数:官方没给 M3/M3.1 的参数量
官方文档只在 M2.1 的条目里写了「230B total parameters with 10B activated per inference」;M3 与 M3.1-Flash-Preview 的参数量、训练数据、架构均未在文档中给出。⇒ 不要自行补参数。
 价格与成本
- 官方文档未公布 MiniMax-M3.1-Flash-Preview 的单价,也未给出计费单位——唯一线索是可用范围被限定在 Token Plan(订阅) 与 MiniMax Code,取密钥的按钮指向订阅控制台。本文不引用任何媒体转述的价格。
- 成本上真正需要注意的是「思考关不掉」这件事:既然思考默认开启且默认档位是
max,同一个简单请求的 token 消耗与延迟会显著高于可关闭思考的模型;官方给出的唯一调节手段是显式把effort调低。⇒ 做成本估算时,务必显式设置effort,不要依赖默认值。 - 据媒体报道,9 月 28 日至 10 月 7 日在 MiniMax Code 内有每日签到双倍积分活动(新老用户均可参与)—— 该活动我未在官方页面取到,标注为「据媒体报道」。
 辩证评估
为什么值得跟:
- 1M 上下文 + 多模态(文本/图像/视频)+ 编码的规格组合,对长代码库、长文档、多轮 agent 会话是有意义的;
- 可调思考深度在工程上确实有用:同一模型可以在「快速改 bug」和「复杂重构」之间切换档位,而不必换模型;
- Anthropic 兼容协议是推荐路径,对已经用 Claude Code/Anthropic SDK 的团队来说,改
base_url的成本很低。
反向视角(至少三条):
- 官方增量有限:相对 M3 只多「可调思考深度」这一项,上下文与三项主特性相同 ⇒ 「M3.1」不是换代;
- 放量范围受限:只能用 Token Plan 与 MiniMax Code,没有普通按量 API ⇒ 自建流水线、CI、批量评测都暂时接不上,要评估只能先进 MiniMax Code;
- 思考无法关闭:对短问题、简单分类、高频调用这类场景,默认
max档的延迟与成本并不友好; - 无基准、无定价、无模型卡:本文检索范围内未见任何第三方评测,官方也未发布该模型的 benchmark 与价格。
 已知 vs 待验证
已证实(官方文档一手):
- 可用范围:only through Token Plan and MiniMax Code for now;
- 模型表:M3.1-Flash-Preview 与 M3 均为 1,000,000 上下文;M3.1 的特性栏多出 Tunable thinking depth;
effort档位(low/medium/high/xhigh/max)、省略时默认 max、字段名随协议不同;- 限制原文:思考无法关闭,
thinking:{"type":"disabled"}或effort:"none"返回 400,报错为「model “MiniMax-M3.1-Flash-Preview” requires adaptive thinking」; - 接入端点(Anthropic 兼容
https://api.minimax.io/anthropic、OpenAI 兼容https://api.minimax.io/v1); - M2.1 的 230B 总参/10B 激活(官方文档 Legacy 表)。
第三方观察:
- IT 之家/凤凰科技:「9 月 27 日上线 MiniMax Code」、面向日常开发、主打速度与稳定性(我未直取原文)。
待验证 / 未取到:
- 官方模型卡/技术报告——未见;
- 任何 benchmark 分数——官方未为 M3.1-Flash-Preview 发布;
- 单价与计费口径——官方文档未列;
- 与 M3 除「可调思考深度」外的其它差异——官方文档未说明;
- 签到双倍积分活动——未在官方页面取到。
 给读者的建议
- 已经在用 Claude Code/Anthropic SDK 的:注意可用范围——它现在只经 Token Plan 订阅与 MiniMax Code 提供,不是普通按量 API;先把额度类型确认清楚,再动手改
base_url(Anthropic 兼容路径是官方推荐的默认路径)。 - 要控成本的:显式设置
effort。默认是max,而思考又关不掉 ⇒ 短任务、简单分类、高频调用务必降到low/medium再压测一遍延迟与 token。 - 做选型的:不要把它当成 M3 的升级旗舰——官方口径下多出来的只有「可调思考深度」;也不要把 M3 的 benchmark 图表拿来给它背书(官方没给它发过分数)。
- 做迁移评估的:无普通 API 这一条会卡住 CI 与批量评测 ⇒ 先把「能不能在订阅通道里跑得起你的评测」作为前置问题。
 来源
官方来源
- MiniMax API 文档|Models(模型总览与特性表;载明可用范围限制与 M3.1/M3 的并列对比):https://platform.minimax.io/docs/guides/models-intro
- MiniMax API 文档|Model Invocation(Text)(Supported Models 表、Key Highlights、
effort档位与默认值、Limitations 中「思考无法关闭」的 400 报错原文、接入端点):https://platform.minimax.io/docs/guides/text-generation
独立来源
- IT 之家/凤凰科技(2026-09-27):https://tech.ifeng.com/c/8wlK0628PiO
- 鉅亨網:https://m.cnyes.com/news/id/6616889
本站相关(背景)
- topic 152(千问 Qwen3.8-Omni-Flash)、topic 153(智谱 GLM-5.3-FlashX)、topic 162(阶跃 Step 5 Preview)
说明:本条可用范围、模型表、
effort档位、思考无法关闭的限制、接入端点均取自 MiniMax 官方文档(一手);「9 月 27 日上线」与「主打速度与稳定性」为媒体表述(官方文档页未标日期);官方未发布该模型的 benchmark 与定价,本文未引用任何媒体转述价格;M3 产品页的基准图表属 M3,不可作为 M3.1-Flash-Preview 的成绩。配图为官方文档页截图(模型表已裁去页面底部 Cookie 横幅),图注已标来源。