 一句话核心: NaiveAI 在其官方研究页(署名日期 2026-09-27)公布 Naive-N0.5-Flash:309B MoE、15.5B 激活,面向编程与 AI 研发;原生 1M 上下文,且整个网络没有全注意力层;模型权重与推理代码以 MIT 许可发布,并直接公布了三档 API 单价——输入 $0.10、输出 $0.40、缓存命中 $0.01(每百万 token)。它的基座是小米开源的 MiMo-V2.5。
背景脉络
开源侧「大参数+长上下文」的竞争里,愿意把注意力结构、许可、单价、吞吐写在同一页上的不多;这条的可核信息密度明显高于同期平均。它还接得上我们一直在跟的「开源生态」线:这是一个国产开源权重被第三方拿去做继续预训练的具体例子——官方页原话是「builds on the open-weight MiMo-V2.5 base model」。
要分清的两家:NaiveAI 与小米是两家机构,前者拿后者的公开权重做基座,不要写成「小米发布」。
关键细节
1)架构上做的是「去掉全注意力」。 全网由八个六层模块组成,一个标准模块是五个 SWA(滑动窗口 128)+一个 DSA(稀疏注意力,选 top 2,048),比例约 5∶1,没有任何全注意力层;与原始 DSA 实现不同,这里用 GQA 四组替换 MLA,索引器改为 16 个 query head,官方称相对原始实现把索引选择耗时降低 44%。
2)训练在公开权重上做继续预训练。 在 MiMo-V2.5 基座上完成 3.25T tokens 的多阶段训练(50B 索引器预热 + 3T 稀疏注意力训练 + 200B 学习率衰减),全程保持原生 1M 上下文。
3)许可与可获取性要分开写。 官方原话是「model weights and inference code are released under the MIT license」,MIT 覆盖的是权重与推理代码——不要扩展成「全部训练代码与数据都开源」(训练数据与配方是否开放,我们未核到;其 Hugging Face 组织页的 Datasets 一栏显示为 0,None public yet)。权重已在 Hugging Face 提供(W8A8 checkpoint 与配套的 DFlash 草稿模型,草稿模型 0.7B);但推理运行时 NaiveRT 的 GitHub 仓库我们直取当前不可用——官方页自己写明「The above content will be available by Oct, 12th.」→ 描述可用状态时必须保留这一层,不要写「代码已可获取」。
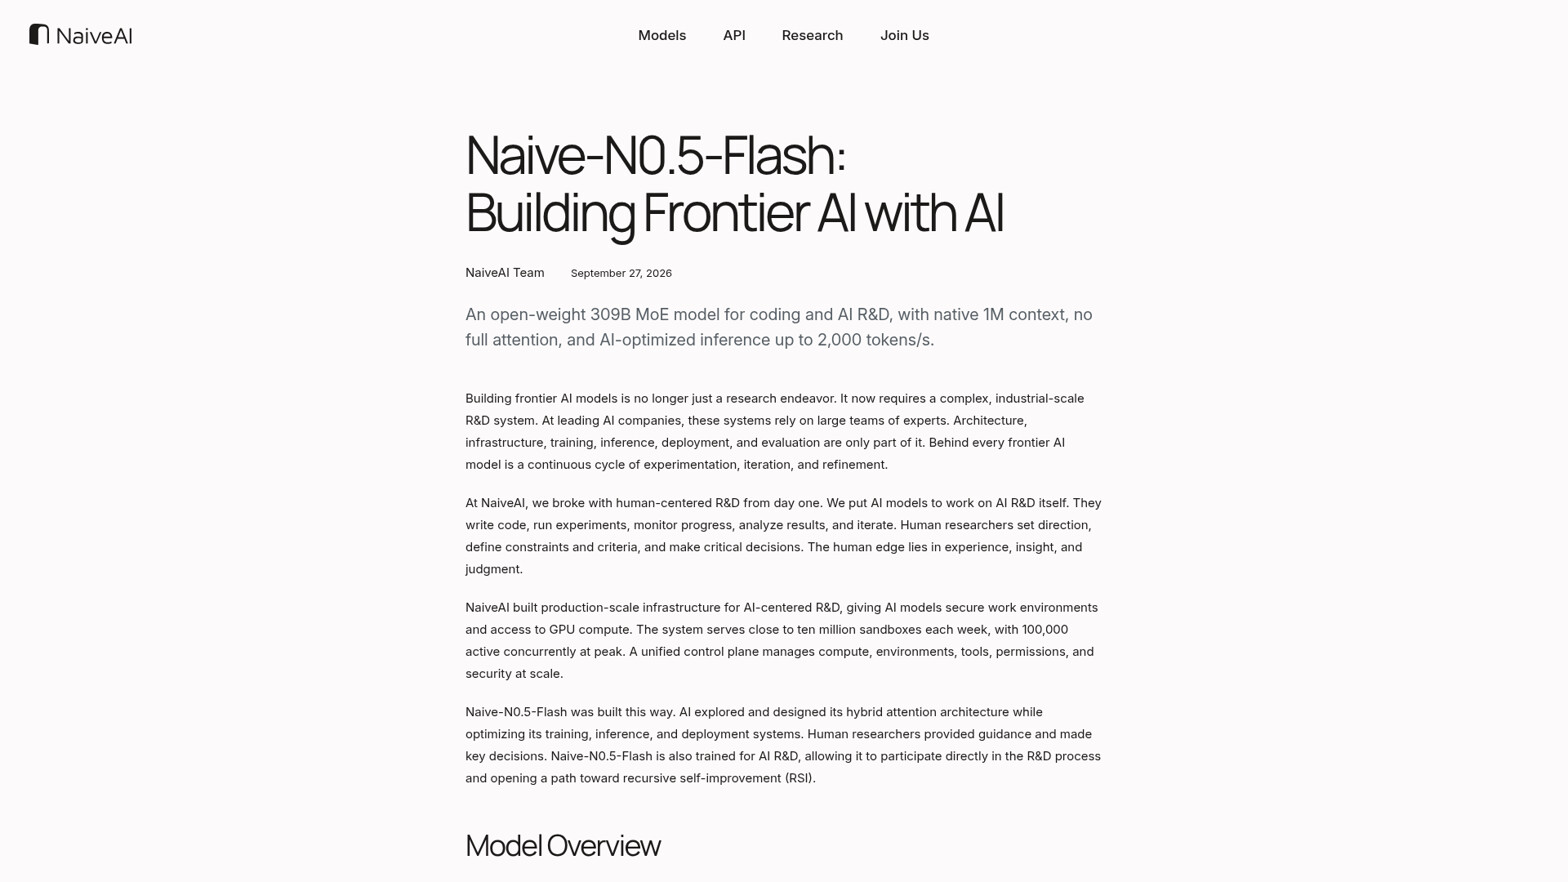
图 1:NaiveAI 官方研究页页首(页载署名日期 September 27, 2026),我们于 2026-09-29 自取。
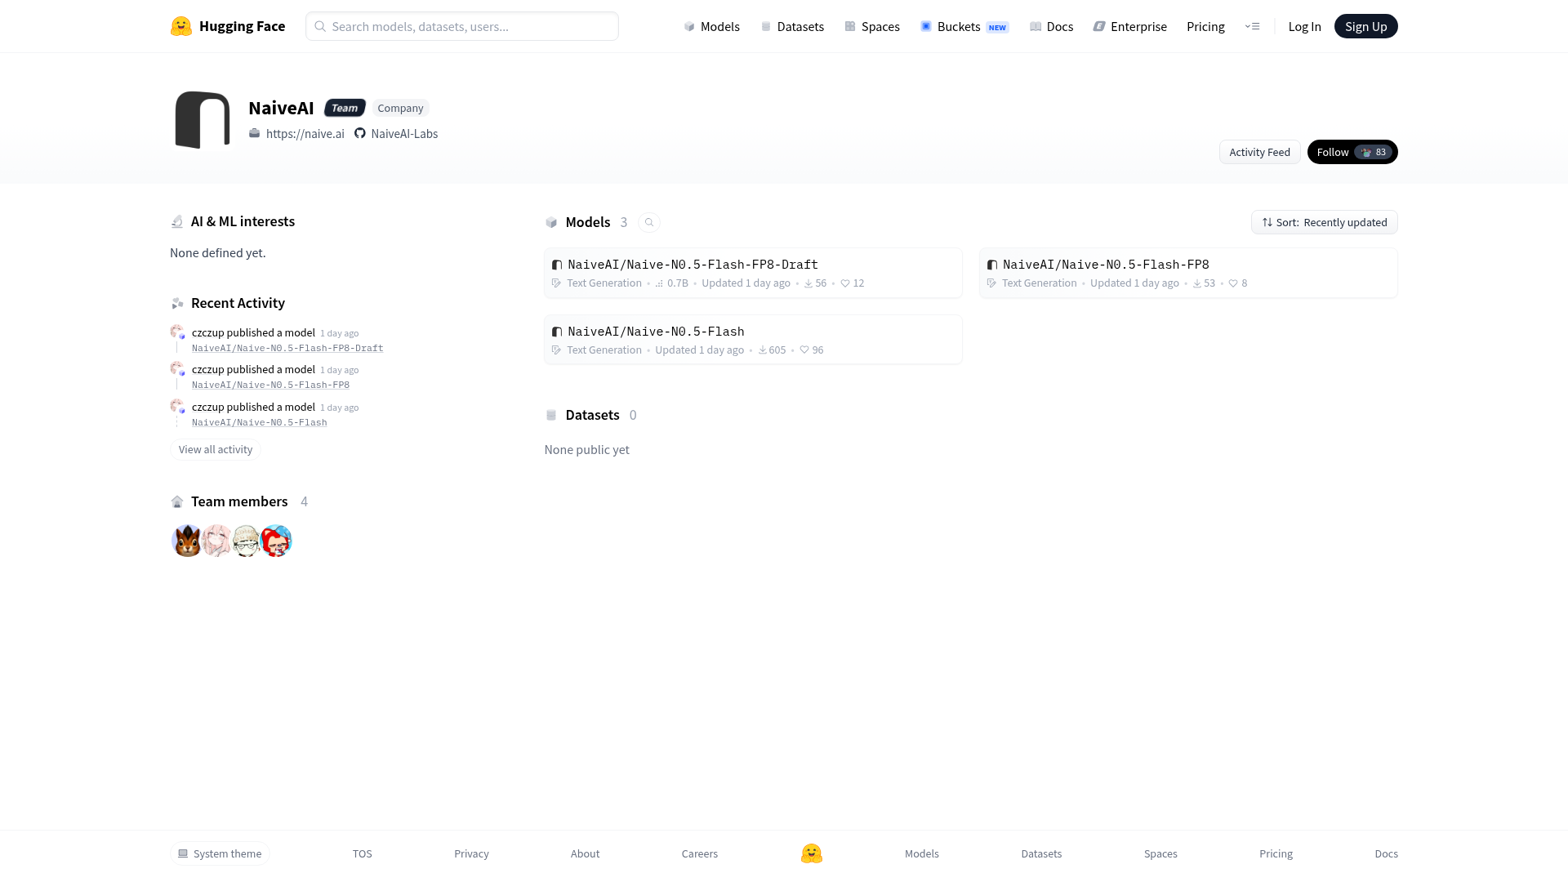
图 2:NaiveAI 的 Hugging Face 组织页(我们于 2026-09-29 自取):Models 3(Flash/FP8/FP8-Draft)、Datasets 0(None public yet)。
官方页给出的规格与数字
下表为官方研究页所载,全部为厂商自测:
| 项目 | 官方所载 |
|---|---|
| 参数 | 309B MoE/15.5B 激活 |
| 上下文 | 原生 1M |
| 许可 | 模型权重与推理代码 MIT |
| API 单价 | 输入 $0.10/输出 $0.40/缓存命中 $0.01,每百万 token |
| 推理吞吐 | NaiveRT 在 8 卡上峰值单流解码 2,122 tokens/s;Standard 模式 50 tokens/s/用户、Ultrafast 模式最高 2,000 tokens/s |
| 一轮投机解码 | 3.4 ms(同一系统上 SGLang 为 12.3 ms,官方称低 72.4%) |
| 编码类自测 | DeepSWE v1.1 67.8、Terminal-Bench 2.1 86.7、SWE-bench Pro 73.6、ALE-CLI 32.4 |
| AI 研发类自测 | MLE-bench-30 73.7%、PaperBench 63.2、NanoGPT SpeedRun 训练 73.8 s(对照 Recursive Superintelligence 77.5 s) |
| 评测口径(官方写明) | Claude Code 2.1.207、1M 上下文、temperature 1.0、top-p 0.95;harness 只暴露基础文件 I/O 与 Bash |
这张表要连着三句话读:
- 全部为厂商自测,本场没有第三方复测;
- 表里的对照模型分数取自各家来源(官方页逐条列了出处:GLM 博客、Kimi-K3 模型页、Qwen 博客、DeepSWE 榜单、Anthropic 系统卡等),不是同一条件下的第三方复测 ⇒ 引用要整表照引并标「厂商自测、对照取自各家来源」,不要单独摘某一格当结论;
- 日期只按官方页署名 2026-09-27。第三方把它列进 9 月 29 日的当日报,那是汇总日、不是发布日 ⇒ 不要写成「9 月 29 日发布」。
价格与使用成本
三档单价是这条最硬的一手数字(官方页原文写明 input/output/cache reads 分别为 $0.10/$0.40/$0.01 per million tokens)。做成本测算时有两个细节别漏:一,缓存命中是独立的第三档,而长上下文 agent 任务里这一档的 token 占比通常很高;二,官方措辞是「API access will also be provided」——即 API 是将要提供,写作时不要写成已经可调用。
辩证评估
正面:参数、注意力结构、许可、单价、推理吞吐全部由官方页一手给出,可核程度高;MIT 许可+明确单价对做成本测算的团队很友好;基座用的是公开权重,说明开源权重的二次开发链路在成形。
反向至少四条:
- 分数与吞吐全是厂商自测,且对照分数来自各家来源、不是同一把尺子。
- 推理运行时的代码当前还拿不到(官方说到 10 月 12 日前),所以「MIT 开源」目前实际覆盖的主要是权重。
- NaiveAI 这家机构的背景我们未核到(成立时间、融资、团队都没查到),本文只按「发布该模型的机构」写;读者也不要给它加「知名」「领先」这类定语。
- 官方页里的自我定位语言(用 AI 做 AI 研发、指向递归自我改进)属厂商主张,不是可核结论。同一页里有个这类例子:官方称一个由该模型自主研究出的世界模型 AutoWM 在 WorldArena-1 Track 1 上得 77.43,高于当时公开榜首 73.64(其比较基准的出处我们未核)。
已知 vs 待验证
已知(我们已直取官方研究页全文与两个页面的截图):309B/15.5B、原生 1M、无全注意力层、SWA∶DSA ≈ 5∶1、索引器 16 头且官方称索引选择耗时降 44%、3.25T tokens 多阶段训练、MIT 覆盖权重与推理代码、三档单价、2,122 tokens/s 与 3.4 ms vs 12.3 ms、评测口径(Claude Code 2.1.207 等)、NaiveRT 仓库与内容「10 月 12 日前可用」、基座为 MiMo-V2.5。
我们自行取数:官方页署名日期为 2026-09-27(该日期在页面渲染文本里未出现,是我们读页面截图读到的);Hugging Face 组织页显示 Models 3、Datasets 0(None public yet)。
未取到/未核:NaiveAI 的公司背景(成立、融资、团队);训练数据与配方是否开放;NaiveRT 源码(直取 404,与官方页「10 月 12 日前」一致);AutoWM 对照基准 73.64 的出处;API 的实际可调用时间。
我们未复现:本文所有分数与吞吐数字均为厂商自报,我们没有跑过其中任何一项。
给读者的建议
- 在做编码 agent 的成本表:$0.10/$0.40 这组单价值得放进你自己的对比里,但记得把缓存命中 $0.01 单独列一行——长任务里它可能决定总成本。
- 想自部署:现在能拿到的是权重(W8A8),运行时还没放出来;按「权重可用、运行时待发布」来规划,别把仓库 404 当成删库。
- 在读「用 AI 做 AI 研发」这类叙事时:把它当厂商主张看,然后锚定那几项可核的数字(参数、许可、单价、评测口径)。这条的评测口径写得很完整,这点值得肯定。
来源链接
官方来源
- NaiveAI 官方研究页(署名为 NaiveAI Team,2026-09-27):https://naive.ai/en/research/
- Hugging Face 组织页(权重):https://huggingface.co/NaiveAI
- 官方页内列的对照分数出处(部分):GLM 5.3 博客 https://z.ai/blog/glm-5.3 / Kimi-K3 模型页 https://huggingface.co/moonshotai/Kimi-K3 / DeepSWE v1.1 榜单 https://deepswe.datacurve.ai/ / Terminal-Bench 2.1 榜单 https://www.tbench.ai/?version=2.1
独立来源
- 第三方新闻汇总(把该模型列入 2026-09-29 当日报;日期不可当作发布日):https://aidapted.ro/en/articles/ai-news-september-29-2026-nvidia-roche-instinct/