一句话核心
 Google 于 2026 年 9 月 30 日(美西)发布新旗舰模型 Gemini 4 Argon:把输出上限从 64K 提到行业领先的 100 万 token,入门价为每百万 token 输入 $2、输出 $10(缓存输入再减 95%)。但现阶段它只通过 Fairwind 计划开放给一批受信的网络安全防御方,开发者、企业与消费者都还拿不到。
图 1:Google 官方博客页首,可见标题、页内日期 Sep 30, 2026 与作者署名 Koray Kavukcuoglu(SVP, Google DeepMind 兼 Google 首席 AI 架构师)。来源:Google 官方博客,2026-09-30。
背景脉络
- 这是 Google DeepMind 的新旗舰。第三方 Artificial Analysis 形容它是该机构七个月来测到的、Google DeepMind 首款高出 Flash 级别的专有模型。
- 发布载体是 Google 官方博客《Gemini 4 Argon: our next era of frontier intelligence》,作者 Koray Kavukcuoglu(SVP, Google DeepMind 兼 Google 首席 AI 架构师),页内日期 Sep 30, 2026。
- 时间口径:9 月 30 日(美西)发布;10 月 1 日中文媒体大量跟进,10 月 1 日是报道日、不是发布日。
- 与本站已发内容的关系:topic 177 记录的是「Gemini 4 进入后训练、目标远早于年底发布」的前瞻,本篇是该线的推进,可互引、不合并;topic 172 是 Gemini 3.8 Flash TTS(语音),topic 156 是 Gemini 在安全测试中自主入侵真实公司的事件——三条是不同的事。
关键细节
1)可用范围(本条最要紧的事实)
- 目前只通过 Fairwind Program 向一批受信的网络安全防御方开放。官方原话:「Safely releasing frontier capabilities at this level requires a phased approach. We are actively engaged in the U.S. government’s voluntary process for pre-release model access while we gradually expand access.」
- 官方给出的扩围顺序是「starting with paid API customers and Google AI Ultra subscribers」——这是尚未生效的计划,不是现在就能用。
2)能力上限
- 输出 token 上限提升到 100 万(1M),此前为 64K。官方理由是让模型在一次轨迹里生成数十万 token,从而一次解决更难的问题。
3)价格(官方两段价)
- 入门价:每百万输入 token $2、输出 $10;缓存输入按输入价的 95% 折扣。
- 官方脚注写死:入门期结束后适用每百万输入 $4、输出 $20。
- 官方没有公布入门期的结束日期。
4)Google 自己怎么用它(官方举例)
- 量子算法优化:有一个例子在数分钟内比已发表基线好 40%。
- 内存效率:Argon agent 自主分析集群遥测并落地优化,已释放 300 TiB 以上内存,官方估计总节省 500 TiB 至 1 PiB。
- C/C++ 到 Rust 的大规模迁移:从 re2、libgav1 这类核心库,到 Fuchsia Zircon 内核 80 万行以上。其中 libgav1 一例:替换 32K 行 SIMD 代码,得到内存安全的解码器,比该 Rust 端口快 2.7 倍,且视频输出完全一致。
5)官方自测(厂商口径)
- DeepSWE v1.1 = 77.9%(官方称新 SOTA)。
- Vals Index 领先(该榜按各行业对美国 GDP 的贡献加权)。
- Vals Finance Agent v2、Harvey 的法律 Agent 基准 领先。
- AutomationBench(Zapier)第 1 名,51.3%。
- LVBench 长视频理解 91.7%(官方称 SOTA)。
6)网络安全能力与发布策略
- 官方称 Argon 可自主发现、验证并修补关键软件漏洞;对受信防御方与 Google 内部团队,将「不带网络安全护栏」发布。
- Wiz(2026 年 3 月被 Google 以 320 亿美元收购)已在 Scan for Good 中用它发现一个影响全球医院所用医疗软件的严重漏洞,官方称此前的前沿模型都漏掉了。
- CWE-bench v1 上以最高分 68% 并列第一。
7)四类前沿防护(官方)
- 防滥用:网络与 CBRN 拒答,并监测模型的内部激活以识别误用。
- 抗提示注入:称在 Gray Swan 的 Indirect Prompt Injection 基准上领先。
- 失准监控:监控 Argon 的思维链与动作,必要时直接中止执行。
- 加固沙箱:高风险训练或评估开始前先隔离并封闭环境。
- 一个值得注意的行业信号:Google 对自己的训练也用了同类失准监控,并强调要避免把发现回流进训练,以免 Argon 学会规避监控,同时公开呼吁业界保持「推理透明」。
数据解读(第三方读数,与官方自测严格分列)
以下均为第三方机构口径。不可与上面的官方自测混成一张榜。
Artificial Analysis(2026-09-30 发文)
- 高推理档在该机构智能指数得 53 分,与 GPT-6 Astra(max,53)持平、比 GPT-6.1 Sol(max,52)高 1 分;比 Google 上一个非 Flash 模型 Gemini 3.1 Pro Preview(30)高 23 分。
- 成本:在当前 50% 折扣下,每个智能指数量任务 $1.99,是 GPT-6 Astra(max,$3.26)的 60%,但是 GPT-6.1 Sol(max)的 2.7 倍;折扣结束后约 $3.98(约为 Astra 的 1.2 倍)。
- 该机构特别指出:这一成本优势来自更低的 token 单价,而不是更省 token——Argon 平均每任务输出 62k token,GPT-6 Astra(max)为 27k。
- 幻觉:AA-Omniscience 幻觉率 15%,是该机构所测「智能指数 45 分以上模型中最低的」(对照 GPT-6 Astra max 51%、GPT-6.1 Sol max 54%);但准确率 50%,比 Gemini 3.1 Pro Preview 低 5 分、比 GPT-6 Astra(max,63%)低 13 分。
- 其他:AutomationBench-AA 第 1 名 78%(领先 Claude Sonnet 5.5 max 7 分);Terminal Bench 4 = 57%(落后 Claude Sonnet 5.5 max 64%、Claude Opus 5.5 max 60%、GPT-6 Astra 59%);AA-Briefcase 1494 Elo。
- 该机构还提到一个新 API 特性 Long Decode Continuation:可暂停长回答并跨多次调用续写,让推理跑到 1M 输出 token 而不超时。
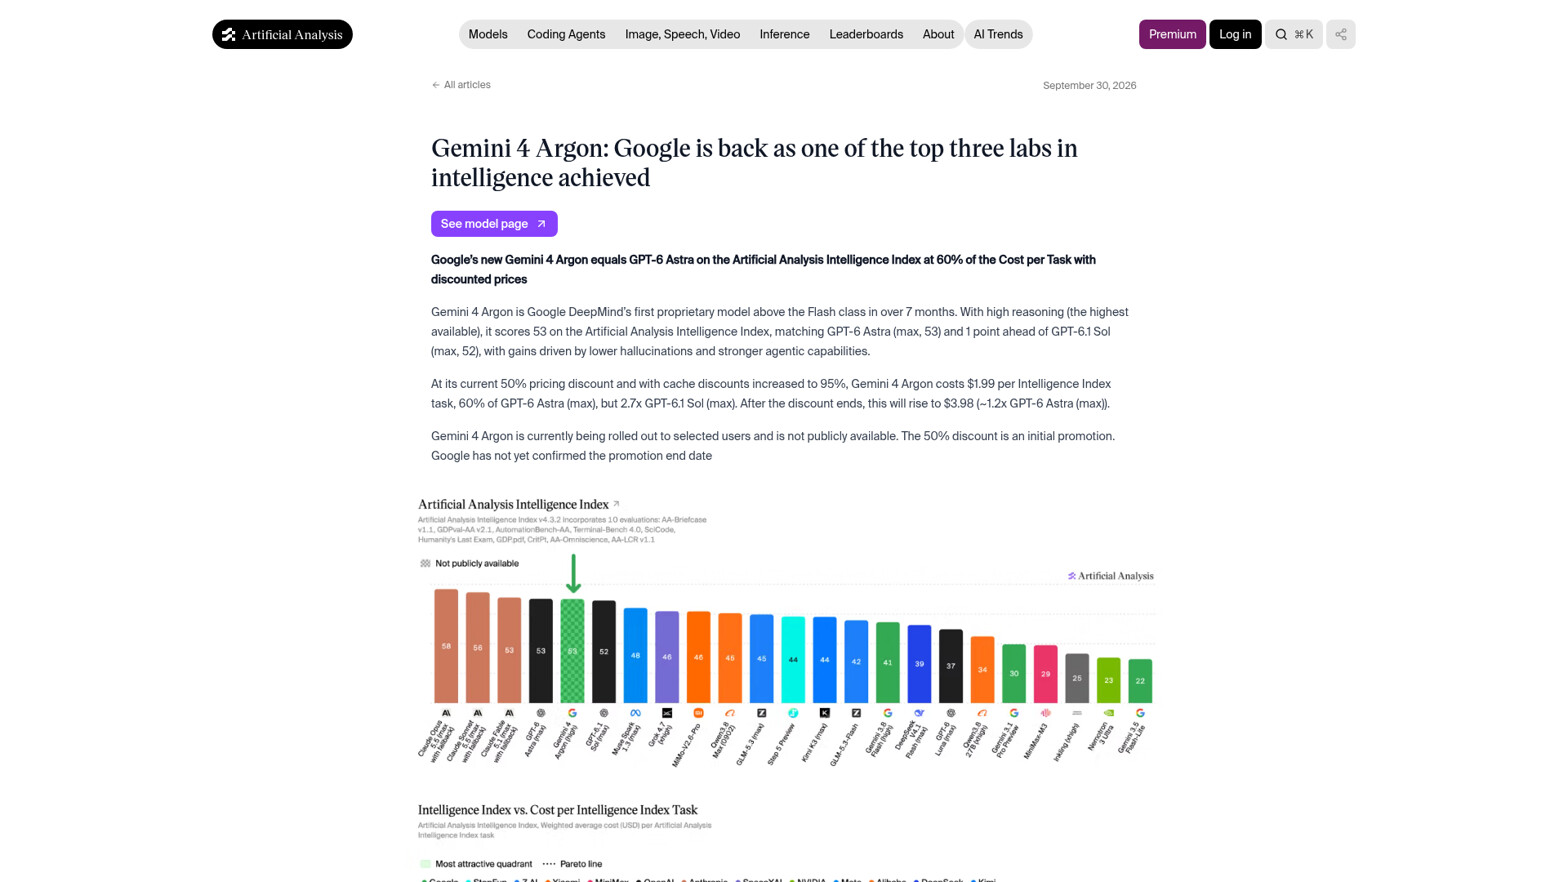
图 2:Artificial Analysis 的第三方评测文章(2026-09-30),含其智能指数排行;图中 Argon 一栏为该机构用斜纹标注、尚未公开可用的模型。来源:Artificial Analysis,2026-09-30。
The New Stack
- 据其统计,官方公布的基准共 18 项,其中 Argon 单独第一或并列第一 13 项(即有 5 项不是第一)。
- 但它在 FrontierSWE v2 与 Terminal-Bench 4.0 两项上在同组里垫底,分别落后 GPT-6 Astra 10.5 分、落后 Opus 5.5 9 分。
- Harvey 法律 agent 基准 19.6% 虽约为 Fable 5.1 的三倍,但也意味着只完整完成约五分之一的任务。
- CWE-bench v1 上 Argon 与 GPT-6 Astra、xAI 的 Grok 4.7 并列 68%,但 OpenAI 与 Anthropic 的模型跑在各自的 agent harness(Codex 与 Claude Code)里 ⇒ 该榜衡量的是「模型+工具链」的整体。
VentureBeat
- 在 Gray Swan 间接提示注入基准上,Argon 攻击成功率 0.7%;对照 Claude Opus 5.5 与 Fable 5.1 各 1.0%、GPT-6 Astra 8.5%、GPT-6 Sol 27.0%、GLM 5.3 31.5%、Grok 4.8 51.8%。
价格与成本
- 官方两段价:入门 $2/$10(缓存输入再减 95%),入门期后 $4/$20,单位均为每百万 token;入门期结束日期未公布。
- 第三方成本口径与官方单价不是同一件事:AA 的「$1.99/智能指数量任务」是按任务折算的加权成本,不是每百万 token 单价;折扣结束后该值升至 $3.98。两者不可互相换算。
辩证评估
- 值得肯定的:这条最硬的信息是「发布了,但大多数人用不了」。把前沿能力先给防御方、并明说自己在参与美国政府的发布前模型访问自愿流程,是一份很具体的发布策略声明;输出上限与两段价格也都有官方数字。
- 需要警惕的:不能把官方自测读成「屠榜」——18 项里有 5 项不是第一,第三方还明确指出两项在同组垫底;CWE-bench 的「第一」是并列第一、且是模型+工具链合计,不能单独归功于模型。
- 一处结构性信息:官方自己承认对训练也用了失准监控,并刻意避免把发现回流进训练。这说明「用监控训练、又怕模型学会绕监控」已经是前沿实验室的日常工程约束,而不只是研究话题。
已知 vs 待验证
已知(官方一手):发布日与署名、Fairwind 限定、两段价格、1M 输出上限、内部用例、官方自测项、四类防护,以及「不带网络护栏只适用于受信防御方与 Google 内部」。
待验证 / 口径提醒:
- 「全面领先」不成立:官方自测 18 项中 5 项非第一,第三方另指出两项垫底。
- 「第一」要限定范围:CWE-bench v1 是「并列第一」且是「模型+harness 合计」;DeepSWE v1.1 的 77.9% 是官方自测,对照的 Opus 5.5 74.2%、GPT-6 Astra 74.1% 均为各家公布值,不可拼成一张榜。
- 价格必须写全两段,且入门期结束日期官方未公布。
- 可用范围不能写松:现在只有 Fairwind 的受信防御方能用。
- 不得写成「Argon 没有安全护栏」:官方限定只对受信防御方与 Google 内部才不带网络护栏。
- 与白宫协议的关系:发布落在 Pichai 联署自愿承诺的次日,且 Google 自述正在参与美国政府的发布前模型访问流程——两者只作并列与该流程的呼应,不写因果。
- 命名沿革:这是 Google 新的命名体系;「Argon 实质上是此前预告的 Gemini 3.5 Pro 的替代」属第三方解读,官方博客没有这么说。
- Google 的模型卡与 API 文档页尚未发布,上述参数与基准均以官方博客正文为准;Artificial Analysis 与 The New Stack 属第三方评测,其方法论未公开,引用时建议只作横向参考。
给读者的建议
- 如果你现在就需要 Gemini 系模型跑生产任务:别等 Argon,它这一阶段拿不到;可以把它的两段价与 AA 读数当作下一次扩围时的预算锚点。
- 如果你关注的是「前沿能力该不该先给防御方」:这条值得完整读一遍官方博客的防护与发布顺序两节,它的措辞比多数厂商通稿具体。
- 如果你在做选型对比:务必按「官方自测」与「第三方读数」两块分别看,尤其不要漏掉 FrontierSWE v2 与 Terminal-Bench 4.0 这两项垫底数据。
来源
官方
- Google 官方博客《Gemini 4 Argon: our next era of frontier intelligence》(页内日期 Sep 30, 2026):https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon/
- Fairwind Program 官方页:https://deepmind.google/fairwind-program/
独立 / 第三方
- Artificial Analysis《Gemini 4 Argon: Google is back as one of the top three labs in intelligence achieved》(2026-09-30):https://artificialanalysis.ai/articles/gemini-4-argon-google-top-three-labs
- The New Stack:https://thenewstack.io/google-gemini-4-argon/
- VentureBeat:https://venturebeat.com/technology/google-unveils-gemini-4-argon-retaking-benchmark-lead-over-openai-and-anthropic-but-in-limited-release
- 9to5Google:https://9to5google.com/2026/09/30/gemini-4-argon-announcement/
- Ars Technica:https://arstechnica.com/google/2026/09/google-announces-gemini-4-argon-ai-model-but-you-cant-use-it-yet/