一句话核心
 Cloudflare 于 2026-10-01 发布并开源两个自训决策模型:Clef(27B) 与 Clef-flash(9B)——权重在 Hugging Face 以 Apache 2.0 开放,同时托管在其 Workers AI 上。两者沿 Typesafe 的 System One API(
noul/choice/score 三类问题,每次最多问 64 个),不做自由文本生成,直接返回每个允许答案的概率;官方称在 10 项决策基准中有 7 项由 Clef 系模型取得最高分,并首次推出配套的强化学习微调服务。
图 1:Cloudflare 官方博客页首,可见标题、署名与页内日期 October 1, 2026。来源:Cloudflare 官方博客,2026-10-01。
背景脉络
- 发布方与日期:这是 Cloudflare Workers AI 团队第一次自己训练的模型——官方在开发者更新日志里的原话是「the first models trained by the Cloudflare Workers AI team」。更新日志页载 October 1, 2026,博客页首同样标 OCTOBER 1, 2026。
- 「决策模型」是什么(官方定义):它不生成文本,而是读入一个输入状态与一组带类型的问答,为每个允许的答案返回概率;下游代码可直接据此路由工单、阻断请求或升级人工。官方强调「没有自由文本要解析,也没有推理 token 要等」。
- 这条线的由来:Cloudflare 自己说,这事起于 Typesafe AI 的 Jev 带起的热度——是 Jev 把「决策模型」这个概念带进 AI。本条与本站已发的 topic 175(TypeSafe Jev) 同线,与 topic 180(U2-Decision、Jev-Omni 等社区生态) 是同一条线的两个侧面(那边讲社区对标,这条讲大厂自训+开源),可互引、不合并。
- 一个容易混淆的点:Cloudflare 是拿 Typesafe 的 Jev Decision Index 来评自己的,并把 Jev、DiffusionGemma Jev、Kev 9B、Laya 都放进了同一张对照表——Clef、Jev、Kev 是三个不同主体(Cloudflare 自训/Typesafe AI 的产品/社区项目 jaredpalmer),Clef 不是 Jev 的后继。
关键细节
1)两个模型与它们的骨架
- 官方规格:
@cf/cloudflare/clef=27B,定位「最高精度」;@cf/cloudflare/clef-flash=9B,定位「延迟敏感的热路径」;两者上下文均为 64K tokens。 - 训练口径(官方原文):Clef 冻结
Qwen3.8-27B、Clef-flash 冻结Qwen3.5-9B,联合优化一个路由头与 rank-256 的 LoRA;后训练用标签平滑交叉熵配合 Brier 损失校准概率,另有称为 RLCD(面向校准决策的强化学习) 的优化目标;数据来自其内部合成数据集(对字段顺序、提示词与 schema 结构做排列)。 - 推理机制:Qwen 只跑一次 prefill,随后并行给各个合法 schema 选项打分;决策步骤是非自回归的,因此没有逐 token 生成的中间文本——官方称这也是它比自回归 LLM 快的原因。
- 多模态:Hugging Face 模型卡写明 Clef 是 27B 多模态模型,输入可以是文本、JSON、图像或视频;更新日志补一句「可随状态传入最多四张图片」(不同于纯文本的决策模型)。
2)接口与可用范围
- 它跟随 System One API(官方原文):现有 Jev 集成只需换端点与模型名即可切过来;每次请求最多问 64 个问题,问题分三类:
noul(是/否,返回「是」的概率)、choice(从你定义的选项里选一个,返回所选选项、每个选项的概率与一个置信度)、score(按有序评分档打分,返回概率加权分与各档概率)。 - 两种获取方式:托管在 Workers AI(端点
@cf/cloudflare/clef与@cf/cloudflare/clef-flash,也可走 REST 接口/ai/run与 AI Gateway)+ 权重在 Hugging Face 以 Apache 2.0 开放(Cloudflare/clef、Cloudflare/clef-flash)。 - 企业口径:官方承诺不读取、不存储、不用客户的请求与响应做训练——除非你使用它的微调产品。
- 新推出的 RL 微调服务:官方称先由前向部署工程师团队陪跑帮客户微调,之后做自助平台;链路全部由 Cloudflare 自有部件组成:AI Gateway(把 AI 流量自动沉淀成数据集)→ Workers AI(对基座模型生成 rollouts)→ Containers(RL 沙箱打分与回放)→ Trainer(新) → Workers AI + BYO Model(重新部署微调后的模型)。
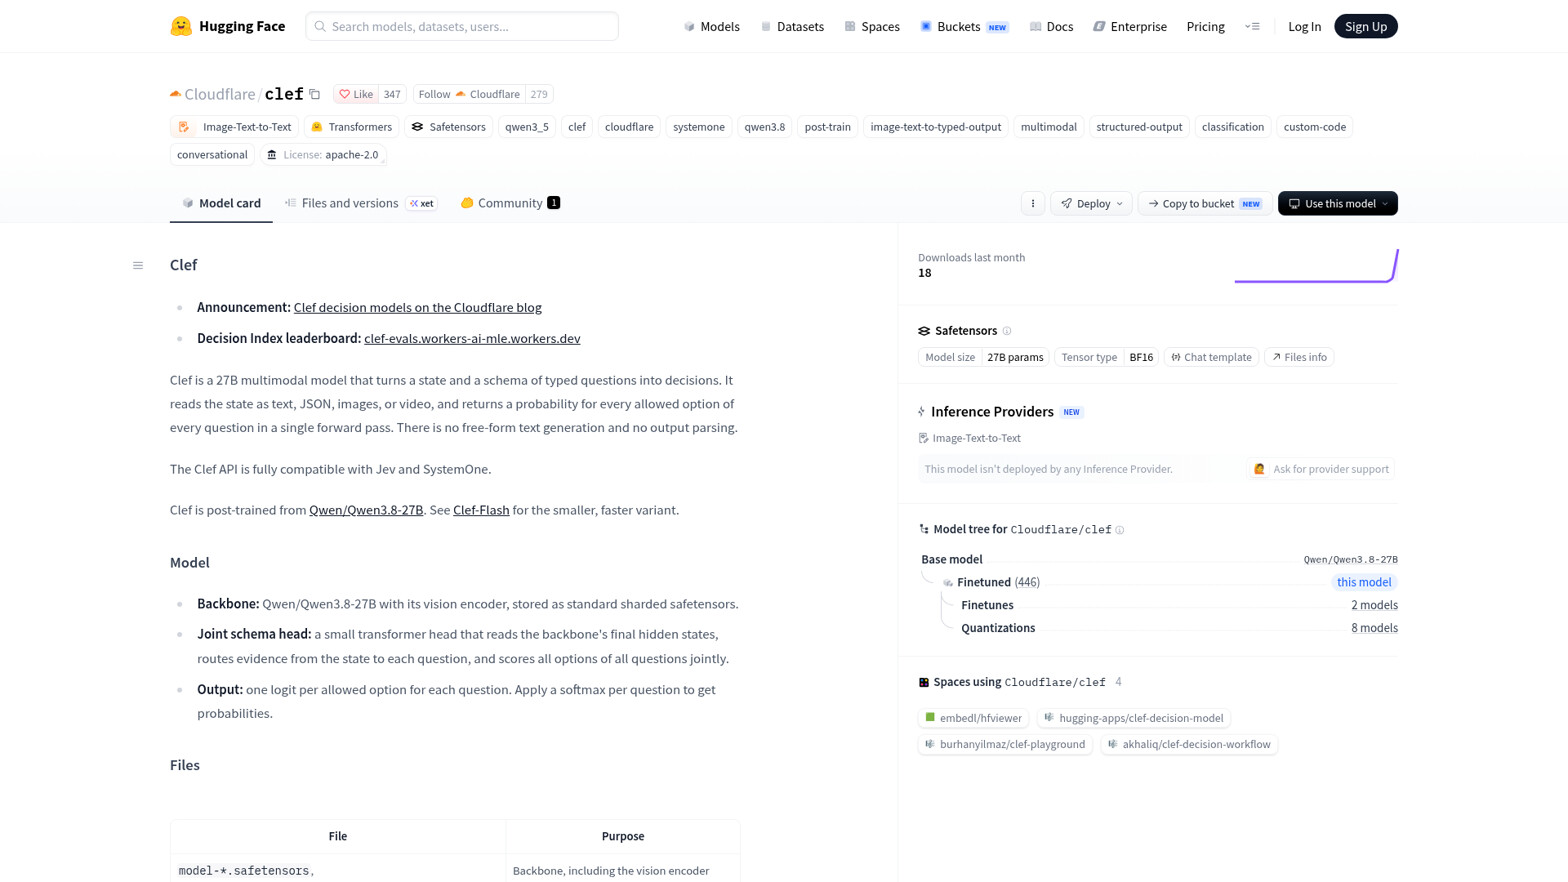
图 2:Hugging Face 上的 Cloudflare/clef 模型卡首页,可见 apache-2.0 许可、基座 Qwen/Qwen3.8-27B、27B 参数与 BF16 张量类型。来源:Hugging Face 模型页 Cloudflare/clef,2026-10-02。
数据解读
先说口径:以下 benchmark 与延迟数字全部是 Cloudflare 自测,榜单也是它自建的在线演示站,第三方没有复测。
官方自测:10 项决策基准(6 个模型对照,节选)
| 基准 | Clef | Clef-flash | Jev | DiffusionGemma Jev | Kev 9B | Laya |
|---|---|---|---|---|---|---|
| BFCL · case exact | 98.47 | 98.76 | 95.75 | 96.52 | 94.51 | 38.13 |
| API-Bank · accuracy | 91.93 | 93.11 | 88.19 | 83.66 | 56.30 | 11.41 |
| BANKING77 · macro-F1 | 94.20 | 90.93 | 79.74 | 74.28 | 84.83 | 14.29 |
| CLINC150+OOS · macro-F1 | 97.43 | 66.77 | 89.27 | 83.49 | 79.03 | 3.19 |
| When2Call · accuracy | 72.37 | 65.58 | 80.97 | 75.44 | 49.62 | 11.94 |
| PhishNChips · accuracy | 79.60 | 75.05 | 62.55 | 85.35 | 50.75 | 50.15 |
- 官方结论与其边界:官方称这 10 项里有 7 项由 Clef 系模型取得最高分——按上表可逐项数出;Jev 仍拿下 When2Call(80.97)与 BRIGHT,DiffusionGemma Jev 拿下 PhishNChips(85.35),并非全面领先。
- 另一块:在 Typesafe 自己的 WorkflowEvals 四项中,官方称 Clef 系赢了 3 项(发票处理、客服、安全事件),仅在「agent trace observability」上以 68.5/69.8 落后 Jev 的 71.6。
延迟(官方表,单位毫秒)
| 指标 | Clef | Clef-flash | Jev | DiffusionGemma Jev | Kev-9B | Laya |
|---|---|---|---|---|---|---|
| 中位 | 209.3 | 38.8 | 524.1 | 84.4 | 51.4 | 5.8 |
| p95 | 238.6 | 122.4 | 536.0 | 211.2 | 187.9 | 222.5 |
- 官方口径是「在 43 项基准运行里,Clef 中位比 Jev 快 2.5 倍、Clef-flash 快 13 倍」。但同一张表也说明:Clef 的中位延迟高于 Kev-9B(51.4ms)与 DiffusionGemma Jev(84.4ms),而 Laya 中位最快(5.8ms)却在上表的质量基准里垫底(官方自己也注明 Laya「以质量换取速度」)。⇒ 准确率与延迟必须分开说,不能合并成一句「更快更强」。
- 一个自有用例(官方给):在其威胁情报团队做域名分类——配合 Browser Run,Clef 在一个域名上完成抓取、渲染、分类耗时 2.2 秒,对照其最快的通用 LLM
gpt-oss-120b在同一流程 4.7 秒且只返回两个分类。
价格与使用成本
- Cloudflare 官方定价页本次未取到,官方价目因此无从核实。
- 第三方转述(须按转述读):The Register 引述称 Clef 为
$0.24/百万 token、约为 Jev 的$0.042/百万 token的 6 倍;同篇引 Cloudflare 的 Michelle Chen 称本地跑的显存门槛是Clef-flash需 ≥41GB、Clef需 85GB。这两组数字均出自该媒体,未在官方页核到。 - 计费与适用条件提醒:官方更新日志把价格指向其 Workers AI 平台定价页;权重这一侧是 Apache 2.0,但官方原话只写「open-sourcing these models … under an Apache 2.0 license」,训练数据与配方未提 ⇒ 不要把「权重开源」写成「全部开源」。
辩证评估
- 机会: 它把「决策模型」从一个明星产品变成一个可比较的品类——官方一张对照表就把 Clef/Clef-flash/Jev/DiffusionGemma Jev/Kev 9B/Laya 并排摆开;而且这是这条线第一次出现「大厂自训 + 权重开源 + 配套微调服务」的完整形态。对需要「有限预设答案」的调用场景,非自回归打分+64K 上下文+可传图的组合确实比用通用 LLM 做分类更省事。
- 限制或争议:
- 所有分数都是自测,榜单是自建演示站;第三方没有复测,官方也没有提外部评测。
- 准确率与延迟是两回事(见上);不能写「全面领先」。
- 价格与本地显存门槛只有媒体转述,官方页未核到。
- Apache 2.0 只覆盖权重,训练数据与配方未公开。
- 主体容易混淆:Clef/Jev/Kev 分属 Cloudflare/Typesafe AI/社区项目。
已知 vs 待验证
已知(官方已证实)
- 发布日 2026-10-01(更新日志与博客页首互证);两个模型的规格(27B/9B、64K)、训练口径(冻结 Qwen3.8-27B/Qwen3.5-9B + rank-256 LoRA)、API 形态(System One/三类问题/每次最多 64 问)、权重以 Apache 2.0 在 Hugging Face 开放、托管端点,以及企业「不读取、不存储、不训练」的承诺。
独立观察 / 转述
- The Register 给出的
$0.24/百万 token、约 6 倍于 Jev、以及 41GB/85GB 显存门槛。 - 全部 benchmark 与延迟为厂商自测(榜单亦为官方自建)。
待验证
- Cloudflare 官方定价页未取到;官方未说明入门期、区域或速率限制条件。
- 训练数据与训练配方未公开;官方自建榜单的完整 43 项结果未逐项核对。
- 官方称目标是把决策模型放进 agent 热路径,尚无第三方在高并发生产环境下的复测。
给读者的建议
- 先判断你需不需要「决策模型」:如果你的调用是有限预设答案的分类/路由/打分(工单分流、内容分级、风控判定),它比让 LLM 生成再解析更省事;如果你要的是开放式生成或推理,这个品类不适用。
- 迁移成本很低,值得试:因为跟随 System One API,已有 Jev 集成换端点与模型名即可切过来;要本地跑则去 Hugging Face 取权重(注意上面那组显存门槛是媒体口径)。
- 对比时把两件事分开看:准确率看那张 10 项表(注意 Jev 仍在 When2Call、DiffusionGemma Jev 在 PhishNChips 更高);延迟看另一张表(注意 Clef 中位高于 Kev-9B 与 DiffusionGemma Jev,Laya 最快但质量垫底)。
- 暂不适合谁:想要「一个模型包打天下」的团队——决策模型是给 agent 做有限决策的组件,通常要与一个通用 LLM 搭配使用。
来源链接
官方
- Cloudflare 官方博客《Introducing Clef: our open-source decision models, and new RL fine-tuning platform》(页首标 OCTOBER 1, 2026):https://blog.cloudflare.com/clef-decision-models/
- Cloudflare 开发者更新日志《Introducing Clef: Cloudflare’s first open-source decision models, now on Workers AI》(October 1, 2026):https://developers.cloudflare.com/changelog/post/2026-10-01-clef-workers-ai/
- 权重页
Cloudflare/clef:https://huggingface.co/Cloudflare/clef - 权重页
Cloudflare/clef-flash:https://huggingface.co/Cloudflare/clef-flash - 官方自建决策基准演示站:https://clef-evals.workers-ai-mle.workers.dev/
独立 / 媒体报道(价格与显存门槛的出处)