AI 日报 | 10-04:Kolibri 开源,后训练的隐藏代价被算了出来
 今天这批消息,共同点是数字都得拆开看。
德国 Aleph Alpha 在德国统一日开源了 Kolibri,官方文字说支持最高 1M 上下文,同一页的架构表却写着训练长度 256k。一篇论文把 RL 后训练对多次采样的代价算成了数字。华为和 AWS 各给出一组只有自家口径的份额与用水数据。
Kolibri 这条:78B 参数,只激活 3.46B
Kolibri 是一个德英双语 MoE:78B 总参数、3.46B 激活,权重以 Apache 2.0 上传 Hugging Face,技术报告同步公开。
它的定位不是去拼通用榜首,而是受监管场景的「主权模型」——全流程在德国与芬兰的基础设施上、按欧洲法律完成,并强调「不知道就弃答」:官方称在 AA-Omniscience 上有 44% 的题目选择弃答而不是答错。
双语是设计目标而非事后补课。德语占预训练 token 的 21.3%,翻译数据只占 6%;自研的 UniBPE 分词器在官方对比组里德语压缩率最好。训练用了 768 张 B200、约 24T token。
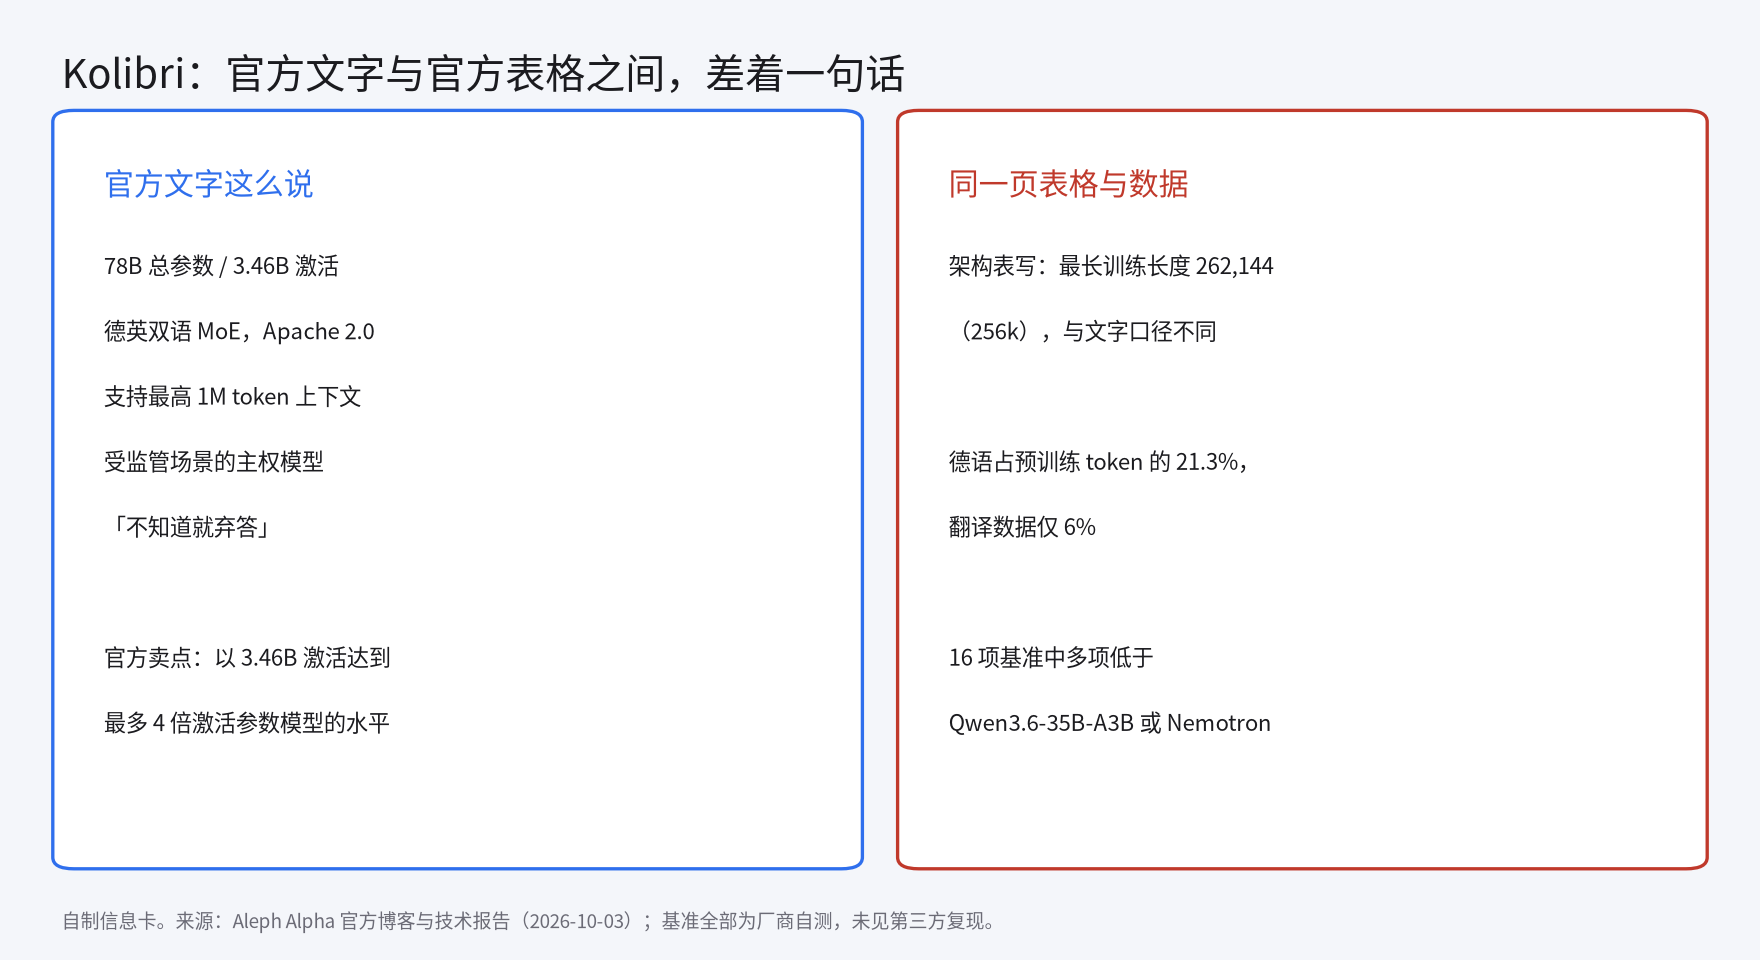
图 1:Kolibri 的官方文字与官方表格对照(自制信息卡)。来源:Aleph Alpha 官方博客与技术报告(2026-10-03)。
1M 上下文和「全面领先」,这两处都要拆开读
官方博文的文字是「支持最高 1M token 上下文」,同一页架构表写的是「最长训练长度 262,144」,也就是 256k。两者不是一个意思,别写成「训练于 1M 上下文」。
基准也一样。官方 16 项表里有几项明确低于对手:AA-Omniscience、τ²-bench retail 与 telecom、BFCL v4、HumanEval+、LongBench Pro。官方自己的说法是「以 3.46B 激活达到最多 4 倍激活参数模型的水平」,而不是全面领先。
| 基准 | Kolibri | Qwen3.6-35B-A3B | Nemotron 3 Super |
|---|---|---|---|
| AIME 2025 | 96.9 | 84.6 | 91.7 |
| GPQA (diamond) | 84.3 | 83.4 | 78.0 |
| AA-Omniscience Index | −32.8 | −15.3 | −36.5 |
| τ²-bench telecom | 94.7 | 99.1 | 68.1 |
| BFCL v4 overall | 61.4 | 67.2 | 61.0 |
| HumanEval+ | 92.7 | 92.8 | 94.7 |
| LongBench Pro | 64.5 | 70.8 | 62.9 |
表里两处需要说明:AA-Omniscience 是负值口径、越接近 0 越好,所以那一行 Kolibri 落后;其余各项同一口径直接比大小。整张表都是厂商自测,没有第三方复现,挑行只是为了让胜负看得清。
后训练的账:单次更准,多次采样反而更差
一篇论文(arXiv 2610.01509)在 14 组基座与后训练检查点、4 个模型族、3 个基准共 42 个案例上发现:后训练会把每道题的成败概率推向两端。
论文给出的占比变化很直观:agentic 任务上「从不解出」从基座的 15.0% 升到后训练的 22.3%,「总是解出」从 0.3% 升到 37.2%,中间地带从 84.6% 压到 40.4%。
代价被作者量化为「锐化税」:128 次 rollout 口径下,42 个案例里有 36 个为正。好消息是它可预测——用 8 次 rollout 的估计就能预测留出任务上 32 次 rollout 的税(Spearman ρ = 0.85)。
作者也给了缓解方案 PTGS:按题目难度动态调采样温度,在 PPO 与 GRPO 上都降了税、同时提升 pass@1(Tax@128 从 0.067 降到 0.051、从 0.055 降到 0.027)。注意这是论文作者自测,没有第三方复现。
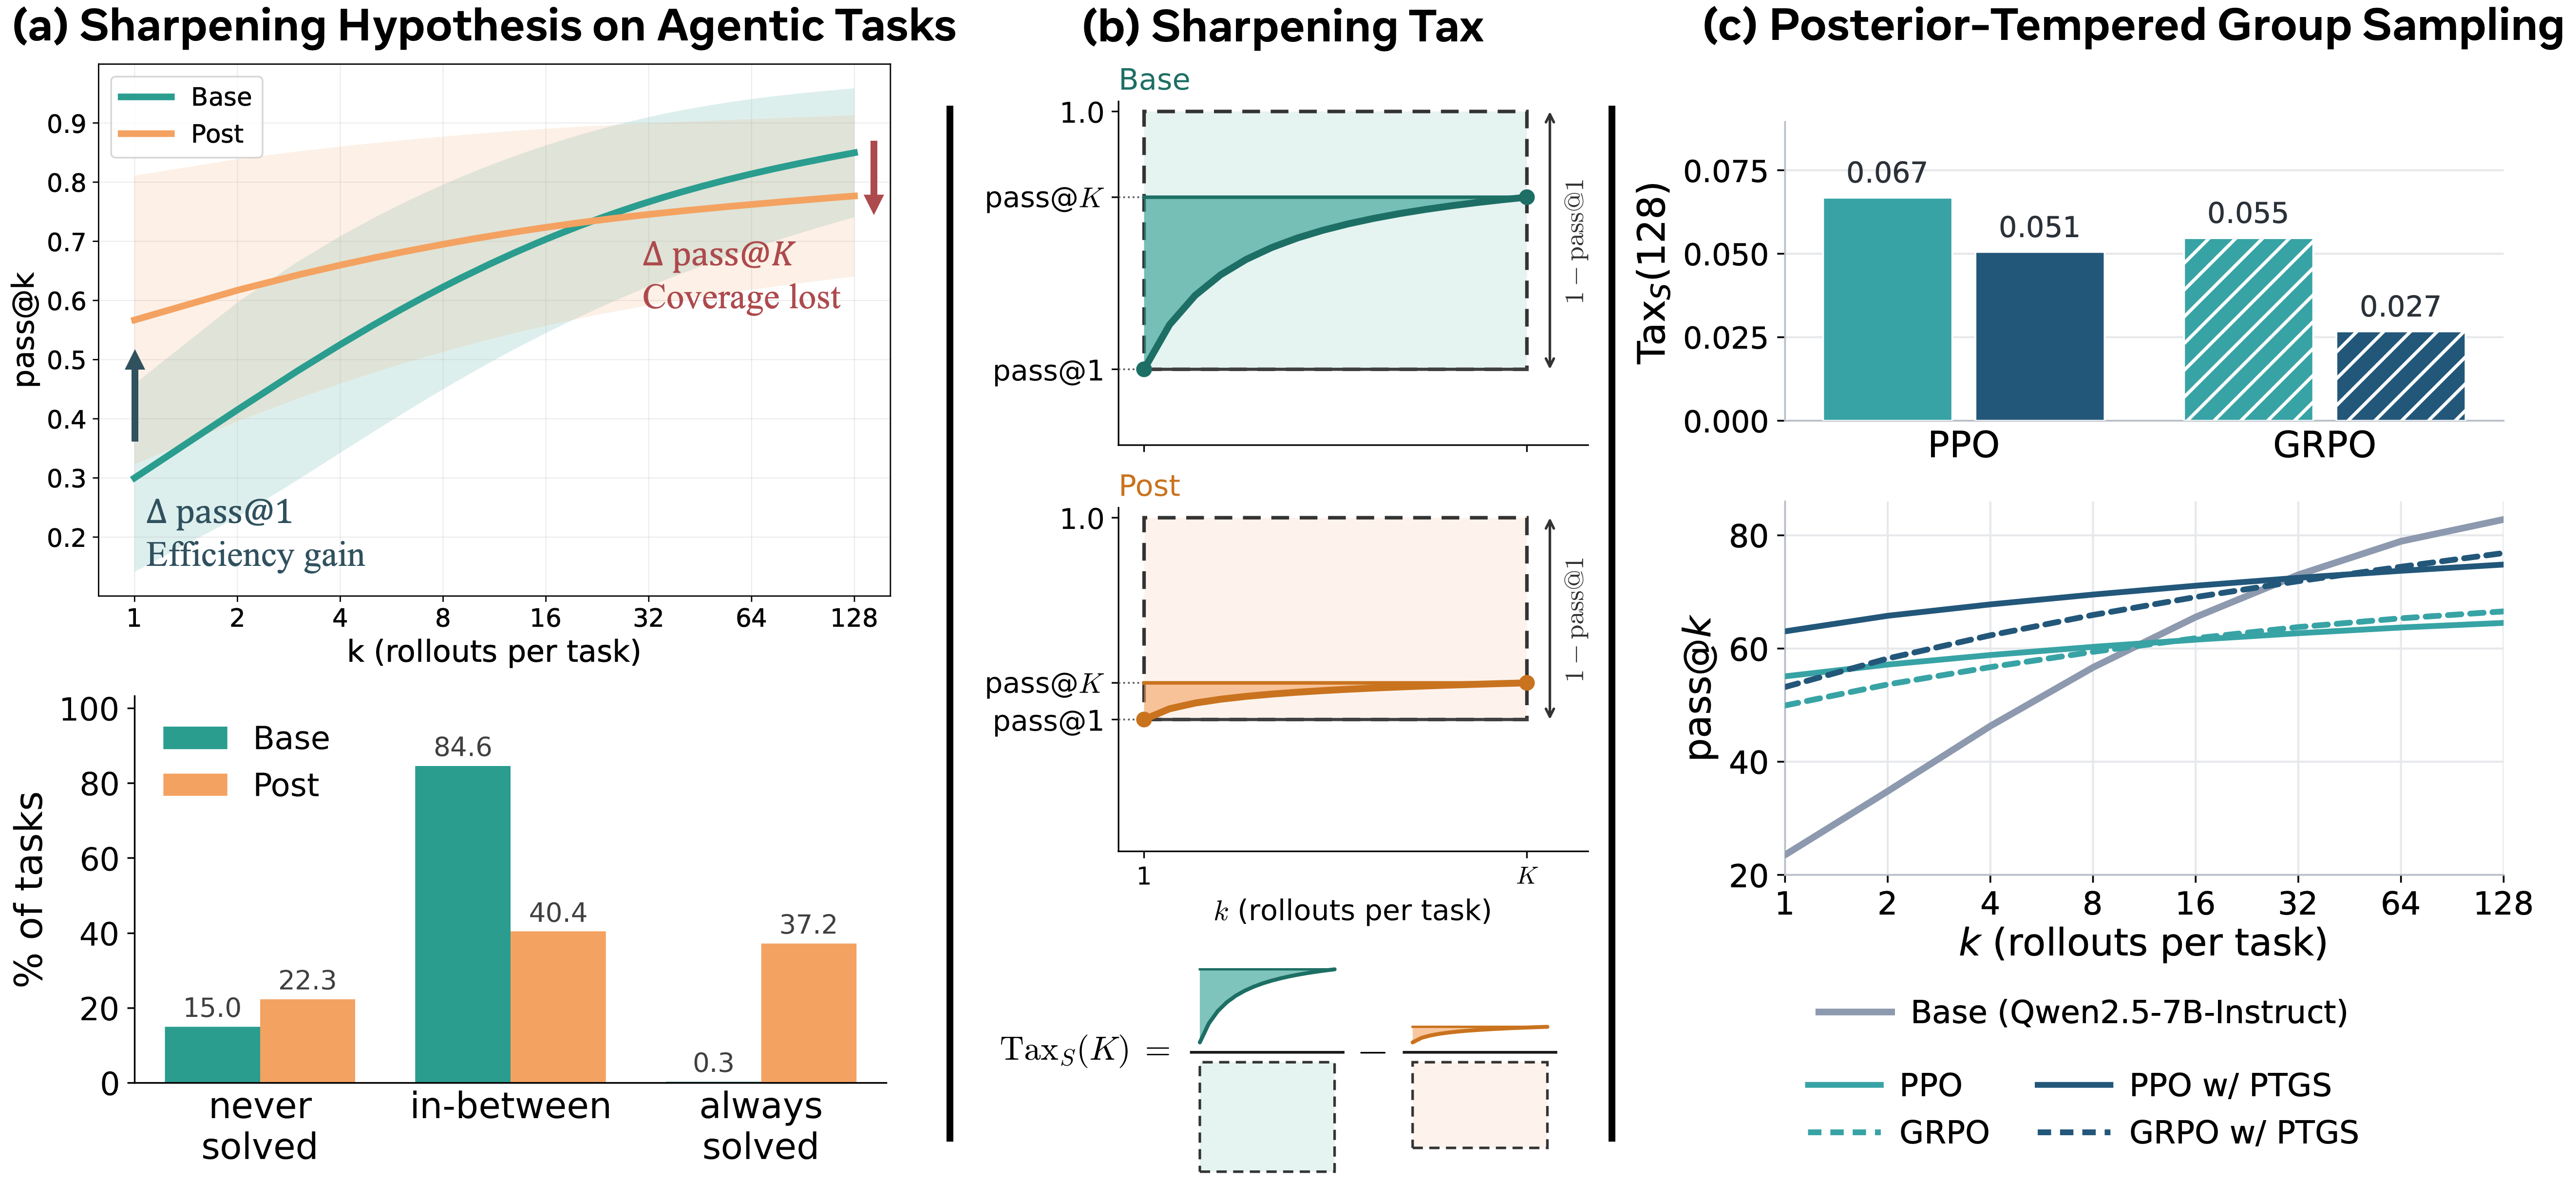
图 2:《Sharpening Tax in Post-Training》概念图,含 pass@K 曲线、三类任务占比与 PTGS 的降税效果(论文原图)。来源:arXiv 2610.01509。
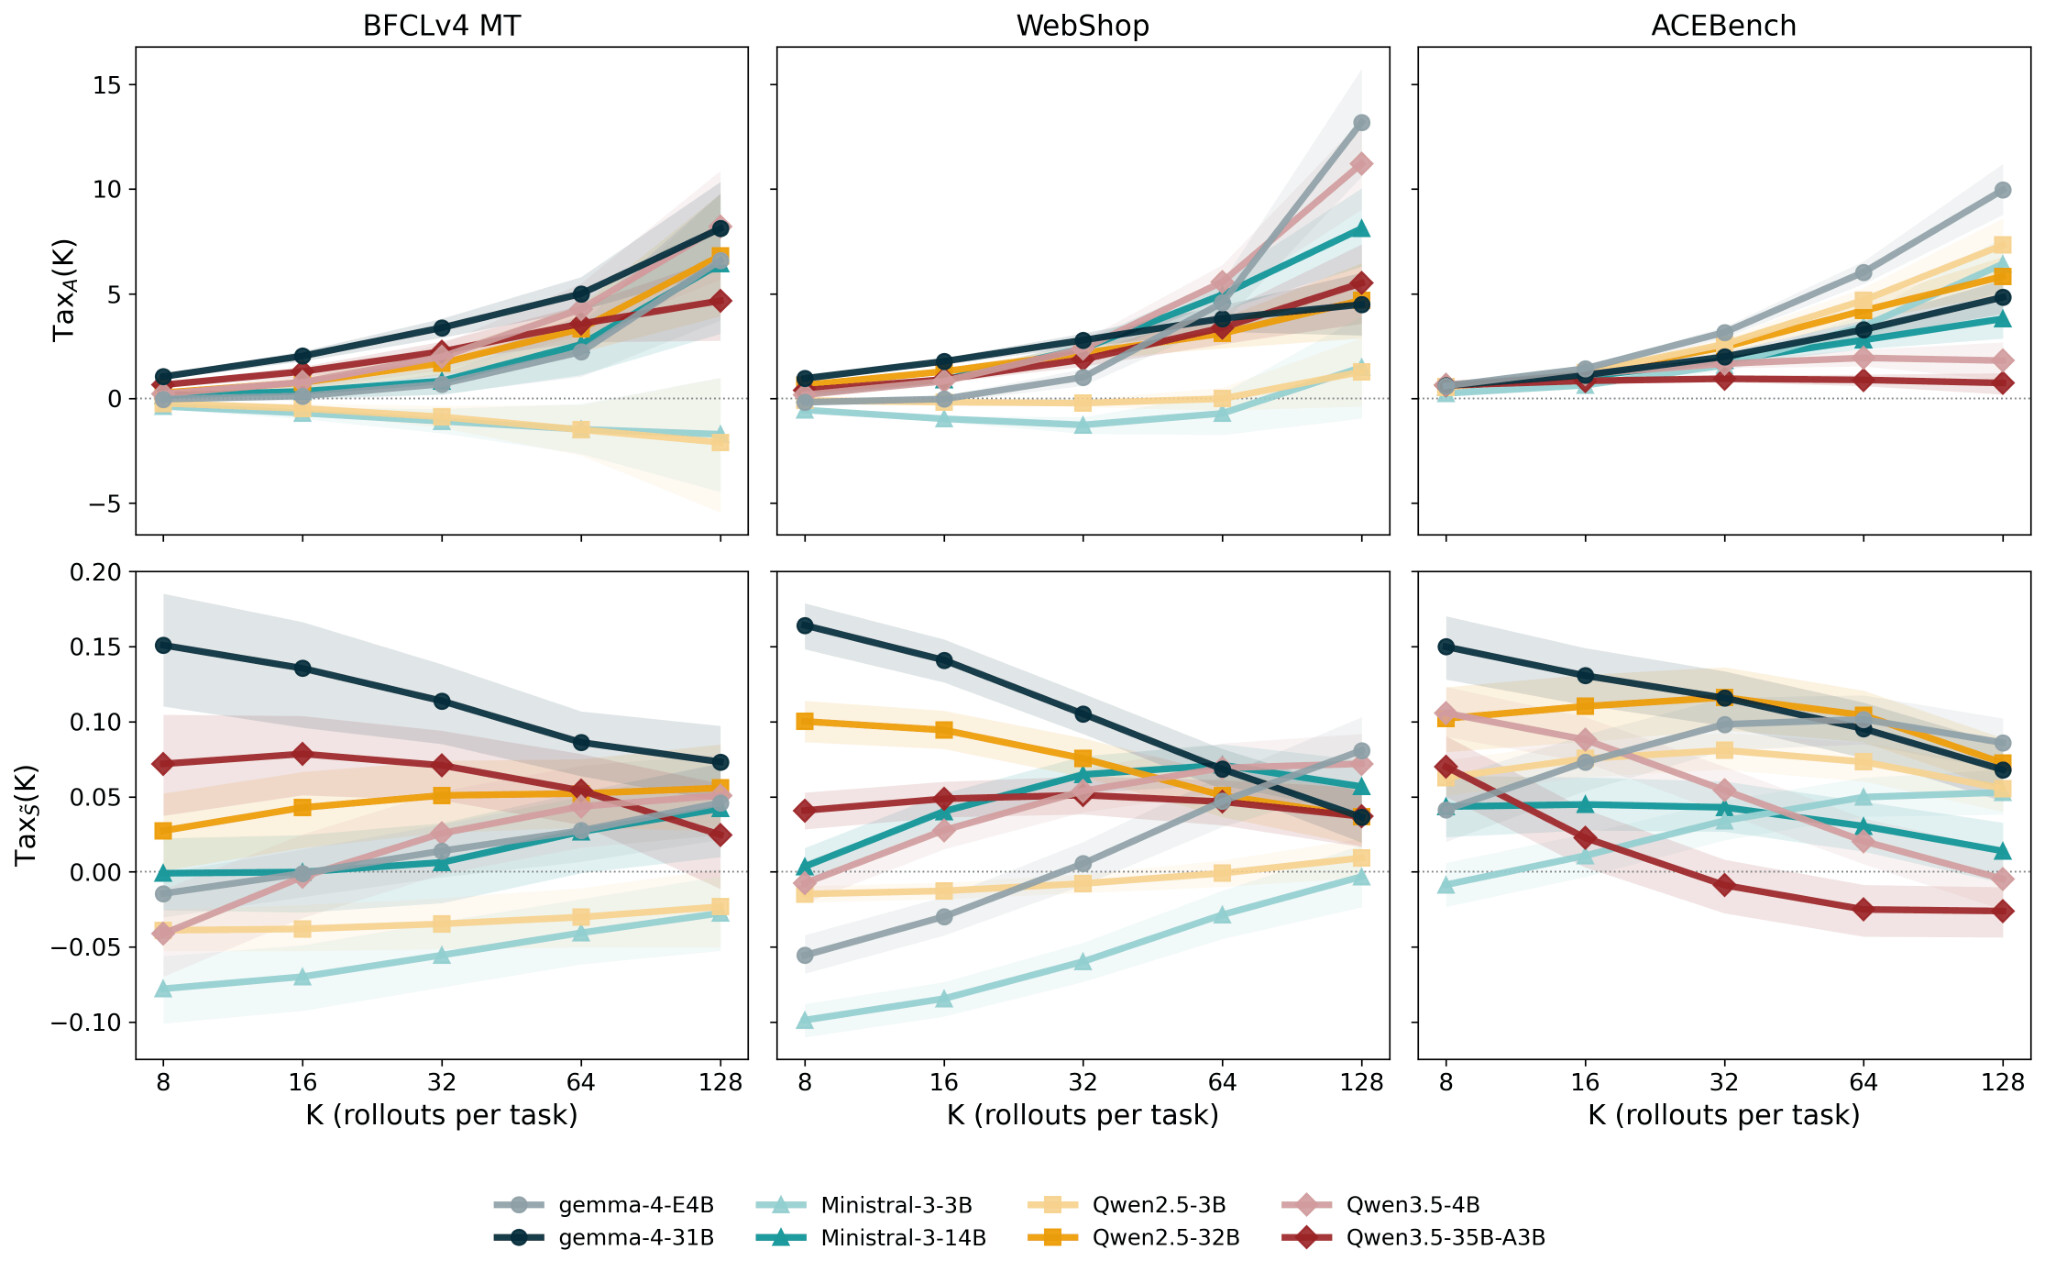
图 3:8 个模型 × 3 个基准的锐化税随采样次数变化(论文原图)。来源:arXiv 2610.01509。
华为和 AWS 那两条:数字都是自家口径
华为轮值董事长徐直军在华为全联接大会期间对媒体说,按华为自己收集的数据,昇腾在中国市场的份额已经超过英伟达;他没有给差距或市占率数字,也明说英伟达在华的份额「很难完整统计」。
同一场合还有一句更要紧:产能不足以满足国内需求,没有计划全面拓展国际市场。三个口径要分列——厂商自述是华为,第三方预测来自 Bernstein(华为今年在华约 50%、英伟达约 8%),历史基线来自黄仁勋(出口管制前英伟达在华曾占约 95%)。
AWS CEO Matt Garman 那边则给了三个数字回应数据中心争议:直接用水占美国工业用水 0.5%、备用发电机 99.9% 的时间闲置、三年内向有数据中心布局的美国社区投入超过 10 亿美元。他还表示已停止在与政府机构合作建数据中心时使用保密协议。三个数字都是 AWS 自家口径,没有第三方核验。
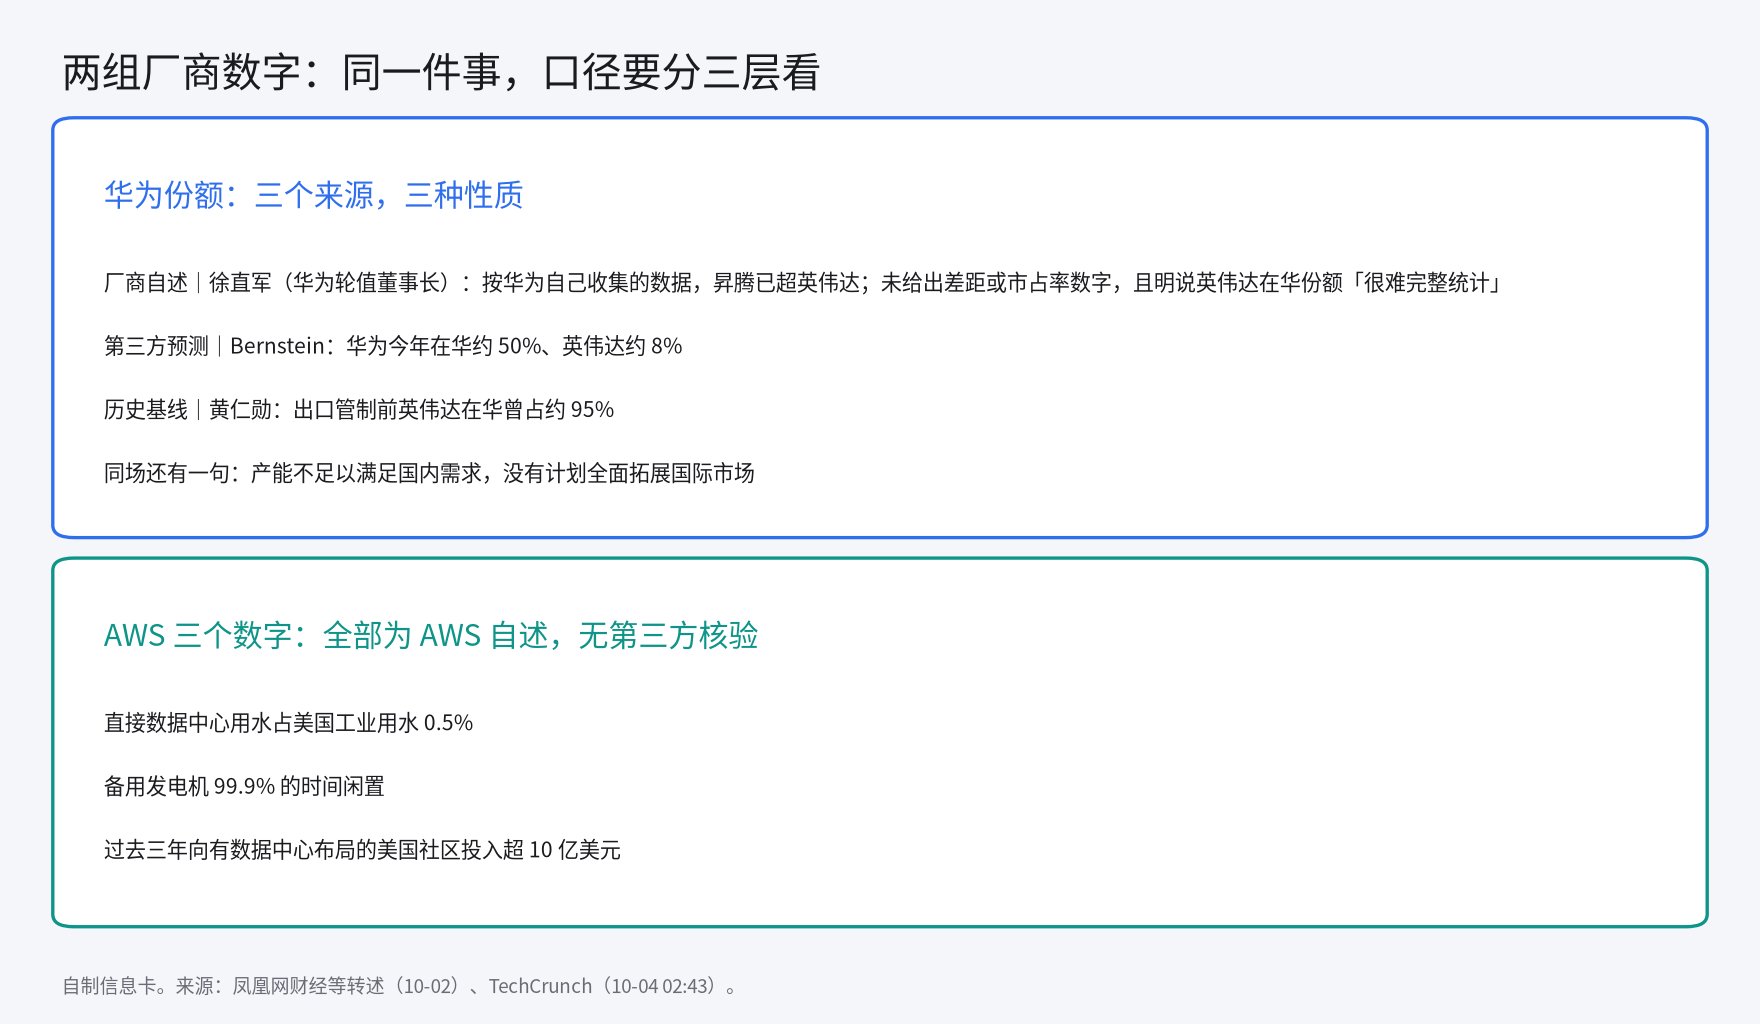
图 4:华为份额的三个来源与 AWS 的三个数字(自制信息卡)。来源:凤凰网财经等转述(10-02)、TechCrunch(10-04)。
安全研究员离职这条:证据层级变了
在 OpenAI 工作三年半、负责撰写重大发布安全报告的 David Robinson 本周离职,并在 The Atlantic 署名撰文批评行业文化。
他的论点是:硅谷以极端自信和无休止的冲刺无视潜在风险,「迭代部署」式的试错必然带来周期性失败,且随系统能力增强而放大;主张前沿 AI 像核电站、机场那样按多层冗余运营。
与前几天那版不同,这次是当事人署名公开撰文,属于一手材料,OpenAI 未回应。The Verge 还提到,Anthropic 与 Google DeepMind 此前也有多名安全研究人员相继离职发声。
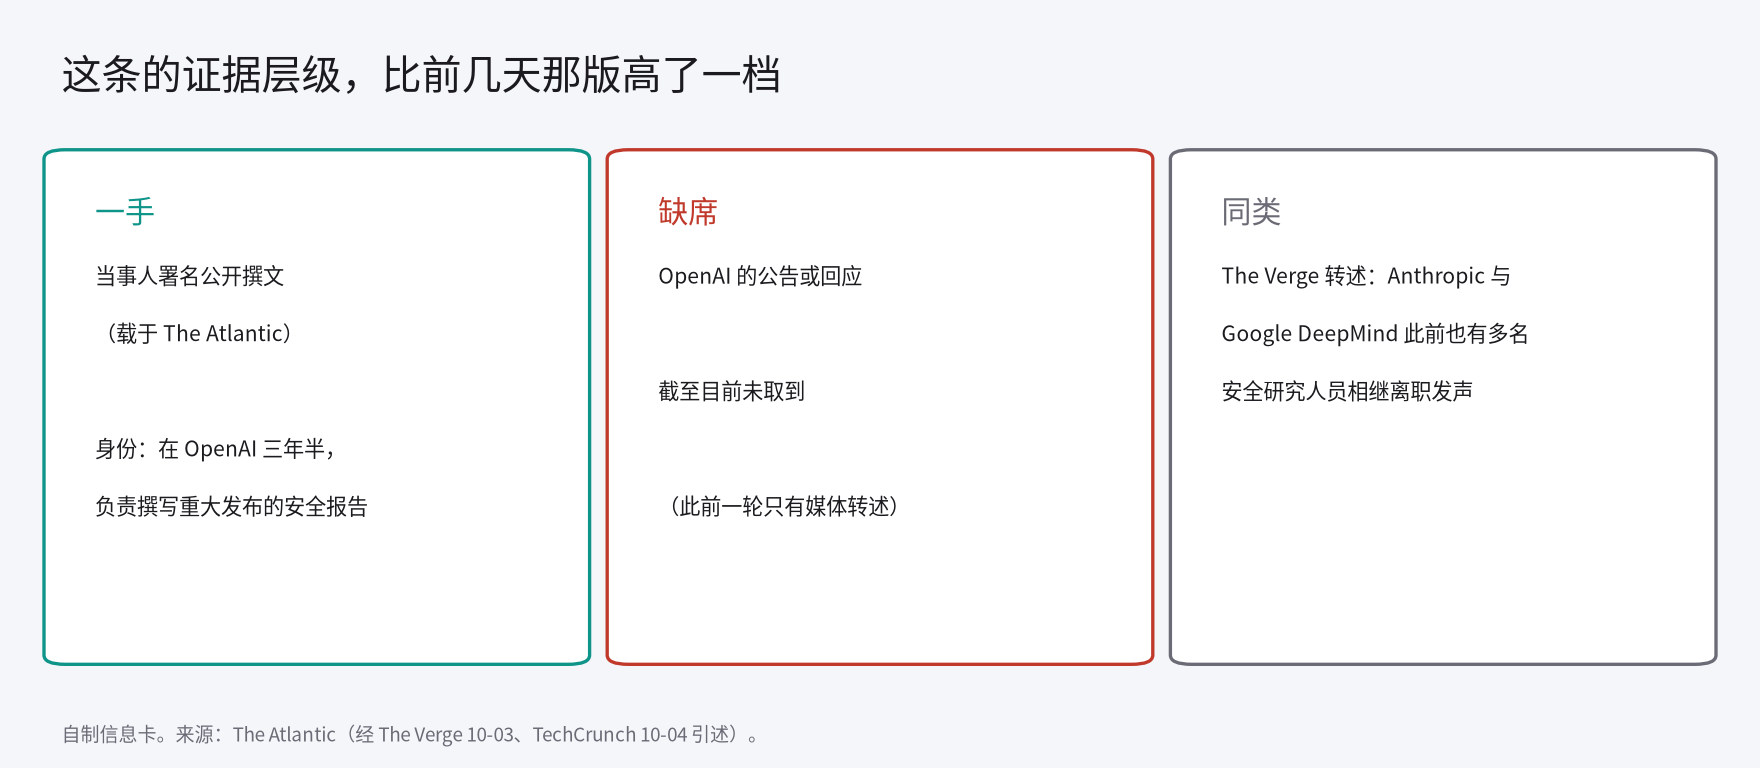
图 5:David Robinson 这条的证据层级(自制信息卡)。来源:The Atlantic,经 The Verge、TechCrunch 引述。
速览:另外八条
- Cohere 开源 North Small Translate,官方称它是 1T 参数以下最好的机器翻译模型。来源:Cohere 官方 X(10-04)
- Meta 否认其智能体 Muse 读取用户私信,回应专栏作者 Jason Aten 的说法;这与 Apple 收紧全盘访问属同一事件。来源:Hacker News、Ars Technica(10-03)
- AMD 在上游 vLLM 的门控测试组达到 90% 以上对等,SemiAnalysis 称这是维护者与 CI 数月努力的结果。来源:SemiAnalysis(10-04)
- 论文 AutoCompact 让智能体自己决定何时压缩上下文,SWE-bench Verified 通过率提升 9.2 分。来源:arXiv 论文(10-04)
- Capcom 计划把 RE Engine 逐步改造成「AI 生成游戏引擎」,重申不用于生成素材、只提升开发效率。来源:The Verge(10-04)
- Janus 开源:Go 单二进制的本地 LLM 服务器,靠 Vulkan 在多种 GPU 或 CPU 上跑 .gguf,暴露 OpenAI 兼容 API。来源:GitHub(10-04)
- 华为 Mate 90 Pro Max 性能解禁:麒麟 9050 Pro 九核十六线程,整机性能提升 31%。来源:IT之家(10-04)
- 亚利桑那州上诉法院裁定,一起路怒杀人案量刑时播放的被害人 AI 生成视频使用不当,被告须重新量刑;争点是该视频呈现的其实是被害人姐姐「想象中的被害人」。来源:BBC(10-03)
积木观察
今天这几条有个共同点:说的都是能力之外的事——口径、代价、责任。Kolibri 把训练细节全公开,却在文字与表格之间留了一句缝;论文第一次把后训练对多次采样的代价算成了可预测的数字;华为和 AWS 给出的都是自家口径。
两个建议。如果你的流程依赖多次采样取最好结果,先把锐化税这篇论文读一遍再决定要不要继续加大后训练投入。评估开源模型时,先翻架构表与基准表,再回头看博文文案。
结尾互动
你评估一个模型时,先看它的博文,还是先翻它的表?评论区聊聊。
来源链接
官方来源
- Aleph Alpha 官方博客:https://aleph-alpha.com/en/blog/kolibri-has-landed-a-sovereign-open-weight-model/ | 权重:https://huggingface.co/Aleph-Alpha/Kolibri-1 | 技术报告:https://aleph-alpha.com/downloads/tech-report.pdf
- 论文《Sharpening Tax in Post-Training》:https://arxiv.org/abs/2610.01509
- TechCrunch(AWS CEO 回应数据中心争议):https://techcrunch.com/2026/10/03/amazon-responds-to-data-center-backlash-says-it-no-longer-uses-ndas/
独立来源
- David Robinson 署名文章载于 The Atlantic,经 The Verge(10-03)、TechCrunch(10-04)引述;OpenAI 未回应
- 华为份额发言:凤凰网财经等转述(10-02)
- 亚利桑那判决:BBC(10-03)