AI 日报 | 10-05:上下文交给模型自己管,比手写压缩更准也更省算力
 让模型自己管上下文,比手写压缩策略更准,也更省算力。这是今天最值得看的一条。
同一批消息的另一半在政策与产品侧:特朗普把「超级智能」落成一个协调机构,Anthropic 的宗教咨询被曝光,Gemini 免费档要从 10 月 9 日起降一档。
头条 | 别写压缩策略,让模型自己改上下文
Context Language Models 的做法很直接:把上下文当成一个文件,允许模型对它做不受限的更新;多智能体场景下,多个上下文就以文件形式并存。
论文是 arXiv 2609.37725,代码已开源在 facebookresearch/context-language-models,作者里能看到 Nathan Lambert、Pang Wei Koh、Luke Zettlemoyer 等人。
零样本条件下(Mini-SWE-Agent 骨干,对比 MEM1、Self-Compact、ACM、RLM 以及 Codex 式摘要),它给出的是「更准且更省」:BrowseComp-Plus 上准确率更高 11.4%、FLOPs 少 21.5%,12 小时 EdgeBench 分数高 5%、FLOPs 少 59%。
| 场景 | CLM 结果 | 计算 |
|---|---|---|
| BrowseComp-Plus(零样本) | 准确率高 11.4% | FLOPs 少 21.5% |
| 12 小时 EdgeBench(零样本) | 分数高 5% | FLOPs 少 59% |
| 24 小时多仓库 agent-swarm | 同算力改进多 65% | 同算力 |
| 上下文管理任务(在上下文中学习) | 留出准确率最高 +35.9 点 | 计算减少 |
| Qwen3.5-9B(在线 RL) | 28.8 → 42.5 | FLOPs 少 12% |
| Suffix Cache Reuse(服务端) | 同等表现 | 比标准 SGLang 再降 35% |
它还试了两种「学习」路径。在上下文中学习,靠自然语言指令、经标准 skill-optimization 循环演化,上下文管理任务留出准确率最高加 35.9 点;在权重中学习,用在线 RL 把 Qwen3.5-9B 在 BrowseComp-Plus 上从 28.8 → 42.5,FLOPs 还少 12%。
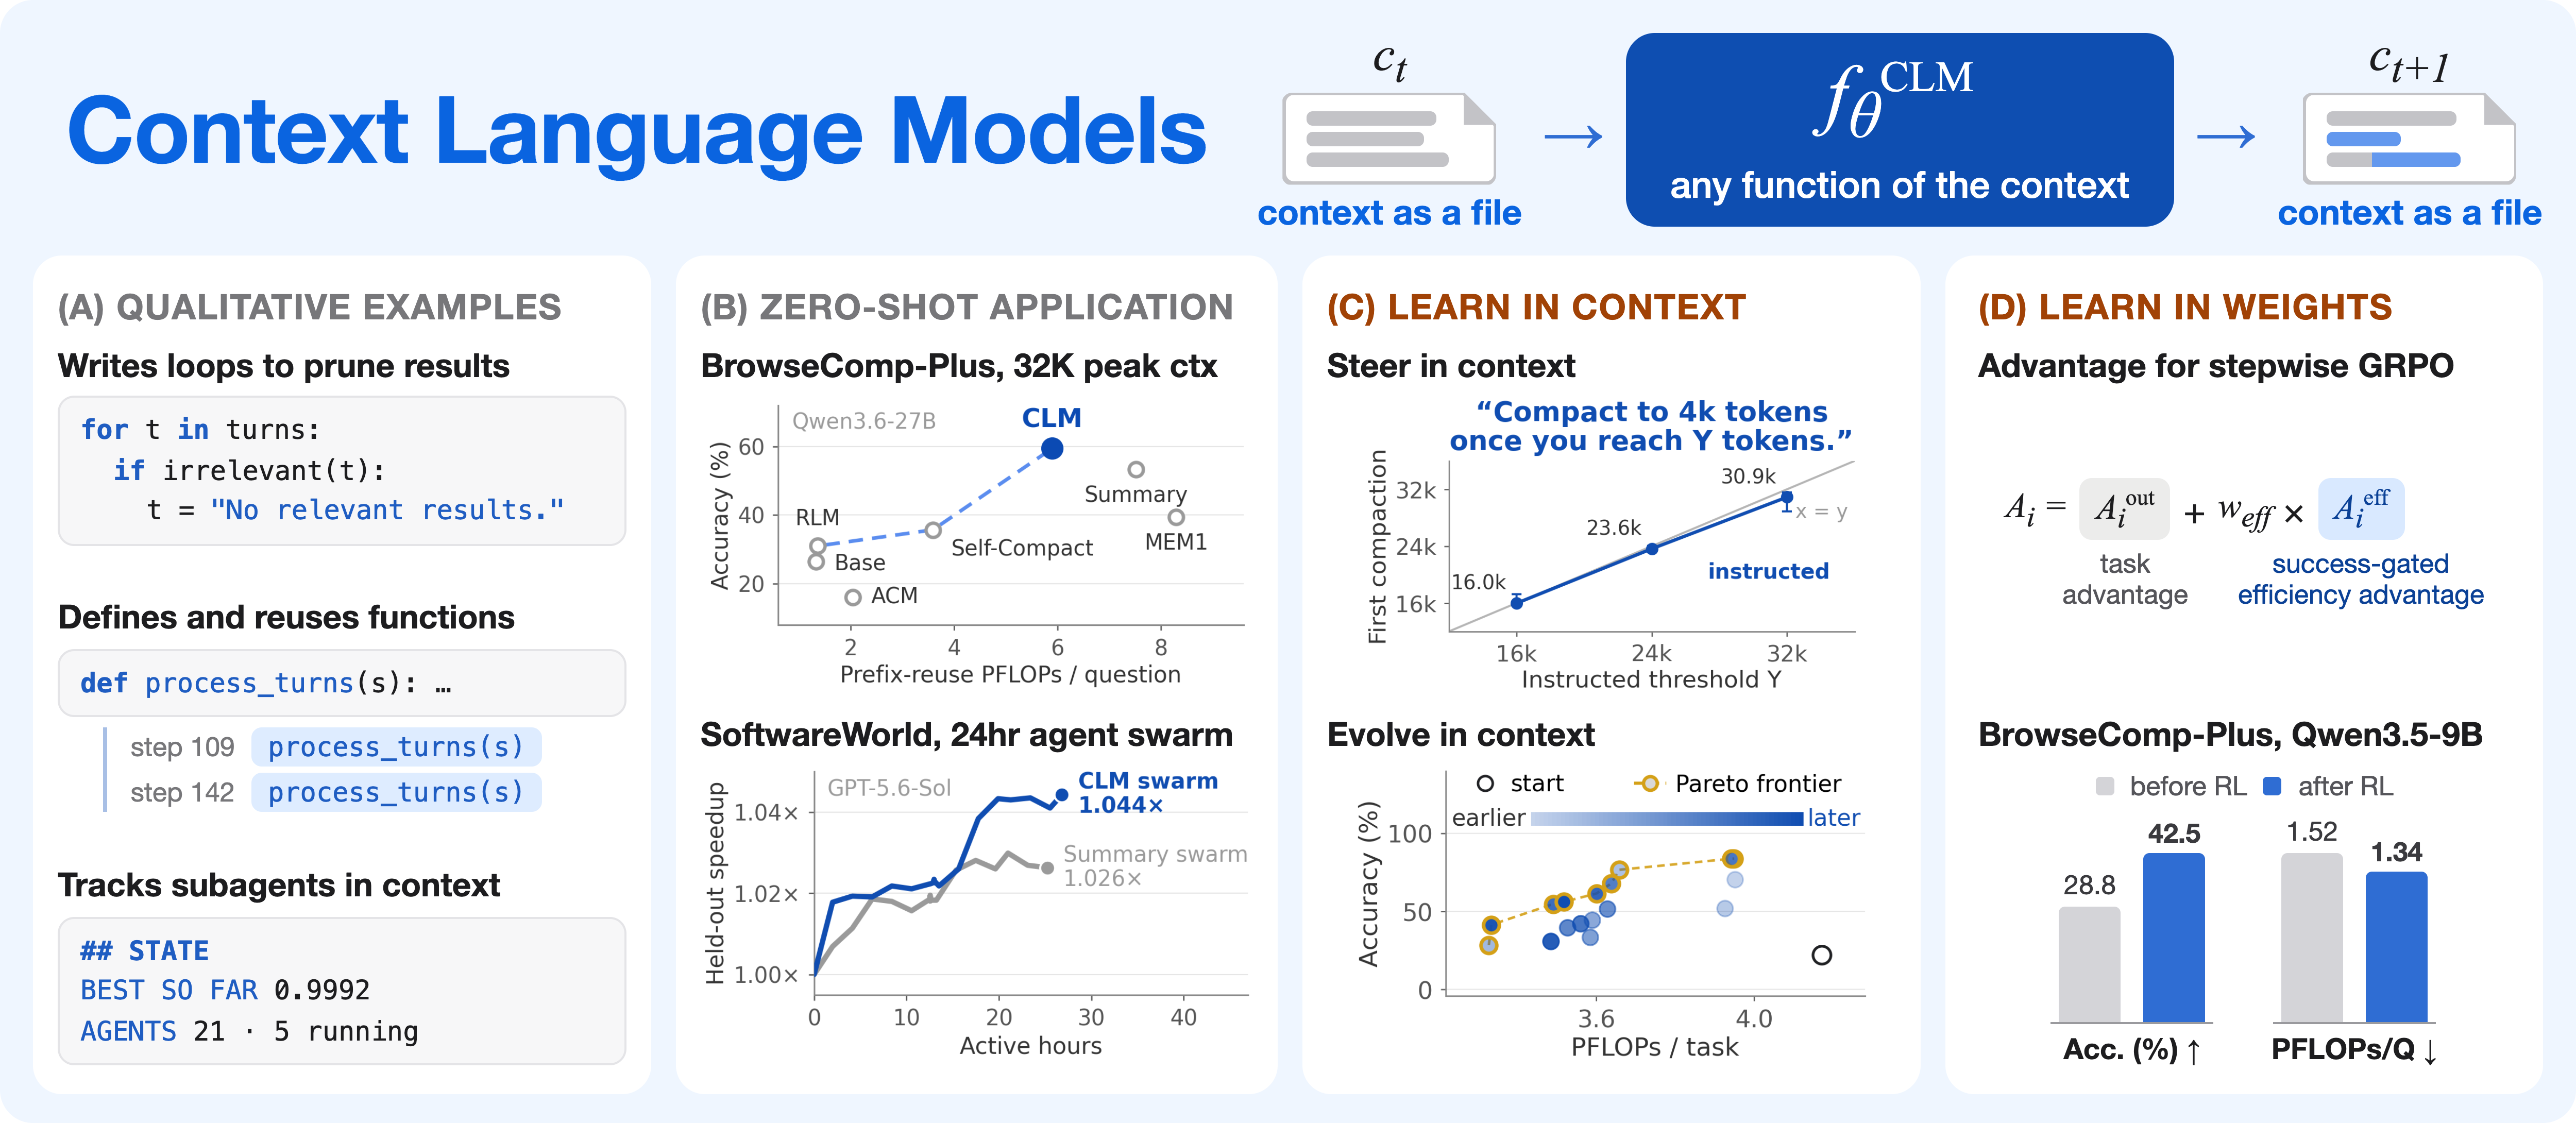
图 1:论文四栏总览,含定性例子、零样本应用、在上下文中学习与在权重中学习。来源:arXiv 2609.37725《Context Language Models》。
另外配了一个服务端方案 Suffix Cache Reuse:同等表现下,服务端计算比标准 SGLang 再降 35%。论文里那张对照图讲的就是这一段。
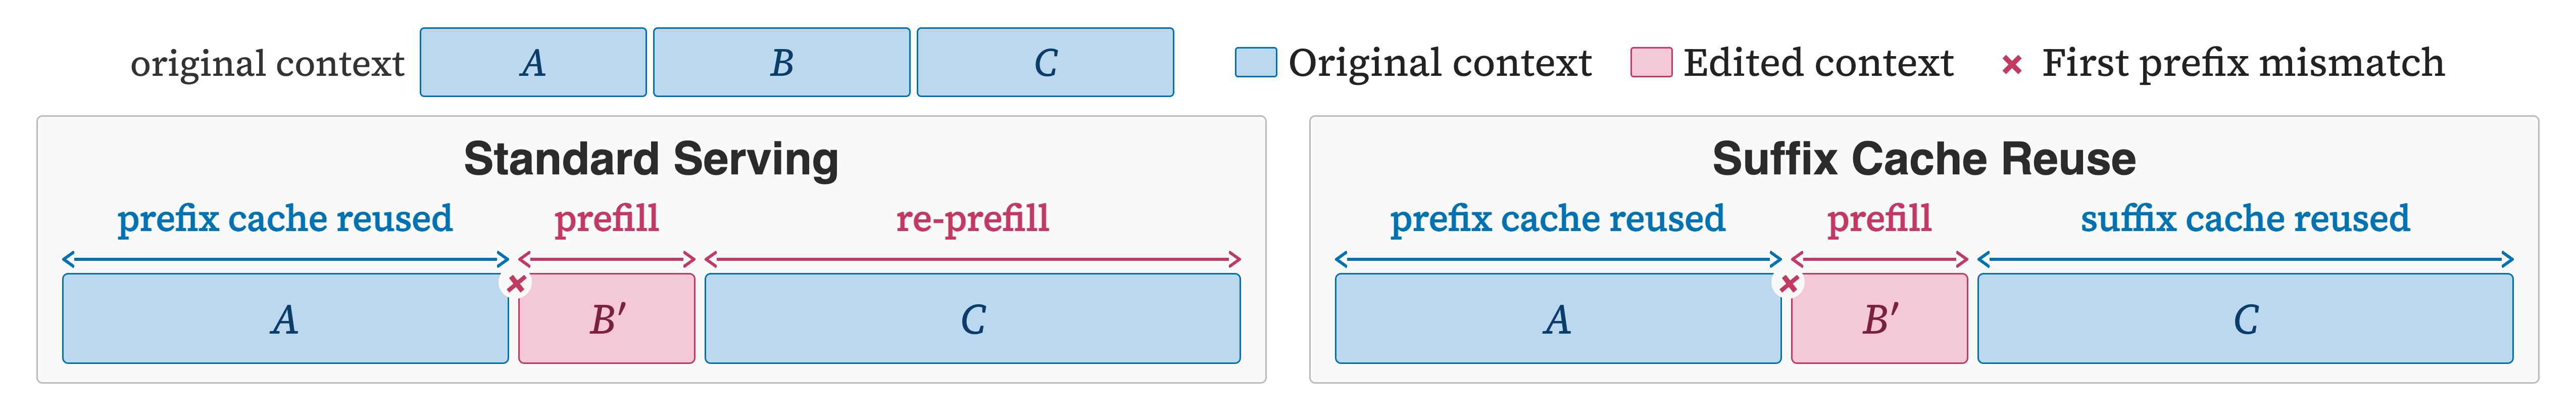
图 2:标准服务与 Suffix Cache Reuse 在编辑上下文后的重算差别。来源:arXiv 2609.37725《Context Language Models》。
它改变的是工程选择:你还要不要自己实现压缩与检索策略,还是把这件事交给模型。需要留意,全部结果是论文作者自测、没有第三方复现;论文 v1 提交于 9 月 29 日,不是这几天才发布。
政策与伦理:一条落地,一条被曝光
特朗普在 Truth Social 宣布成立「超级智能部队」,称其负责协调联邦政府、确保美国继续在超级智能领域保持领先。要写清它的性质:协调机构,不是监管机构。
人事来自《华尔街日报》的转述——国家情报总监 Jay Clayton 任主席,另三名官员任副主席,任务是在 120 天内就风险与机遇提交报告。TechCrunch 与 The Decoder 都指出,这个名称与实际超级智能技术并无关系。
据《纽约时报》,Anthropic 联合创始人 Chris Olah 过去一年主导与天主教、犹太教、锡克教、福音派等宗教领袖私下会面,讨论模型是否已有意识、以及如何为其灌输道德准则。与会者称他像对待有意识存在那样谈论 Claude,而他本人承认无法确定。
报道还提到 Anthropic 在保密协议下接触神学家与宗教学者,希望他们认可 Claude 具有道德地位;奥尔特曼对此发声批评,其批评原文尚未公开。这条的见报日是 10 月 2 日,不是今天。
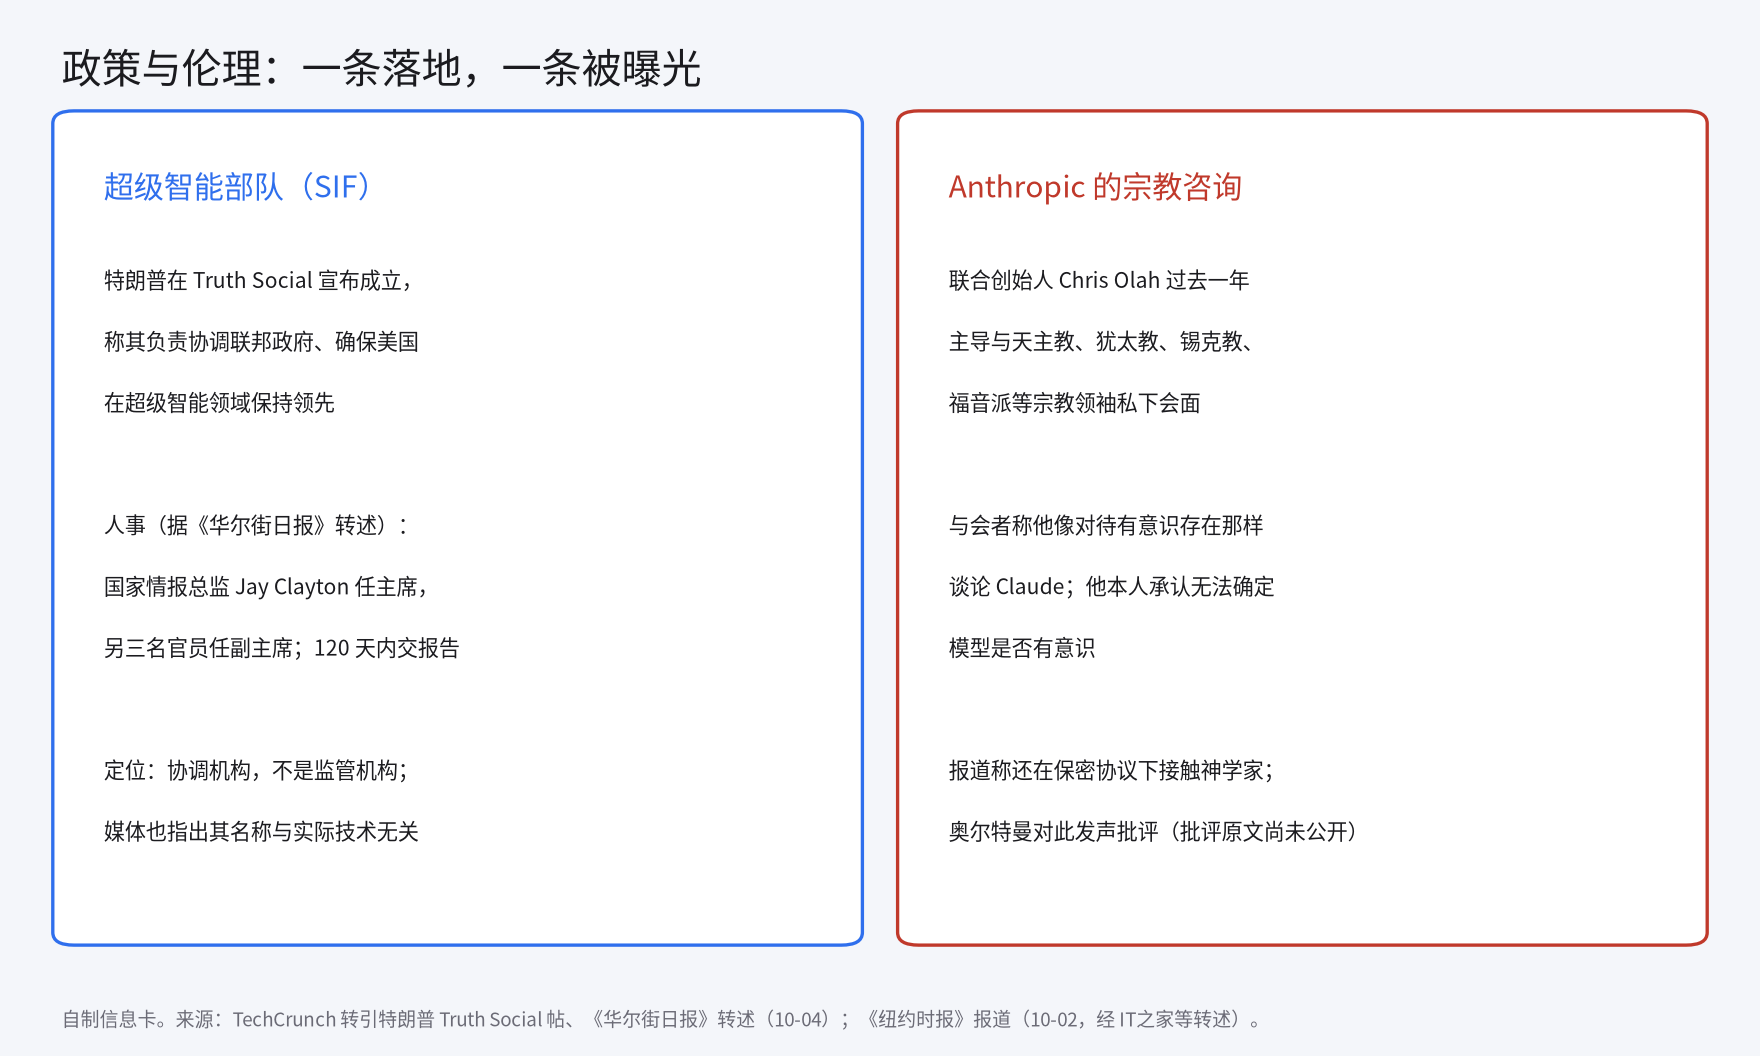
图 3:SIF 与 Anthropic 宗教咨询两条的要点与口径。自制信息卡。来源:TechCrunch 转引特朗普 Truth Social 帖、《华尔街日报》转述(10-04);《纽约时报》报道(10-02)。
工具与产品:都在压低门槛,也都在等核实
一个 MIT 许可的开源项目 Strata,让 125B 的 Qwen3.8-Flash-Next 跑到消费级显卡上——项目自述 12GB 以上显存即可,RTX 4090 上约 100 token/s。这些数字目前只有项目自述,没有第三方实测,想用就自己先测一遍。
据第三方报道,自 10 月 9 日起,Gemini Web 与 App 的免费个人用户不再默认提供完整的 Flash 以及 Pro 访问,统一调整为更轻量的 Flash-Lite。目前没有 Google 官方的公告,消息来自第三方转述,「AI Plus 也失去 Pro」这个细节未经确认。
还有一条只有转述来源:GitHarness 把每条需求与对应工作像 Git 提交一样存,用户改需求时从最近有效版本分支、只重做变更部分。作者称在全部 30 个测试设置中优于「简单续跑」,其中一个编码设置的 token 用量少 73.6%。这条目前无论文原文可核,数字请按转述口径看。
三条的共同点是把「能不能跑、怎么跑、花多少」的门槛往下压,但数字分别来自项目自述、第三方转述和 X 转述——都还等第三方实测。
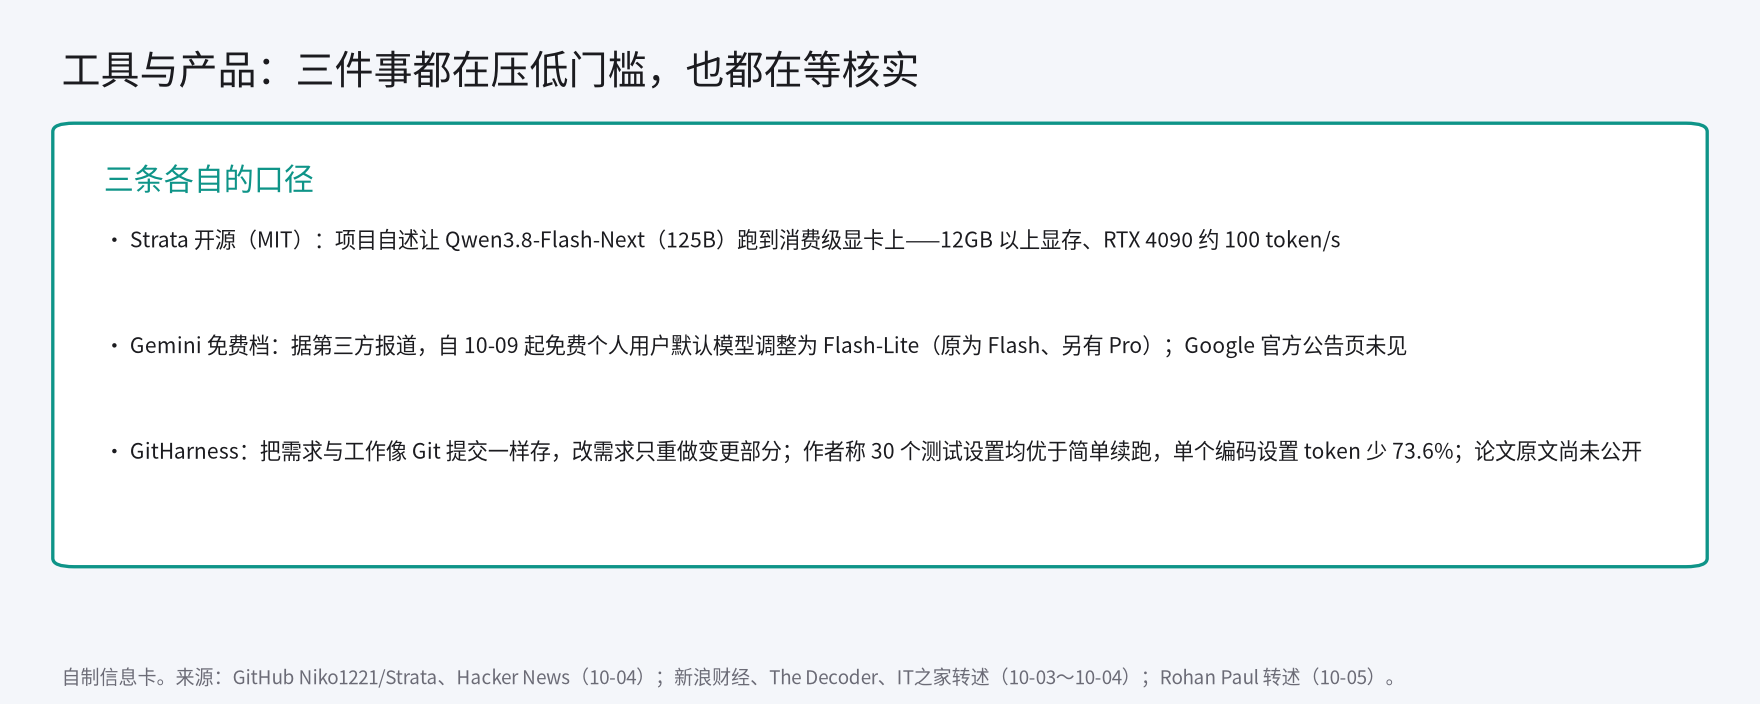
图 4:Strata、Gemini 免费档与 GitHarness 三条的口径。自制信息卡。来源:GitHub Niko1221/Strata、Hacker News(10-04);新浪财经、The Decoder、IT之家转述(10-03~10-04);Rohan Paul 转述(10-05)。
速览:另外八条
- 马斯克称 Grok 4.7 在 Artificial Analysis Cyber Index 登顶,该榜的评测方尚未确认这一说法。来源:马斯克 X(10-05)
- 马斯克确认 SpaceXAI 将更名为 SpaceXSI,延续「SI」这条改名线。来源:IT之家(10-04)
- 微软为 20 多个数据中心项目引入「仿生」计划,恢复原湿地生态、种植本土植物。来源:IT之家(10-04)
- 人形机器人笼斗赛被加州监管叫停,州立体育委员会已发出停止令。来源:IT之家(10-04)
- 新泽西副州长称把调查报告喂给多个 AI 平台、共 59 次询问,无一家认定存在性骚扰。来源:The Verge(10-05)
- 乐山大佛管委会辟谣「掏耳朵」视频,称系 AI 生成的不实信息。来源:IT之家(10-04)
- 一项研究结论:个人智能体的记忆笔记超过一定限度反而让智能体违反规则,计数追踪类需求应改用代码。来源:经 Rohan Paul 转述(10-05)
- 星际争霸赛事后续:GPT-6 Astra 与 Claude Opus 5.5 表现相当,但都打不过人类做的机器人。来源:The Verge(10-04)
积木观察
把今天这几条放在一起看,智能体的状态管理正在从「靠模型隐式记忆」变成显式机制:CLM 把上下文当文件,GitHarness 把需求当提交,连速览里那条研究都在说记忆不是越多越好。
如果你在做长时程 agent,建议先读 CLM 的对照条件,再决定要不要把手写的压缩逻辑换成「让模型自己管」;也可以先拿它那两个指标——准确率与 FLOPs——量一遍自己现在的方案。
结尾互动
你的智能体现在是自己写压缩策略,还是已经交给模型管了?评论区聊聊。
来源链接
官方来源
- 论文《Context Language Models》:https://arxiv.org/abs/2609.37725 | 代码:https://github.com/facebookresearch/context-language-models
- Strata:https://github.com/Niko1221/Strata
- 特朗普 Truth Social 帖(经 TechCrunch 转引):https://techcrunch.com/2026/10/04/trump-unveils-his-new-super-intelligence-force/
独立来源
- SIF 人事:《华尔街日报》转述(10-04)
- Anthropic 宗教咨询:《纽约时报》(10-02),经 IT之家、The Decoder 等转述
- Gemini 免费档调整:新浪财经、The Decoder、IT之家转述(10-03~10-04),尚无官方公告
- GitHarness:经 Rohan Paul 转述(10-05;论文原文尚未公开)