AI 日报 | 10-06:文本水印来了,官方把它的失效条件也一起写了
 文本水印从论文话题变成了合规现实,而且这次官方把检出率的上限一起公布了。
OpenAI 为符合欧盟 AI 法案分阶段引入隐形文本水印 textGrain:全球 API 客户即日起可自愿开启,EU 的 ChatGPT 与 Codex 在数周内生效。同一批消息里,它还在图像生成场景试起了视觉广告,并把两个模型的默认速度提了上来。
头条 | textGrain:不加可见标记,也不识别作者
机制上,它在模型选词时嵌入不可见的统计信号,检测器据此判断文本是否可能由 OpenAI 模型生成。官方明确:不加可见标记,也不识别作者、组织、账号或对话来源。技术报告已经放出,官方还计划把这项技术开源。
落地分三步:即日起全球 API 客户可对部分模型自愿开启,API 中默认关闭;未来数周为 EU 境内的 ChatGPT 与 Codex(所有档位)加水印,不做全球默认;检测器只向获批研究者与专家机构开放申请。
对照看,Anthropic 对 Claude 采用全球强制水印,OpenAI 走的是区域化加 API 自愿这条路线。
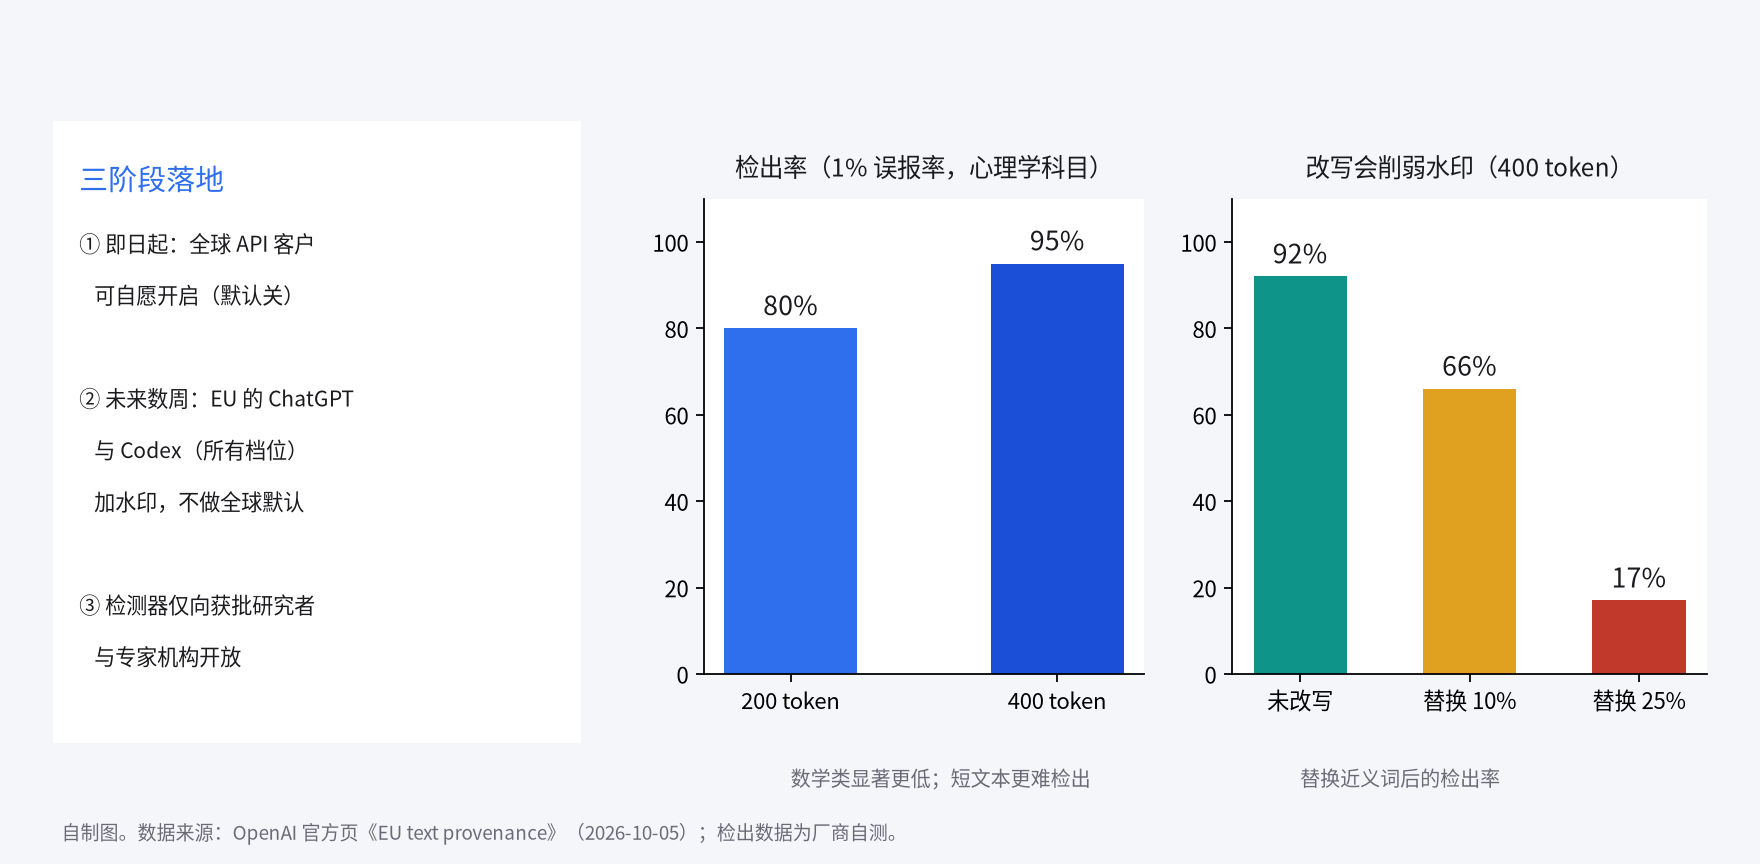
图 1:textGrain 的三阶段落地、检出率与改写后的衰减。自制图。来源:OpenAI 官方页《EU text provenance》(2026-10-05),检出数据为厂商自测。
水印真正的边界写在官方自己的免责里:短文本与受约束文本更难检出;在 1% 目标误报率下,约 200 token 的心理学科目文本检出率约 80%、400 token 约 95%,数学类显著更低。改写会削弱它——400 token 文本替换 10% 近义词后从约 92% 掉到 66%,替换 25% 后只剩 17%。
官方还给了一张 8 项能力指标的对照表,结论是加水印前后未见有意义差异。要看清它的性质:那是同一个模型加与不加的对照,不是模型之间的能力榜。
| 基准 | 无水印 | 有水印 |
|---|---|---|
| AA Intelligence Index | 49.57 | 49.76 |
| AutomationBench | 34.09% | 34.86% |
| DeepSWE v1.1 | 72.80% | 71.68% |
| Terminal-Bench 4.0 | 53.90% | 56.06% |
| Terminal-Bench Science 0.1 | 56.90% | 60.00% |
| BrowseComp | 87.92% | 87.35% |
| HealthBench Professional | 64.27% | 64.60% |
| GPQA Diamond | 94.44% | 93.94% |
图像里开始出现广告,先在美国小范围试
OpenAI 推出新的视觉广告格式,初期只在 ChatGPT 的图像生成过程中测试:广告明确标注,与生成的图像分开,官方称不影响 ChatGPT 给出的答案。测试本月晚些时候在美国启动,先面向一小批广告主。
规模口径来自官方:ChatGPT 每周触达 12 亿人。测量侧接入了一批归因与测量伙伴,广告定价没有披露。
三条早期效果数据——WeightWatchers 的归因 CPA 比其付费搜索混合基准低 15.3%、健康品牌 Dose 的增量购买 67% 来自新客、Portland Leather 的访客 93% 是新访客——都是合作方口径,不是第三方独立测评。
对象也要分清:这跟 2026 年 1 月那版「回答底部的文字广告」不是一回事,这次是图像生成场景里的视觉广告格式。
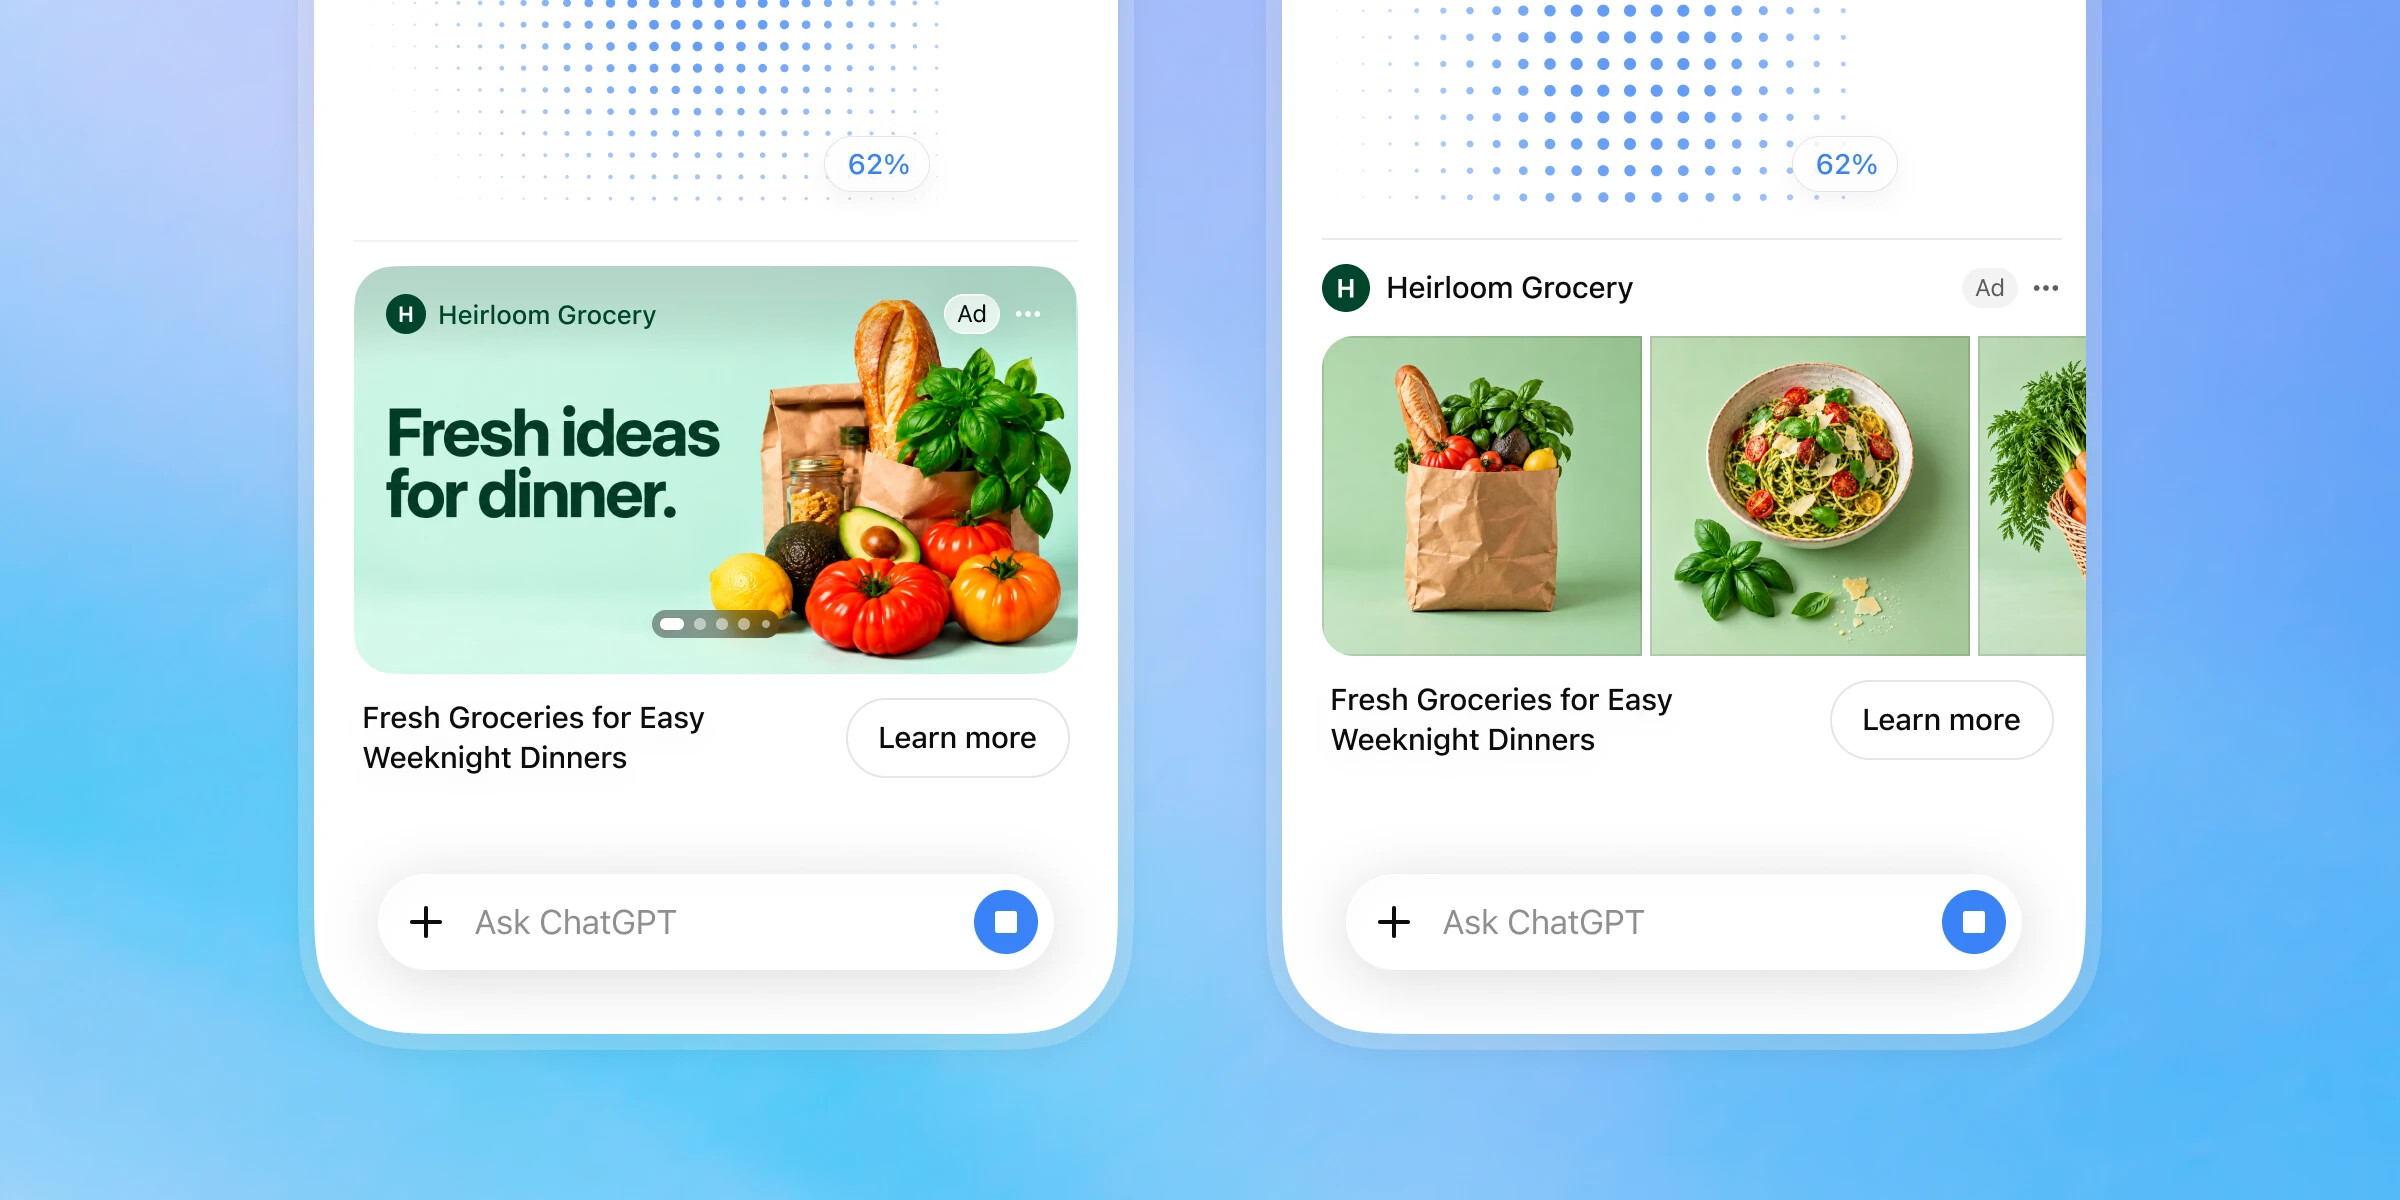
图 2:ChatGPT 视觉广告格式的产品示意,广告带「Ad」标注。来源:OpenAI 官方页配图。
记忆正在被当成文件管,第三家也这么做了
Cognition 为 Devin 推出 Dreaming:跨会话构建记忆图、记录工作偏好,并在夜间做自我改进——清除过期记录、发现潜在信息。同时开源 Agent Memory Repo:记忆记录存放在文件里,用 Git 做版本管理。官方称这是「简单的原语」,但解锁了跨智能体会话的消息板这类用法。
这不是孤例。前一天的头条 CLM 把上下文当成一个文件让模型自己改,更早的 GitHarness 把需求与工作像 Git 提交一样存。三家独立做法趋同,说的是同一件事:把智能体的状态管理做成显式、可版本化的文件,而不是隐式记忆。
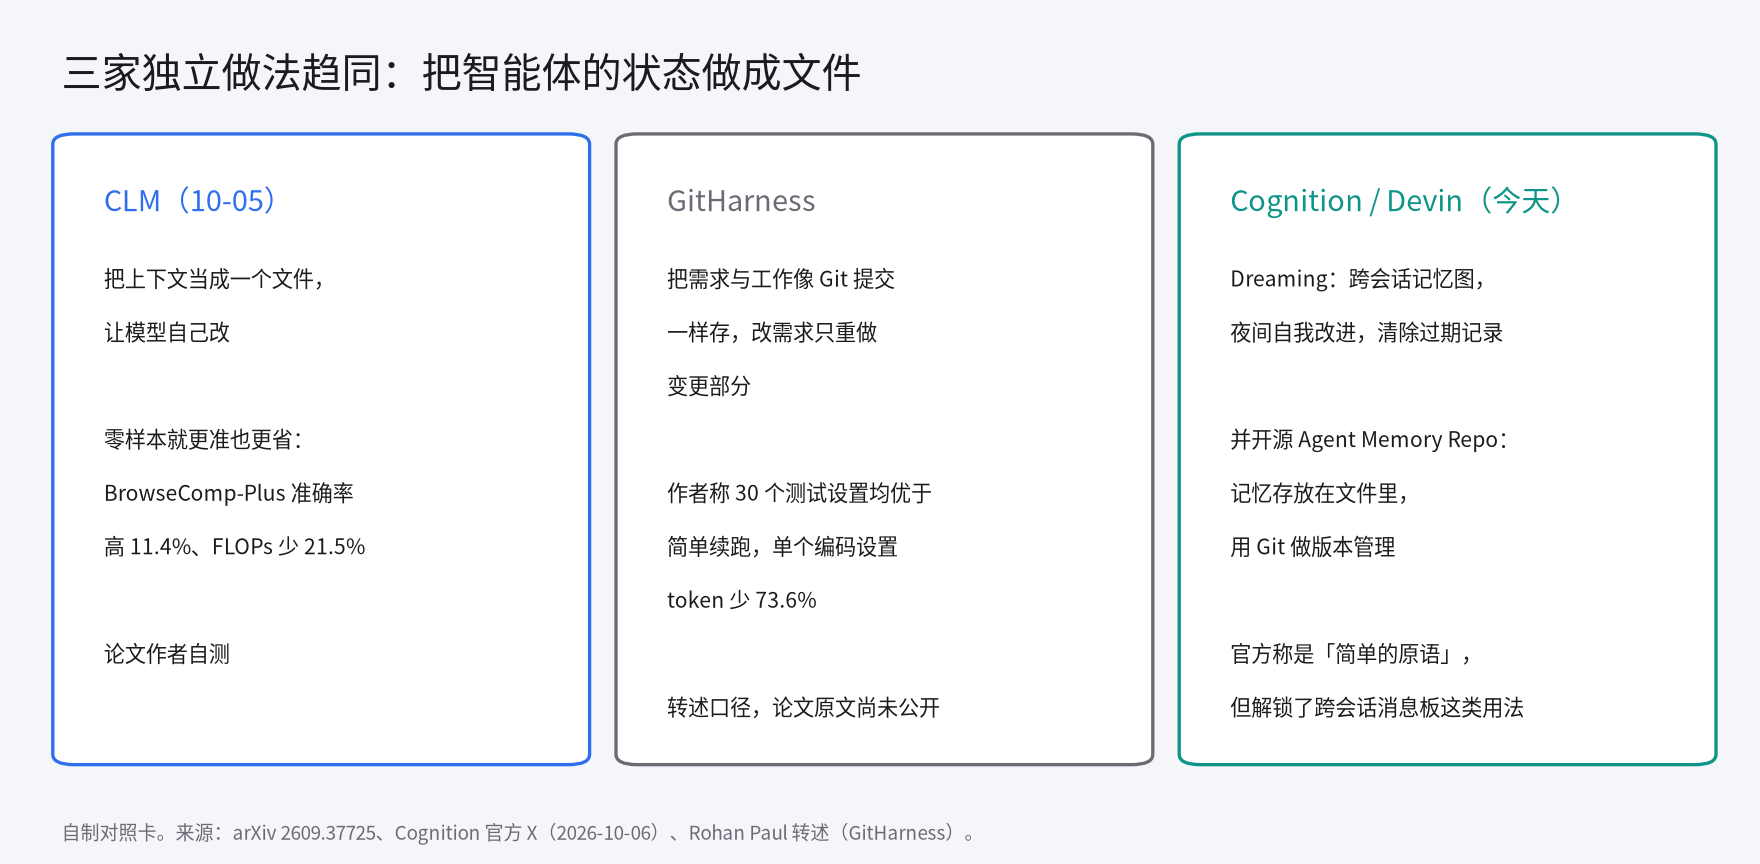
图 3:三家把状态做成文件的对照。自制对照卡。来源:arXiv 2609.37725、Cognition 官方 X(2026-10-06);GitHarness 为转述口径。
另外三条:一个研究预览、一次提速、一个监管首例
Reka 发布 190 亿参数的模型 Rho-1 研究预览版,在单一网络内处理文本、图像、视频与机器人动作。它是研究预览版:除参数量与模态外,没有公开规格,也没有基准分和价格。
OpenAI 把 GPT-6 Astra 与 GPT-6.1 Sol 的默认速度提升了约 50%(50 TPS,此前为 30 TPS),覆盖其全部产品以及通过 Sign in With ChatGPT 接入的合作伙伴。这是厂商口径,没有第三方复核。
还有一条只有转述来源:Nolla Health 据称成为美国首个获准由 AI 开出初始处方的机构,范围限犹他州成人的轻中度痤疮;处方转给持证药剂师,医生在早期逐例审核。目前没有官方文件可核。
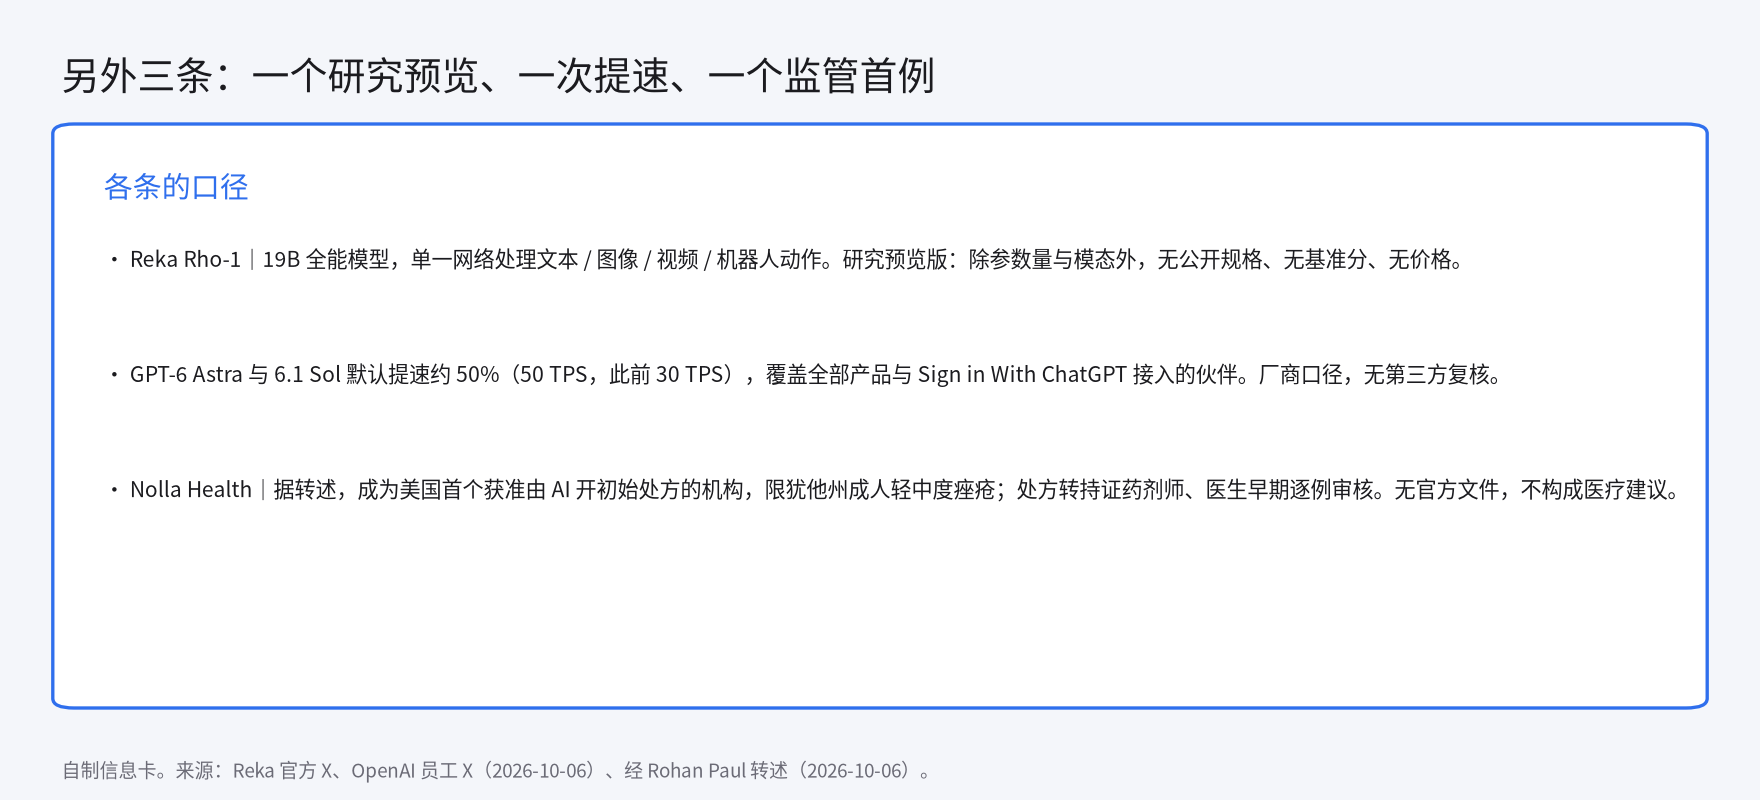
图 4:Rho-1、默认提速与 Nolla Health 三条的口径。自制信息卡。来源:Reka 官方 X、OpenAI 员工 X、经 Rohan Paul 转述(2026-10-06)。
速览:另外六条
- TikTok 推出 AI 购物助手与一键结账,可在信息流里直接向品牌购买。来源:TechCrunch(10-06)
- 华为与高通达成 5G 等专利交叉许可协议。来源:IT之家(10-06)
- 施耐德电气以 226 亿美元全现金收购 PTC。来源:IT之家(10-05)
- Anthropic 的人工审查员将用户威胁对话上报警方,该女子随后被捕。来源:经 Rohan Paul 转述(10-06)
- Suno 上线专辑功能,可设封面、编排曲目并发布。来源:Suno 官方(10-06)
- computer use 被视为智能体的下一个主战场:大量软件没有可用 API,GUI 是通用接口。来源:Yuchen Jin X(10-06)
积木观察
今天的主线可以合成一句话:输出侧在加可追溯性(水印)、加变现方式(广告)、降延迟成本(提速),状态侧在把记忆做成文件与版本。
两个可执行的判断。如果你的产品面向 EU 用户、或经 API 输出文本,先确认水印的开启状态与检测接口的申请条件,别等它默认生效才发现。如果你在做 agent,Agent Memory Repo 是开源的,可以直接照着它的「文件加版本」这套原语,评估要不要替换现在的隐式记忆。
结尾互动
你更在意输出被追溯,还是更在意它不被误判?评论区聊聊。
来源链接
官方来源
- OpenAI 欧盟文本溯源:https://openai.com/index/eu-text-provenance/ (2026-10-05)
- OpenAI 视觉广告:https://openai.com/index/new-chatgpt-ads-format-and-measurement/ (2026-10-05)| 1 月那版广告方案:https://openai.com/index/our-approach-to-advertising-and-expanding-access/ (2026-01-16)
- Cognition:https://cognition.com/agent-memory-repo | https://devin.ai/blog/memory-and-dreaming
- Reka labs:https://reka.ai/labs
独立来源
- 与 Anthropic 强制水印的对照:The Decoder
- Rho-1 的第三方报道:The Decoder
- 默认提速:OpenAI 员工 X(Tibo),无第三方复核
- Nolla Health:经 Rohan Paul 转述,无官方文件