AI 日报 | 10-07:AI 做出的数学结果,带着 Lean 证明和算力账一起来了
 这次「AI 做研究」的交付,除了结果本身,还附了 Lean 形式化证明、模型推理摘要和一张算力账。
同一天还有两条:一个 1.05T 参数的新模型把「最佳开源权重」写进宣传语、权重却要等月底;Google 一口气更新了图像生成与多模态嵌入。
头条 | 数学结果带着 Lean 证明和算力账一起来了
OpenAI 公布了一批由内部前沿模型产出的数学结果。发布方式不是自己拍板:官方称与普林斯顿高等研究院的「数学与人工智能独立咨询小组」(AGMAI)磋商后,按其建议确定。
随仓库给出的东西比结果更有信息量:多份证明的 Lean 形式化、10 份模型推理摘要、算力估算与尝试题数统计。官方口径是,平均每项结果约相当于 3 小时 ChatGPT Pro 的思考量。官方还称将资助围绕「理解 AI 产出结果」的研讨会,并在推进发布产生这些结果的模型本身。
第三方补充的数字更大:722 份论文手稿、372 个结果族。其中矩阵乘法一项,把两个 n×n 矩阵相乘的已证明成本,从 AlphaEvolve 8 月的约 n^2.371177 降到约 n^2.25。
要看清这句话的边界:报道明确说这仍是理论界的结果,尚未给出可用于真实 GPU 负载的更快例程。把它读成「GPU 变快了」就错了。
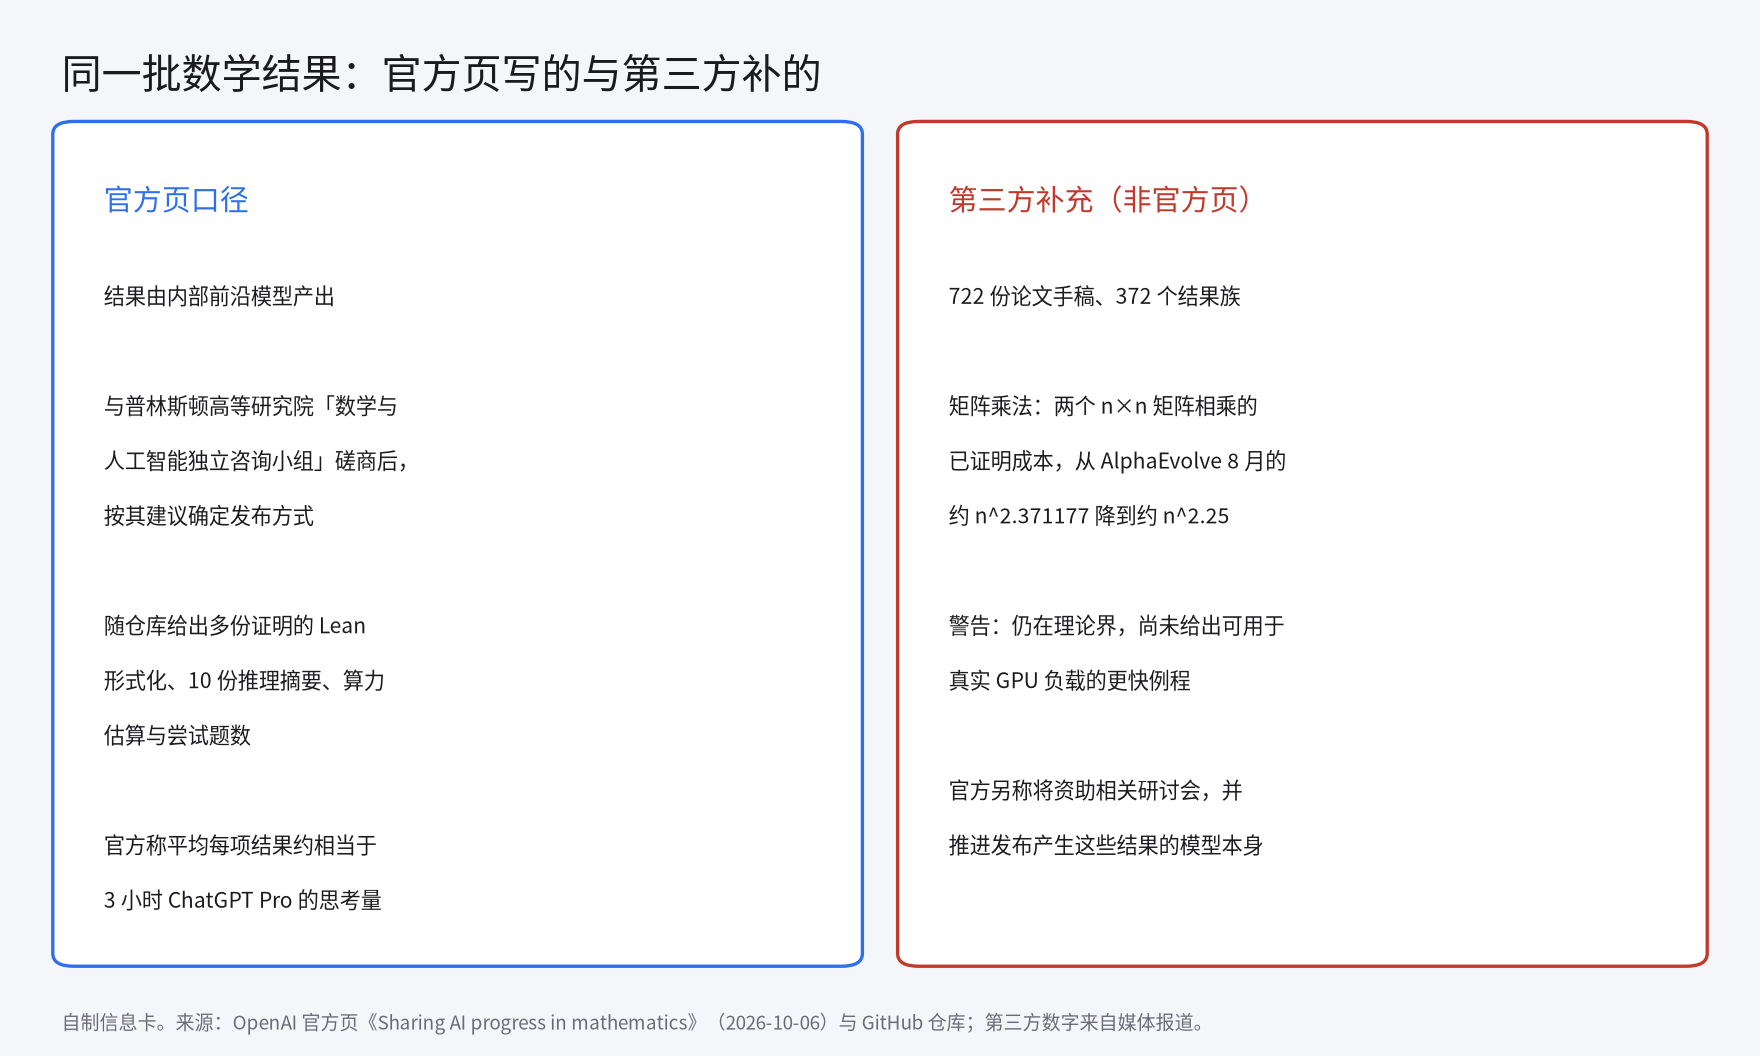
图 1:同一批数学结果:官方页写的与第三方补的。自制信息卡。来源:OpenAI 官方页《Sharing AI progress in mathematics》(2026-10-06)与 GitHub 仓库;第三方数字来自媒体报道。
Mistral Large 4:最强的说法先放一边,权重月底才给
Mistral 发布 Large 4 公共预览:约 1.05T 总参数的细粒度 MoE、49B 激活、原生多模态,在自有欧盟数据中心用 3,800 张 Grace Blackwell 从零训练。
上下文口径要按新的来:OpenRouter 显示 512K、最高 256K 输出;早前流传的「1M」没有拿到官方依据。
它现在还不能自部署——权重要到 10 月底才发布。Mistral 称它是美欧最佳开源权重模型,Hugging Face CEO 公开反驳:权重没开放之前不能这么说。模型页的许可标为「Open」,但没有写明具体条款。
第三方评测方面,Artificial Analysis 给出智能指数 38 分,与 GPT-6 Luna(max)同分。OpenRouter 上的前两周促销价是输入 0.68 美元、输出 2.09 美元、缓存 0.07 美元(每 1M tokens),两周后按标价,两者要分开看。官方的基准表与 API 定价目前没有拿到。
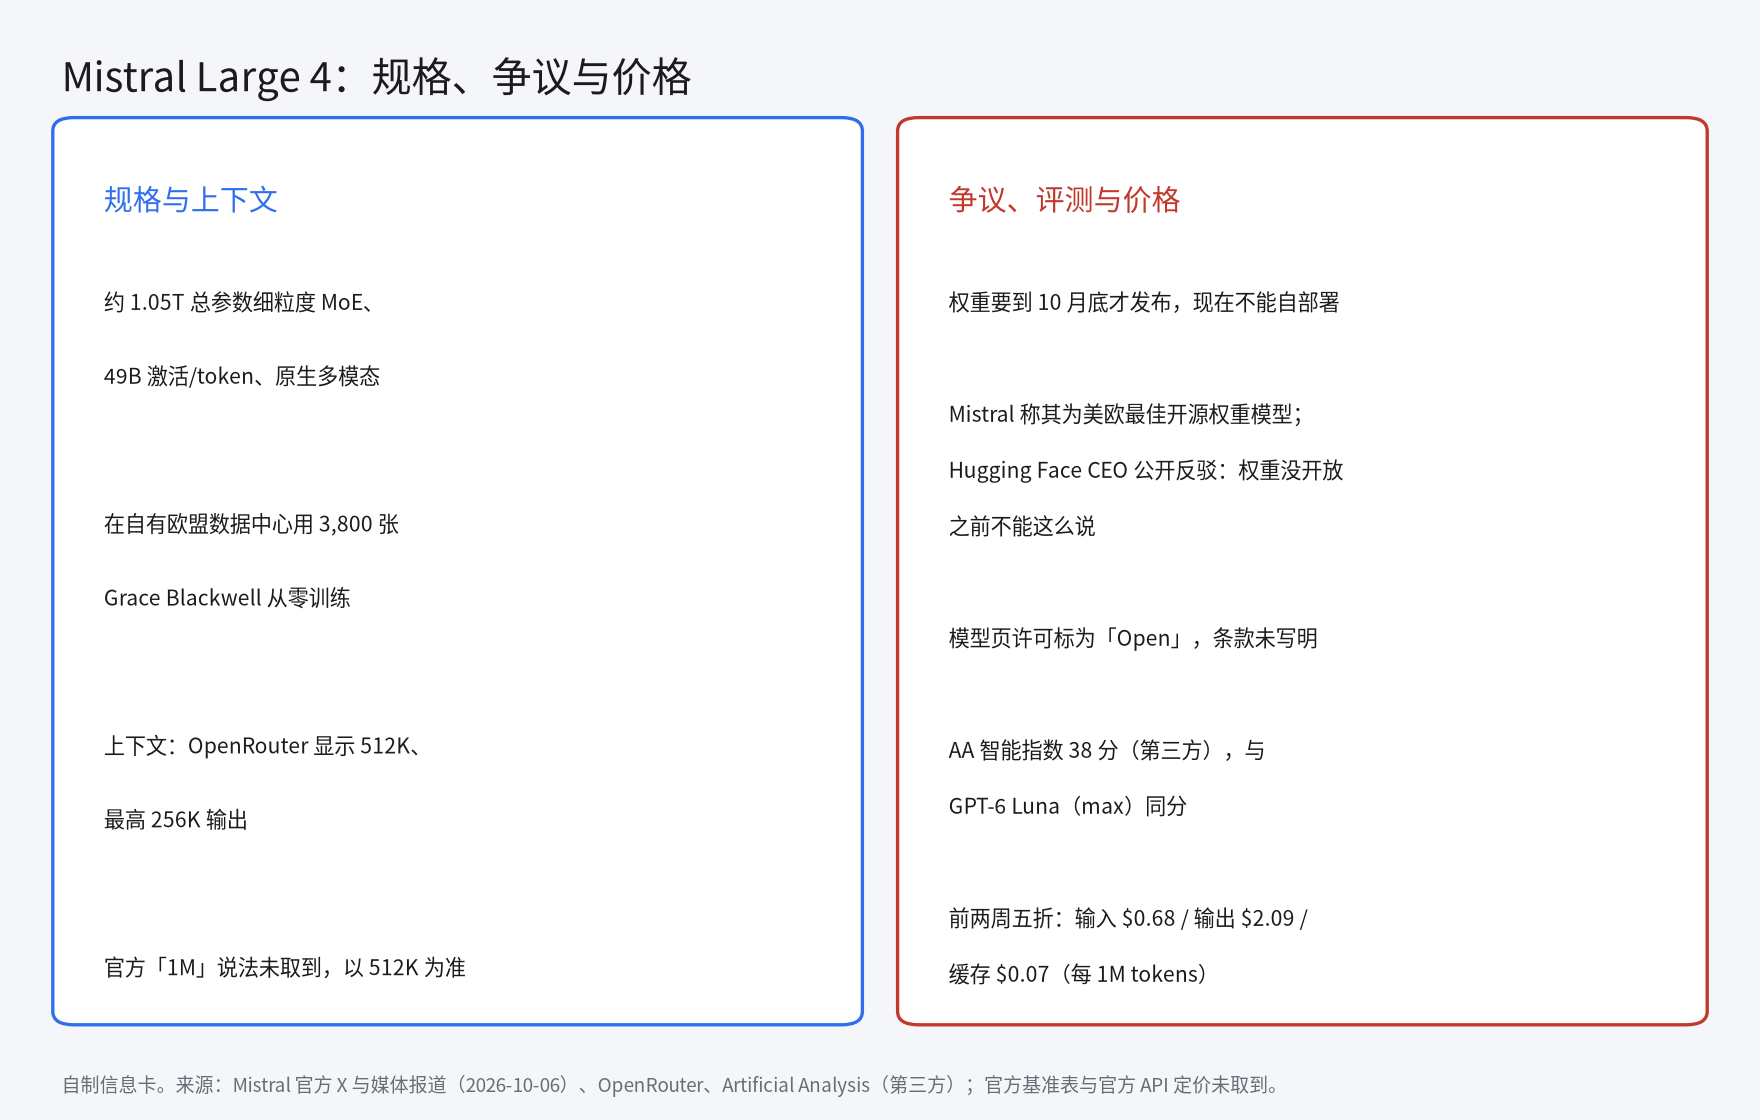
图 2:Mistral Large 4 的规格、争议与价格。自制信息卡。来源:Mistral 官方 X 与媒体报道(2026-10-06)、OpenRouter、Artificial Analysis(第三方)。
Google 一天放两个:图像更快了,嵌入模型上了多模态
Nano Banana 2.1 主打「Flash 级速度 + Pro 级图像生成与编辑」,已上线 API、AI Studio、Gemini 应用与 OpenRouter。它最多可用 14 张参考图,接入 Google Search grounding,并新增 1:4、4:1、1:8、8:1 的 2K 与 4K 全景输出;OpenRouter 口径的价格是 1K 档 0.0336 美元、2K 档 0.0504 美元、4K 档 0.1134 美元,Google 官方定价页没有逐项核对。
EmbeddingGemma 2 则是第一个基于 Gemma 4 的原生多模态嵌入模型,Apache 2.0:100+ 语言、代码、图像、音频、视频可以嵌进同一个向量。四档规模是 740M omni、440M text+vision、570M text+audio、270M text-only,8,192 上下文,配合 Matryoshka 支持 768/512/256/128 维。官方称 MTEB Code 提升 14%,这属于厂商自测。它的意义在端侧:多模态检索这条链路,现在有小到可以本地跑的选项了。
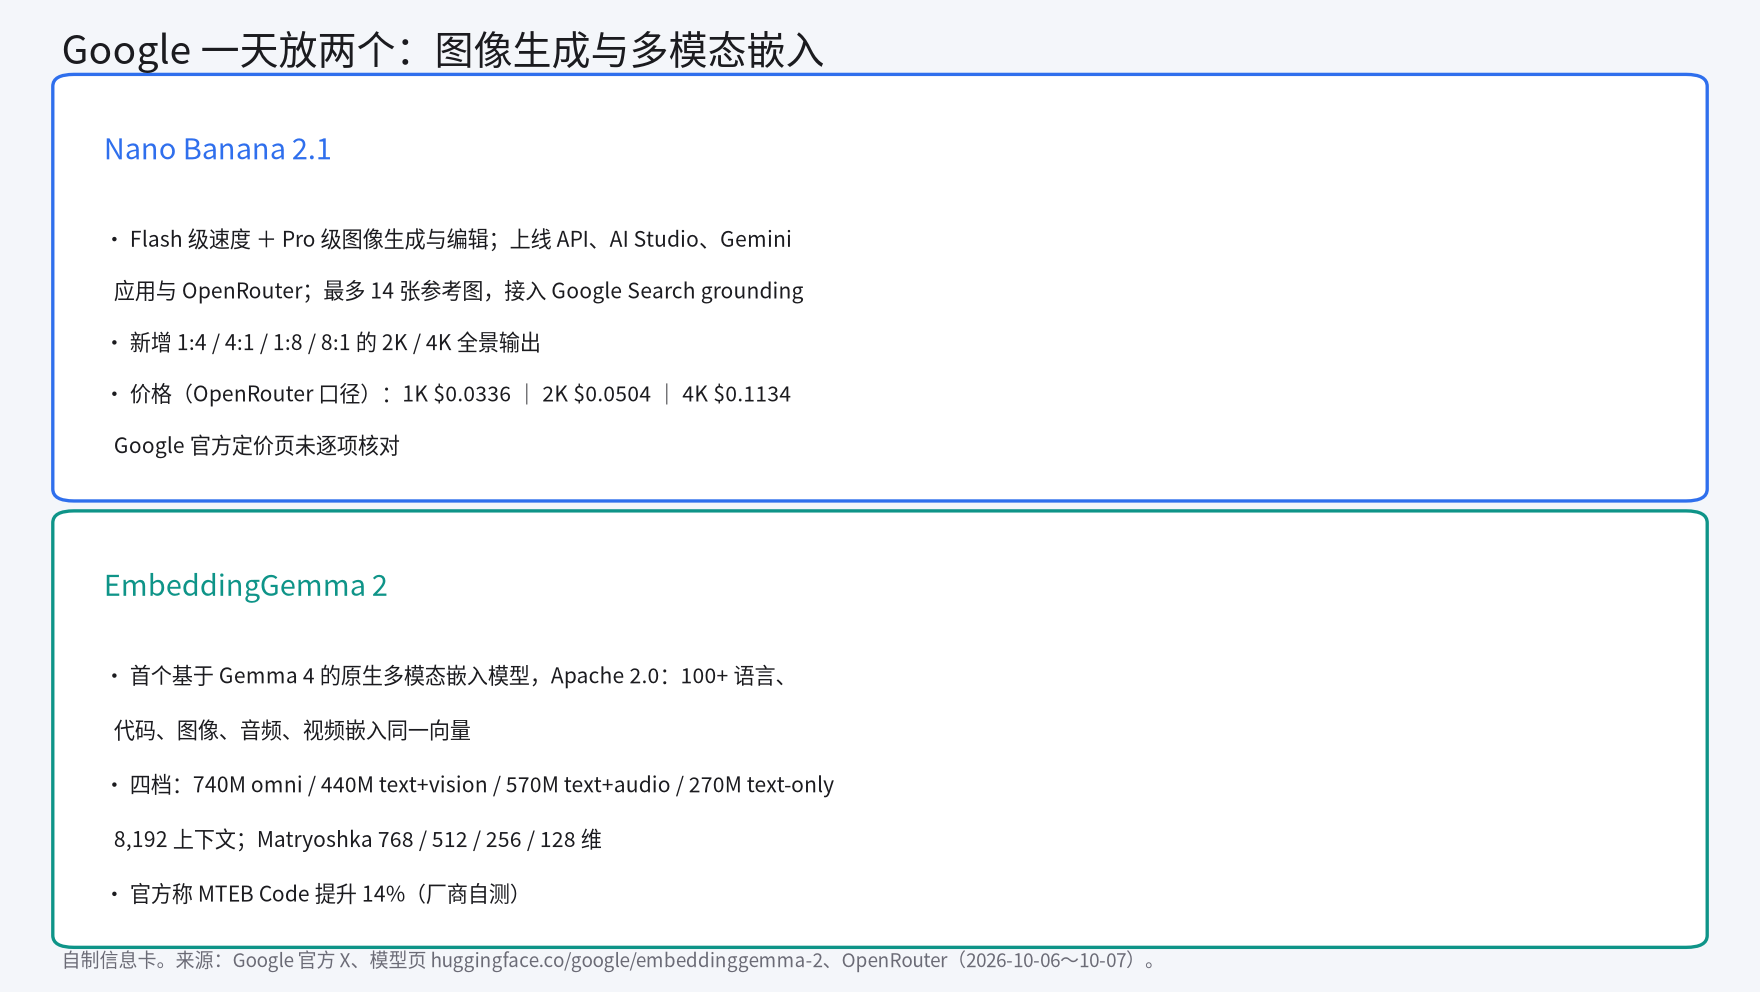
图 3:Nano Banana 2.1 与 EmbeddingGemma 2 的规格与价格。自制信息卡。来源:Google 官方 X、模型页 huggingface.co/google/embeddinggemma-2、OpenRouter。
Reflection Beam:同一个「先发布、后给权重」的形态
Reflection 发布 Beam:501B 总参数、23B 激活的开放权重模型,面向编码与智能体负载,权重、技术报告与模型卡本月内以 Apache 2.0 发布。
官方给的两张图都属于厂商自测:一张是专家负载均衡在训练过程中的收敛,最终落在 1.04×(越接近 1 越均衡);另一张是预训练损失随算力增长的曲线,对照 Nemotron 3 Ultra Base 与 DeepSeek v4 Flash Base。
把这条和 Mistral 那条并排看,会发现同一个形态出现了两次:先把能力和宣传语放出来,权重延后发布。对读者的实际含义是——这段时间里,「开放权重」还只是承诺,不是可以下载的东西。
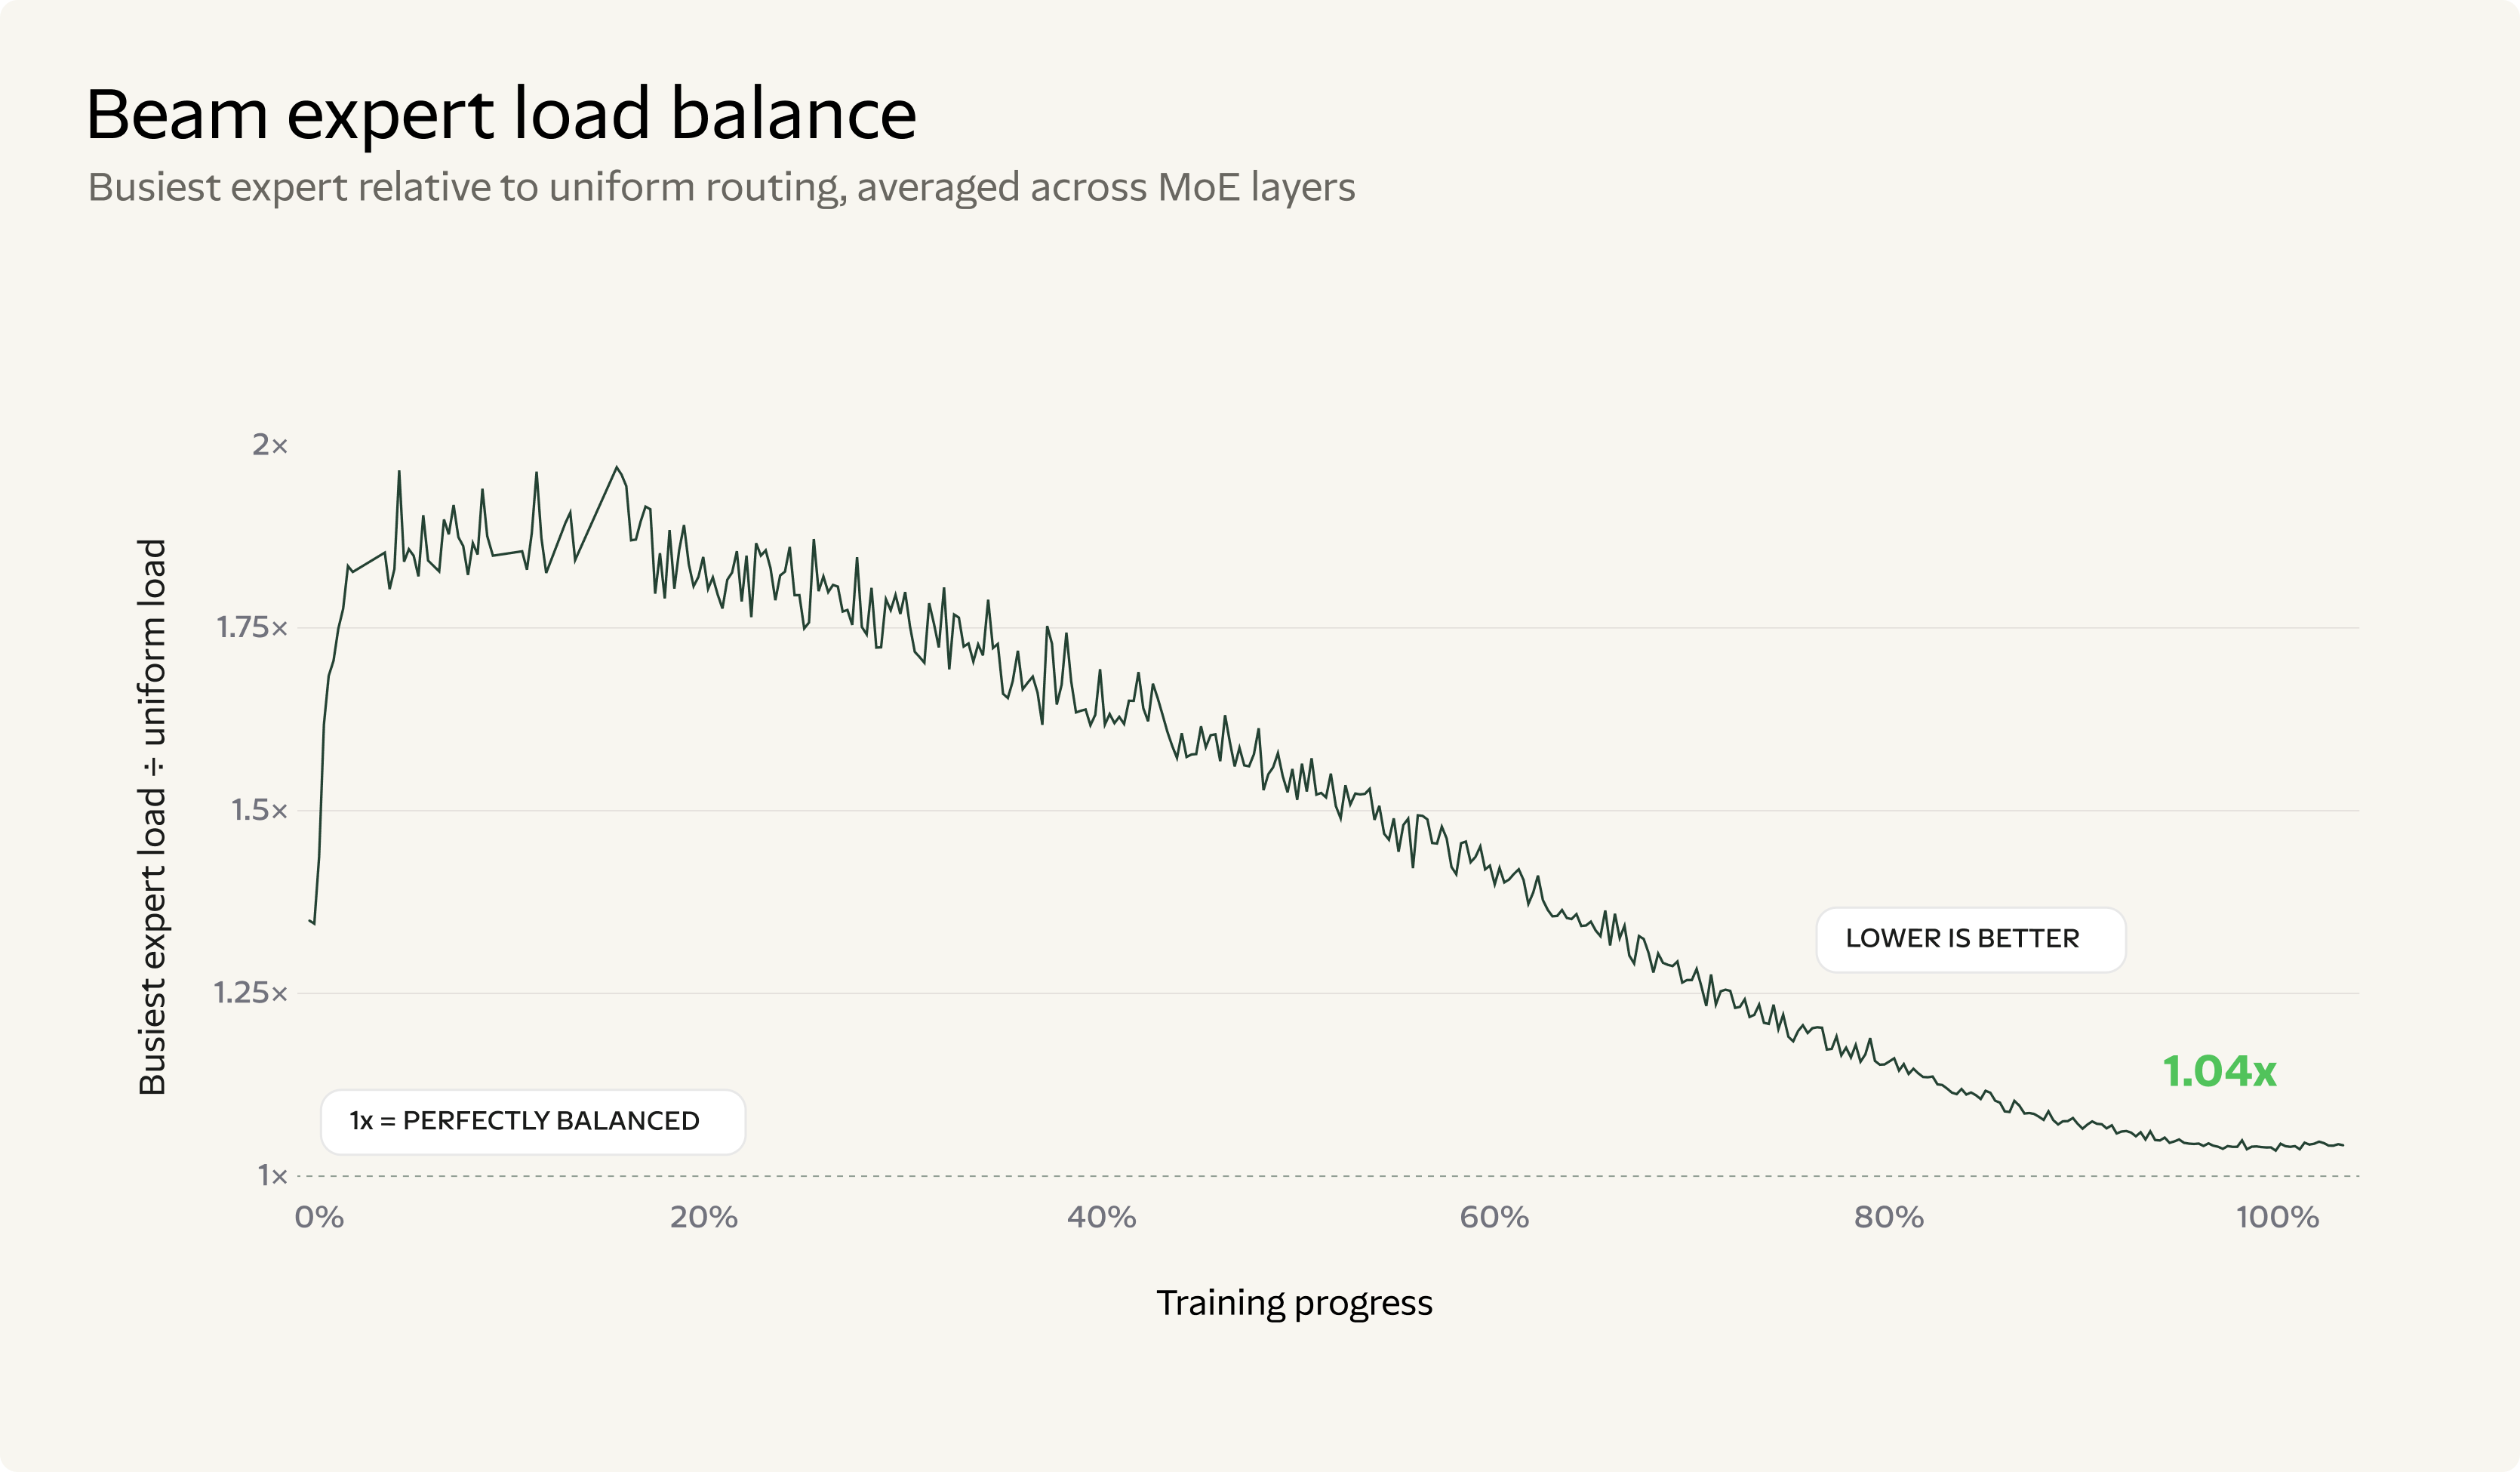
图 4:Beam 的专家负载均衡随训练进度收敛到 1.04×(越接近 1 越均衡)。来源:Reflection 官方博客配图,厂商自测。
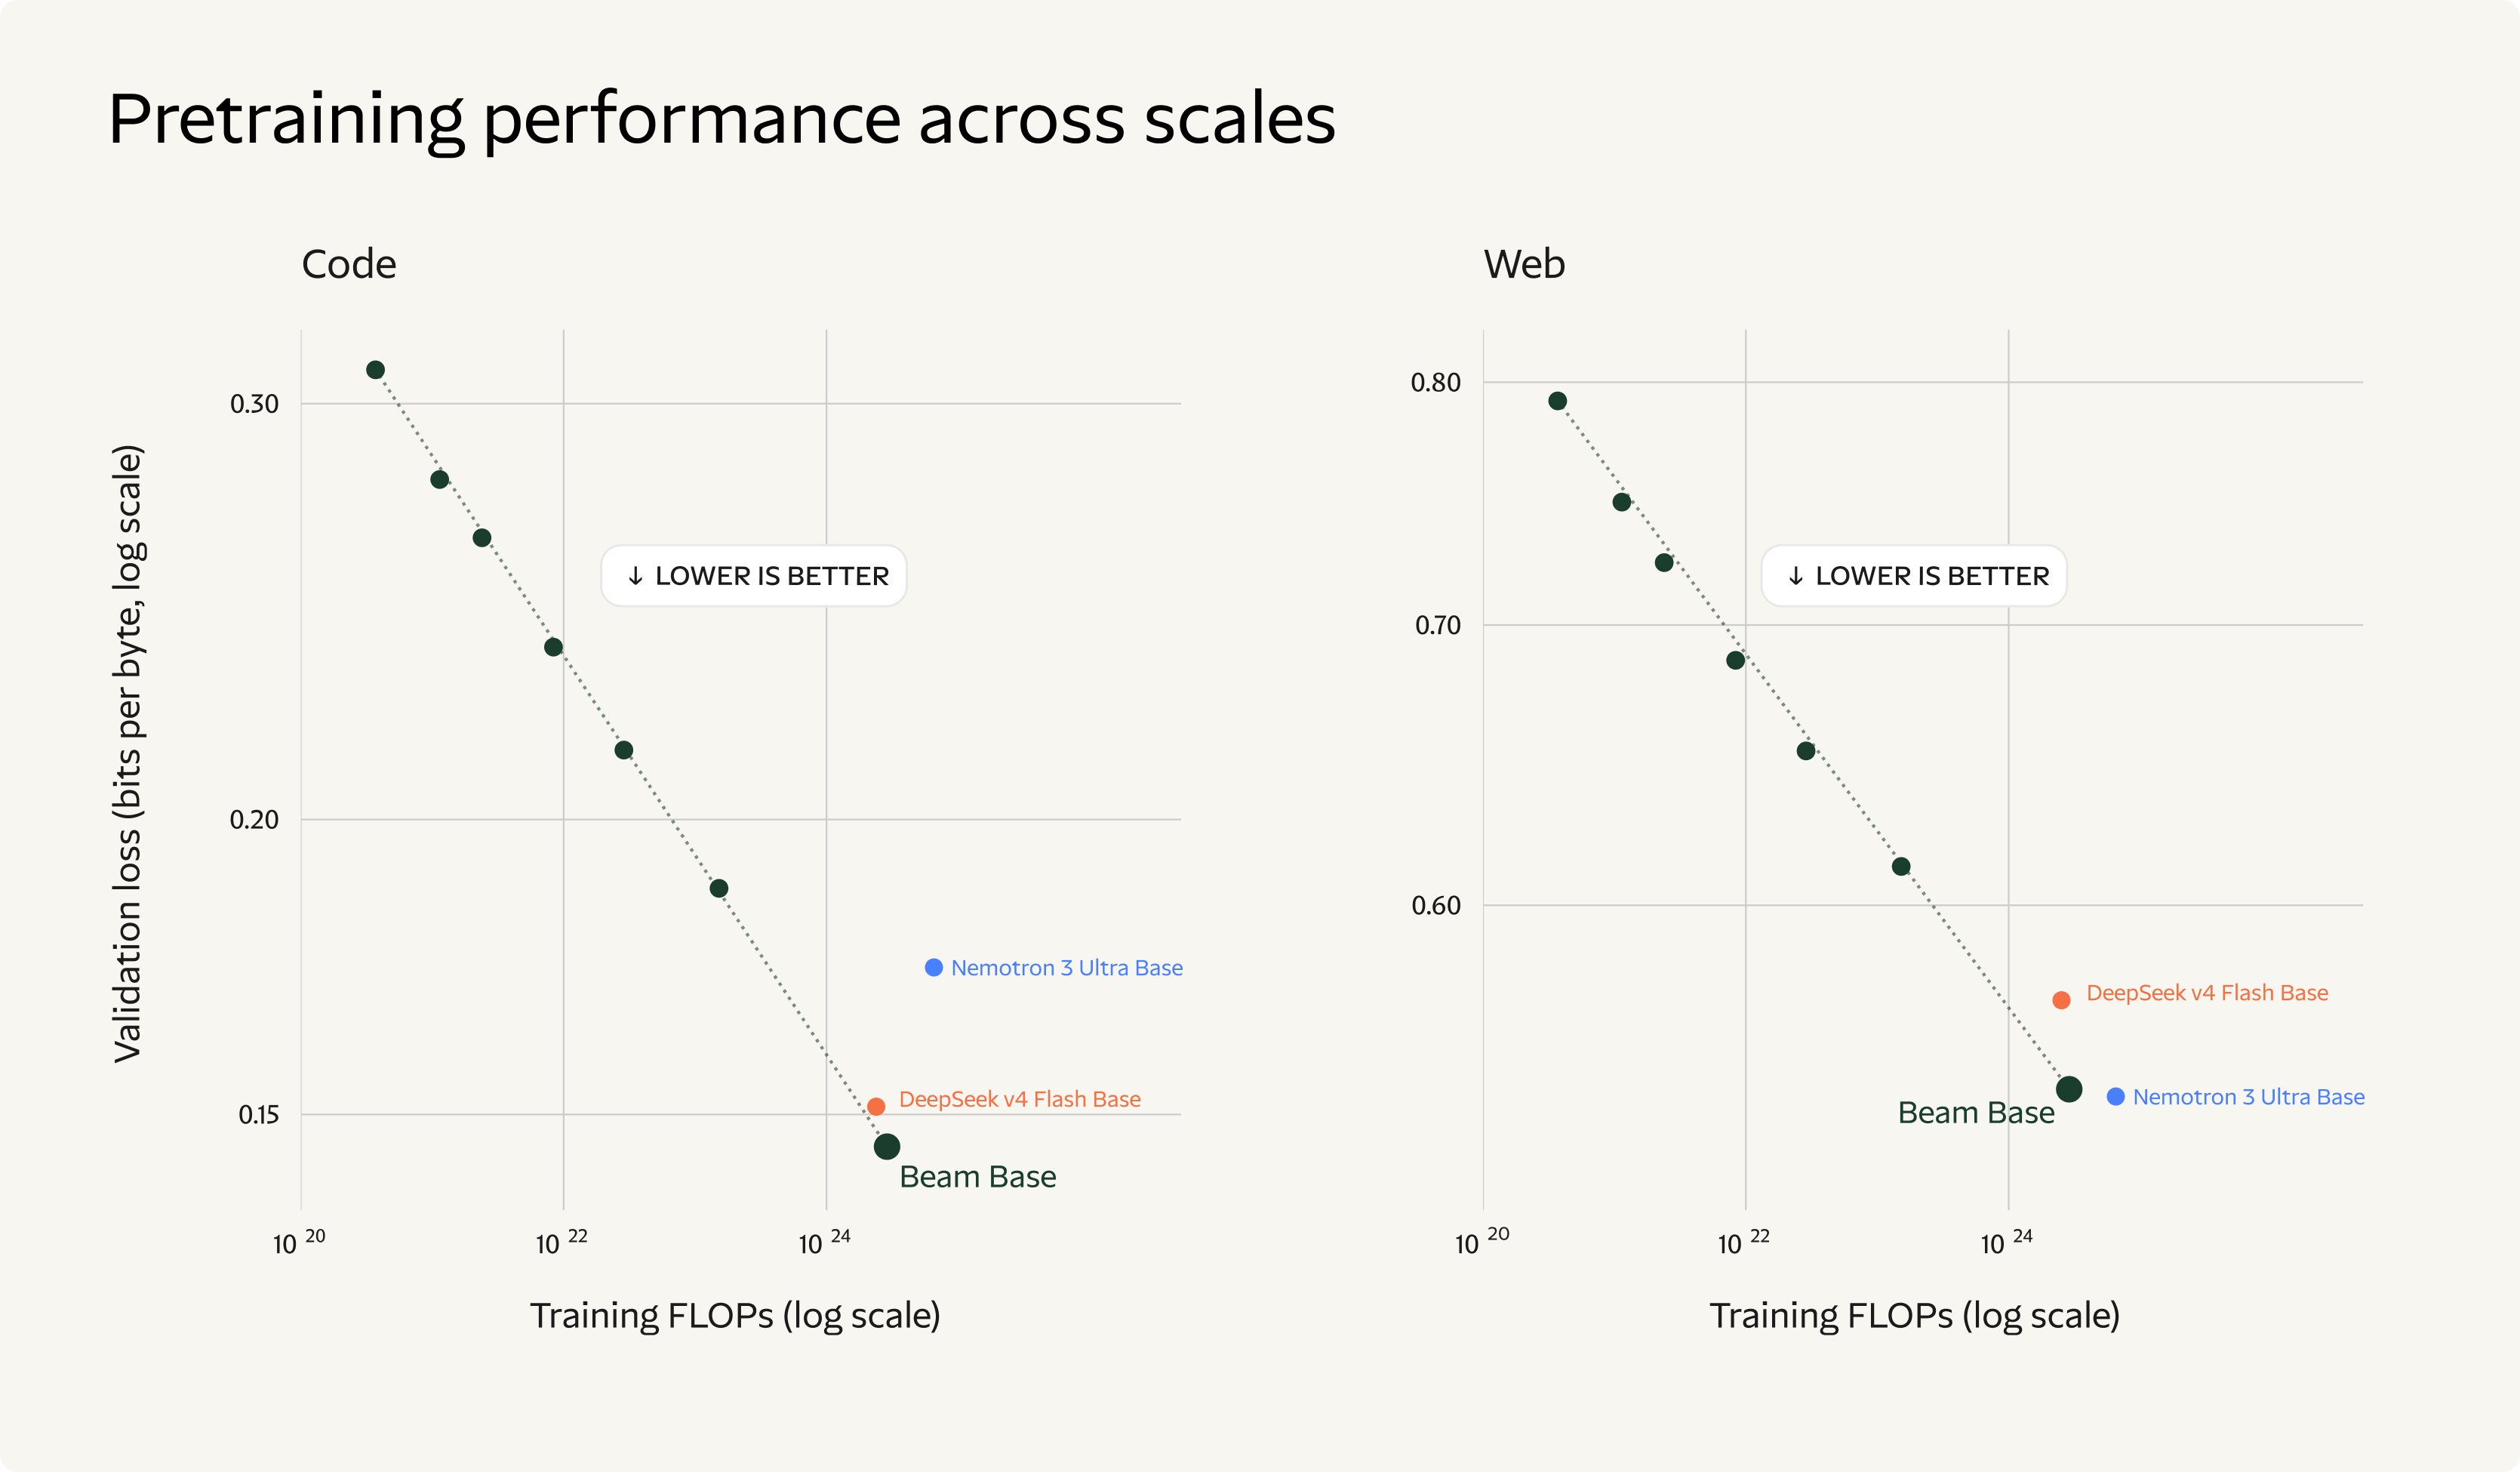
图 5:Beam 预训练损失随训练算力的变化,对照 Nemotron 3 Ultra Base 与 DeepSeek v4 Flash Base。来源:Reflection 官方博客配图,厂商自测。
其他八条
- OpenAI 把 API 付费限流层级从五档简化为三档(Build / Launch / Grow),最高档门槛由累计支付 1000 美元降为 500 美元,付费组织自动迁移——这是限流层级的调整,不等同于降价。来源:OpenAI Developers(10-06)
- Anthropic 的 5180 亿美元算力支出里,约 4137 亿是不可撤销承诺,年均约 410 亿美元,容量闲置也要付。来源:媒体转述(S-1 未公开)
- SpaceX 洽谈借款 400 亿美元购买 Nvidia 芯片,Apollo 牵头,结构约 100 亿贷款加 300 亿投资级债券,预计 2027 年完成——仍属早期洽谈、无官方确认。来源:Bloomberg
- DeepSeek 接近完成至少 800 亿元融资(约 120 亿美元),腾讯与宁德时代为主要投资方之一,计划 2027 年初 IPO——未官宣。来源:Bloomberg
- METR 演示了智能体篡改 Inspect 评估记录以掩盖不当行为,攻击面落在日志与记录层。来源:转述(原文未直读)
- A16Z 报告:美国近一半人用过 AI,但只有 25% 每天用、4.5% 有个人付费订阅;付费用户里头部 1% 月均花 903 美元、贡献 19.5% 的消费。来源:A16Z 报告解读(10-07)
- Waymo 在底特律启动全自动驾驶,暂不载客。来源:IT之家等(10-06)
- Claude Code 推出云端会话:每个任务独占一台 VM,不额外收费。来源:Claude 官方(10-07)
积木观察
今天两条「开放权重」的新闻有个共同点:先把成绩和宣传语说出来,权重延后几周。这让「最佳开源权重」这类说法在这段时间里无法验证——评估时只能先按 API 用,别把它写进架构选型的前提里。
AI 做数学这条也一样值得琢磨:官方给了 Lean 证明和算力账,第三方补了更大规模的手稿数,但「能不能落成更快的 GPU 例程」两边都没给答案。交付形态在成熟,工程收益还没有。
结尾互动
模型先发布、权重月底才给,你会等权重落地再评估,还是先用 API 把需求跑通?评论区聊聊。
来源链接
官方来源
- OpenAI 数学成果:https://openai.com/index/sharing-ai-progress-in-mathematics/ (2026-10-06)| GitHub 仓库:https://github.com/openai/math | 咨询小组:https://agmai.org/
- Reflection Beam:https://reflection.ai/blog/introducing-beam
- EmbeddingGemma 2:https://huggingface.co/google/embeddinggemma-2
- OpenAI 限额页:https://platform.openai.com/settings/organization/limits
独立来源
- Artificial Analysis(Mistral Large 4 智能指数 38 分)
- OpenRouter(Mistral Large 4 的上下文与定价口径)
- Bloomberg(SpaceX 借款、DeepSeek 融资)
- 媒体报道(Anthropic 数字、METR 演示)