AI 快讯 | AMIE 上《柳叶刀》:候选列表覆盖 90%,只押一个诊断时命中 56%
 一款对话式 AI 在真实门诊接诊了 100 名患者,全程零安全中断——但官方给的三个数字里,只有一个接近「准确率」这个词。
这项由 Google Research / DeepMind 与贝斯以色列女执事医疗中心(BIDMC)合作的研究,本周正式发表于《柳叶刀》。预印本 3 月就已经公开,所以这周发生的事是「正式发表」,不是研究刚做完。官方的更新说明里,同时写下了两条对自己不利的结论。
研究是怎么做的
100 名成年患者在就诊前 0 到 5 天与 AMIE 做文本对话,其中 98 人按约就诊;对话全程由 7 名经培训的内科主治医师实时视频监护,另设 4 条预设停机标准。研究事先注册、经过伦理审查,单中心,最终诊断来自就诊后 8 周的病历回顾。
底层模型是 Gemini 2.5 Pro(知识截止 2025-01),没有做领域微调。
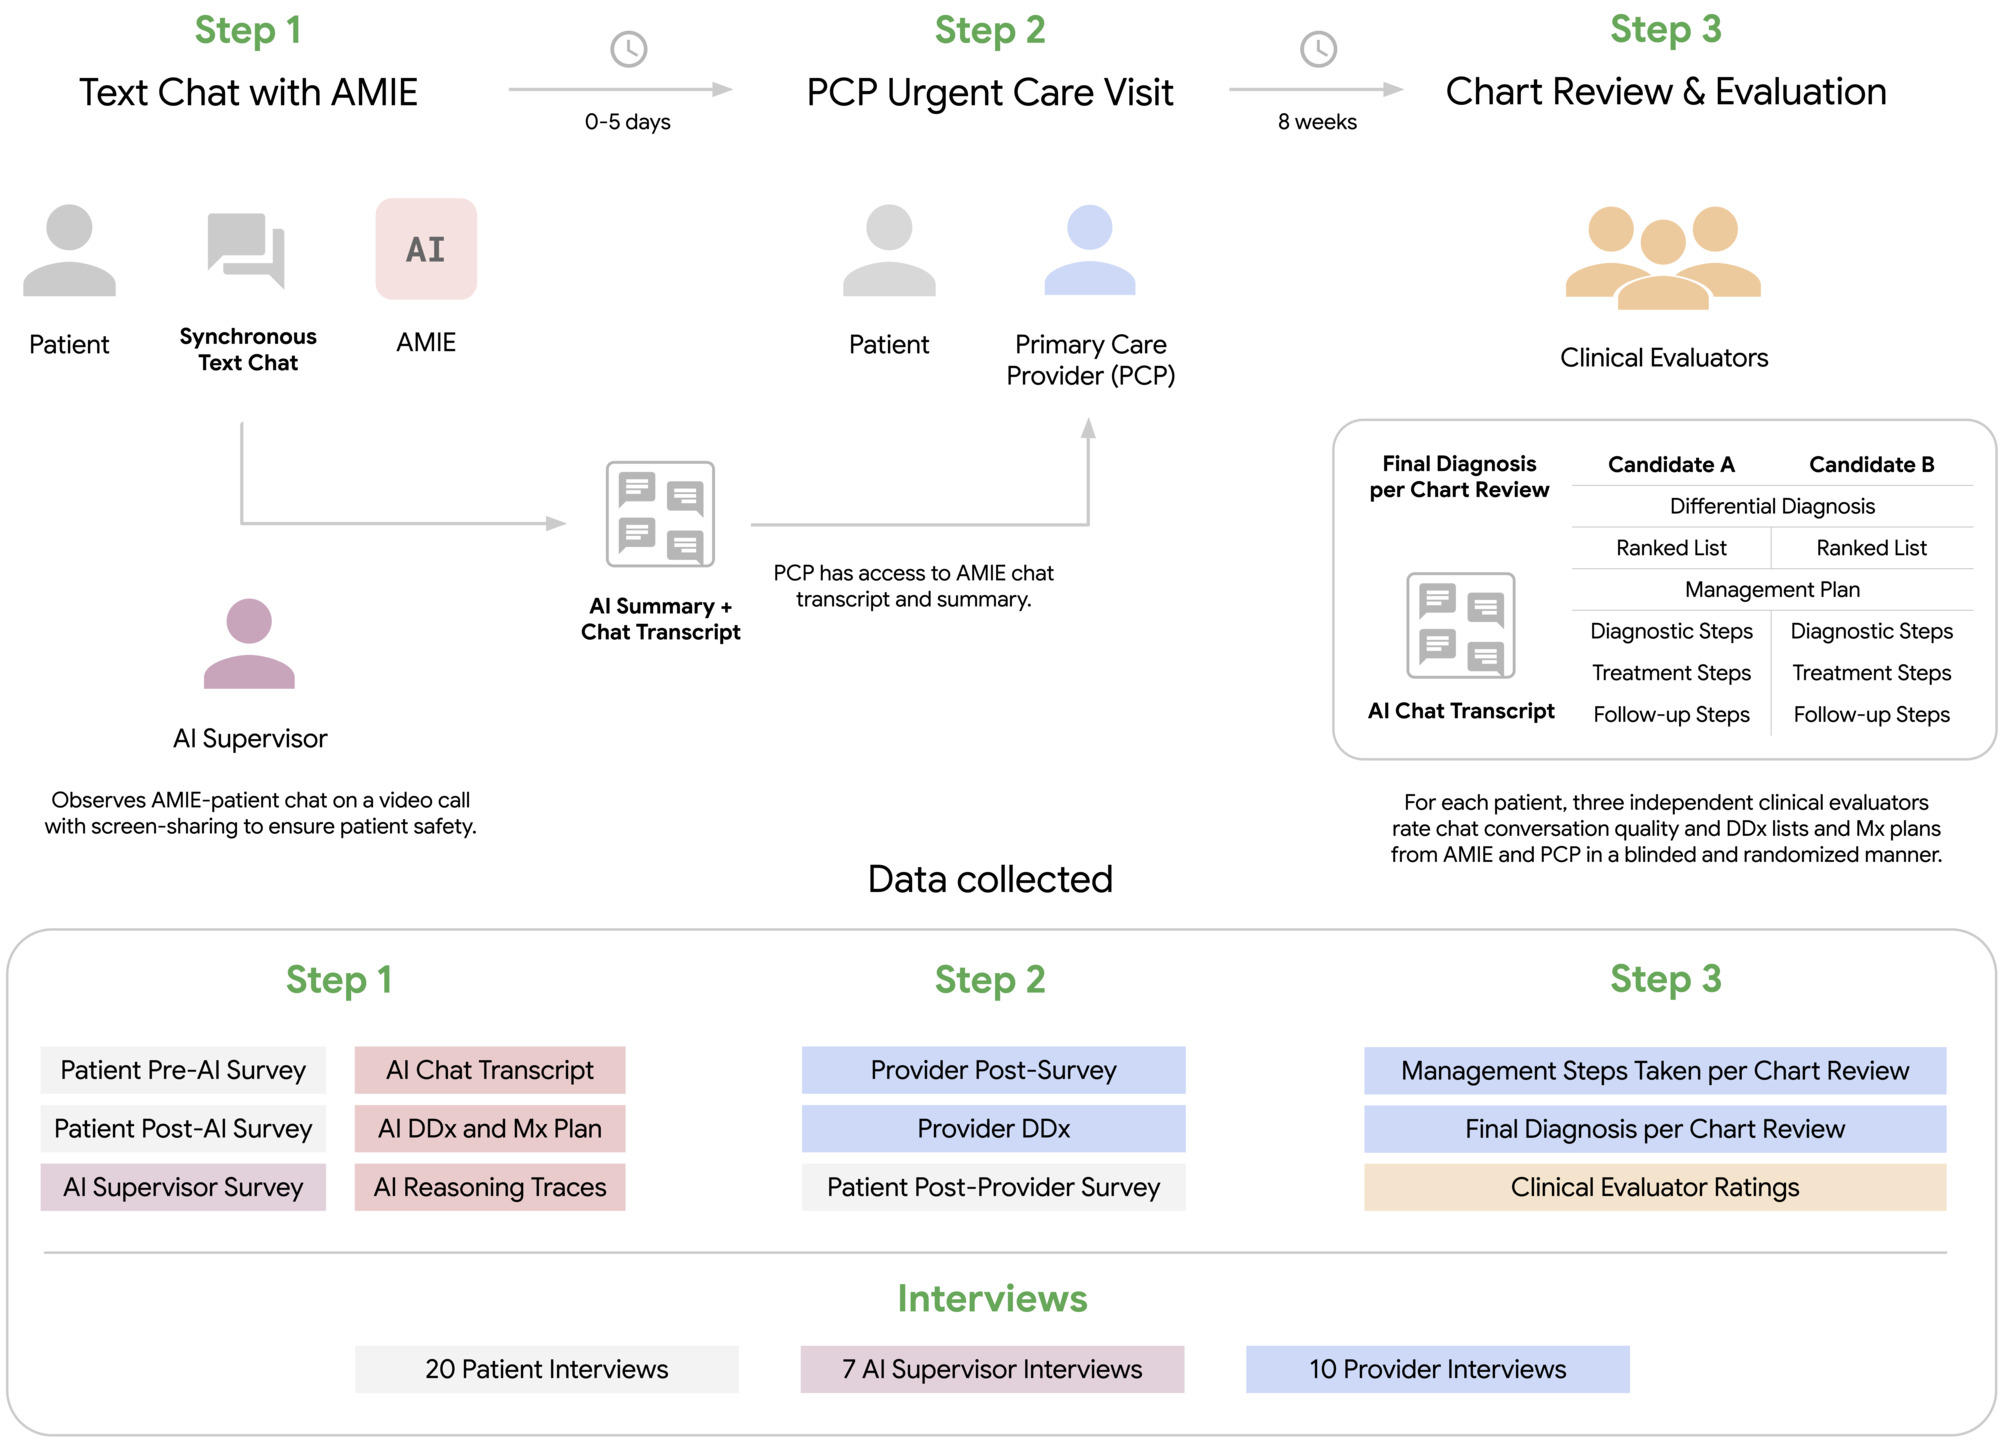
图 1:AMIE 与 BIDMC 研究的三步流程——患者先与 AMIE 文本对话,再到基层门诊就诊,8 周后由临床评估者回顾病历盲评。来源:Google Research 官方博客研究图(流程图,不含测评数据)。
三个数字不能混着读
90% 是「鉴别诊断候选列表(取前 7 项)中包含最终诊断」的比例;取前 3 项时是 75%;而把最终诊断列为唯一最可能诊断的命中率是 56%。换个说法:它擅长把答案放进候选里,单独押一个时并不准。
另外,流传的「75% 的临床医生反馈摘要帮助其准备就诊」在官方博客与论文里都对不上——那个 75% 其实是前 3 项诊断准确率;官方对「帮助就诊准备」的表述是定性的。
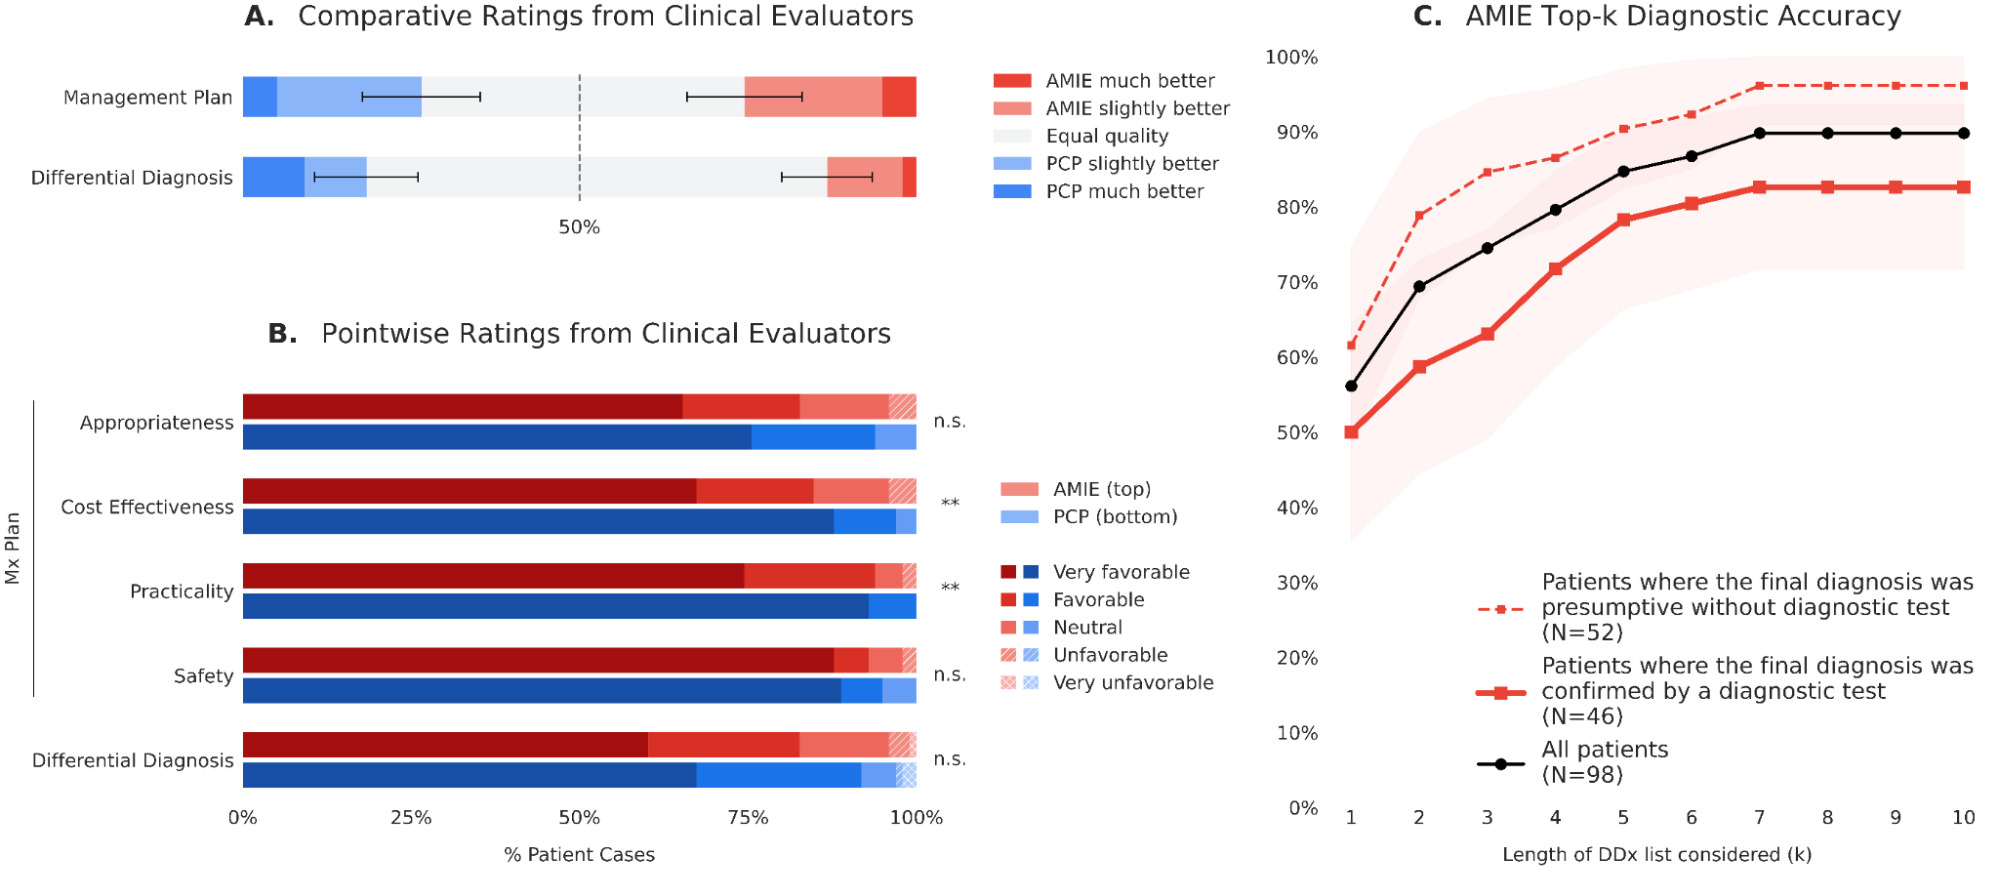
图 2:AMIE 与基层医生的盲评结果,以及 AMIE 的 top-k 诊断准确率曲线——k=1 为 56%,k=7 达 90%。来源:Google Research 官方研究图,出自厂商与医院合作、经同行评审发表于《柳叶刀》的研究。
官方自己划的边界
这项研究不含对照组,官方明确写它「不支持对本干预相对于基线流程之效果的定量主张」。它还是单中心、纯文本、需要专职医师实时监督,排除了心理健康主诉与孕妇,样本也偏年轻——外推范围有限。
盲评结果同样两面:AMIE 与基层医生在鉴别诊断质量(p=0.6)、管理计划的适当性(p=0.1)与安全性(p=1.0)上没有显著差异,但基层医生在「可行性」与「成本效益」上更优(p=0.003 / p=0.004)。这套组合给出的角色因此是「可监督的辅助」,而不是替代。
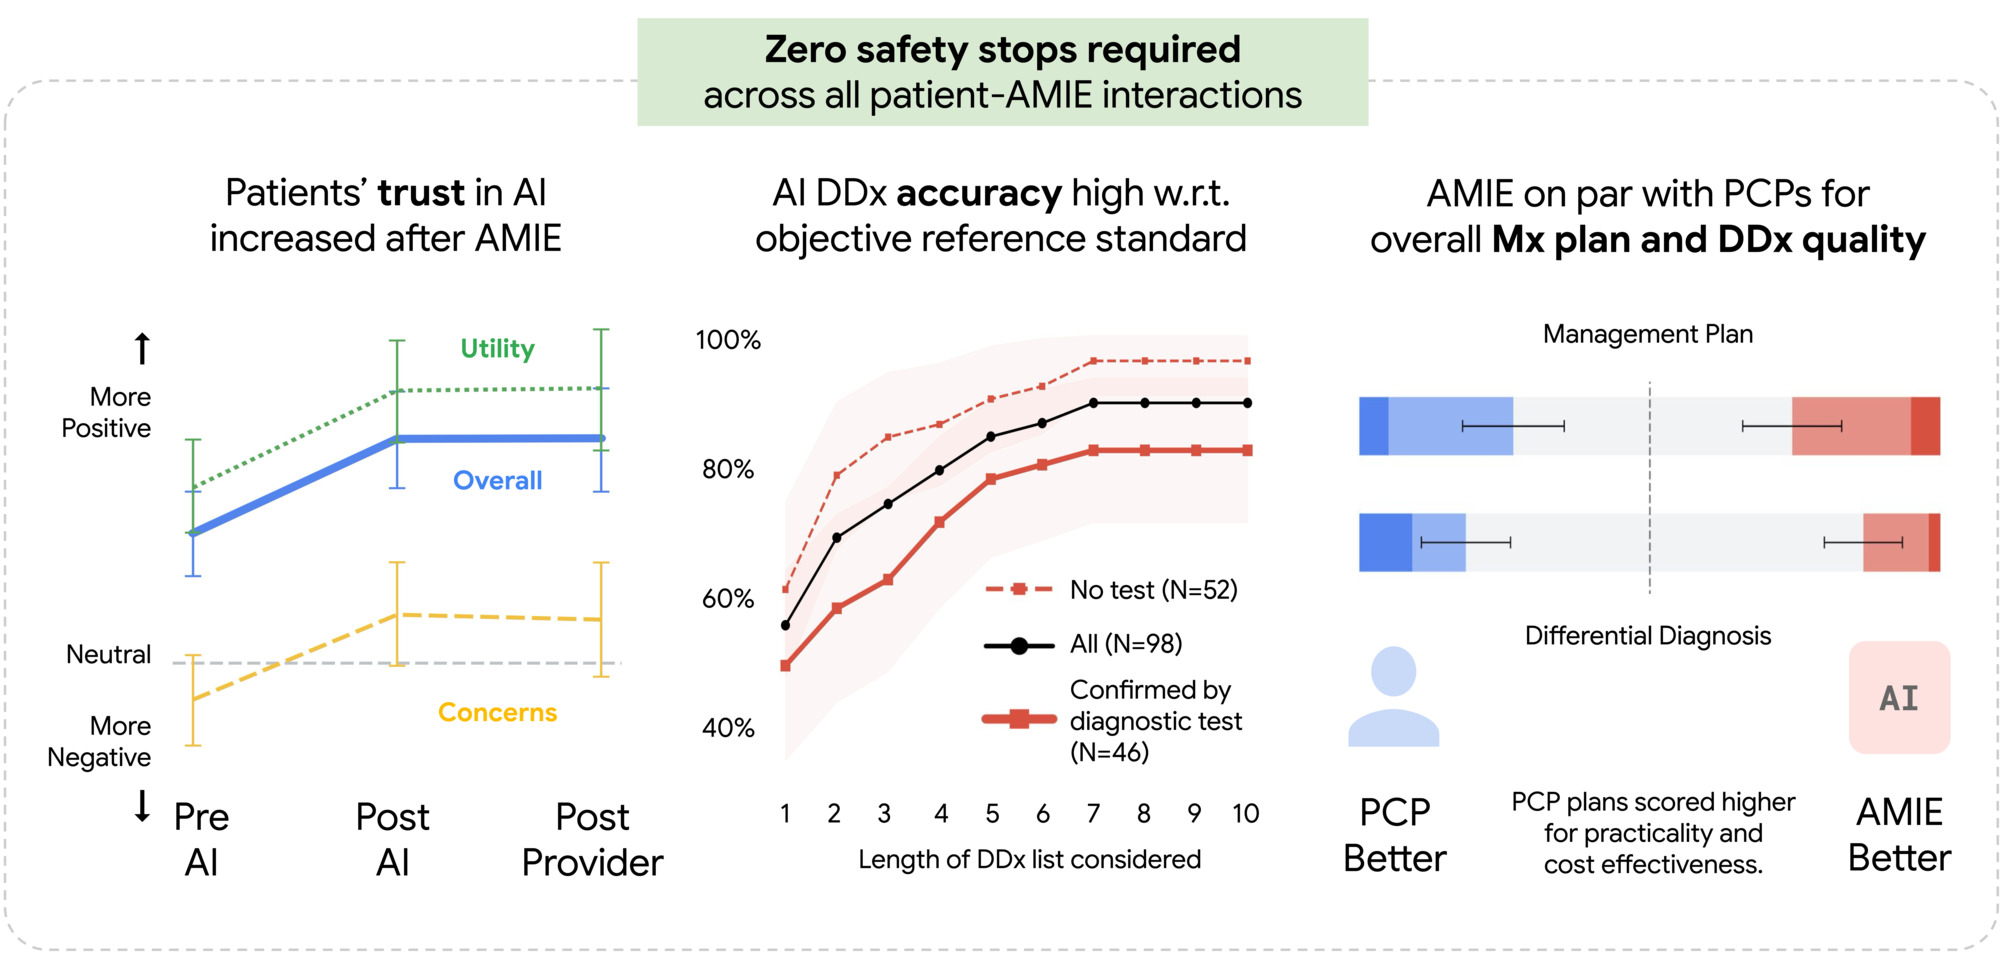
图 3:安全性、患者信任与诊断准确率的汇总;「可行性」与「成本效益」两项基层医生更优。来源:Google Research 官方研究图,同上研究。
患者这一侧的态度是正向的:GAAIS 量表上,整体评价与效用两项在对话后显著改善,并在就诊后保持;顾虑一项也略有缓和。
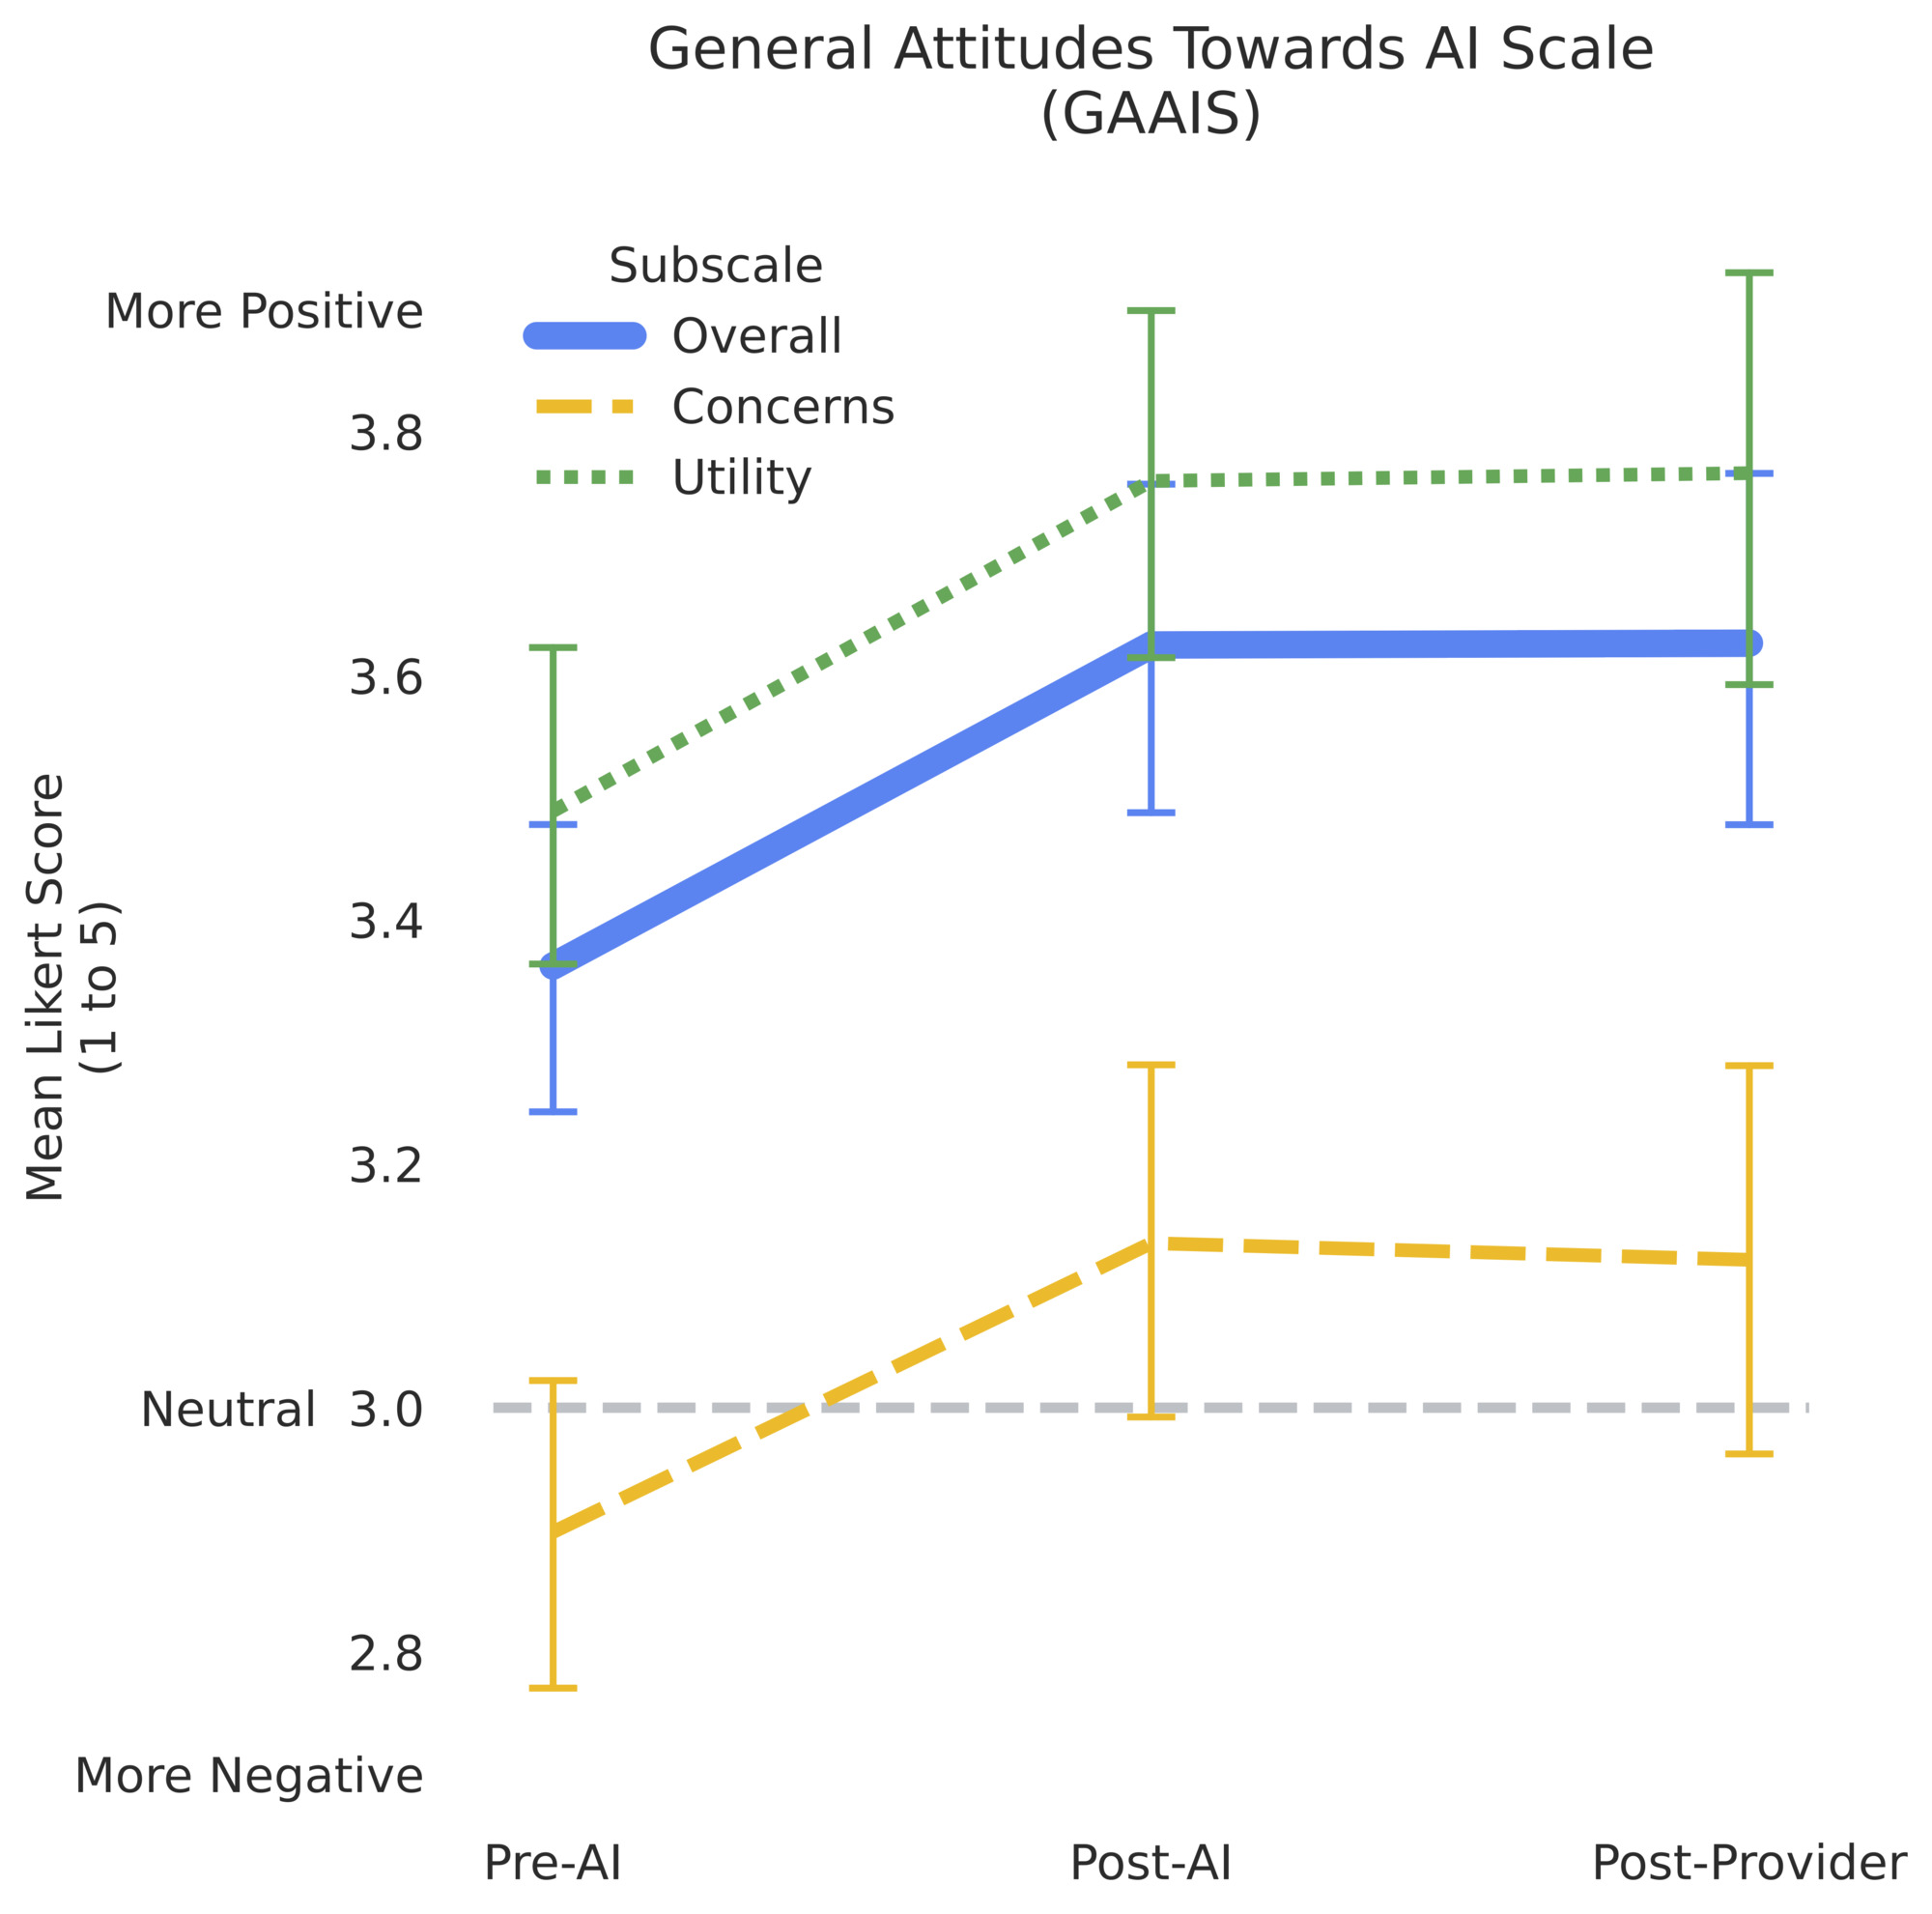
图 4:患者对 AI 的态度量表在就医前、对话后、就诊后三次测量的变化。来源:Google Research 官方研究图,同上研究。
另外一条跟进:一个符号错误,撤回 3 篇
OpenAI 在官方数学仓库的变更记录里写明:一篇论文里的符号错误使一个论证失效,因此撤回 3 篇手稿,其中两篇依赖该论证;同一批记录还修订了 14 篇、因引用联动更新 13 篇。官方同时给出形式化进度:top-line 结果里有300 / 719 ≈ 42% 已完成形式化。
媒体口径的「722 份手稿 / 372 项结果」与官方的 719 个 top-line 结果对不齐,引用时要把量词写清楚。这和本月初那批数学结果指向同一件事:瓶颈不在产出,而在验证流程与人类理解的归位。
来源链接
官方来源
- Google Research 官方博客《Exploring the feasibility of conversational diagnostic AI in a real-world clinical study》(2026-03-11 首发,2026-10-08 加更新说明已发表于 The Lancet)
- 论文预印本:arXiv 2603.08448v2;正式发表:《柳叶刀》
- OpenAI 数学仓库变更记录:github.com/openai/math(记录日 2026-10-07)
独立来源
- Retraction Watch(OpenAI 撤回手稿,10-08)