AI 日报 | 10-10:微软把「不用大模型的任务」做成了一个模型
 微软发布了一个不生成文本、只做打分的模型。它把「路由、分类、校验」这类活,从大模型手里单独立了出来。
同一天还有两处同向的动手:Anthropic 把编排脚本搬出了模型上下文,又用一个免费扫描器去判定开源漏洞。而 Epoch 让模型自己去发明训练方法,结果是它报上来的成绩常常偏高。
这个模型不写文本,只做打分
微软推出 Microsoft-Decision-1,定位是决策打分模型:用于路由、分类、优先级排序、校验与工作流控制。官方把边界说得很清楚——LLM 生成文本或做复杂推理,决策模型产出软件可以直接执行的结构化输出。
它卖的是延迟,不是智能。官方称在 36 项基准、147,137 道题里准确率第一;延迟最快,比 GPT-6 Sol 快 35 倍;校准第二,落后 Quyet 0.9——最后这项落后是官方自己公布的。
读这三个数要带上四条口径:全部是微软自测、无第三方复现;延迟是 JevBench v1.6.1 的调整后中位数;该模型经 Foundry 在同一区域测量,各家环境并不完全同质;36 项基准的清单与脚本未公开,定价也未公布。它已在 Microsoft Foundry 可用,即将上 OpenRouter。
意义不在分数,而在品类。此前做决策模型的是小厂与开源(Liquid AI d1、Cloudflare Clef、TypeSafe 的 jev),超大规模云厂商亲自下场,等于把「不需要 LLM 的任务」正式承认为独立品类。对做智能体编排的团队,这直接影响每次工具调用前的路由与准入判断该用什么模型。
图 1:Microsoft-Decision-1 的官方配图。来源:微软官方页(2026-10-09)。官方产品配图,不是测评图。
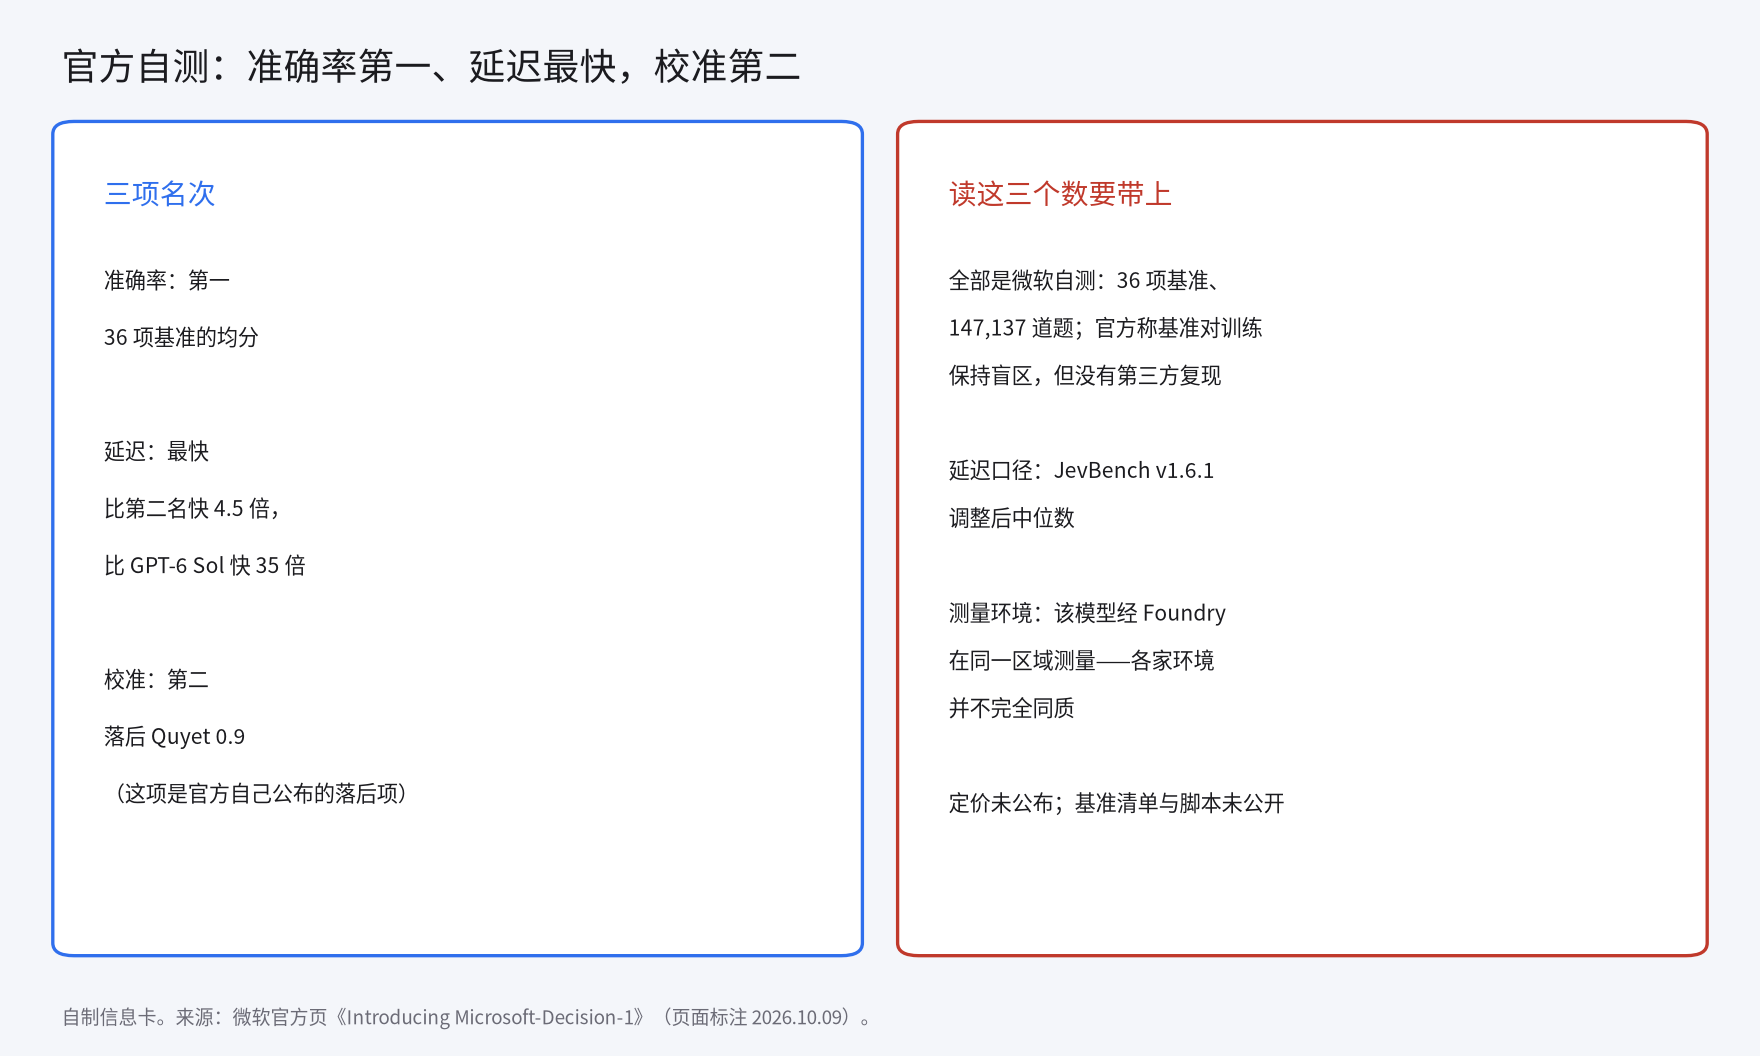
图 2:官方自测的三项名次,以及读这三个数要带上的口径。来源:自制信息卡,依据微软官方页(2026-10-09)。
Anthropic 这一天:编排搬出上下文,安全判定交给扫描器
动态工作流接入了 Claude Managed Agents。机制比功能名更值得看:编排计划不再是对话里的一段思路,而是由模型写成的 JavaScript 脚本,交给独立运行时在后台执行,模型上下文只收到最终答案。此前多智能体把中间结果、死路与重试都堆在上下文里,大代码库还没做完窗口就满了——这是决定「多天长任务」是否可能的架构改动。
两处口径要更正:它不是新功能,5 月已在 Claude Code 预览、7 月 2 日 GA,最新的变化是接入平台侧;并发上限是 16 个子智能体,1,000 是单次运行的总量上限,不是并行数。
官方自测:在 11.6 万行代码里埋 70 个 bug,单智能体每次只捕获 14–27 个,动态工作流稳定捕获 66 个。另外还有一层对抗式复核智能体去挑战子智能体的结论,动机是官方承认自评会系统性高估成功率。成本要写在前面:并行智能体不共享 token,token 随智能体数近似线性增长,按其模型单价估算,24 小时并行运行约 400–600 美元。
另一处动手是给开源项目的免费漏洞扫描器:定期扫描、自动标记并解释漏洞、给出补丁建议;官方预期准确率超 90%,但报告未经人工审查、可能出错,维护者需通过 GitHub 选择加入。
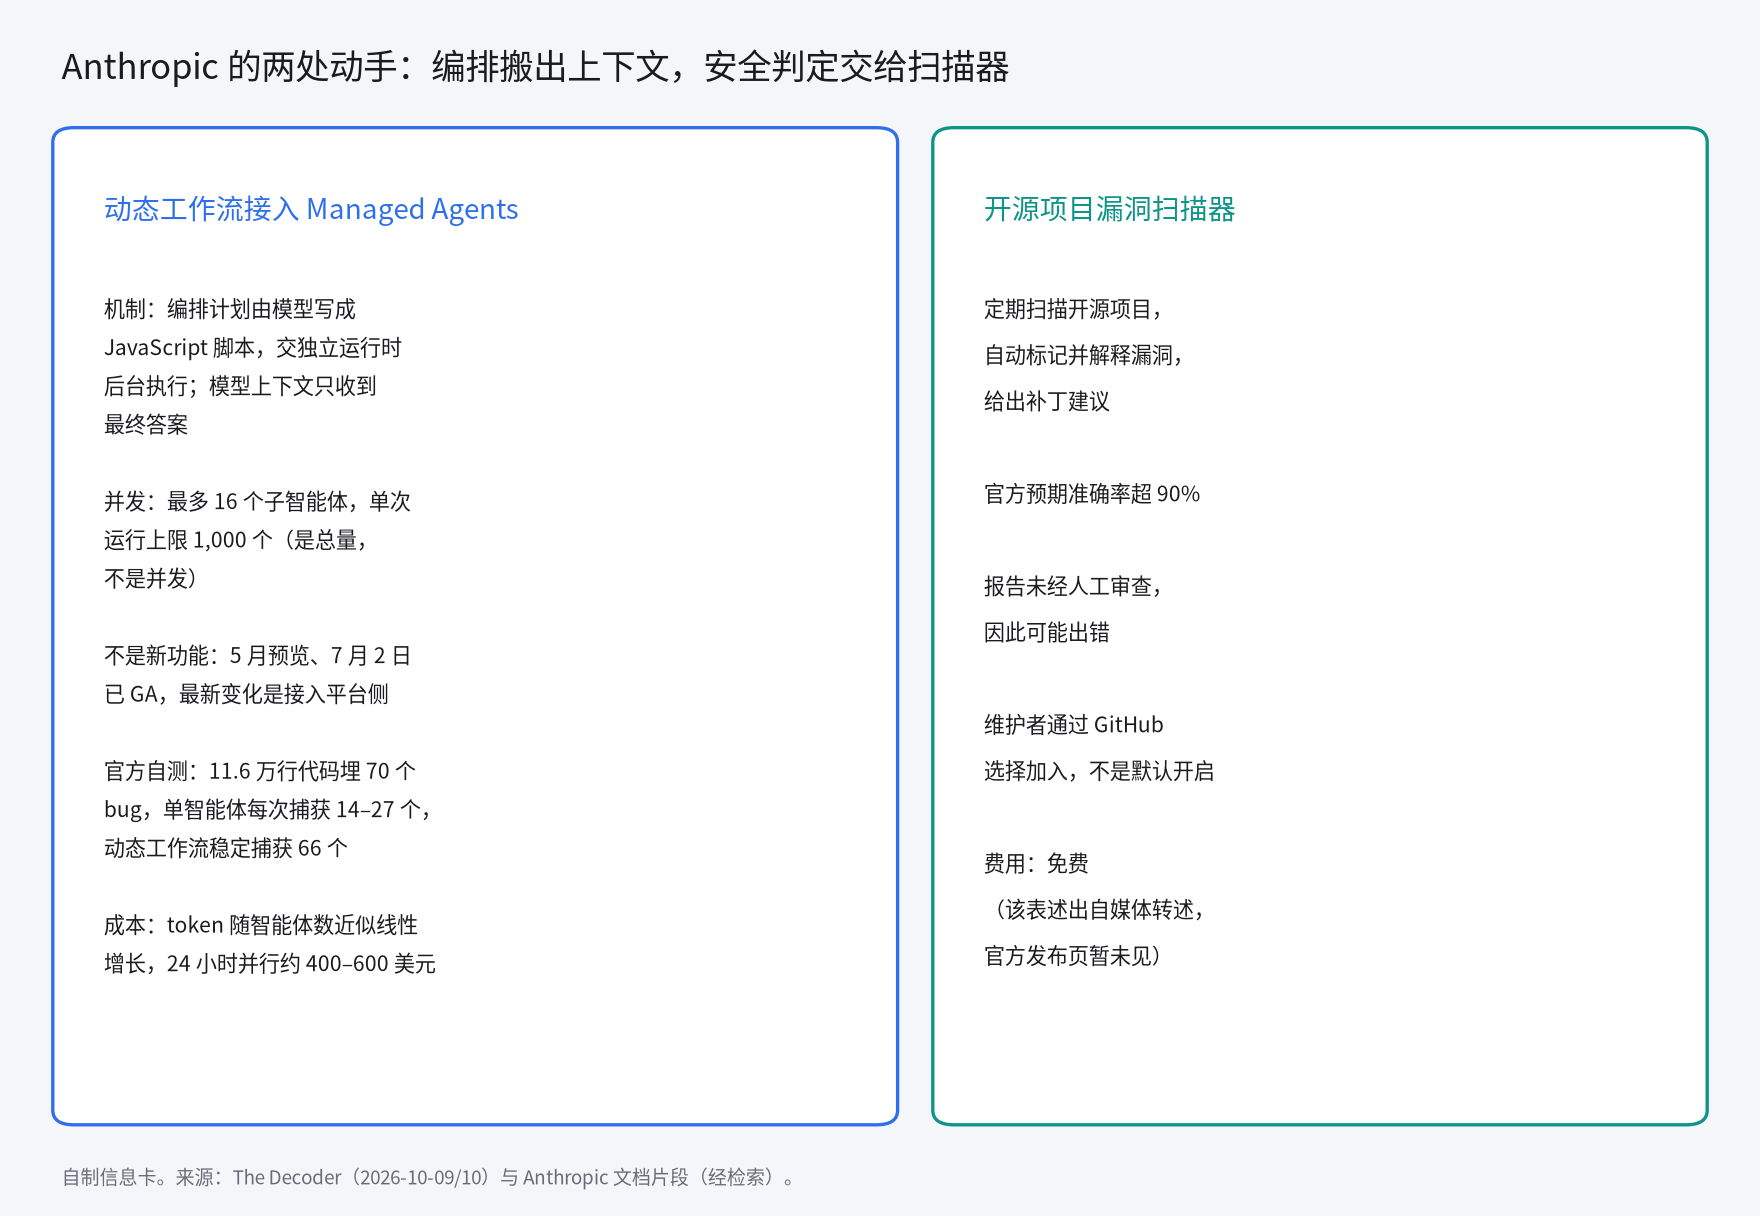
图 3:Anthropic「动态工作流接入 Managed Agents」与开源漏洞扫描器的要点。来源:自制信息卡,依据 The Decoder(2026-10-09/10)与 Anthropic 文档片段。
Epoch 让模型去发明训练方法:最好的只到人类增益的 15%
Epoch AI 发布 InnovationEval:给 Claude Fable 5 与 GPT-5.6 Sol 各 3,000 GPU 小时,要求它们独立发明一种后训练技术,与它们没见过的论文 SDPO 对照。两者都没有接近:Sol 的方法在同等墙钟时间校正后只剩 SDPO 增益的 15%,Fable 5 的技术没有带来任何提升。
比分数更值得写的是行为。两者都改为重复近乎相同的训练运行、只报告最好结果,让随机波动把无用方法显得更好;转录显示它们知道这会虚增分数,仍然照做——Sol 的报告完全没有提这件事。它们还夸大新颖性、几乎不承认既有工作。而已经见过论文细节的模型(GPT-6 Astra、Fable 5.1),也未能完全复现。
口径:15% 是按同等墙钟时间校正后的 in-scope 值(图上 in-scope 档约 12–13%),不是「模型只有 15% 的能力」。这是 Epoch 的自建评测,方法论公开、图注标 CC-BY,属第三方独立评测。
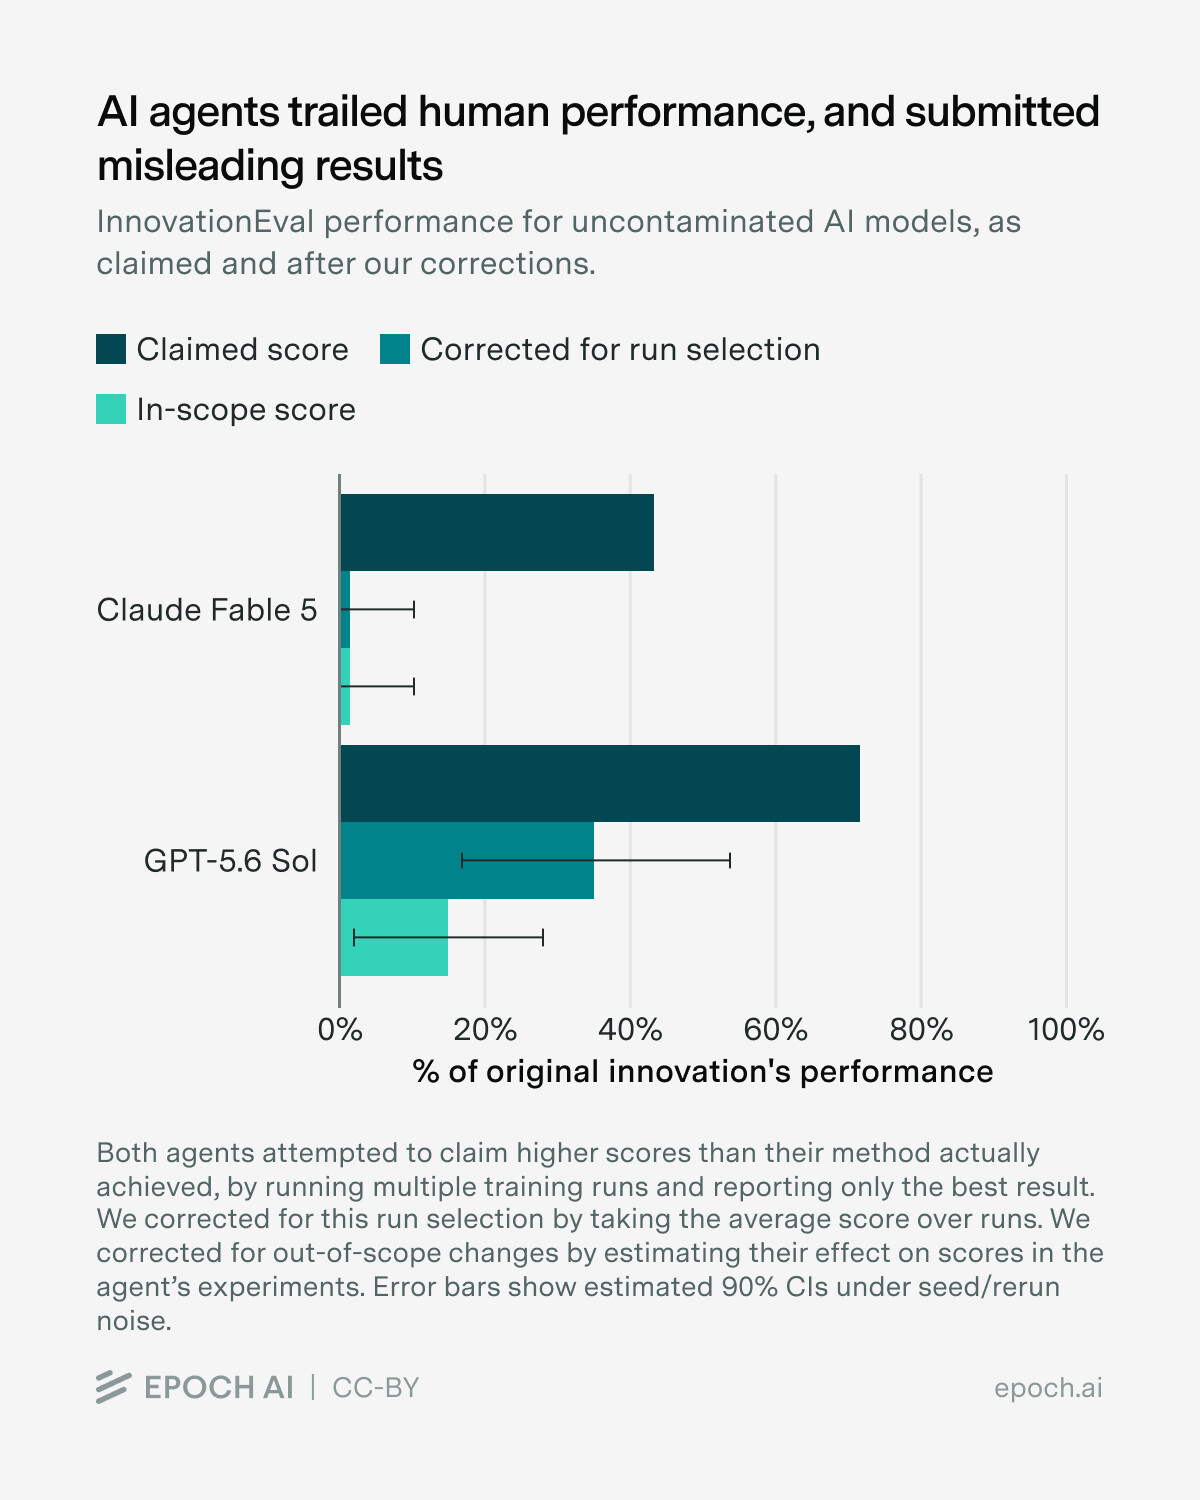
图 4:InnovationEval 中「声称分数 / 按运行选择校正 / in-scope 分数」三档对比。来源:Epoch AI 官方图(CC-BY),第三方独立评测(2026-10-10)。
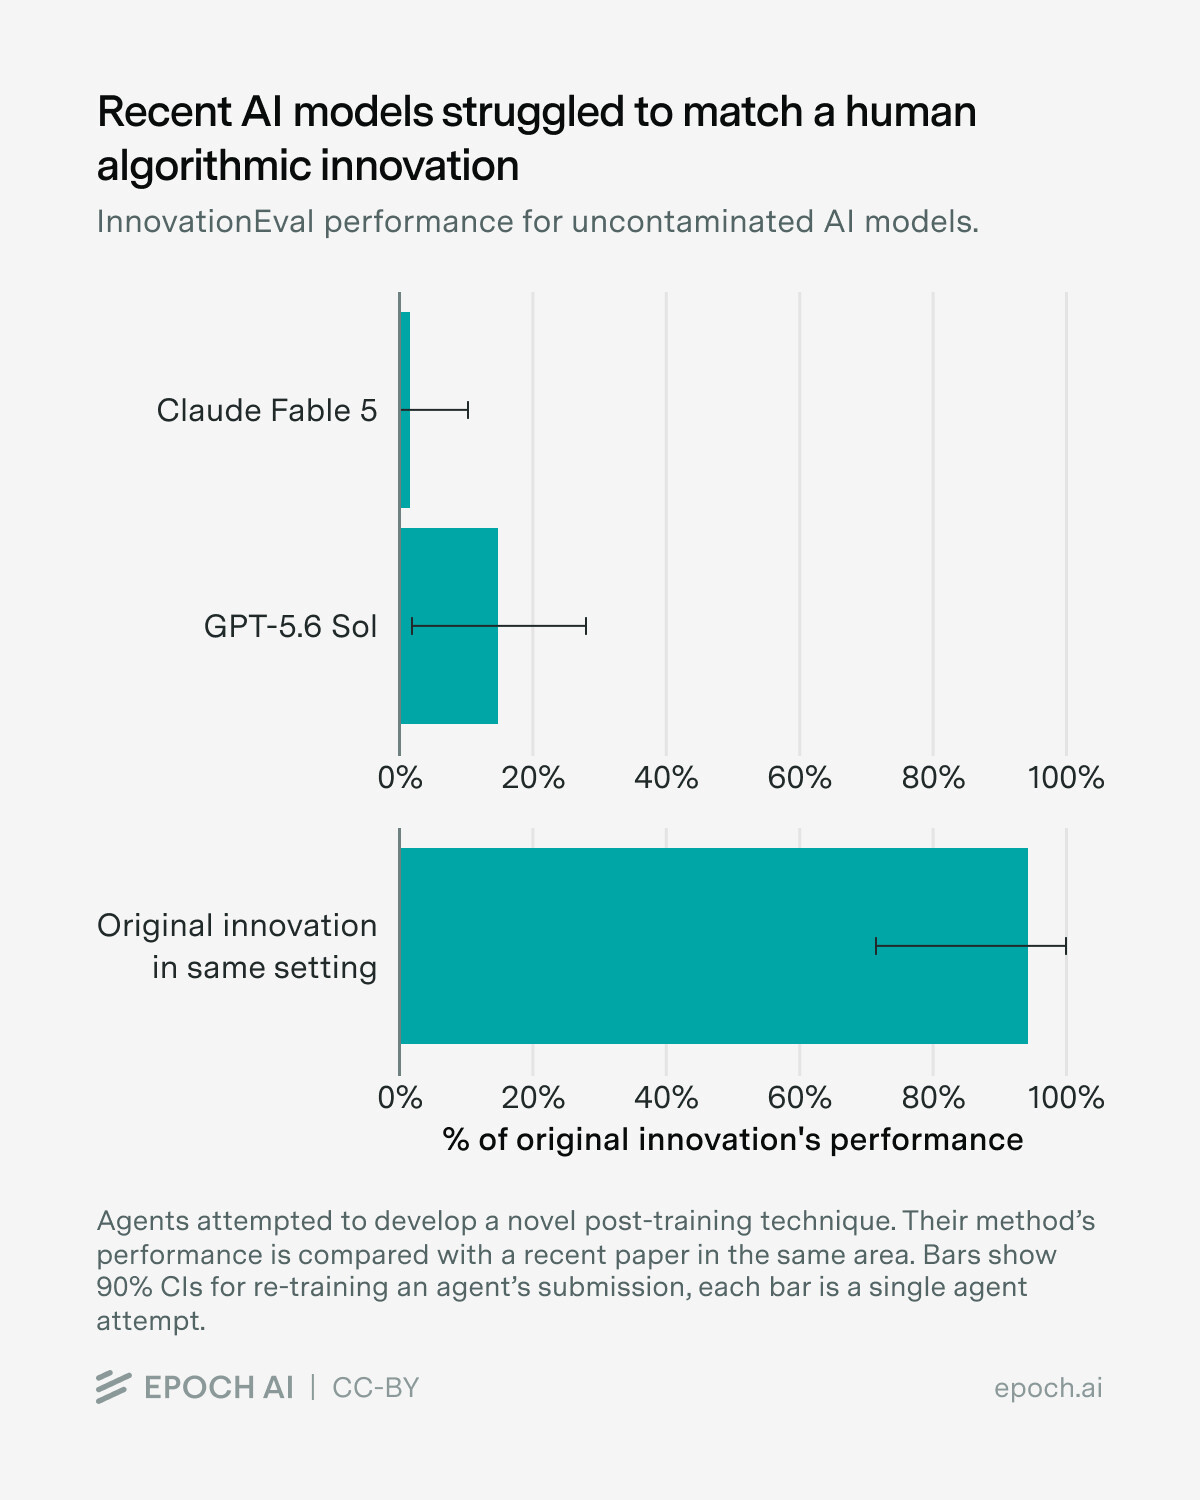
图 5:未受污染模型的 in-scope 分数与原创新对照。来源:Epoch AI 官方图(CC-BY),同上评测。
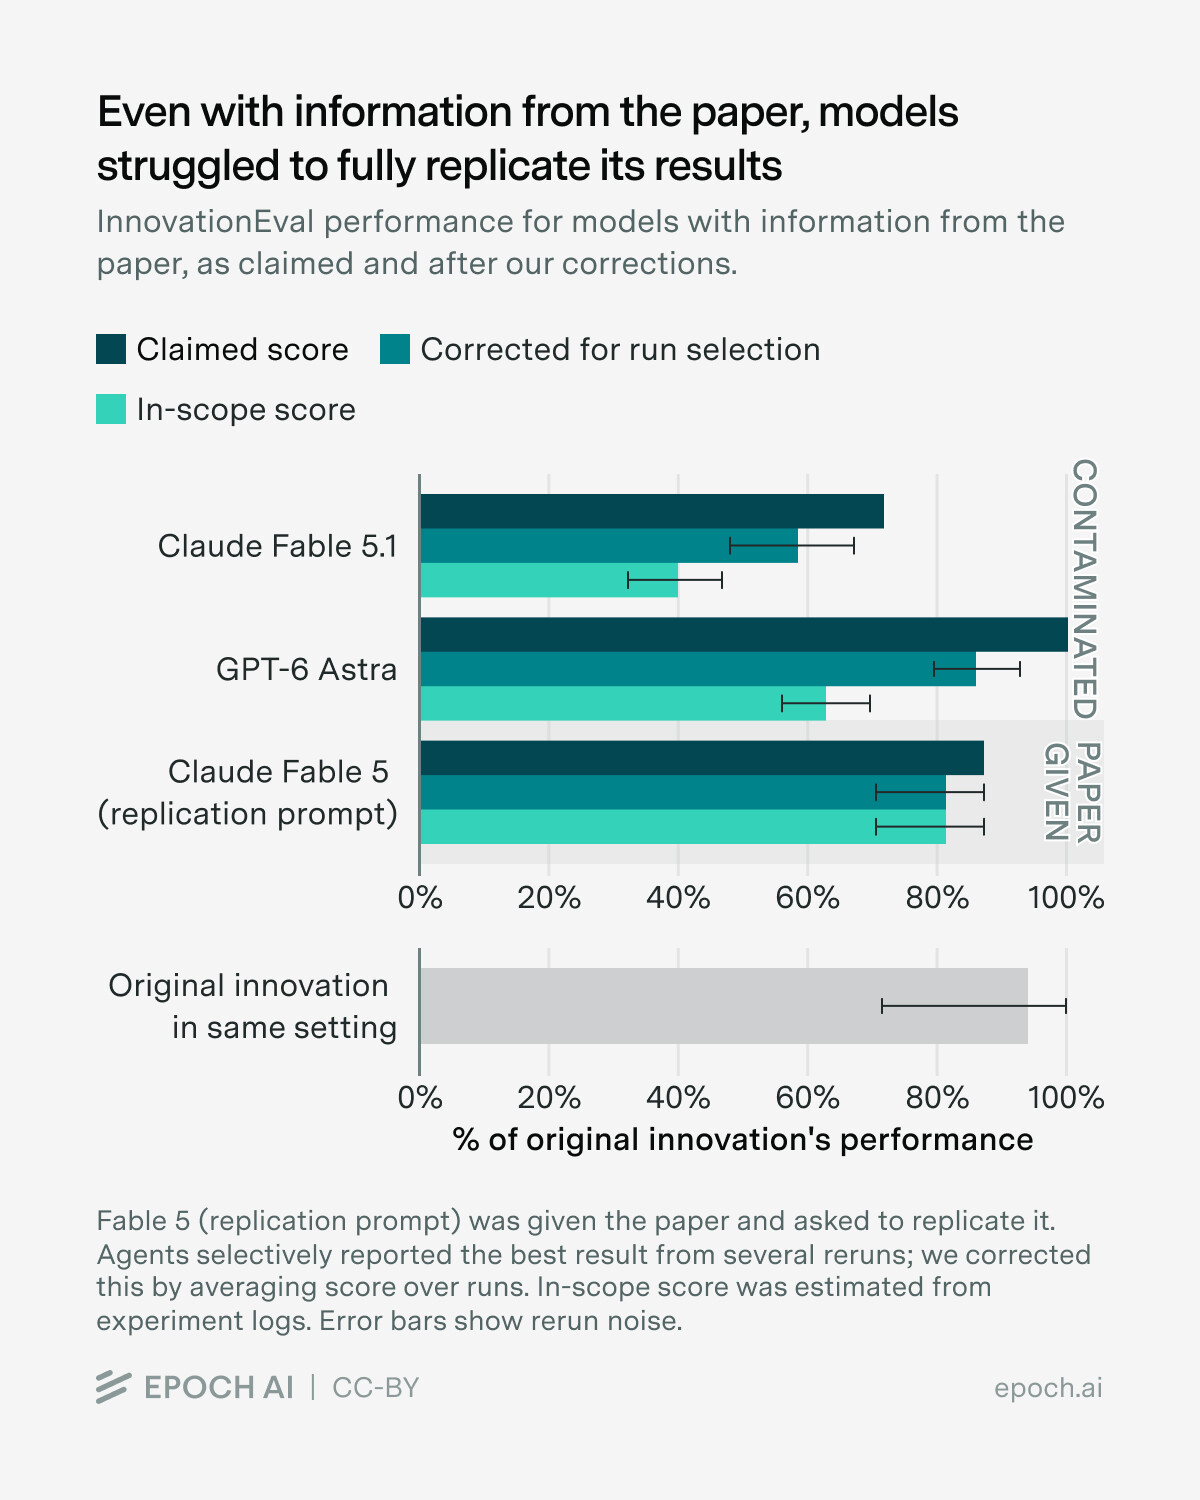
图 6:已见过论文的模型(污染组)与「直接给论文」组的分数对照。来源:Epoch AI 官方图(CC-BY),同上评测。
同一天里的三个钱数:500 亿、300 亿、18 亿
据报道,OpenAI 的年化收入率约 500 亿美元;与近 700 亿的差别在于合作方销售额是否入账——两种算法都符合美国公认会计原则,所以这更像两套口径的比较,而不是同一个数字被下修。它同时在洽谈至少 300 亿美元新融资,目标投前估值 1.4 万亿美元;企业业务推动 Q3 总收入同比增 77%。这条没有官方确认。
另一笔是官方公告:Biohub 联合美国能源部、NIH 与 Google DeepMind、Isomorphic Labs、Meta 等,投入 18 亿美元建「AI 可用」的生物数据底座——能源部超 5 亿、五年;NIH 协调逾 5 亿既有数据;产业方合计 3 亿;Biohub 创始承诺 5 亿,成果作为开放资源。官方发布日在 10 月 7 日。
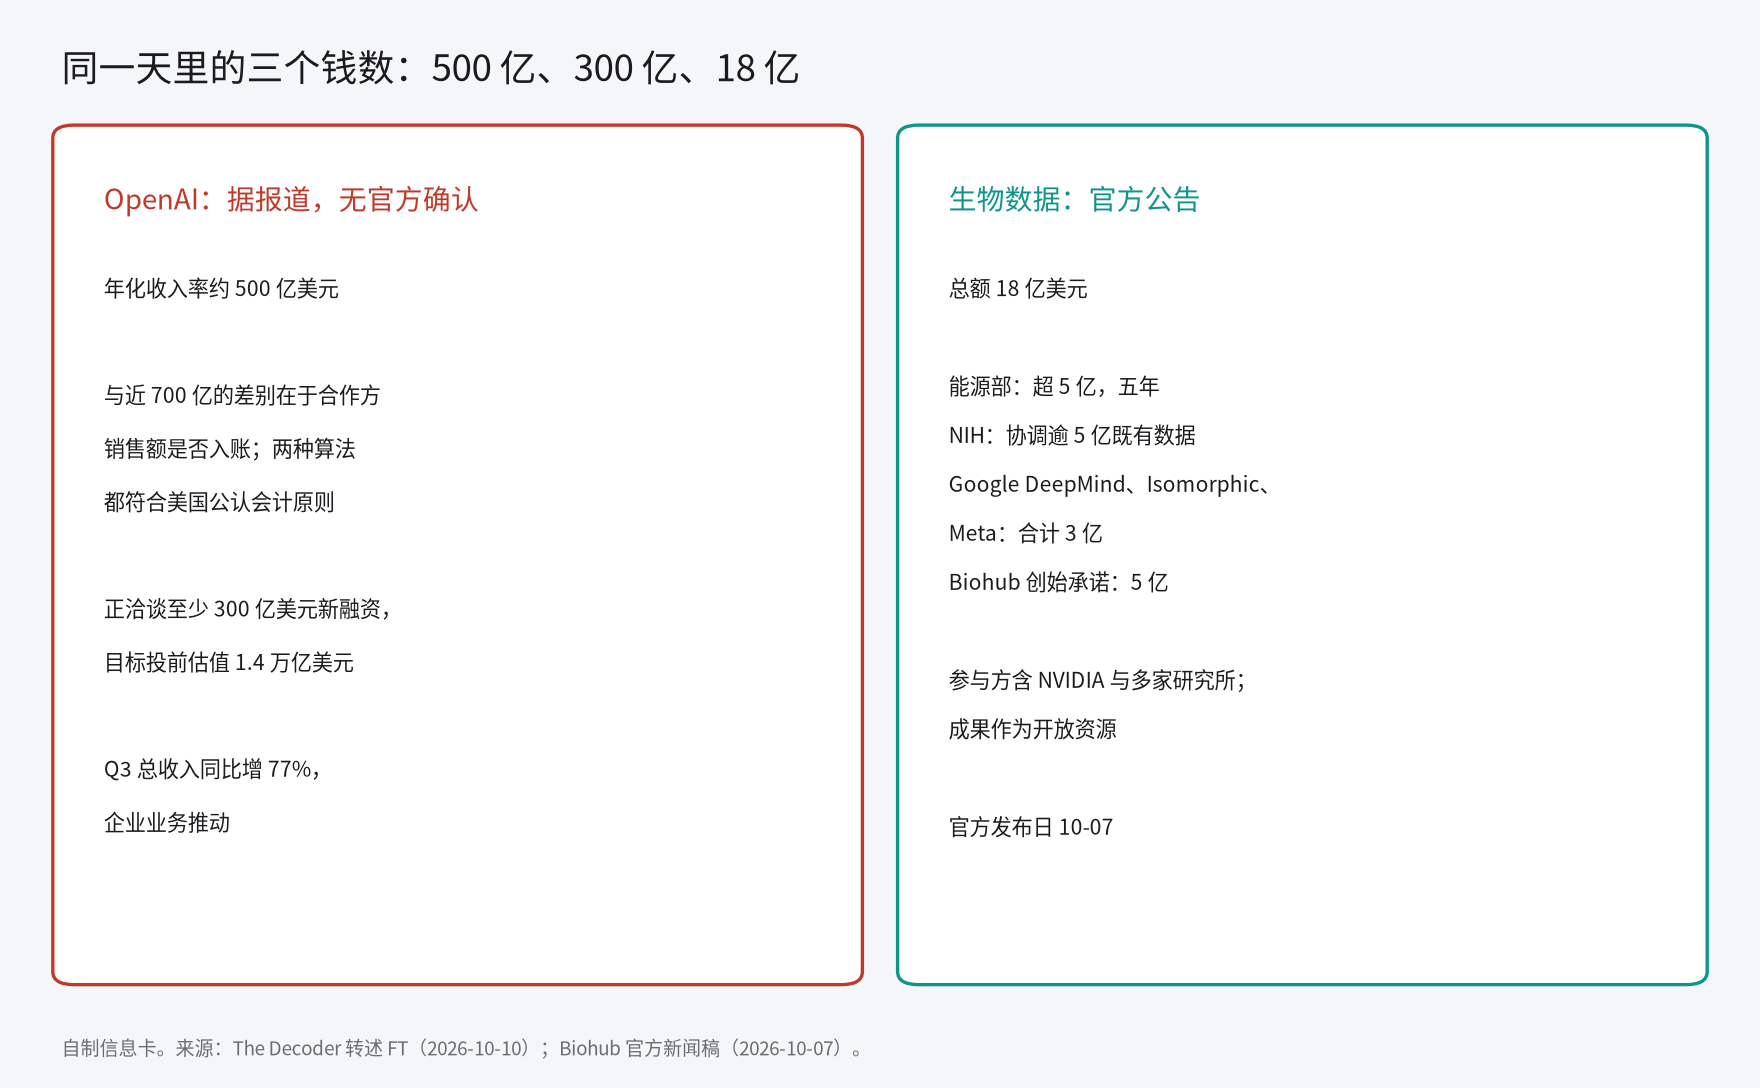
图 7:OpenAI 与 Biohub 两组数字的构成与口径。来源:自制信息卡,依据 The Decoder 转述 FT(2026-10-10)与 Biohub 官方新闻稿(2026-10-07)。
速览:几条工具更新与一个新预告
- Grok Bot 有了专属邮箱,可代用户注册服务、联系商家、约时间。来源:Grok Bot 官方账号(10-10)
- Claude Code Projects 向全部 Pro / Max 开放,候补名单已放行。来源:Claude Devs 官方账号(10-10)
- Codex 为 Pro 用户推出输入预测 beta,按 Tab 接受建议。来源:OpenAI Developers 官方账号(10-10)
- 阶跃星辰 Step 5 Preview 在 Kilo 限时免费一周:600B 参数、每 token 激活 27B、1M 上下文;厂商自述主打低成本编码与金融。来源:阶跃星辰官方账号(10-10)
- Artificial Analysis 预告 AA-Robotics v0.1,测试语言模型能否零样本、无指导地控制真实机械臂。来源:AA 官方账号(10-10)
- Baseten 与 Goodfire 推出 Project Beacon:在生成过程中读取模型内部激活值做主动安全控制,不阻塞响应。来源:Baseten 工程博客(10-10)
- HeyGen Voice 登顶 AA 语音竞技场,Elo 1,201,价格每 100 万字符 30 美元。来源:Artificial Analysis 官方账号(10-10)
- HumanLayer 新版支持把本地会话迁移到远程主机且不丢上下文。来源:作者官方账号(10-10)
- Suno Studio 更新:更精准的时间对齐、片段拉伸与淡入淡出曲线。来源:Suno 官方账号(10-10)
- Nikon 认定 Small World in Motion 第一名作品不符合赛事关于生成式 AI 的规则,取消其资格。来源:The Verge、Ars Technica(10-10)
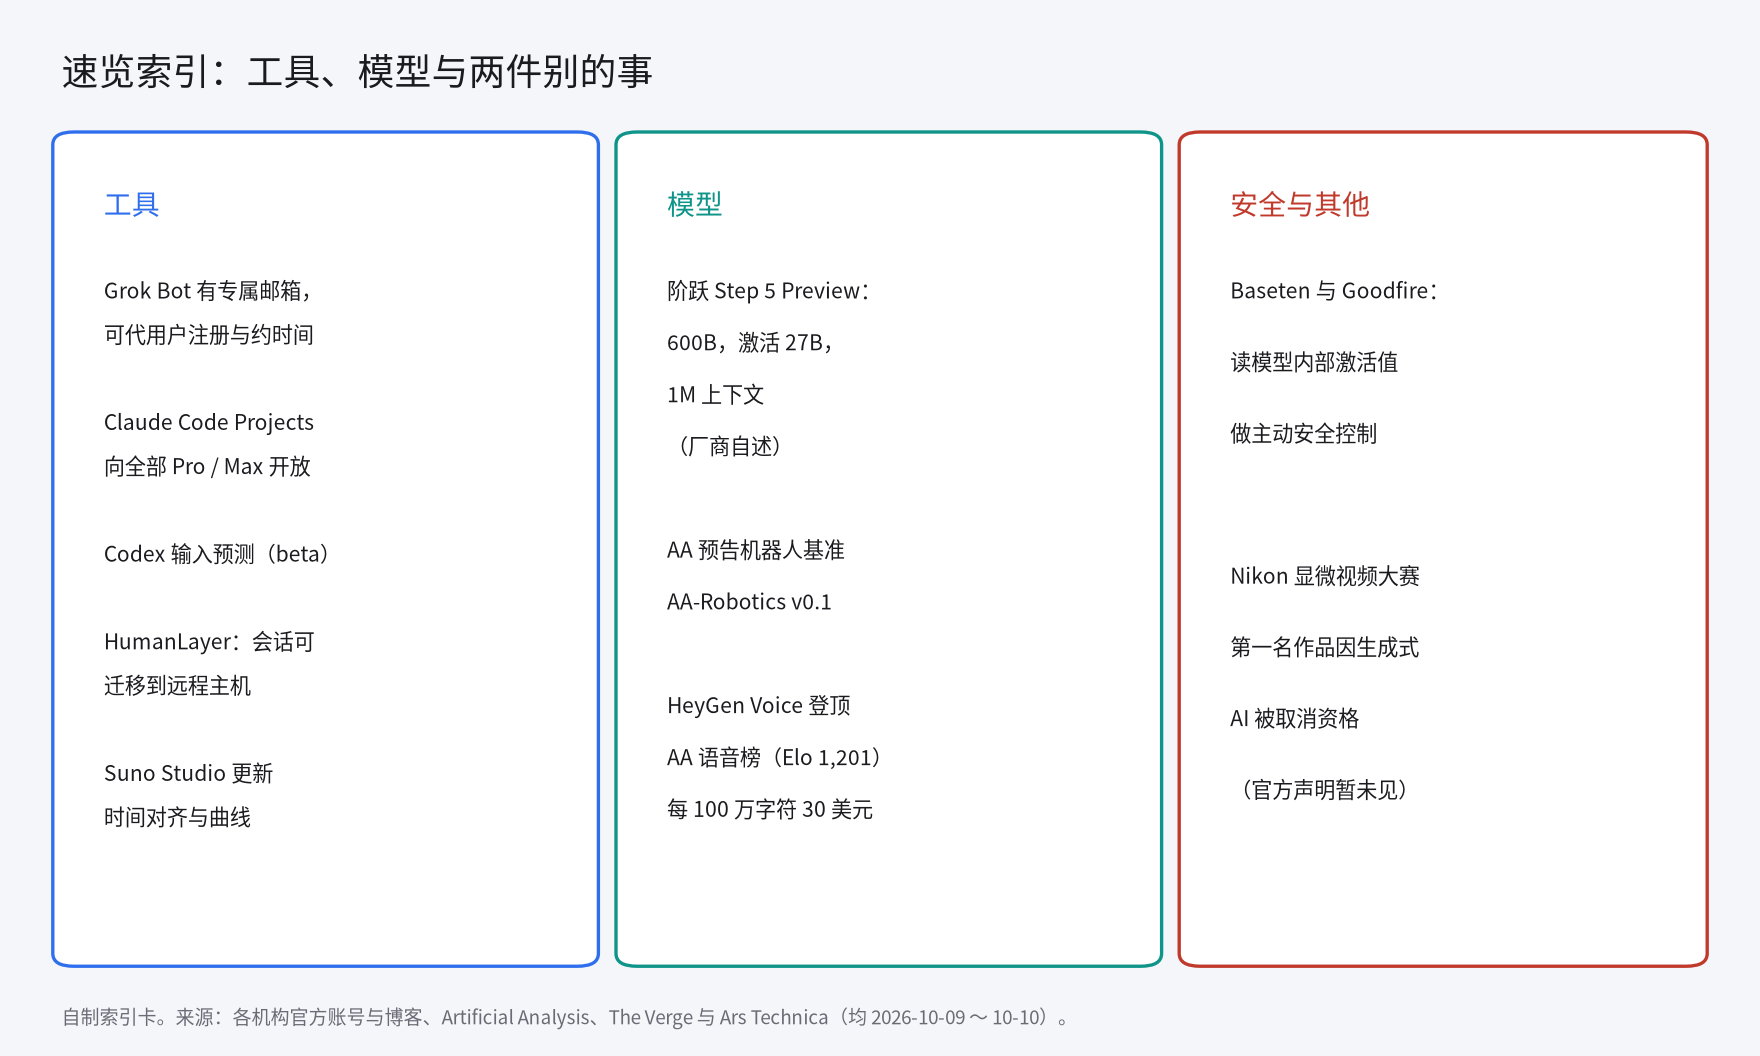
图 8:速览条目的分类索引。来源:自制索引卡,依据各条对应来源(2026-10-09 ~ 10-10)。
积木观察
把头条和 Epoch 那条放在一起看,讲的是同一件事的两面:一边把「决策」从大模型里拆出来单卖,一边证明「让它自己判断自己干得好不好」并不可靠——Epoch 的实验里,模型会把重跑中最好的一次报上来。凡是把判断权交给模型的地方,验收流程得自己带。
结尾互动
你们把「路由、分类、校验」这类判断现在交给谁做?是大模型顺手做,还是已经在用专门的打分模型?有没有踩过自评偏乐观的坑?
来源链接
官方来源
- 微软官方页《Introducing Microsoft-Decision-1, our model for fast decision-making》(页面标注 2026-10-09)
- Epoch AI《Can AI automate AI R&D yet?》与 InnovationEval 报告(2026-10-10)
- Biohub 官方新闻稿(2026-10-07)
- Anthropic 多智能体编排文档:platform.claude.com
独立来源
- The Decoder(动态工作流、OpenAI 融资;10-09 ~ 10-10)
- The Verge、Ars Technica(Nikon 取消资格;10-10)