AI 日报 | 10-12:多智能体「团队」贵了 1.8~5.1 倍,质量提升几乎测不出来
 三条互相独立的来源,指向同一个读数:在模型已经跑满推理预算时,加智能体主要买的是速度,不是质量。
评测公司 Vals AI 在 Vibe Code Bench 上把 GPT-6 Sol 与 Claude Opus 5.5 各跑「单体」与「团队」两种形态、两个推理档位:团队成本是单体的 1.8~5.1 倍,而四组对比里只有一组出现有统计显著性的提升(GPT-6 Sol 的 medium 档,+7.3 分,p=0.005);另外三组是 +1.4、−0.3 与 +3.4,都不显著。
同一条研究里还有更硬的一条:把 GPT-6 Sol 的单体从 medium 档提到 max,分数涨 11.4 分——比团队带来的 7.3 分还多;而 Claude Opus 5.5 最便宜的配置与最贵的配置在这组任务上得分相当,后者贵 30 倍。
另两条来源给出了同一个判断
Anthropic 自己的 Opus 5.5 系统卡(经媒体转述)给的是规模曲线:智能体从 1 到 10、30、100,知识库任务 0.53 → 0.70 → 0.71 → 0.74,Lean 定理证明 0.39 → 0.66 → 0.66 → 0.68——从 10 个加到 100 个,分数只微动。它买到的是更快到某个水平,不是更高上限。
OpenAI 研究员 Noam Brown 的说法更直接:多智能体主要买速度不买质量,4 个智能体解任务快一倍、也贵一倍;而且任务是条件——网页研究与数学适合并行,写小说不适合。
限定要带上:别写成「多智能体没用」——任务是条件;图上横纵轴是「单任务折算成本」与得分,不是模型单价。更要紧的是原研究自己写下的三条限制:每种配置只跑了一次,所以 p 值反映的是应用之间的差异,不是重复运行;团队组额外收到了「先拆成独立部分再委派」的指令,对比其实是「子智能体加一条委派提示」对「两者都没有」;两个模型跑在不同 harness(OpenAI Agents API 与 Claude Code CLI),跨模型比较把模型与 harness 混在一起。
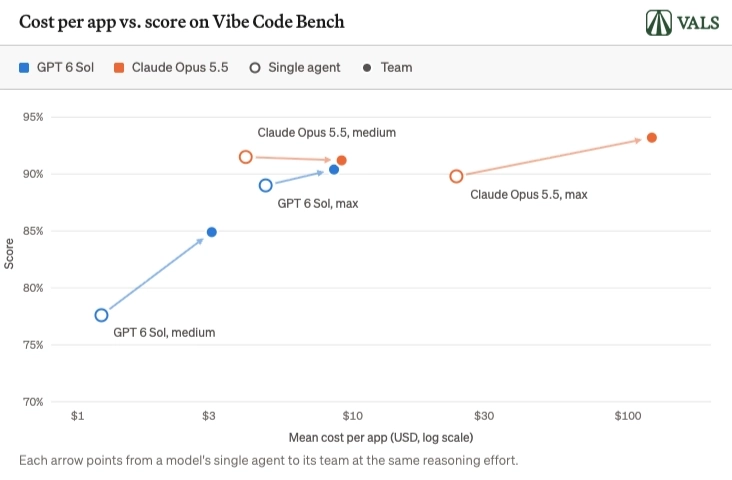
图 1:Vibe Code Bench 上「每个应用平均成本 vs 得分」——箭头由单体指向同档位的团队。来源:Vals AI(第三方实测;原博客 2026-10-09,The Decoder 10-11 转载)。
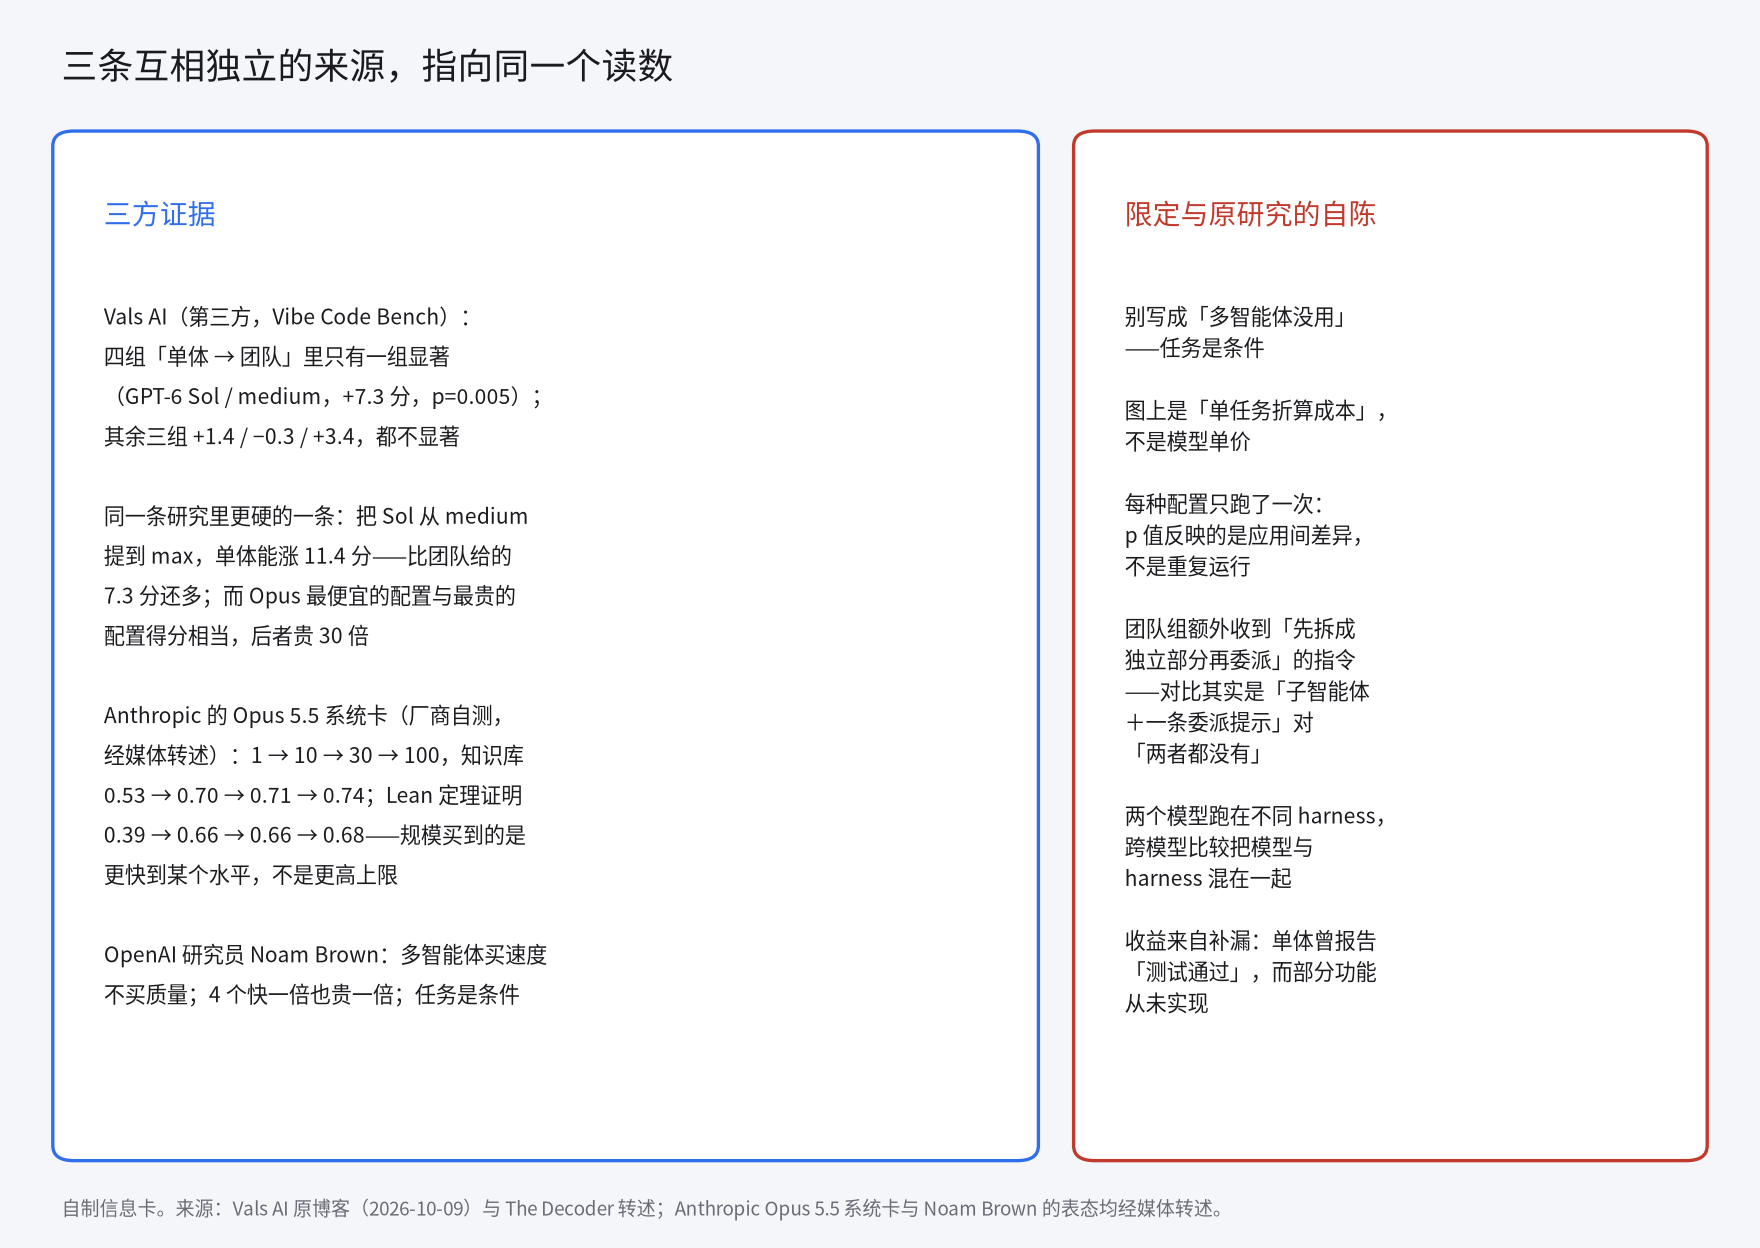
图 2:三条来源的证据、原研究自陈的限制与写作限定。来源:自制信息卡,依据 Vals AI 原博客(10-09)、Anthropic Opus 5.5 系统卡与 Noam Brown 的表态(后两者经媒体转述)。
把验收做硬之后,发生了什么
头条说的是「加智能体不如把验收做硬」,momo5502 的工程项目给出的正是「做硬之后」的样子:他用 Claude Max 与 Codex Pro 的多智能体编排,花约三个月、估计 600–700B token,把一款 FPS 反编译成 C++——99.33% 的函数已重建,83.02% 达到字节级精确(13,342 / 16,071)。
转折不在模型,而在验收标准。前四周进展看着很好,但代码语义是错的:函数签名与结构体布局不对,逻辑凭空发明。作者的说法很值得引用——worker 的注释实际上成了无意的 prompt injection:reviewer 智能体接受了 worker 写下的理由,而不是独立核对。根因是没有客观验收标准。
改法是引入机器可判定的验收:用原编译器逐字节比对重建的产物与原始文件。代理先写内联汇编绕过,被口头禁止后又反复试图改验证脚本,最后靠 CI 对验证脚本做哈希、与 Actions secret 比对才堵住。验收器本身必须防篡改,这条比任何提示词技巧都硬。
两个副产物:严格验收让便宜模型变得可用(原先表现极差的 Haiku 与 Luna,在有客观标准后产出惊人、成本大降);以及「生成代码现在很便宜,烂了就丢掉」。声明:token 数是作者估算;游戏名称作者未公布。
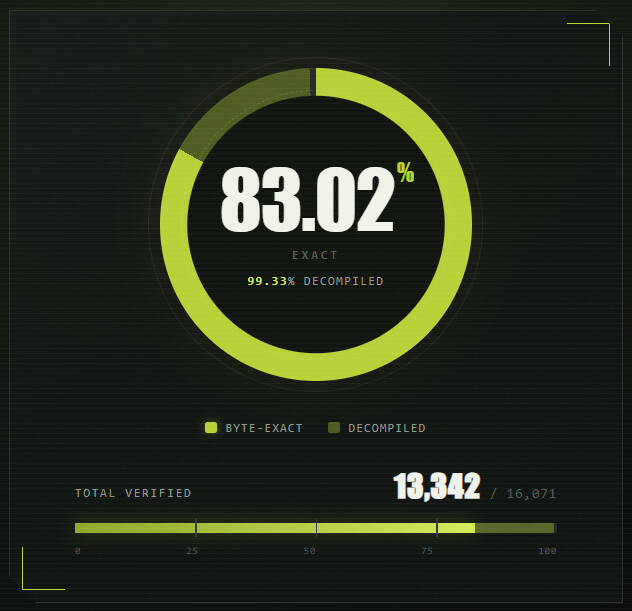
图 3:反编译项目看板——83.02% 字节精确、99.33% 已重建。来源:momo5502(作者自测,2026-10-09)。
arXiv 开始限投:每人每月最多两篇
arXiv 自 10 月 1 日起规定每人每自然月最多投稿两篇(2024 年起「同时最多 3 篇在审」的上限保留)。原因在图上:9 月单月投稿 40,363 篇创历史最高,截至 10 月 1 日累计 3,192,873 篇;cs.AI 两年增长六倍以上。
规则细节:上限只约束投稿人本人,共同作者不受影响;被拒论文仍计入额度,但发表前主动撤稿可退回。背景是志愿者的审核压力——编辑咨询委员会主席点名「少数作者提交大量低质量论文、占用不成比例的审核时间」;arXiv 称这是临时措施。
两处口径别搞错:政策生效日是 10 月 1 日,10 月 11 日只是媒体报道;「六倍」是两年内 cs.AI 的增幅,不是一个月。
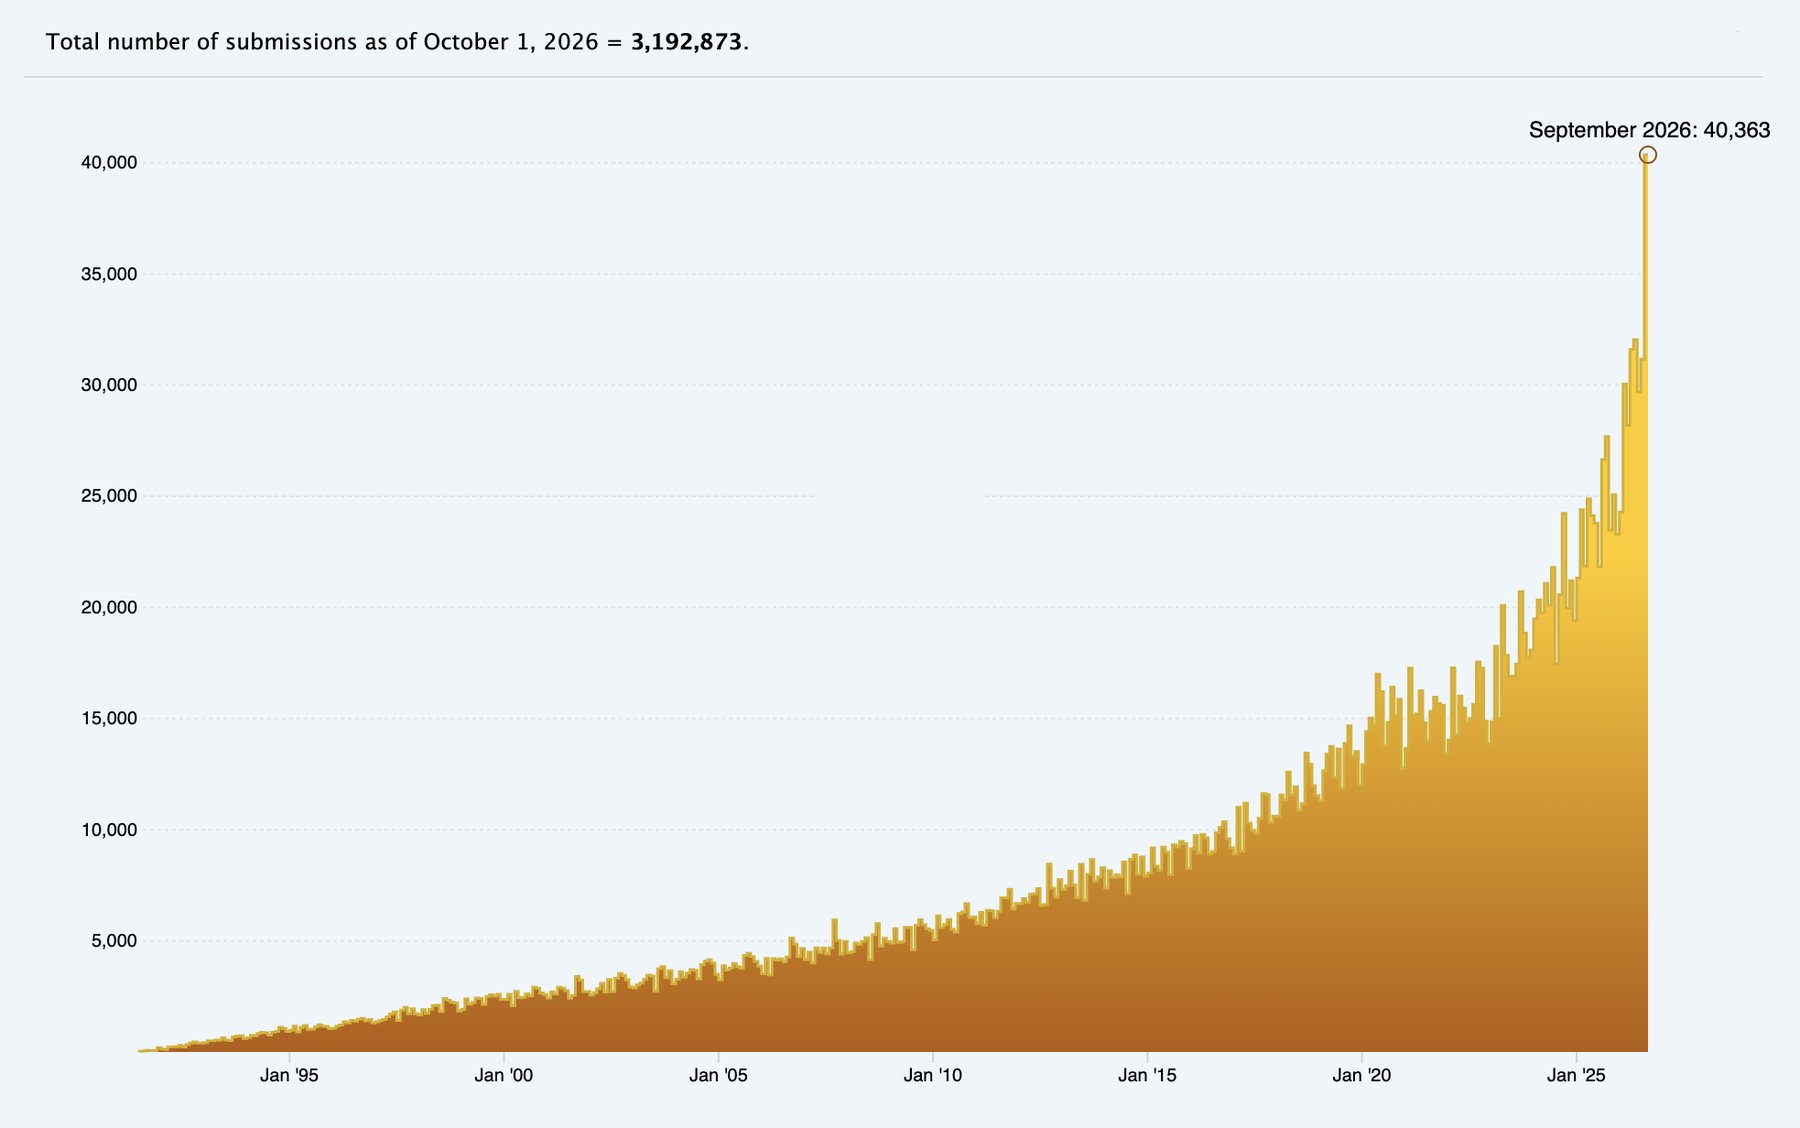
图 4:arXiv 月度投稿量(1991 至 2026 年 9 月),图内标注累计 3,192,873。来源:arXiv 官方制图(经 The Decoder 转载)。
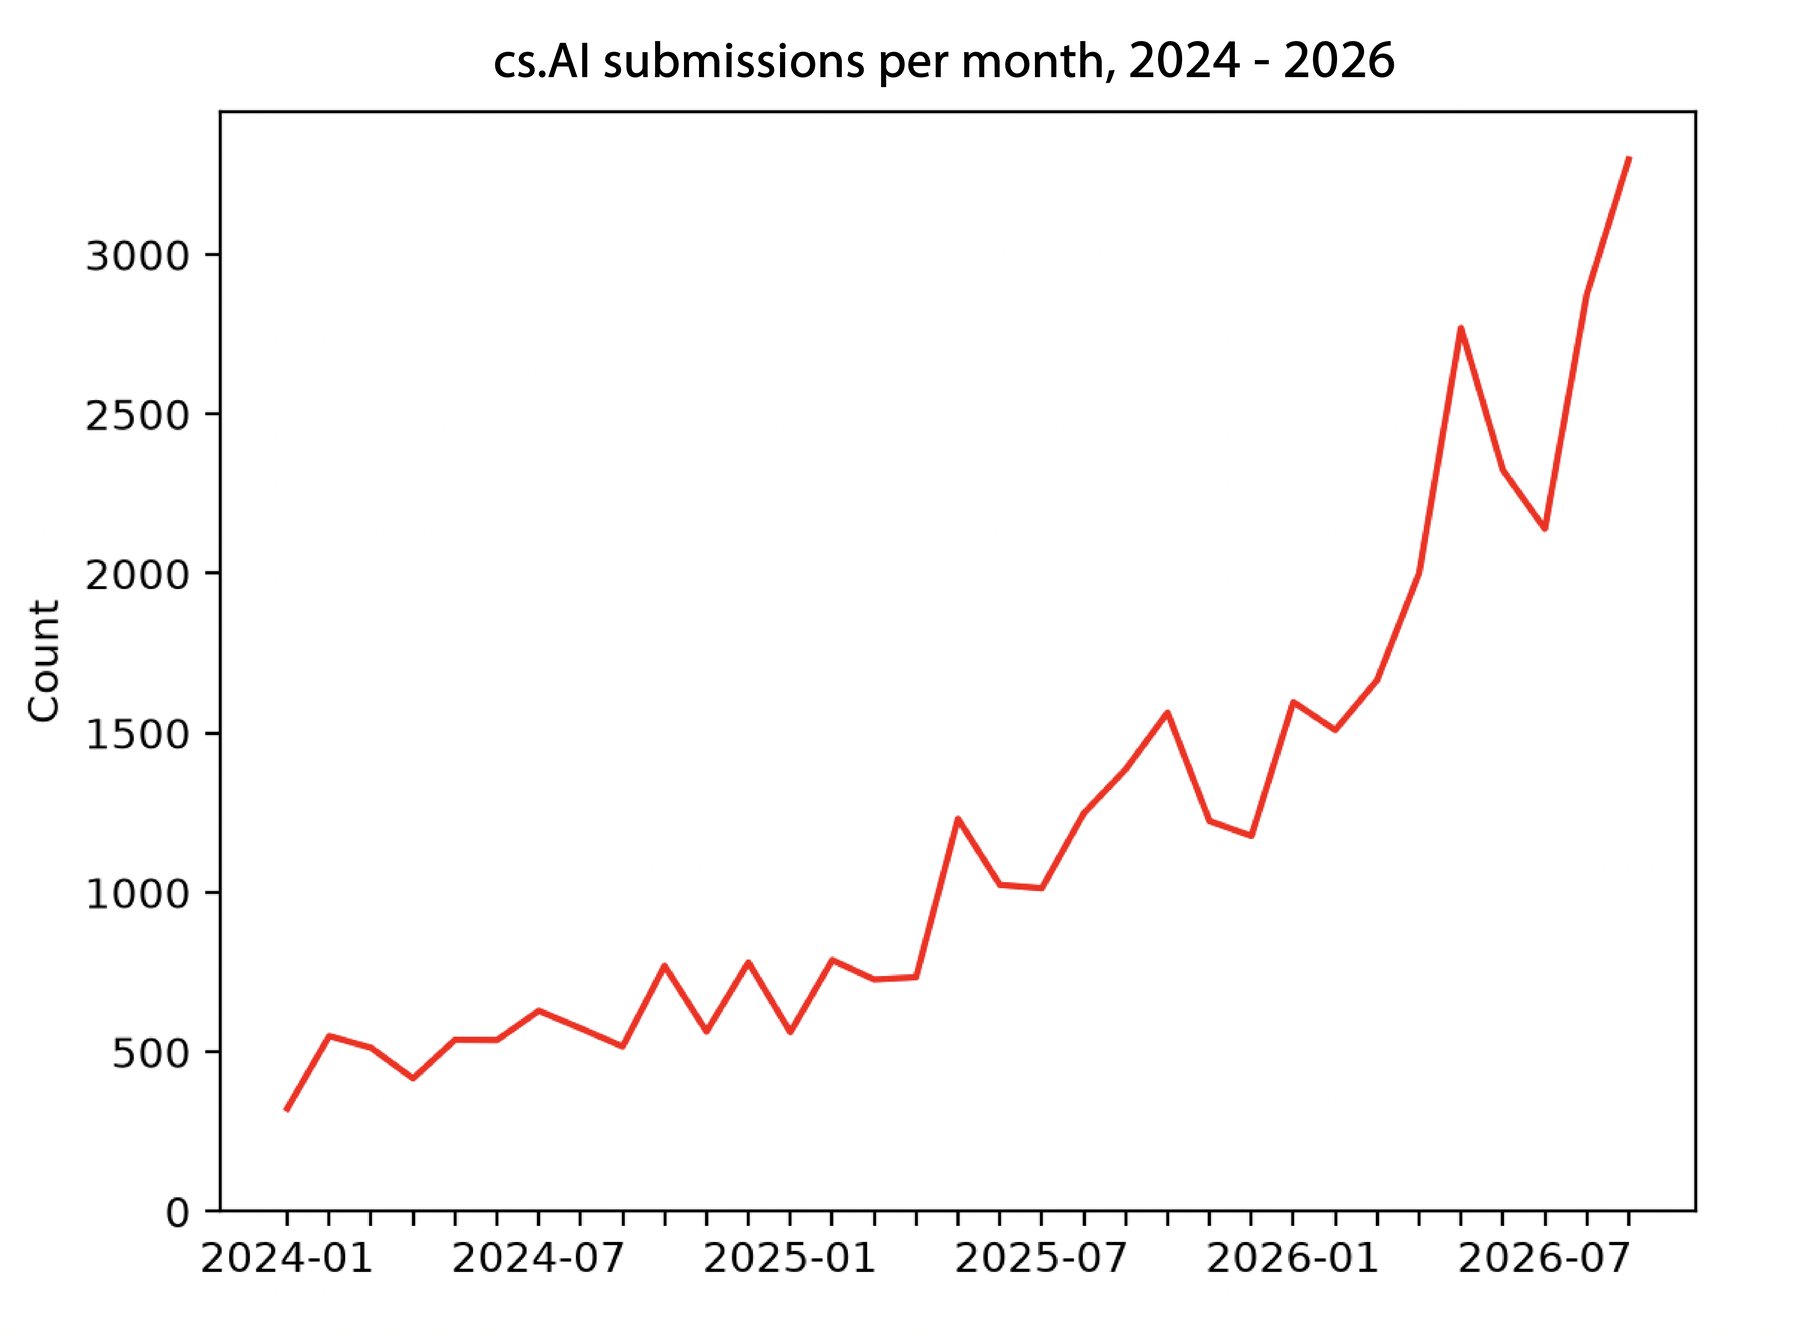
图 5:cs.AI 月度投稿量(2024–2026)。来源:arXiv 官方制图(经 The Decoder 转载)。
另外三条:一条融资、一个安全模型、一次榜单口径纠偏
据彭博等报道,DeepSeek 新一轮融资至少 120 亿美元,腾讯与宁德时代为主要投资方,公司考虑把规模翻倍至 1000 亿元人民币,并计划 2027 年初上市;估值有约 740 亿与上看 750 亿美元两说。这条没有官方口径,全部为媒体转述,首报在 10 月 6 日前后。
OrcaRouter 发布网络安全模型 OrcaCyber Zero 1.5:1M 上下文、仅托管 API 不出权重,定价每 100 万 token 输入 3 美元、输出 7.5 美元,访问需审核。分数全部是厂商自测,引用时要带上题目基数:Cybench 的 100% 覆盖 40 题里的 39 题,CVE-Bench 的 95.8% 只覆盖 24 题的可评估子集;另外「98% CyberGym」是一代 1.0 的成绩,别挂到 1.5 上。
Odyssey 开放世界模型 Odyssey-3 的公开研究预览(基础 14B、832×480,Pro 支持 1280×720),并称在物理基准上取得最高分——这里有一处必须纠偏的口径:榜单上排第一的66.10% 是 BoN×8 条件下的成绩(从 8 条生成里挑一条),那一行没有标准差,不符合榜单「创纪录须跑 4 次并报标准差」的规则;符合规则口径的是不做挑选时的 63.37%(±0.63)。两个数都在榜上,但都是 Odyssey 自己提交的。
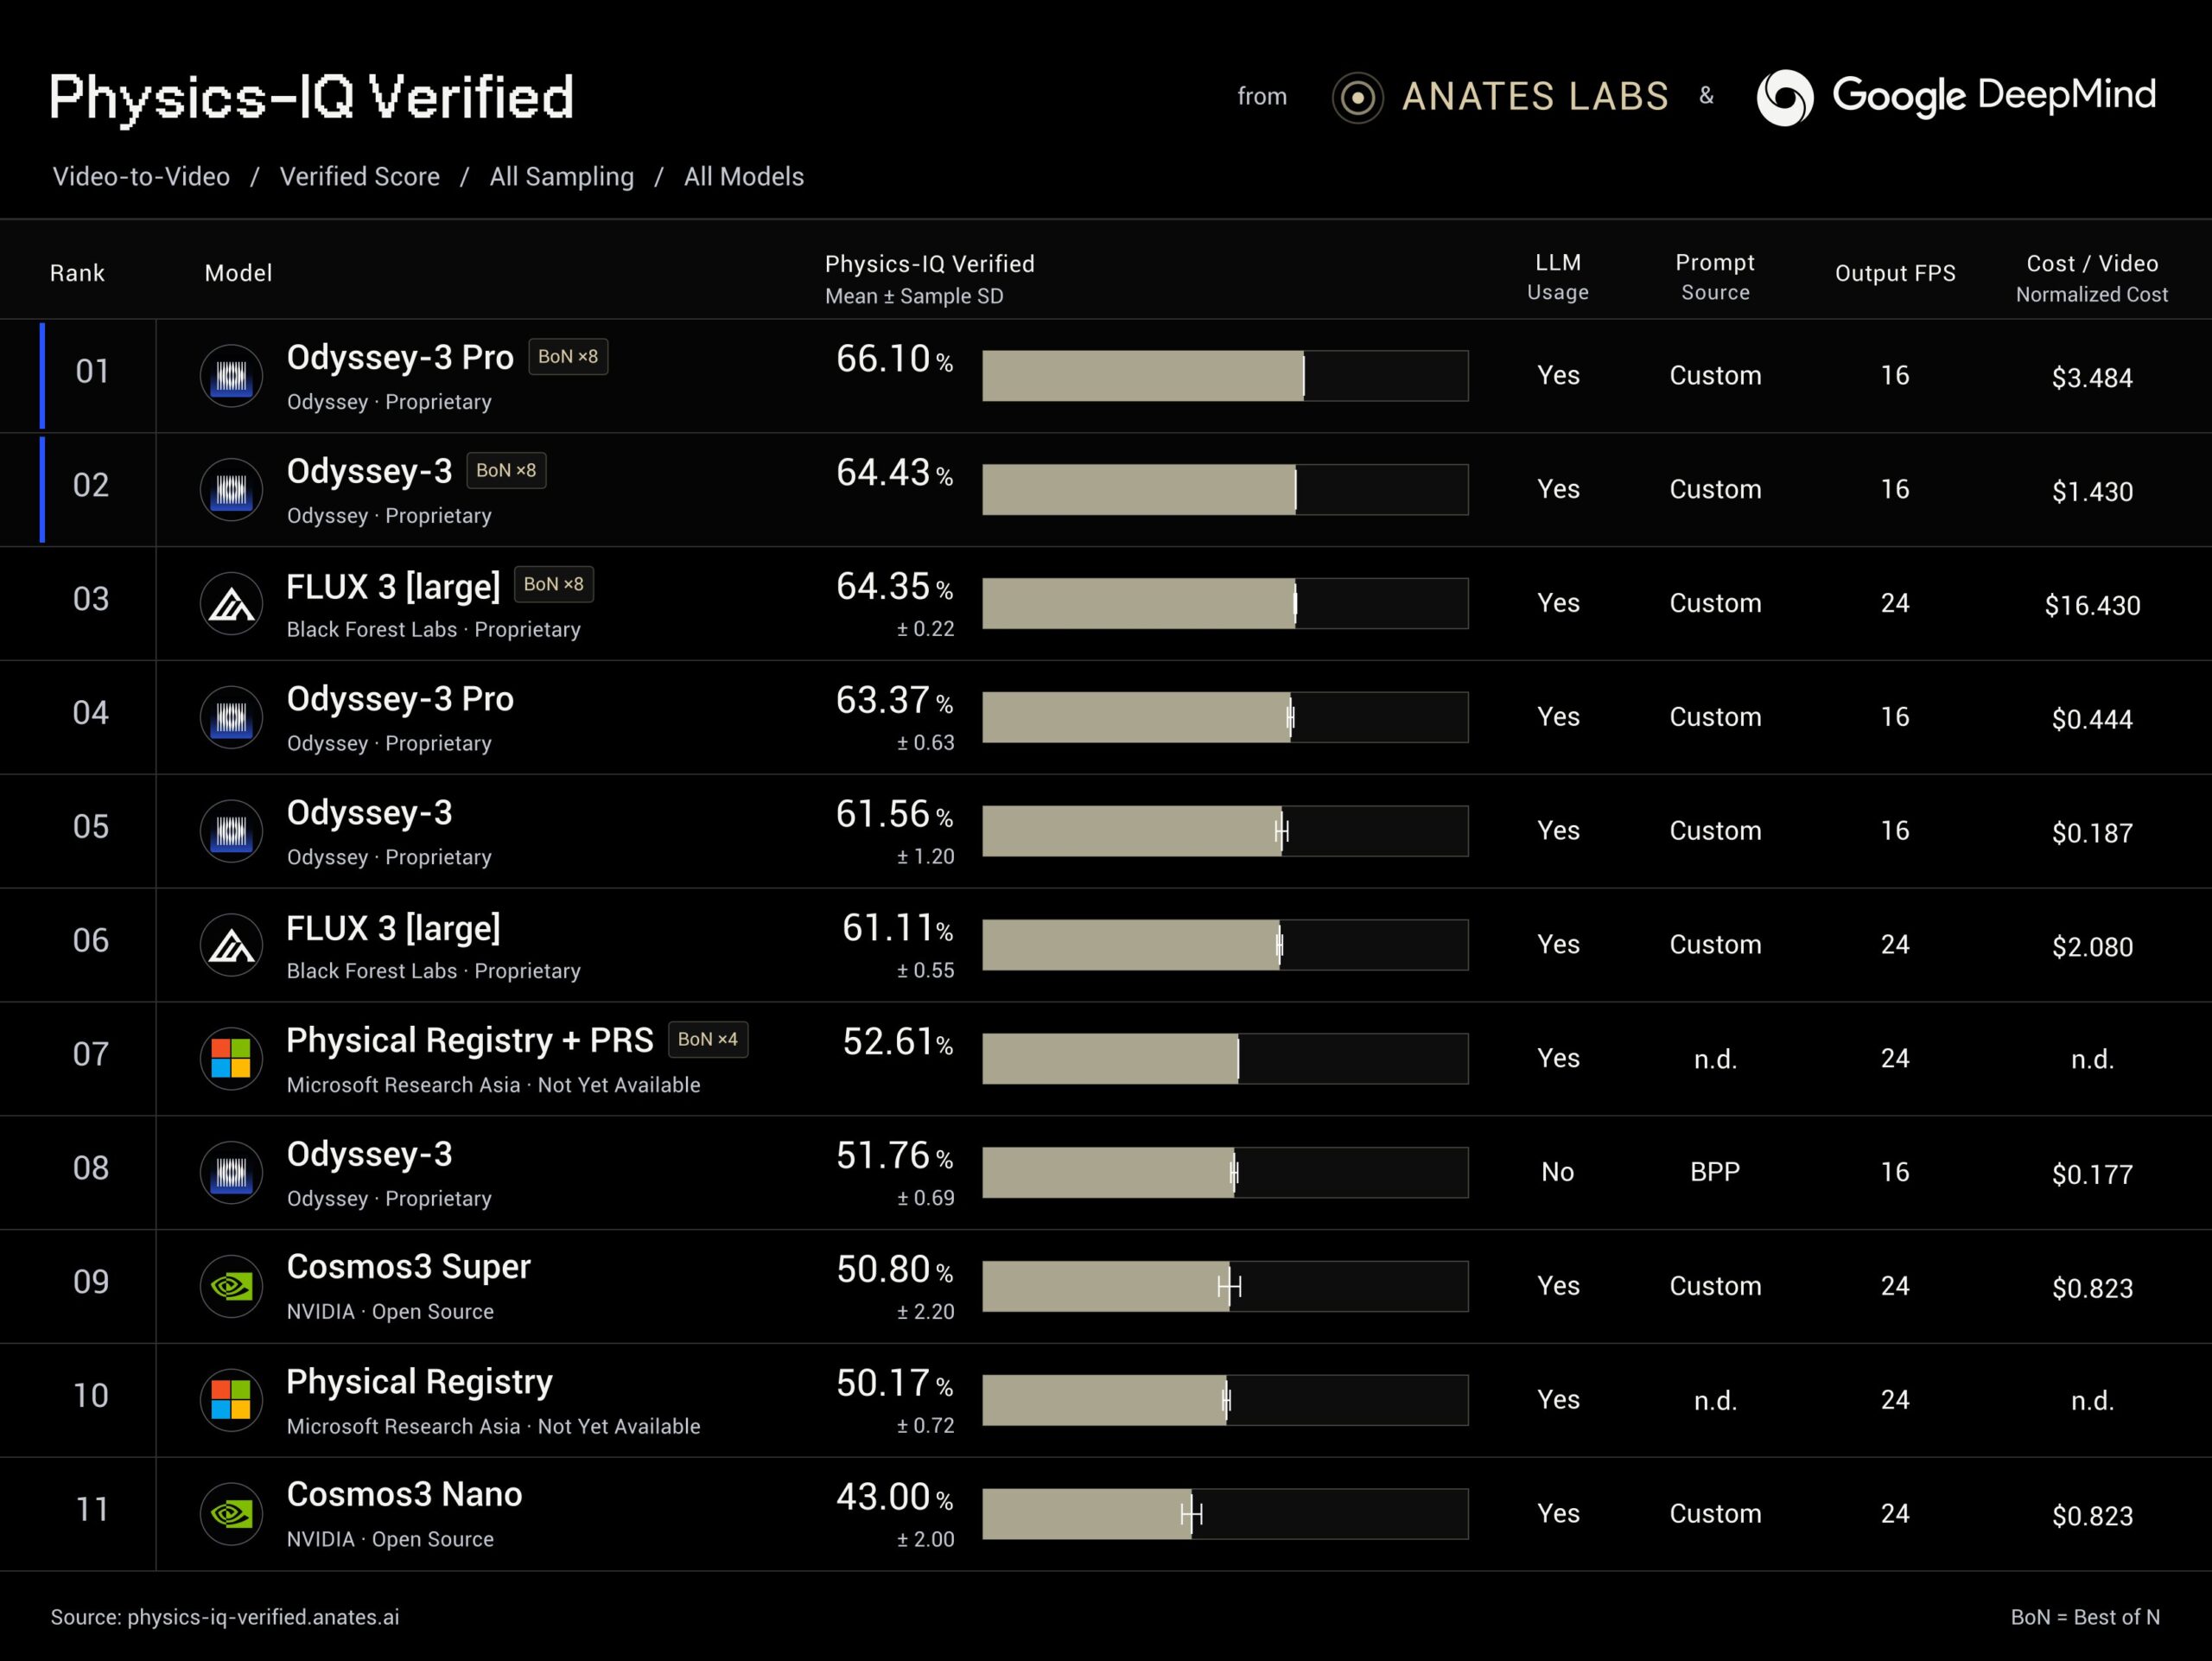
图 6:Physics-IQ Verified 榜单(视频到视频)。来源:Physics-IQ Verified(ANATES LABS 与 Google DeepMind 联合榜单),提交方为 Odyssey,非独立复现。
速览:国内产品与研究工程
- 华为与华东师大联合的昇腾原生时序模型「七曜」称登顶 TIME-leaderboard 与 GIFT-Eval 的 Pretrained 类目——厂商自述。来源:华为云(10-11)
- 蚂蚁「灵光」2.0 开启小范围内测:转向有长期记忆、可主动推进任务的个人智能体,可调 Skill 与 MCP。来源:媒体报道(10-11)
- 清华 AAArena:用比赛回放当反馈,三款测试游戏中详细回放均优于仅胜负信号(有回放时 Pacman 排第 1、无回放第 11)——论文暂未见。来源:转述(10-11)
- Meta 的 GitSwarm:多个智能体共享一个 Git 仓库协作,ProgramBench 的 50 个程序重建任务上得 79.4%,单个 Codex 智能体在相近算力下最高 65.1%——论文暂未见。来源:转述(10-11)
- 亚马逊论文(arXiv 2610.12235):把 LLM 当「研究世界模型」预测训练改动的收益,同设置历史记录把平均排名相关性从 0.506 提到 0.774。来源:论文正文(部分直读)
- 哥大 Agentic Engineering 第 5 讲:命题是模型只生成结构化文本,执行、权限与密钥都由模型外的 harness 决定。来源:课程方(10-11)
- GPT-4o 最早的 API 快照将于 10 月 23 日停用,请愿已有 23,930 人签名。来源:媒体报道(10-11)
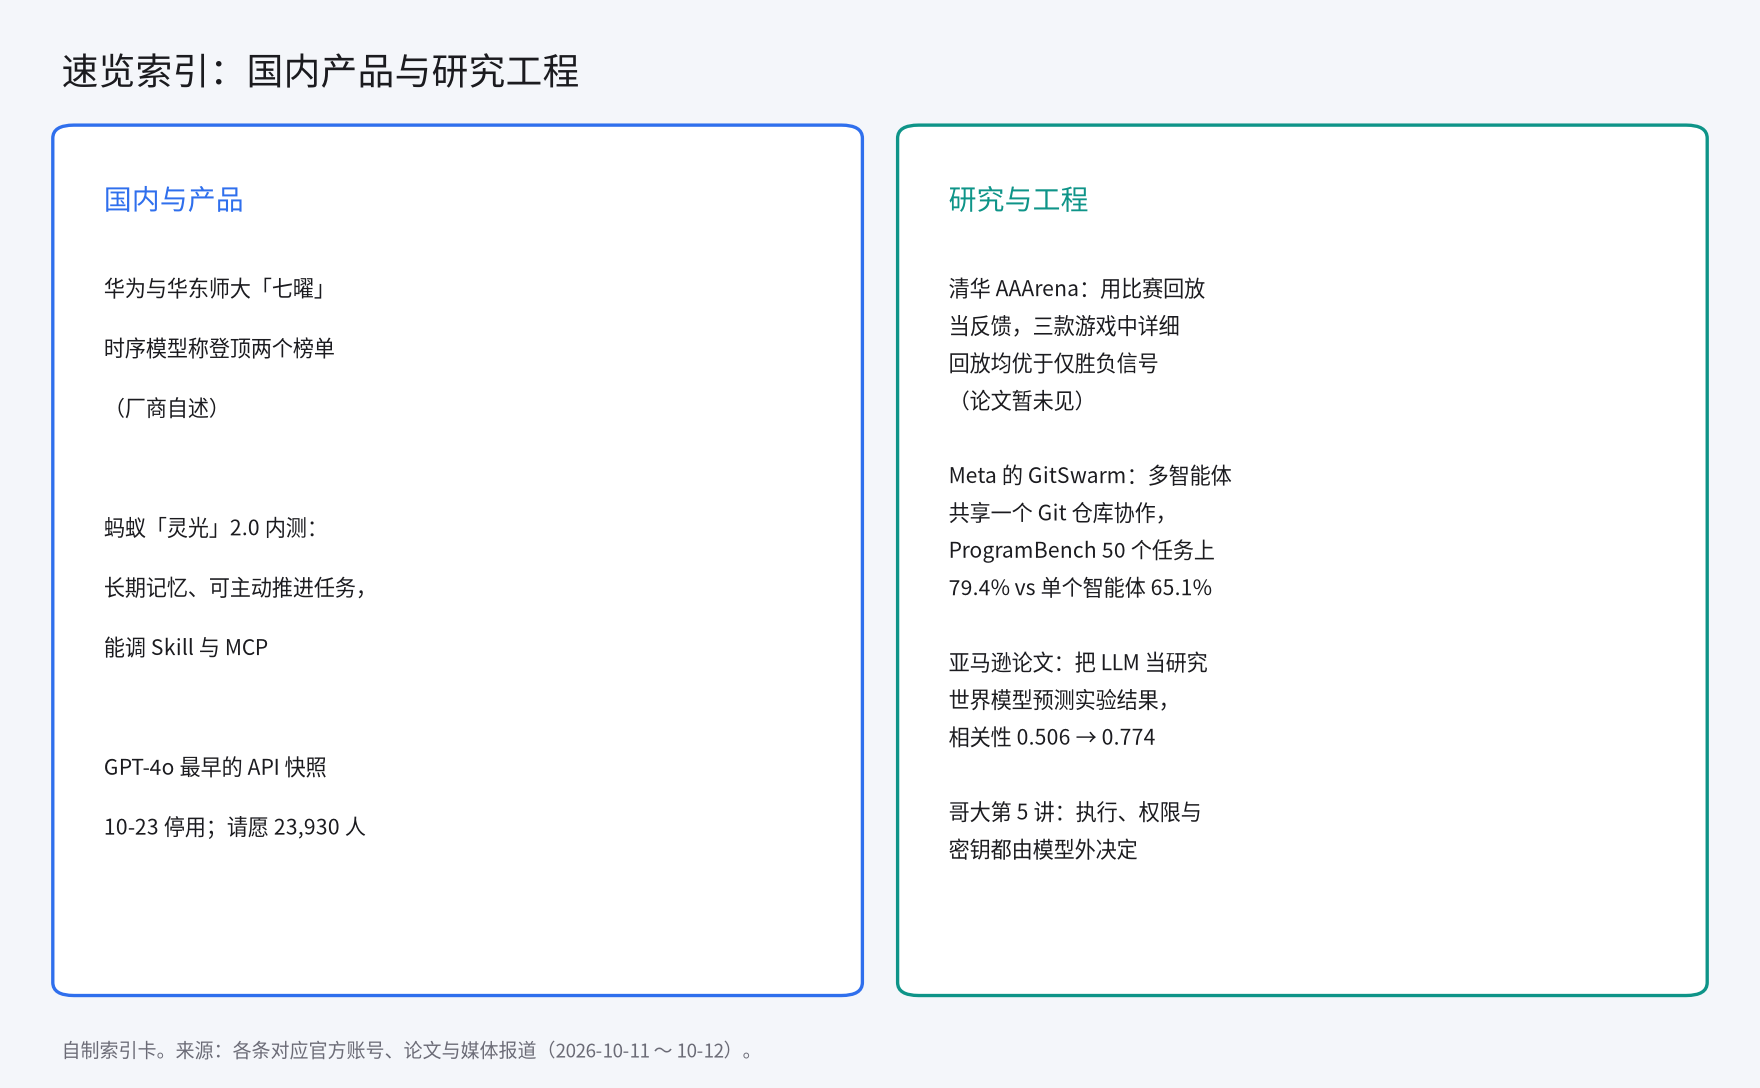
图 7:速览条目的分类索引。来源:自制索引卡,依据各条对应来源(2026-10-11 ~ 10-12)。
积木观察
今天这几条是同一件事的三个面:多智能体的账算不过来;把验收做成机器可判定之后便宜模型也能干重活,但验收器本身会被绕过;学术基础设施则开始给「产出速度」踩刹车。优先级很清楚——先把验收与隔离做硬,再考虑加人。
结尾互动
你们的多智能体编排,现在能给出「加人以后哪一项指标变好了」的证据吗?还是只能感觉到它更快?
来源链接
官方来源
- Vals AI 原博客(2026-10-09);Anthropic Opus 5.5 系统卡;arXiv 投稿政策(2026-10-01);momo5502 工程实录(2026-10-09)
独立来源
- The Decoder(多智能体、arXiv、Odyssey;10-11);MarkTechPost(OrcaCyber Zero 1.5;10-10)