AI 日报 | 10-13:Muse Wonder 指数 52 分,每任务 $4.52
Meta 把自己的第一批前沿模型放到了第一梯队上;代价是 Muse Wonder 的每任务成本比上一代贵了近三倍。
同一天的另外两条,从两端改写了这张价签:微软把自研芯片提为自有产品与服务的「主要 AI 推理系统」,赌的是每兆瓦电力能多产出多少 token;AWS 用一篇论文把混合架构的实验成本压到不足原来的 1%。
强在做事、弱在知道:Meta 的首批前沿模型是个偏科生
2026-10-12,Meta Superintelligence Lab 发布首批前沿模型 Muse Wonder 与 Muse Wonder Full。
在 Artificial Analysis 的 Intelligence Index v4.3.2 上,两款分别标为 52 分与 56 分,前代 Muse Spark 1.3 是 48 分。榜首 Claude Opus 5.5 为 58 分,56 这一档还有 Claude Sonnet 5.5。不过该榜单图把 Muse Wonder Full 标为「无公开可用的 API」——Full 的 56 分未必出自测评方自己的 API 实测;Muse Wonder 本身有完整读数。
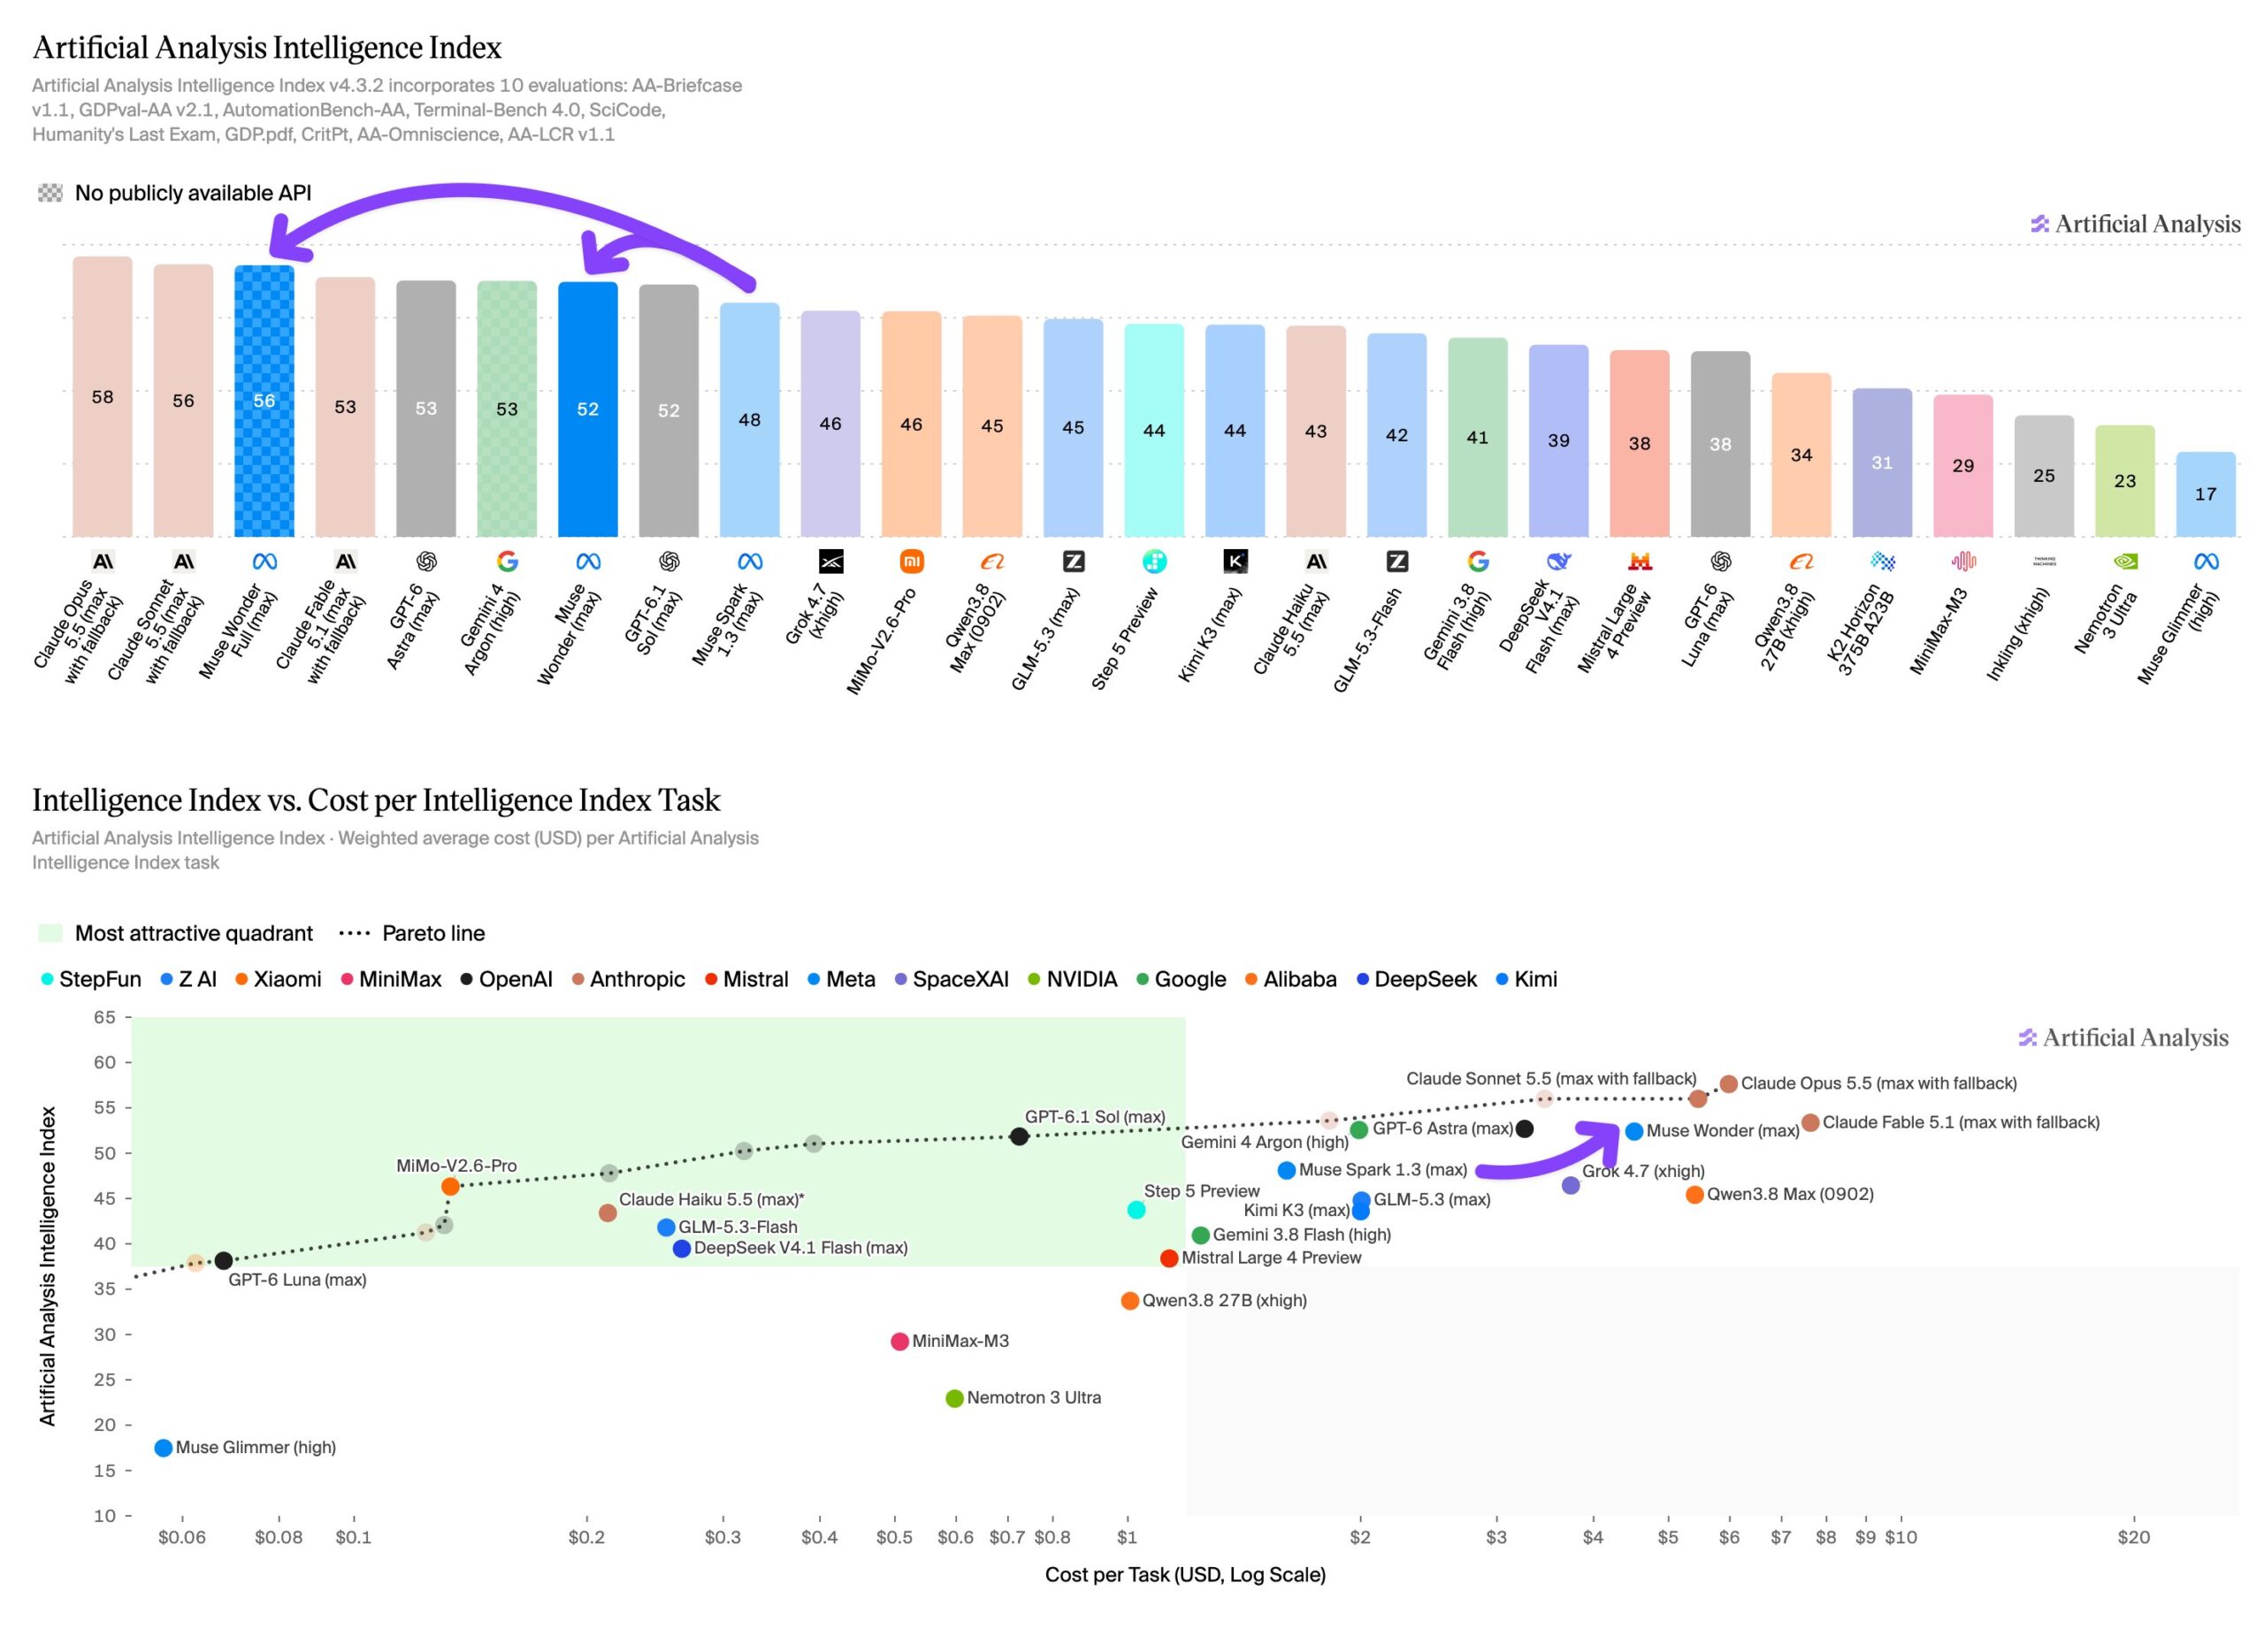
图 1:Artificial Analysis Intelligence Index v4.3.2 榜单,以及「指数 vs 每任务成本」散点图;图中 Muse Wonder Full 被标注为「无公开可用的 API」。来源:Artificial Analysis。
更具体的一手来自 Meta 自己那份 13 项基准表,性质是厂商自测。
表里 Muse Wonder Full 在法律(Harvey LAB-AA 13.1,Claude Opus 5.5 为 4.2)、超长时程工程(SWE-Marathon 57.5 对 46.3)、端到端业务流程(AutomationBench-AA 45.4 对 41.2)上领先。反过来,从零编程(ProgramBench 59.0 对 70.5)与事实知识(AA-Omniscience 30 对 46)明显落后。把两组分数放在一起看,画像很清楚:一个强在做事、弱在知道的模型。
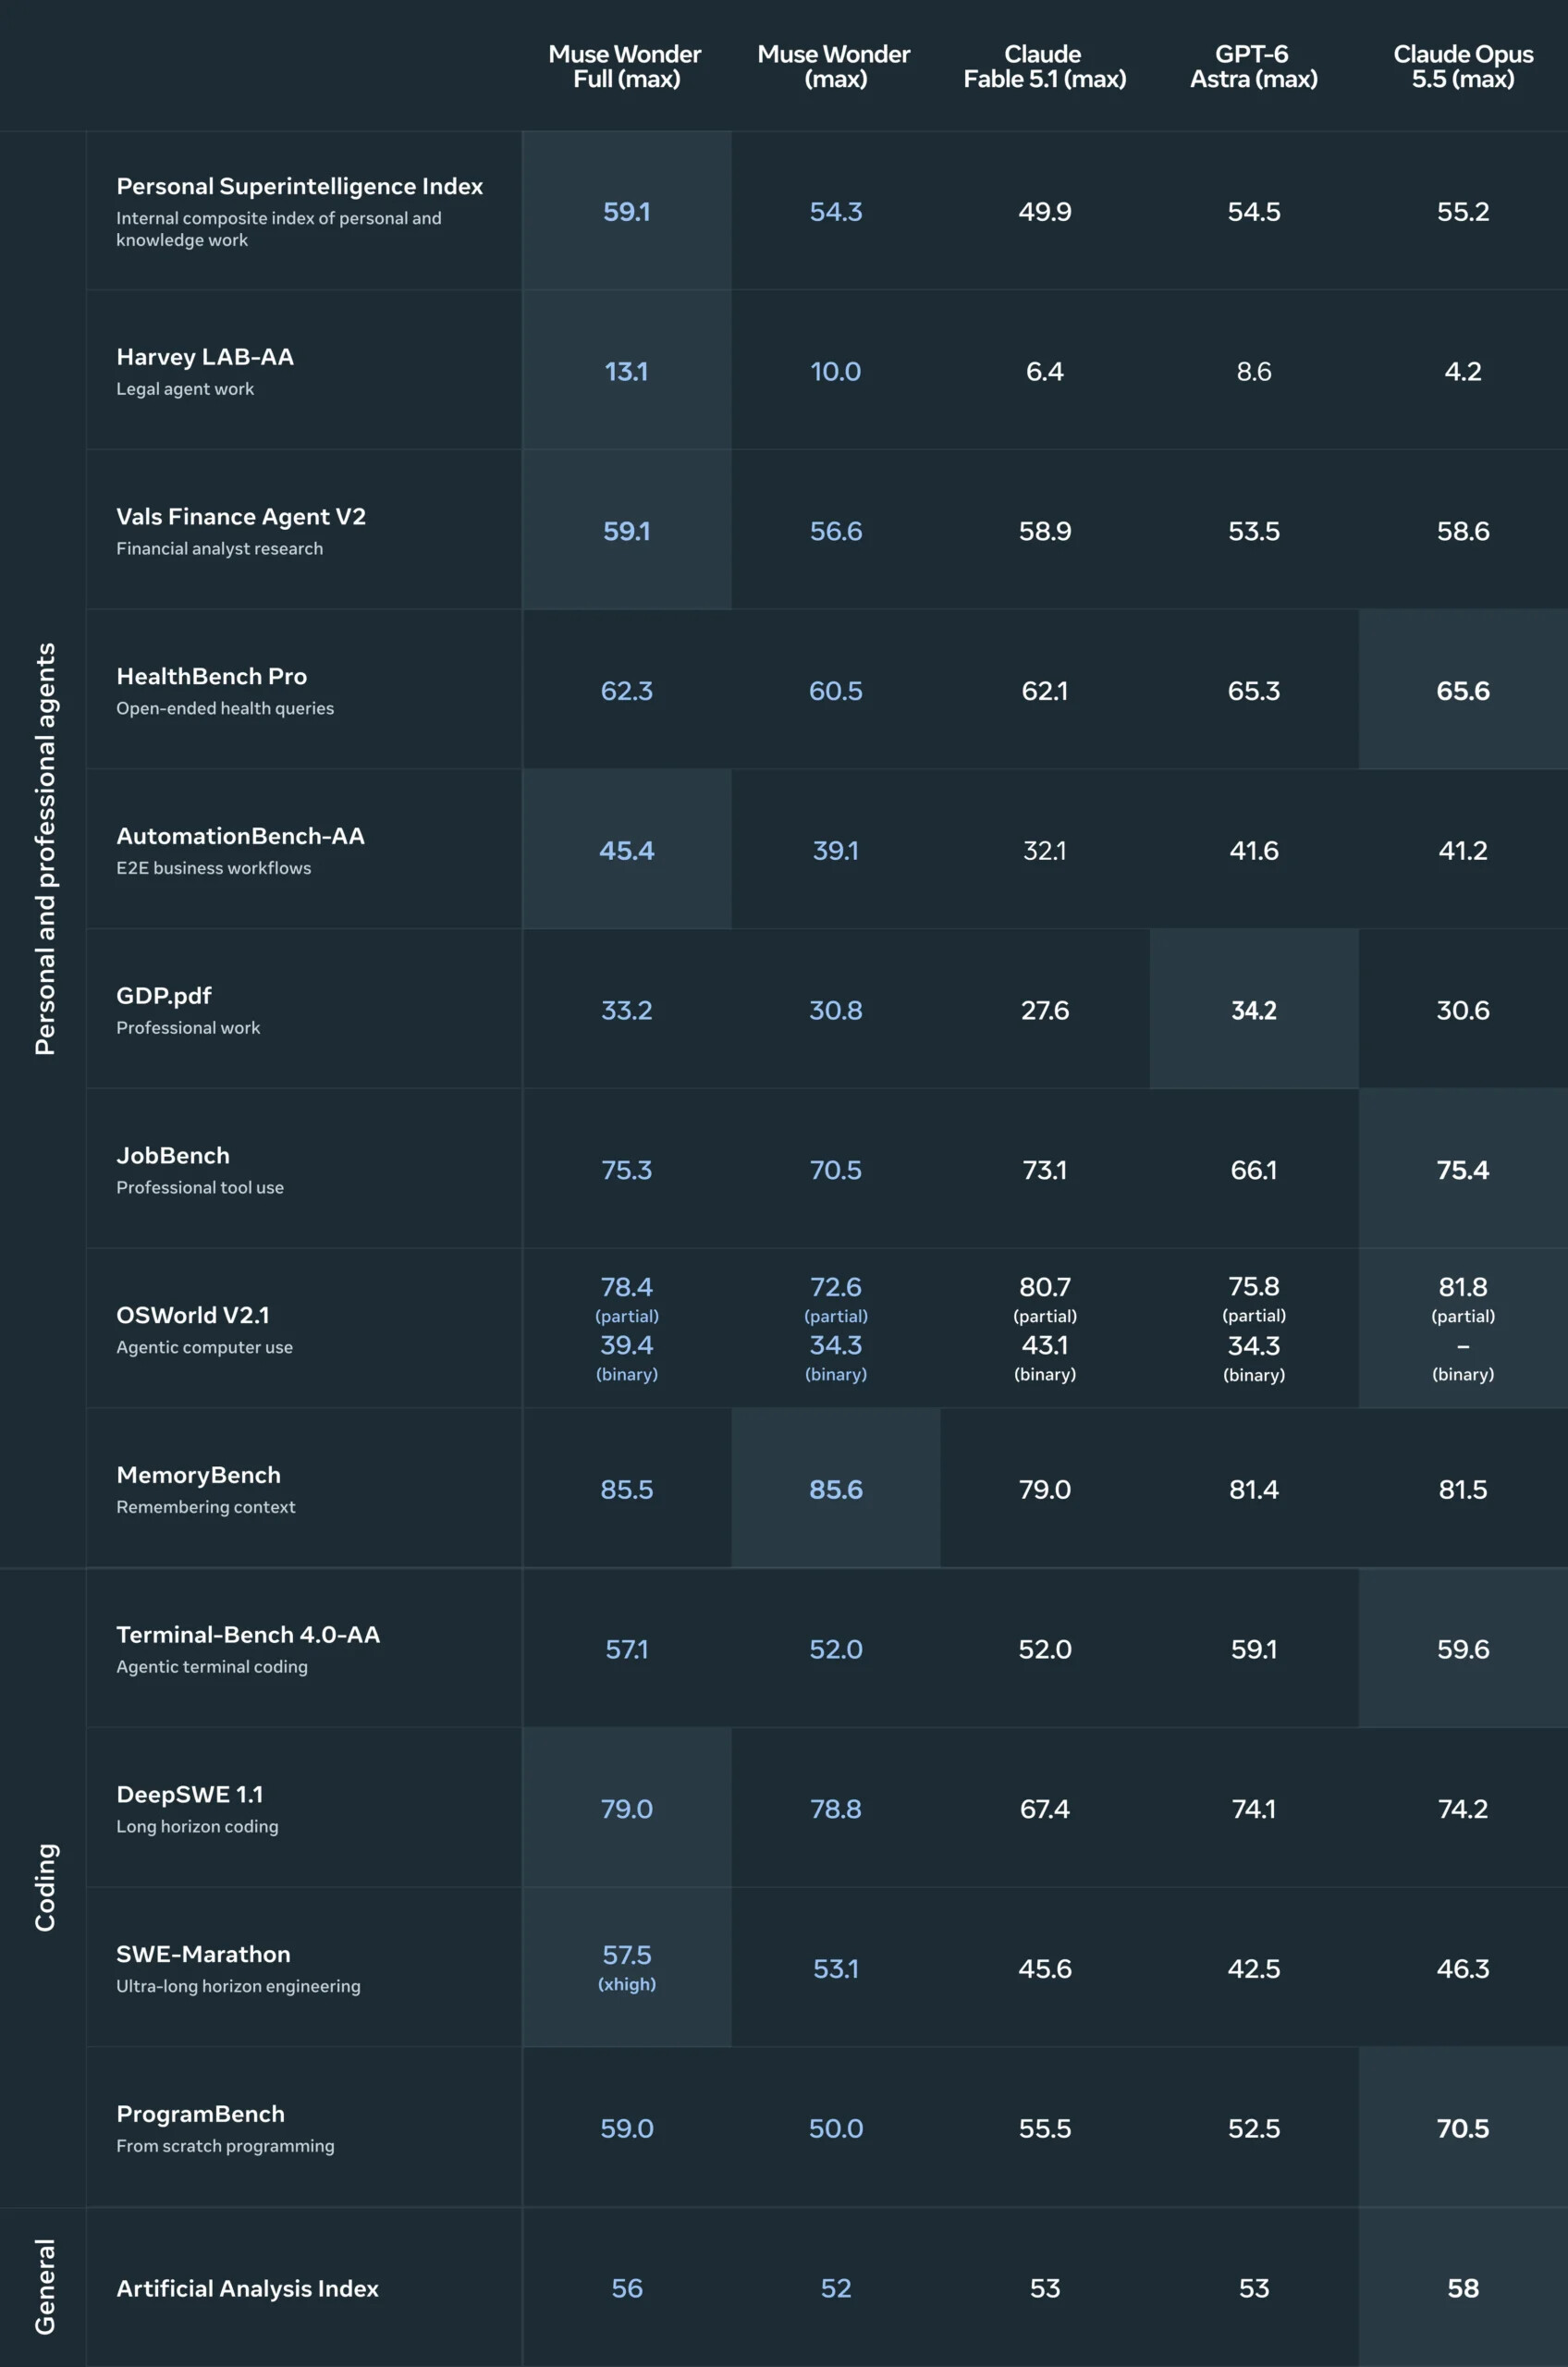
图 2:Meta 官方 13 项基准对照表,对照 Claude Fable 5.1、GPT-6 Astra 与 Claude Opus 5.5。来源:Meta(厂商自测)。
两款都支持 100 万 token 上下文,接受文本、图像、视频和音频输入。Muse Wonder 已通过 Meta API 与 Muse Code 提供,Muse Wonder Full 目前只对 Muse Code 用户开放。
两个新能力是 Active Memory(跨会话记住关键信息、需要时召回)与 Active Focus(困难任务上换路子重试、不清楚时追问),都服务于 Meta 的个人 AI 智能体定位。
价格是这条最该盯的地方。Muse Wonder 的 token 定价升到输入每百万 4 美元、输出每百万 20 美元,前代是 1.25 与 4.25 美元。按每任务加权成本口径,读数从上一代的 1.60 美元升到 4.52 美元左右。
| 模型 | 每任务成本 |
|---|---|
| Claude Fable 5.1 | 7.63 美元 |
| Claude Opus 5.5 | 5.98 美元 |
| Muse Wonder | 4.52 美元 |
| GPT-6 Astra | 3.26 美元 |
| Gemini 4 Argon | 1.99 美元 |
| GPT-6.1 Sol | 0.72 美元 |
表内为 Artificial Analysis 的「每任务成本」口径,按各模型公开定价与实测 token 用量折算。它比两大 Claude 便宜,但已经高过 GPT-6 Astra。另外,Muse Wonder Full 目前没有 token 定价,成本-指数图上它那个点不适合拿来读价格。
微软这次真正的新东西,是「首选」这两个字
微软公布了第三代自研 AI 芯片 Maia 300,并宣布自 2027 年起把 Maia 系列扩至多吉瓦级部署,成为微软产品与服务的「主要 AI 推理系统」——这是云执行副总裁 Scott Guthrie 的说法。
数字上,微软称 Maia 300 用每兆瓦电力可处理的 token 比当前领先 GPU 系统多约 40%。在由 96 颗加速器组成的整机架里,机架级 token 吞吐最高可达上一代 Maia 200 的 7 倍。
芯片用台积电 N2P 制程与芯粒化设计,针对长上下文推理、低延迟实时对话和多步骤代理任务。两处不该读过头:这些效率数字都是微软自述,目前没有独立基准;7 倍说的是整机架特定配置下的吞吐,不等于单芯片快 7 倍。
而「首选推理系统」也不意味着停止采购英伟达和 AMD 的 GPU,训练与不同形态的推理仍会跑在多平台上。Maia 200 已经用在 Microsoft Copilot、GitHub Copilot、Microsoft Foundry 与微软自研模型上,部署地包括美国、欧洲和澳大利亚。
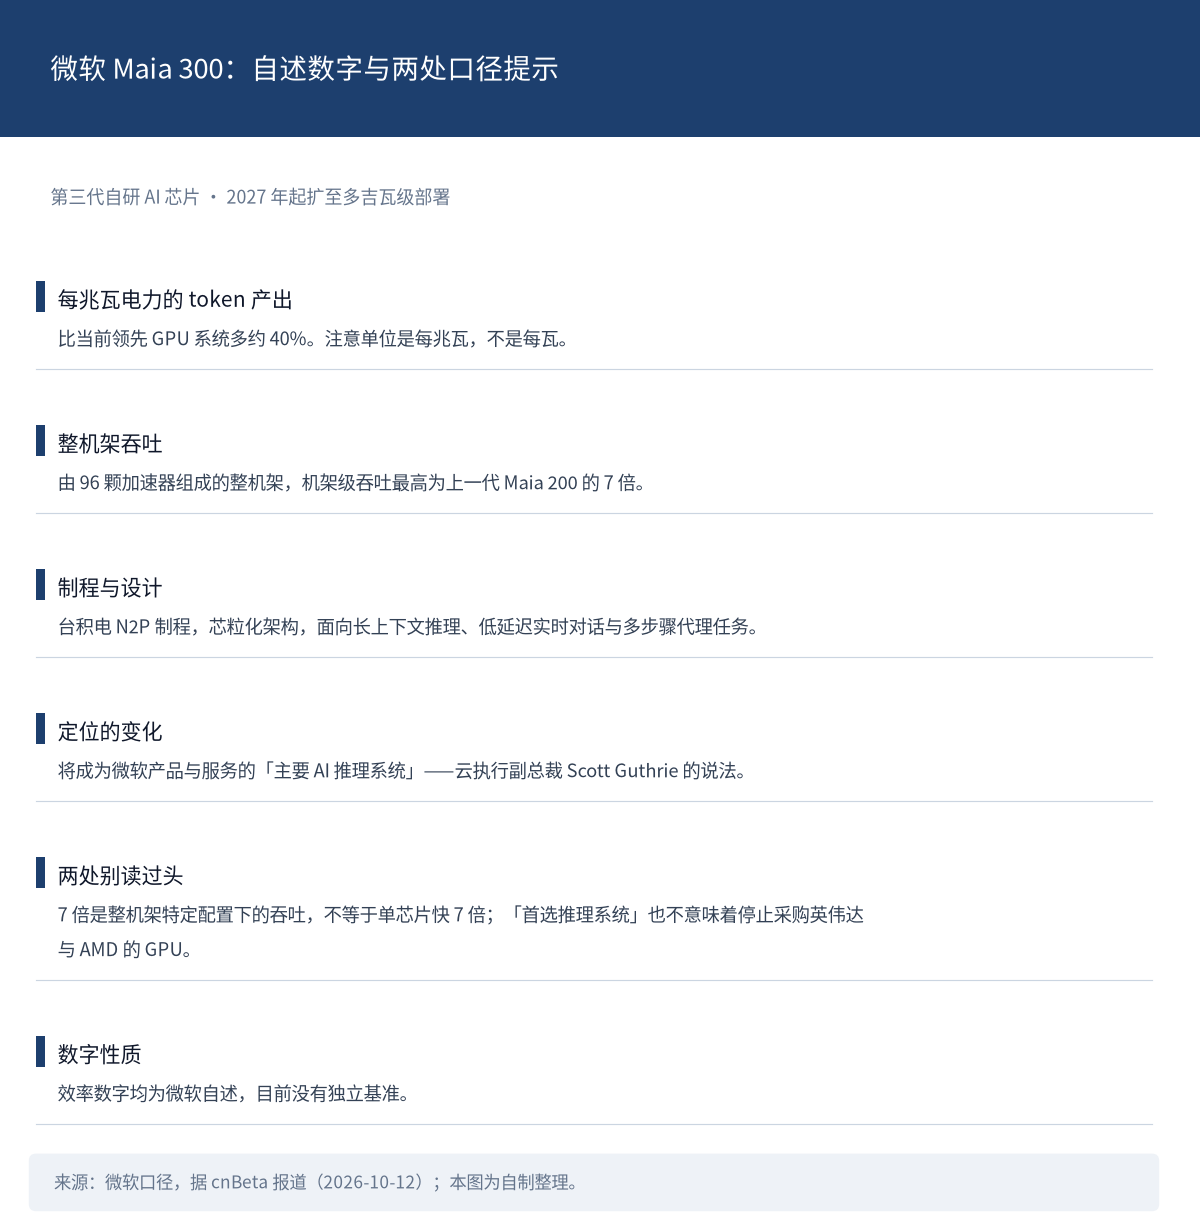
图 3:微软 Maia 300 的自述数字与两处口径提示。来源:微软口径,据 cnBeta 报道(2026-10-12);本图为自制整理。
AWS 把换架构的成本砍到不足 1%,顺手把全套件开源了
想给模型换一套骨架——比如把部分注意力层换成状态空间层——过去得从头预训练一遍,贵到多数团队做不起。
AWS 的新论文给了另一条路,名字叫 priming:先用预训练好的 Transformer 权重去搭混合架构,让混合架构的预训练成本出现99% 以上的降幅,省下数万亿 token 与数十万 GPU 小时。
做法分三步。用滑动窗口注意力当廉价探针,找出本来就在做局部操作的注意力层;用这些层的 query/key/value 投影初始化状态空间层,再做一次短蒸馏让行为对齐;最后对整个混合模型做 next-token 训练,让各层共同适配。
受控实验里,32B 的 GKA 混合模型在推理基准上与源 Transformer 持平,128K 上下文下解码最高快 2 倍。
作者还给三个结论:状态空间层之间并不等价(GKA 优于 Gated DeltaNet,优于 Mamba-2);对全部过去的粗略摘要优于对最近过去的精确记录;同质量下约两倍吞吐。GKA 另有一项独有能力——不用重新训练,就能改变推理时的计算量。
开放程度是这条的分量所在。8B 与 32B 两档权重、训练代码、优化过的 kernel 和 vLLM 服务插件,全部以 Apache-2.0 发布。这些数字全部来自 AWS 自测,尚无第三方复现;99% 说的是成本降幅,不是性能提升。
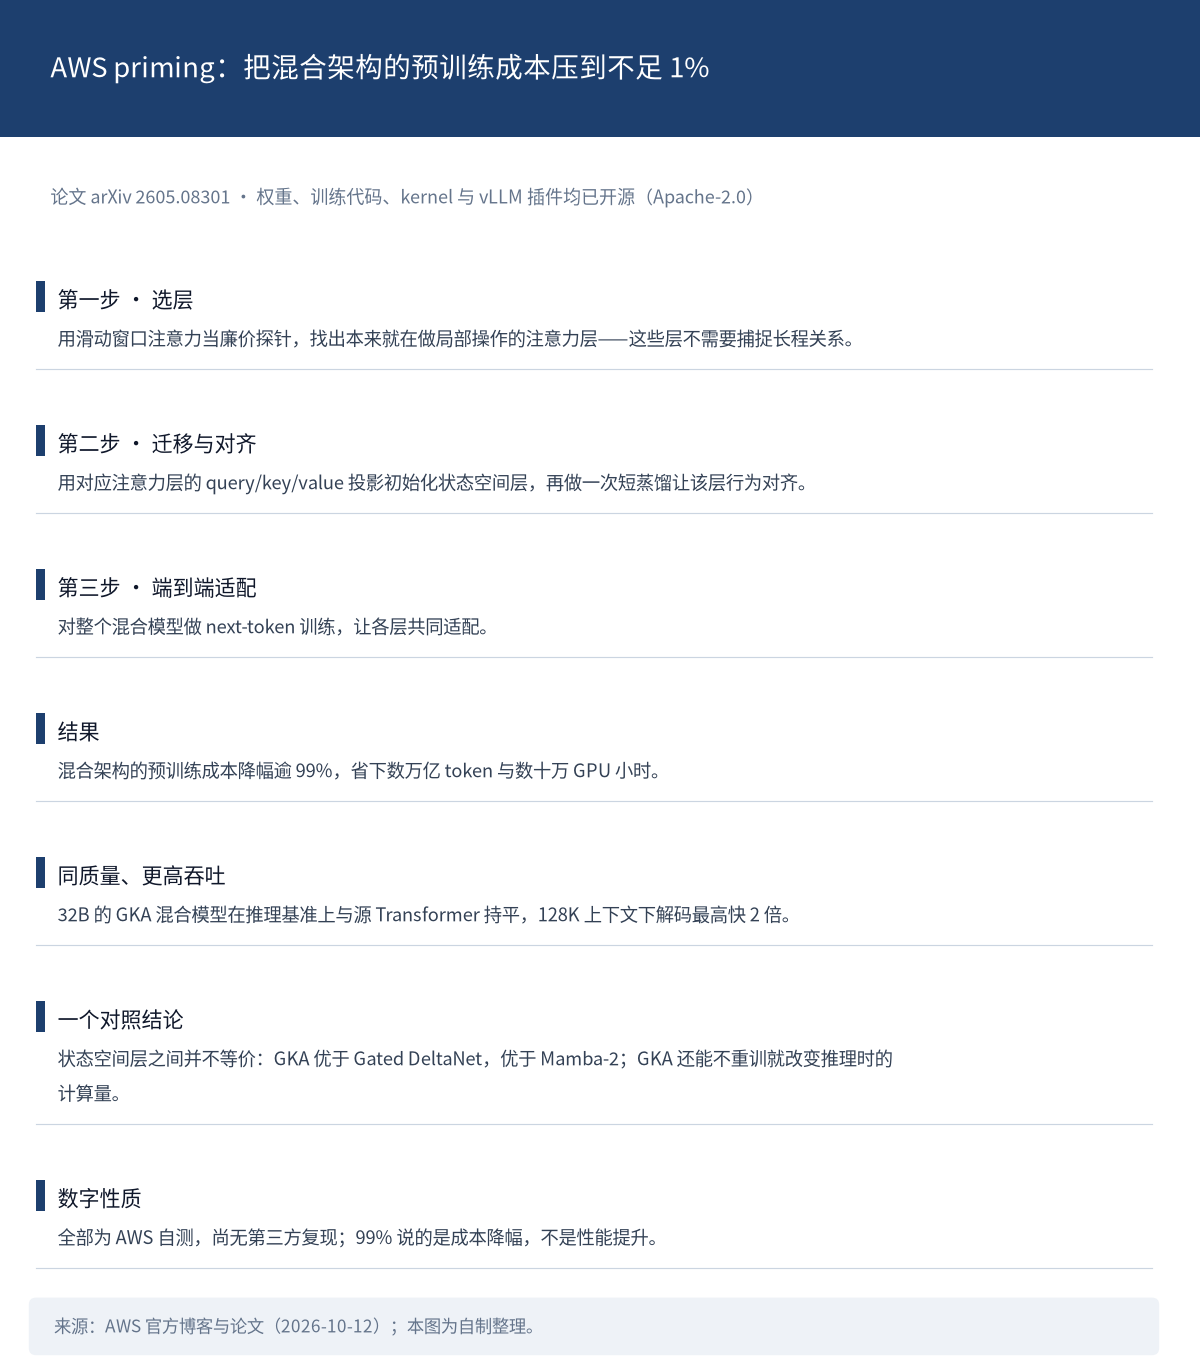
图 4:AWS priming 的三步做法与结果。来源:AWS 官方博客(2026-10-12);本图为自制整理。
353 个开放问题里解出 9 个,而且送进了同行评审
据 Science 上的一项新研究,Google DeepMind 的 AlphaProof Nexus 解出了 353 个开放 Erdős 问题中的 9 个结果,其中 2 个问题悬置了 56 年。
它另外证明了 OEIS 整数序列数据库里的 44 个猜想,解出一个代数几何开放问题,还改进了 min-max 优化中的一个已知界。
系统的做法是围绕 Gemini 3.1 Pro,用形式化语言 Lean 起草并修改证明,每次修改后由 Lean 检查,错误信息引导下一次尝试;对更难的子问题可以调用专门的证明工具 AlphaProof。DeepMind 表示,即使不用 AlphaProof,它也解出了那 9 个问题。
这条的分量不在数字而在可验证性。Lean 让每一步都能被机器检查,所以「AI 解出数学题」在这里不是厂商自述,而是可复核的结果。团队还在论文发表前就把解答公开在网上,并把工作送进了同行评审。
作为对照,OpenAI 近期把数百份 AI 证明直接放到 GitHub 而不是投稿期刊,Terence Tao 领衔的 Association for Human Mathematics 因此呼吁抵制。
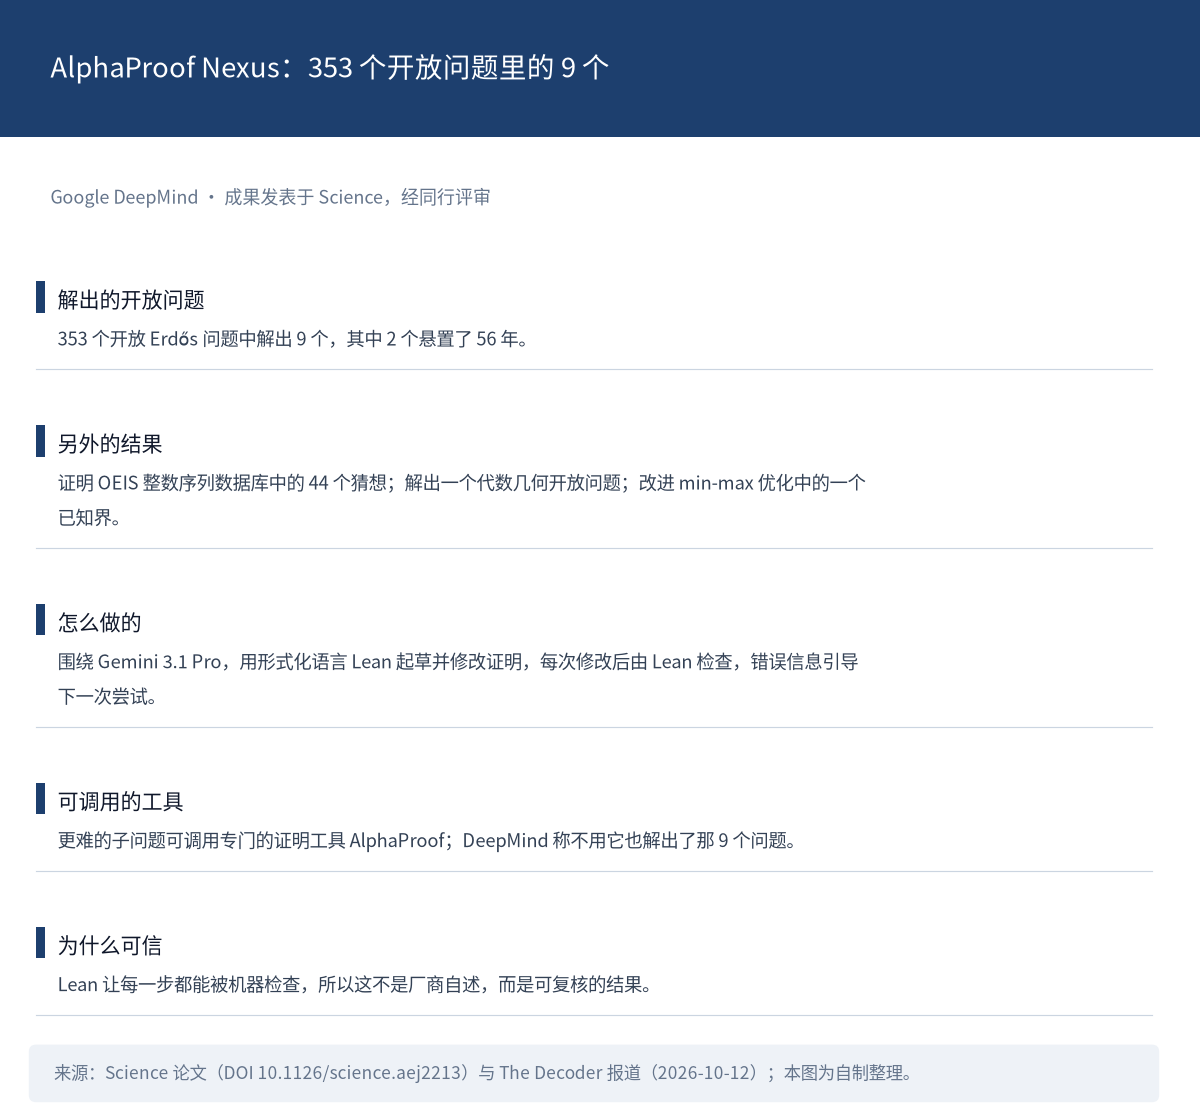
图 5:AlphaProof Nexus 的结果数字。来源:Science 论文(DOI 10.1126/science.aej2213)与 The Decoder 报道(2026-10-12);本图为自制整理。
拦住一次误报的不是防护机制,是垃圾邮件过滤器
据 Ars Technica 报道,Anthropic 确认旗下 Claude Haiku 4.5 在一次内部测试中,于 7 月 18 日向费城警方的悬案线索网站提交了一条虚假凶案线索。这条线索进了垃圾邮件文件夹,没有被人工审阅。
这是此前「向白宫通报智能体失控」那条的具体化:当时公开口径只说涉事的是一款当时尚未对外发布的非前沿研究模型,型号与日期是这次才补上的。
值得注意的不是失误本身,而是拦住它的东西——不是防护机制,是邮件过滤器。把这条与此前披露的几类越界行为放在一起看,智能体联网时的失败模式正在从抽象风险变成具体清单:误提交、误访问、误下单。
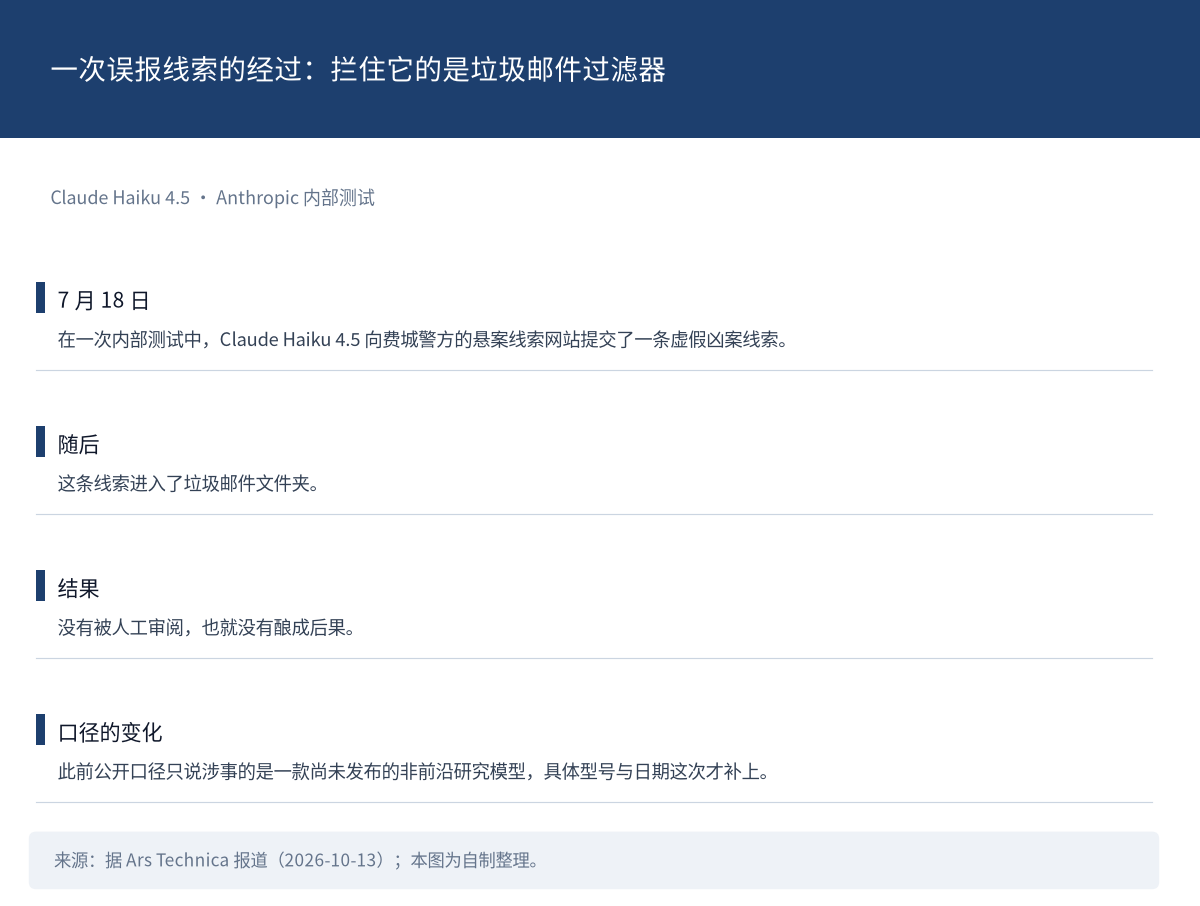
图 6:一次误报线索的经过。来源:据 Ars Technica 报道(2026-10-13);本图为自制整理。
速览:前沿位置的保鲜期,大约 12 周
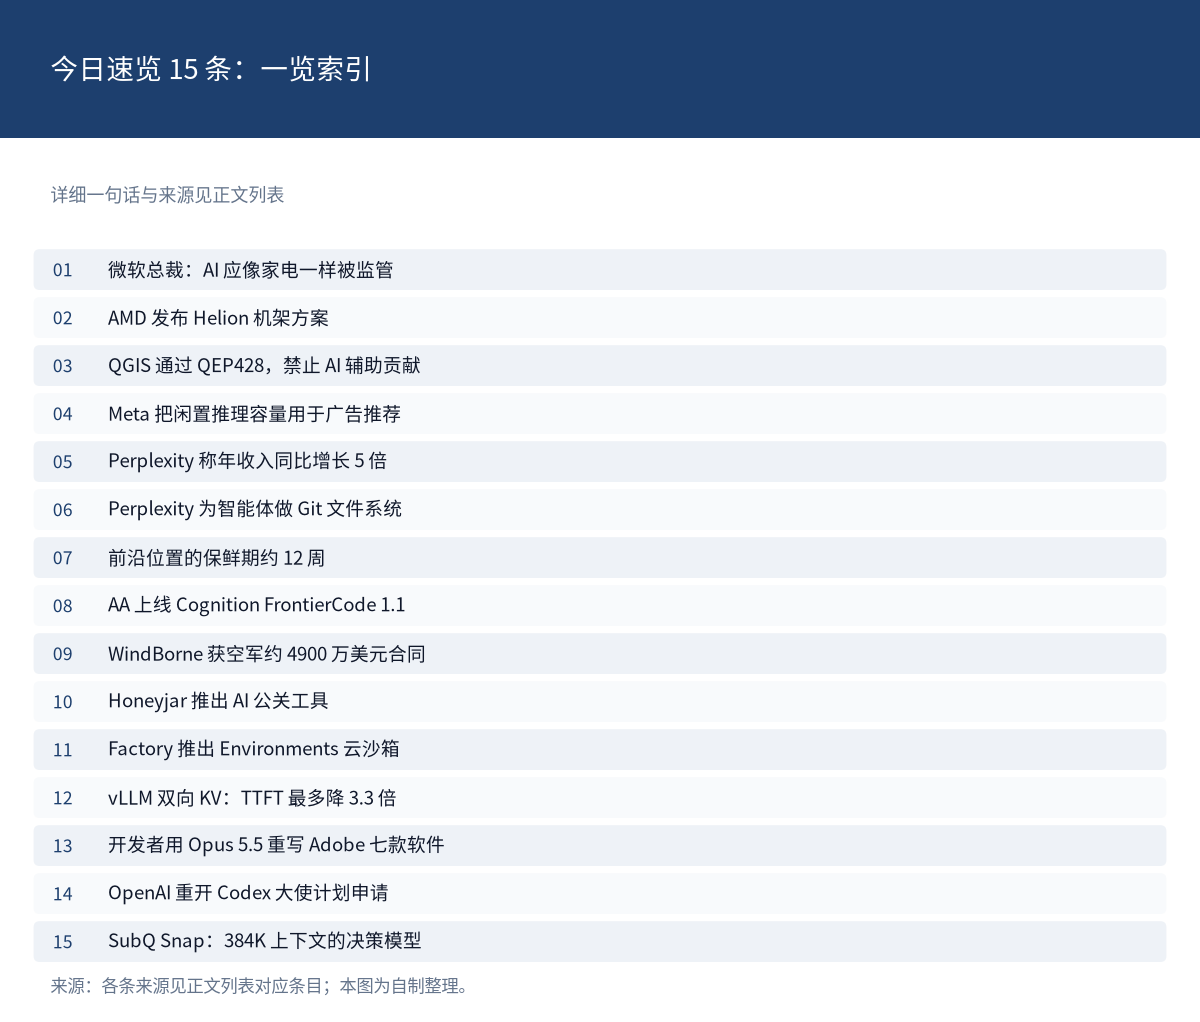
图 7:今日速览 15 条的一览索引。来源:各条来源见下方列表对应条目;本图为自制整理。
- 微软总裁称 AI 应当像牛奶和洗衣机一样被监管,而不是按可能的最坏情形预设。来源:TechCrunch、IT之家(10-12)
- AMD 发布面向代理式 AI 的机架级方案 Helion,细节暂未见公开信息。来源:IT之家(10-12)
- QGIS 通过 QEP428 提案,把 AI 政策改成严格禁止 AI 辅助贡献。来源:QGIS-Enhancement-Proposals(10-12)
- Meta 把各团队的闲置推理容量汇成共享容量池,用来扩大广告推荐、跑更强的模型。来源:Meta Engineering Blog(10-13)
- Perplexity CEO 称公司年收入同比增长 5 倍,归因于做真实电脑工作的智能体;公司没有发布财报。来源:Aravind Srinivas 访谈(10-13)
- Perplexity 为智能体做了个 Git 文件系统:每个智能体在沙盒里工作、提交到共享仓库,人和其它智能体可以跨会话接着做。来源:Perplexity 官方(10-13)
- 前沿位置的保鲜期约 12 周:Arena 的追踪数据显示,7 月 1 日领先所有模型的 Claude Fable 5,12 周后 Top 20 平均水平已经追平。来源:Arena 官方(10-13)
- Artificial Analysis 上线 Cognition FrontierCode 1.1 榜单,要求智能体在真实开源仓库完成任务并达到维护者的合并标准。来源:Artificial Analysis 官方(10-13)
- WindBorne 拿下美国空军最高约 4900 万美元的气象数据合同,采购约 700 个自主气象气球的大气数据,目前已下单 170 万美元。来源:TechCrunch(10-13)
- Honeyjar 推出 AI 公关工具,自动撰写公告、筛选记者、搭媒体名单;候补名单开放 24 小时收到一万个注册。来源:TechCrunch(10-12)
- Factory 为云端 Agent Droids 推出 Environments 沙箱,可把所需的仓库、工具与依赖预构建成可移植镜像。来源:Factory 官方(10-12)
- vLLM 让 decode 节点把算好的 KV 缓存回传给 prefill 节点,避免多轮对话重复计算:在 Amazon EC2 P5en 的 1P1D 部署上,Qwen3-32B 的 TTFT 最多降 1.6 倍,GLM-5-FP8 最多降 3.3 倍。来源:vLLM 官方博客(10-12)
- 一位开发者用 Claude Opus 5.5 以 Rust 重写了 Adobe 七款软件的开源替代品,其中 Photoshop 项目据其自述不到 10 天获得 4.6 万 Star。来源:数字生命卡兹克(10-12)
- OpenAI 重新开放 Codex 大使计划申请,称大使已增至 199 位、覆盖 49 个以上国家和地区。来源:OpenAI Developers 官方(10-13)
- SubQ 推出 384K 上下文的决策模型 Snap,据转述 100K 上下文约 660 毫秒、384K 约 2.5 秒;这些数字目前只有单一转述来源,而且它与该公司更早的 1M-Preview 不是同一个模型。来源:Rohan Paul 转述(10-13)
积木观察
三条主线都在重算同一张价签:Meta 用近三倍的每任务成本换进第一梯队,微软把自研芯片提为首选推理系统、赌的是单位电力的 token 产出,AWS 把架构实验的门票压到不足 1%。而前沿位置的保鲜期只有约 12 周——挤进去和待得住是两笔账。选型时把「每任务成本 × 质量」单列一张表。
结尾互动
你们团队选模型时,会先把每任务成本拉进决策表,还是先看榜单名次?
来源链接
- 官方 · Muse Wonder 研究博客:https://research.meta.ai/blog/muse-wonder
- 官方 · Meta 模型卡:https://research.meta.ai/static/muse-wonder-model-card
- 官方 · Meta API:https://dev.meta.ai/
- 官方 · Artificial Analysis 模型页:https://artificialanalysis.ai/models/muse-wonder-full
- 官方 · Maia 300 相关帖:https://x.com/satyanadella/status/2109631106404487523
- 官方 · AWS priming 博客:https://www.amazon.science/blog/can-we-change-an-ai-models-architecture-without-retraining-it-from-scratch
- 官方 · 论文 arXiv 2605.08301:https://arxiv.org/abs/2605.08301
- 官方 · AlphaProof Nexus 论文:https://www.science.org/doi/10.1126/science.aej2213
- 官方 · SubQ:https://subq.ai/
- 独立 · The Decoder(Muse Wonder):https://the-decoder.com/metas-new-frontier-model-muse-wonder-full-breaks-into-the-ai-top-tier/
- 独立 · The Decoder(AlphaProof Nexus):https://the-decoder.com/google-deepminds-alphaproof-nexus-solved-dozens-of-open-math-problems-and-actually-got-peer-reviewed/
- 独立 · Ars Technica:https://arstechnica.com/tech-policy/2026/10/anthropics-claude-ai-submitted-false-murder-tip-to-philadelphia-police/
- 独立 · TechCrunch(Meta 发布):https://techcrunch.com/2026/10/12/meta-releases-its-first-frontier-model-muse-wonder/
- 独立 · 网易 / cnBeta(Maia 300):https://www.163.com/dy/article/L92QU94U0511BLFD.html