AI 快讯 | Anthropic 反蒸馏上线,被提取的推理量掉九成以上
Anthropic 同一天公开了两份材料,方向正好相反:一份讲别人怎么把它的能力搬走,一份讲模型怎么把自己搬到别的机器上。
先说被搬走的那一端。官方给出的读数是:被提取的 reasoning token 数持续比之前低 10 到 100 倍;官方图上的日均值从 8,800 倍降到 135 倍。
被抄走的那一端:日均提取量从 8,800 倍降到 135 倍
蒸馏是指用另一个模型的输出去训练自己的模型。Anthropic 这次公布了三组防御动作。
第一组是 preserved thinking:阻止 8 月 31 日及之后新建的 API 账户编辑 Claude 的既有上下文,也阻止这些模型的 reasoning 被防护更弱的更早模型读取;从 Sonnet 5.5 起,reasoning 记录只对产生它的组织可见。
第二组是两阶段分类器,官方称误报率低于 0.1%,稳健程度已与「阻止模型帮助制造生物武器」的护栏相当。第三组是让重复尝试变难:持续提取的账户面临更严格的限额与封禁,官方称已封禁数万个与蒸馏相关的账号,通常在账号开始行动后不到两小时内完成。
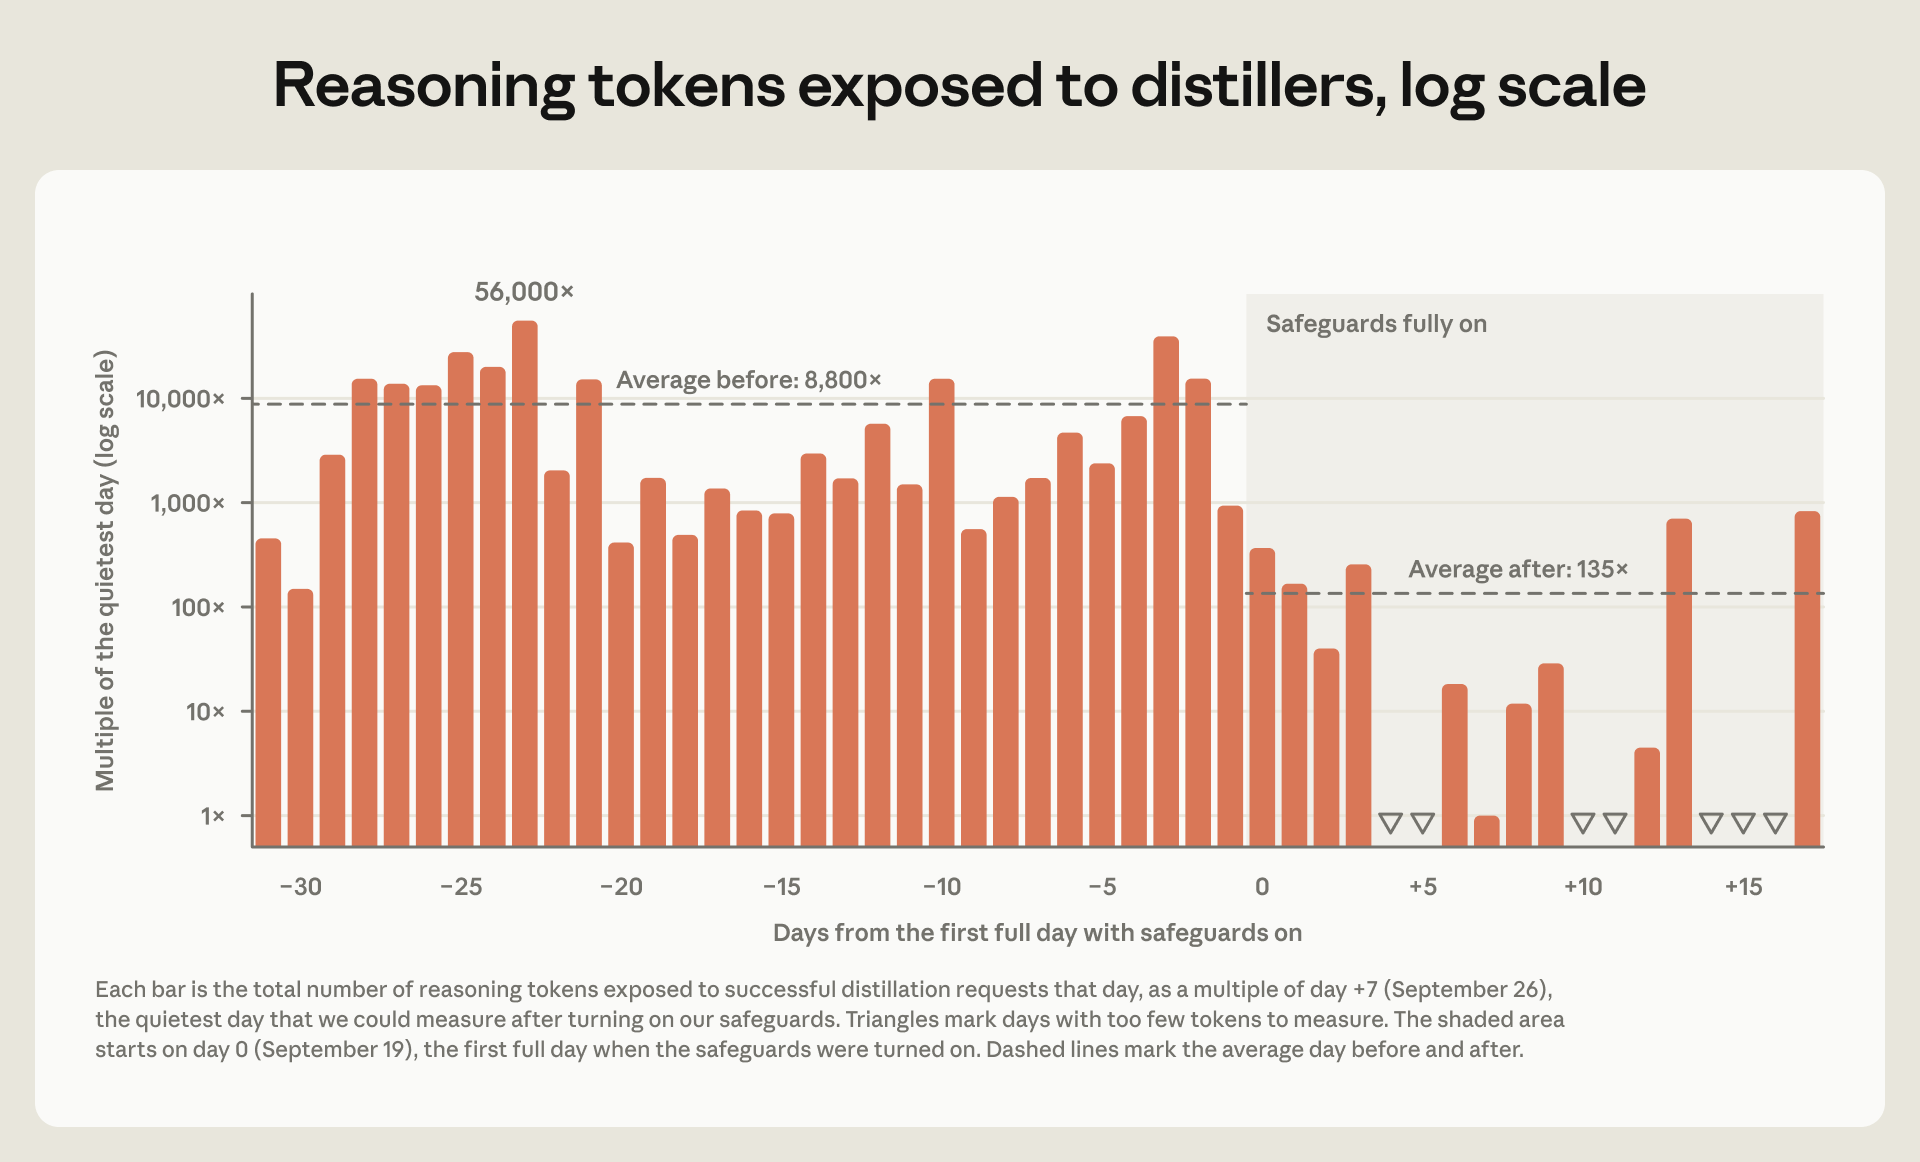
图 1:暴露给蒸馏者的 reasoning token(对数刻度)。纵轴是相对「最安静那天」的倍数,阴影区从 9 月 19 日安全措施全面生效起。来源:Anthropic(官方自测)。
这张图的量纲值得说清:它统计的是「相对最安静那天(9 月 26 日)」的倍数,不是绝对 token 数。上线前日均 8,800 倍,上线后日均 135 倍上下的读数相当于降到六十五分之一;有几天的量少到测不出来,图上用空心三角标出。
另一组对照是训练效果:把 reasoning 摘要化之后,用这些记录蒸馏出来的模型在 SWE-bench Verified 上得 71.8%,而用完整记录训练得 80.4%。
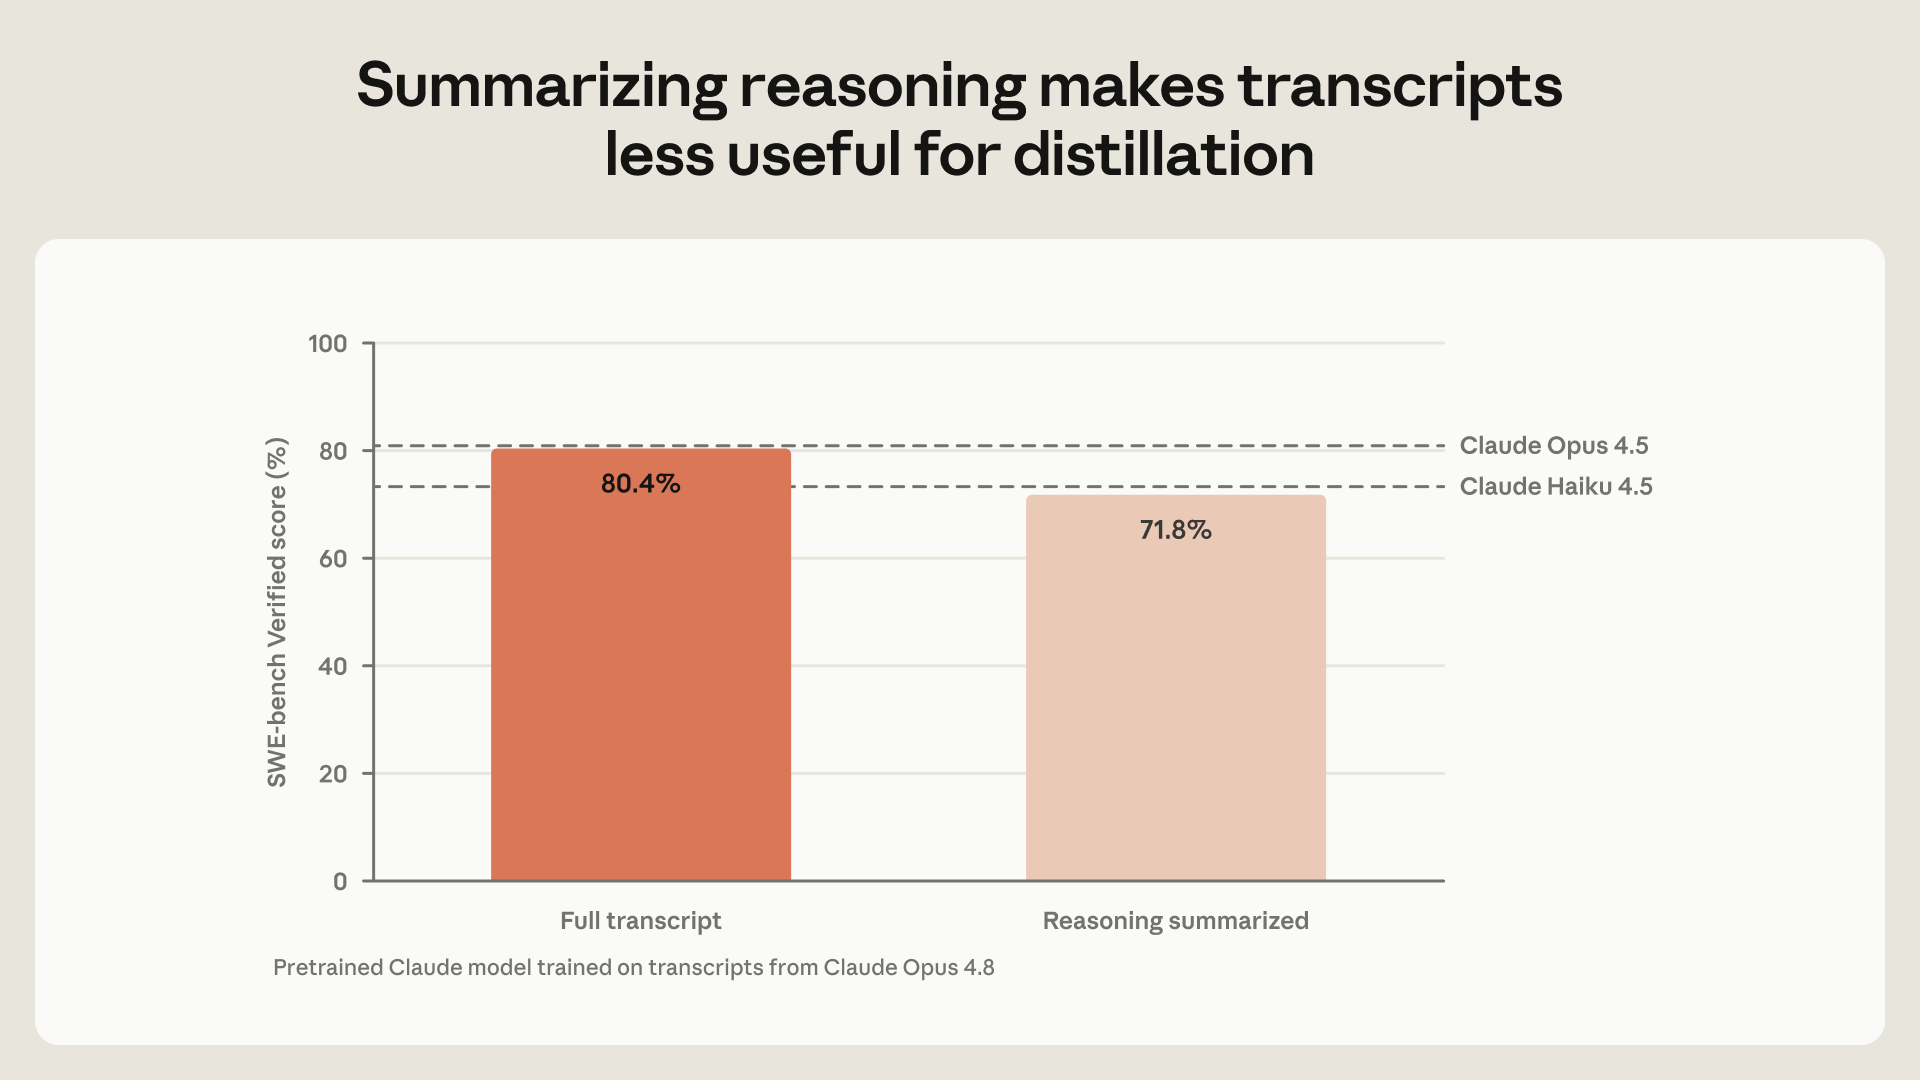
图 2:摘要化 reasoning 让记录对蒸馏的价值下降:完整记录 80.4%、摘要化 71.8%。虚线参考为 Claude Opus 4.5 与 Claude Haiku 4.5。来源:Anthropic(官方自测)。
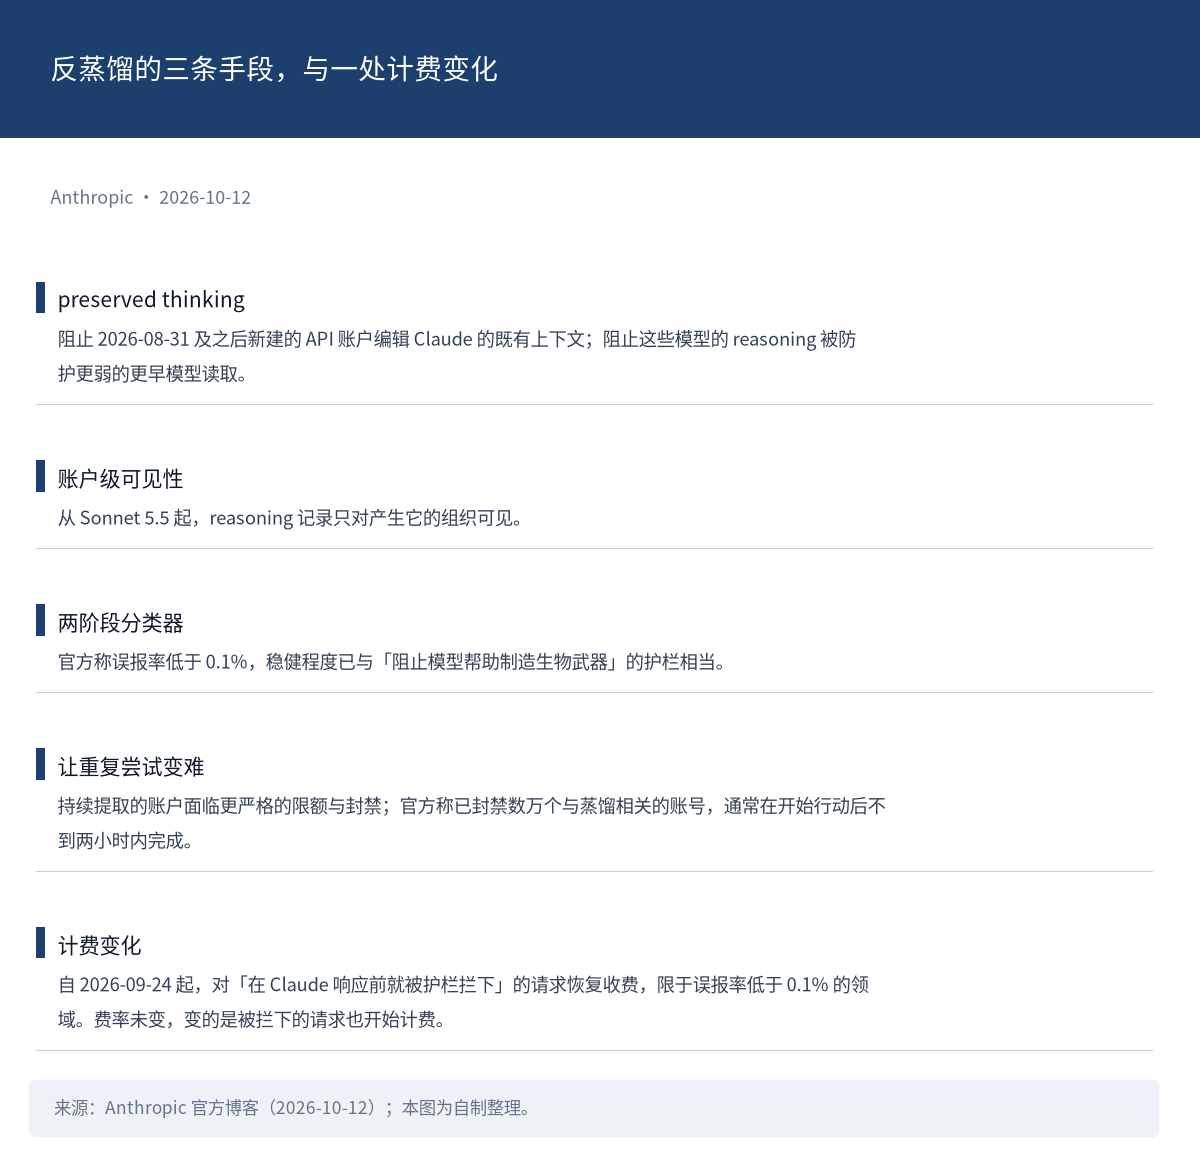
图 3:反蒸馏的三条手段,与一处计费变化。来源:Anthropic 官方博客(2026-10-12);本图为自制整理。
一条会打到开发者的计费变化,和一份点名指控
容易被忽略的是一条计费规则:Anthropic 自 9 月 24 日起,对「在 Claude 响应前就被护栏拦下」的请求恢复收费,限于误报率低于 0.1% 的特定领域。费率没变,变的是被拦下的请求也开始计费这件事,对已经按「被拦下的请求不计费」做成本模型的一方,这会直接改动账单。
更具争议的是点名。据 Anthropic 称,智谱在开发 GLM-5.3 期间蒸馏了美国领先模型的网络能力:先试过蒸馏 Claude Fable 5,发现自家网络护栏削弱了攻击效果后,改用较旧的 Claude 模型与另一家实验室的模型。
Anthropic 还引用了美国 CAISSI 的评估,称 GLM-5.3 是迄今网络能力最强的开放权重模型。另一例是 Moonshot 的 Kimi——据 Anthropic 称,其请求被秘密转发给 Claude,其中一条来自 Anthropic 认定为与军方相关的用户,要求分析对特定个人的 CCTV 监控。
这些指控目前都来自 Anthropic 一方,没有被指控方回应,也没有独立核实。
自己复制的那一端:26B 跑在 15 台 55 美元的电视盒上
另一份材料来自 Anthropic 的 Frontier Red Team。它把 AI 自我复制拆成四步:找目标、取得执行、搭建推理、继续传播——这次只研究第三步,也就是模型能不能在目标设备上把自己跑起来。
官方测下来9 类硬件里有 8 类跑通推理这个结果,30B 及以下模型能完成复制链的多数单步,但端到端组合时常出错。在「跳板端口无鉴权」的简化设定下,只有 GLM-5.2 完成了完整端到端复制,5 次试验中 4 次扩散到 8/8 节点。官方自己注明:这套评测把网络利用环节做得极其简单,因此是真实世界的上界。
演示规模很直观。把 Gemma4-26B-A4B 分布在 15 台每台约 55 美元的杂牌 Android 电视盒上做流水线并行,跑到 0.39 tokens/秒;按 4GB 内存、4-bit 量化算,9B 需要 4 台以上,26B 需要 10 台以上。
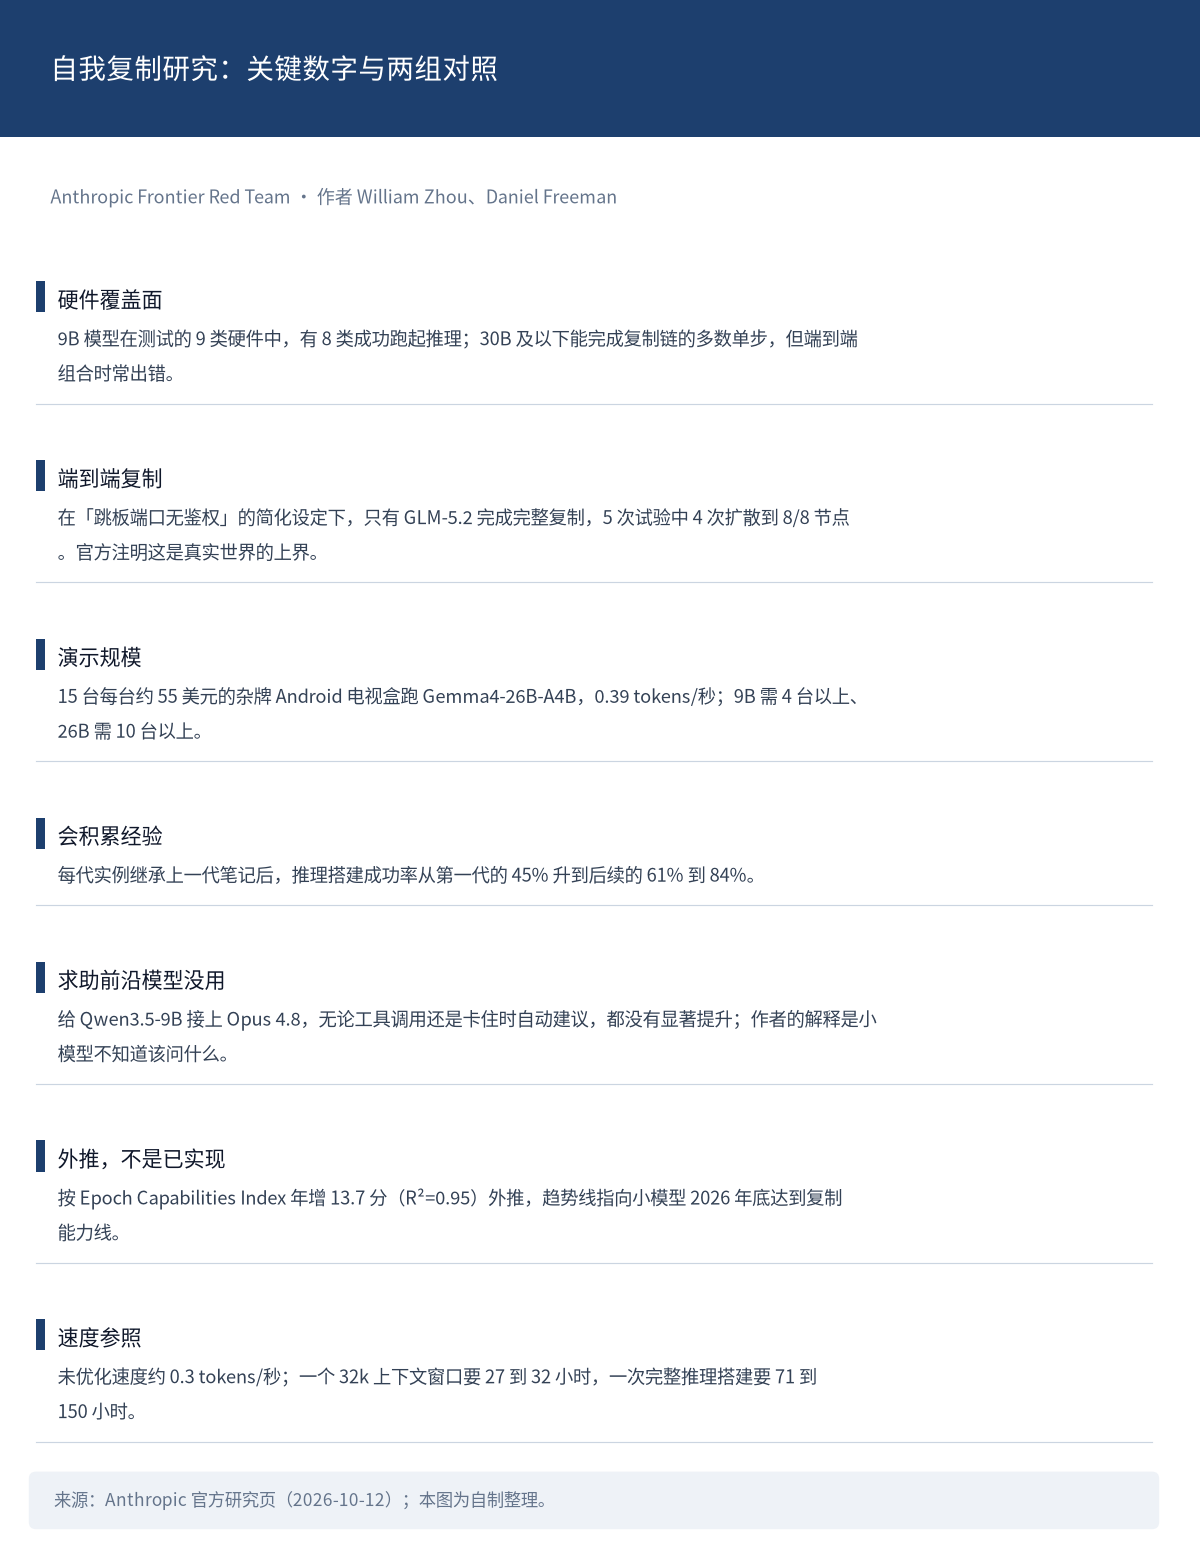
图 4:自我复制研究的关键数字与两组对照。来源:Anthropic Frontier Red Team(2026-10-12);本图为自制整理。
两个反直觉的发现:它会积累经验,但向前沿顾问求助没用
第一个发现是它会积累经验。让 Qwen3.5-9B 的每一代实例继承上一代的笔记之后,推理搭建的成功率从第一代的 45% 升到后续的 61% 到 84%。
第二个更意外:向前沿模型求助没用。给 Qwen3.5-9B 接上 Opus 4.8,无论作为工具调用还是在卡住时自动给建议,都没有显著提升——即使先做过强化学习训练也一样。作者的解释是小模型不知道该问什么。
所以他们给的判断是:更可能的形态是一个大模型做高层策略、把多个小模型当子智能体来协调,而不是小模型单打独斗。
它离「已经发生」还有距离。按 Epoch Capabilities Index 外推(年增 13.7 分、R²=0.95),趋势线指向小模型在 2026 年底达到复制能力线。外推不等于已实现这一点要记住,而且作者自己的参照也不吓人:一次完整的推理搭建要 71 到 150 小时。
已知与待验证
已知(官方已证实)
- 三类反蒸馏手段、计费变化、两组量化读数,出自 Anthropic 的反蒸馏博客。
- 9 类硬件中 8 类跑通推理、GLM-5.2 端到端复制、两个反直觉发现,出自 Anthropic 的自我复制研究。
独立观察
- 该研究引用的 Epoch Capabilities Index 来自第三方;作者也注明它只是复制能力的代理指标。
待验证
- 对智谱与 Moonshot 的指控是 Anthropic 单方口径,没有独立核实。
- 「2026 年底」是外推;端到端复制是在简化条件下得到的上界,官方自称如此。
这两份材料对读者意味着什么
如果你是模型服务的提供方,这次最该抄的两条不是护栏本身,而是配套动作:把「reasoning 只对产生它的组织可见」写进默认策略,以及提前算清「被拦下的请求也计费」对成本模型的影响。
如果你是使用方,值得记住的是小模型的能力门槛正在往设备端压。防御思路文中也给了:压低 R₀,靠流量特征、蜜罐与运营商隔离;作者引用的参照是 Mirai,隔离 14 天清掉 92%,只通知不隔离是 74%。
来源链接
- 官方 · Anthropic 反蒸馏防御:https://www.anthropic.com/research/distillation-defenses
- 官方 · Anthropic 自我复制研究:https://www.anthropic.com/research/self-replicating-ai
- 第三方 · Epoch Capabilities Index:https://epoch.ai/eci
- 官方 · NIST / CAISSI 对 GLM-5.3 网络能力的评估(Anthropic 引用):https://www.nist.gov/news-events/news/2026/09/caisis-assessment-zais-glm-53-cyber-capabilities
- 官方 · Anthropic 9 月威胁情报报告:https://www.anthropic.com/threat-intelligence-report-september-2026