AI 日报 | 10-16:Meta 开源 816B 模型,42B 激活、能本地跑
Meta 把 816B 的开放权重放了出来,还顺手给了两条不租云也能跑的路。
头条 · 权重放出来了,Meta 说这是美国开源最强
Meta 在 10 月 15 日放出 Muse Spark Open:816B 总参数、每 token 激活 42B、1M 上下文、原生多模态。它是 8 月那版 Muse Spark 1.2 的开放权重版本,与 Muse Spark 1.3 共享同一基座——和 10 月 15 日那条闭源的 Muse Wonder 是两个模型,别混。
先把口径说清:「迄今最强的美国开放权重模型」是 Meta 自己的说法。目前没有第三方跑分——Arena 显示它已上架 Agent Arena 与 Code Arena、评分暂未见公开读数;Artificial Analysis 的页面与 Meta 官方基准表也未见公开读数。传播最广的那组数字(JobBench 61.8、HLE-Diamond 26.1、Terminal-Bench 2.1 76.4)出自一张转发的配图,基准主办方与对比模型清单均未见公开信息。
权重当天可用,这是这条最实在的部分:Hugging Face 上以 Muse Model License 发布,vLLM、SGLang、TensorRT-LLM、Transformers、llama.cpp、Unsloth 等引擎当天支持;据媒体转述,该许可免费使用但要求标注「Built with Muse Spark Open」,年收入超过 2000 万美元、又想把它做成 API 服务的供应商需要另签协议——许可原文暂未见公开,这一条按转述看。
架构 · 62 层全是 MoE,注意力是混着用的
按 vLLM 官方博客的拆解,Muse Spark Open 是稀疏 MoE:62 层解码器全部是 MoE 层,每层 256 个专家。权重分布也写得很直白:专家 799B、attention 13.5B、MoE latent 投影 4.2B、embedding 与输出 3.3B、视觉塔 1.9B。
注意力是混着用的:每 4 层一个循环——3 层滑窗 2048 加 1 层全注意力,62 层里 46 层窄、16 层宽。官方给的换算结果是,到 1M 上下文时 KV cache 大约只占全注意力的四分之一。
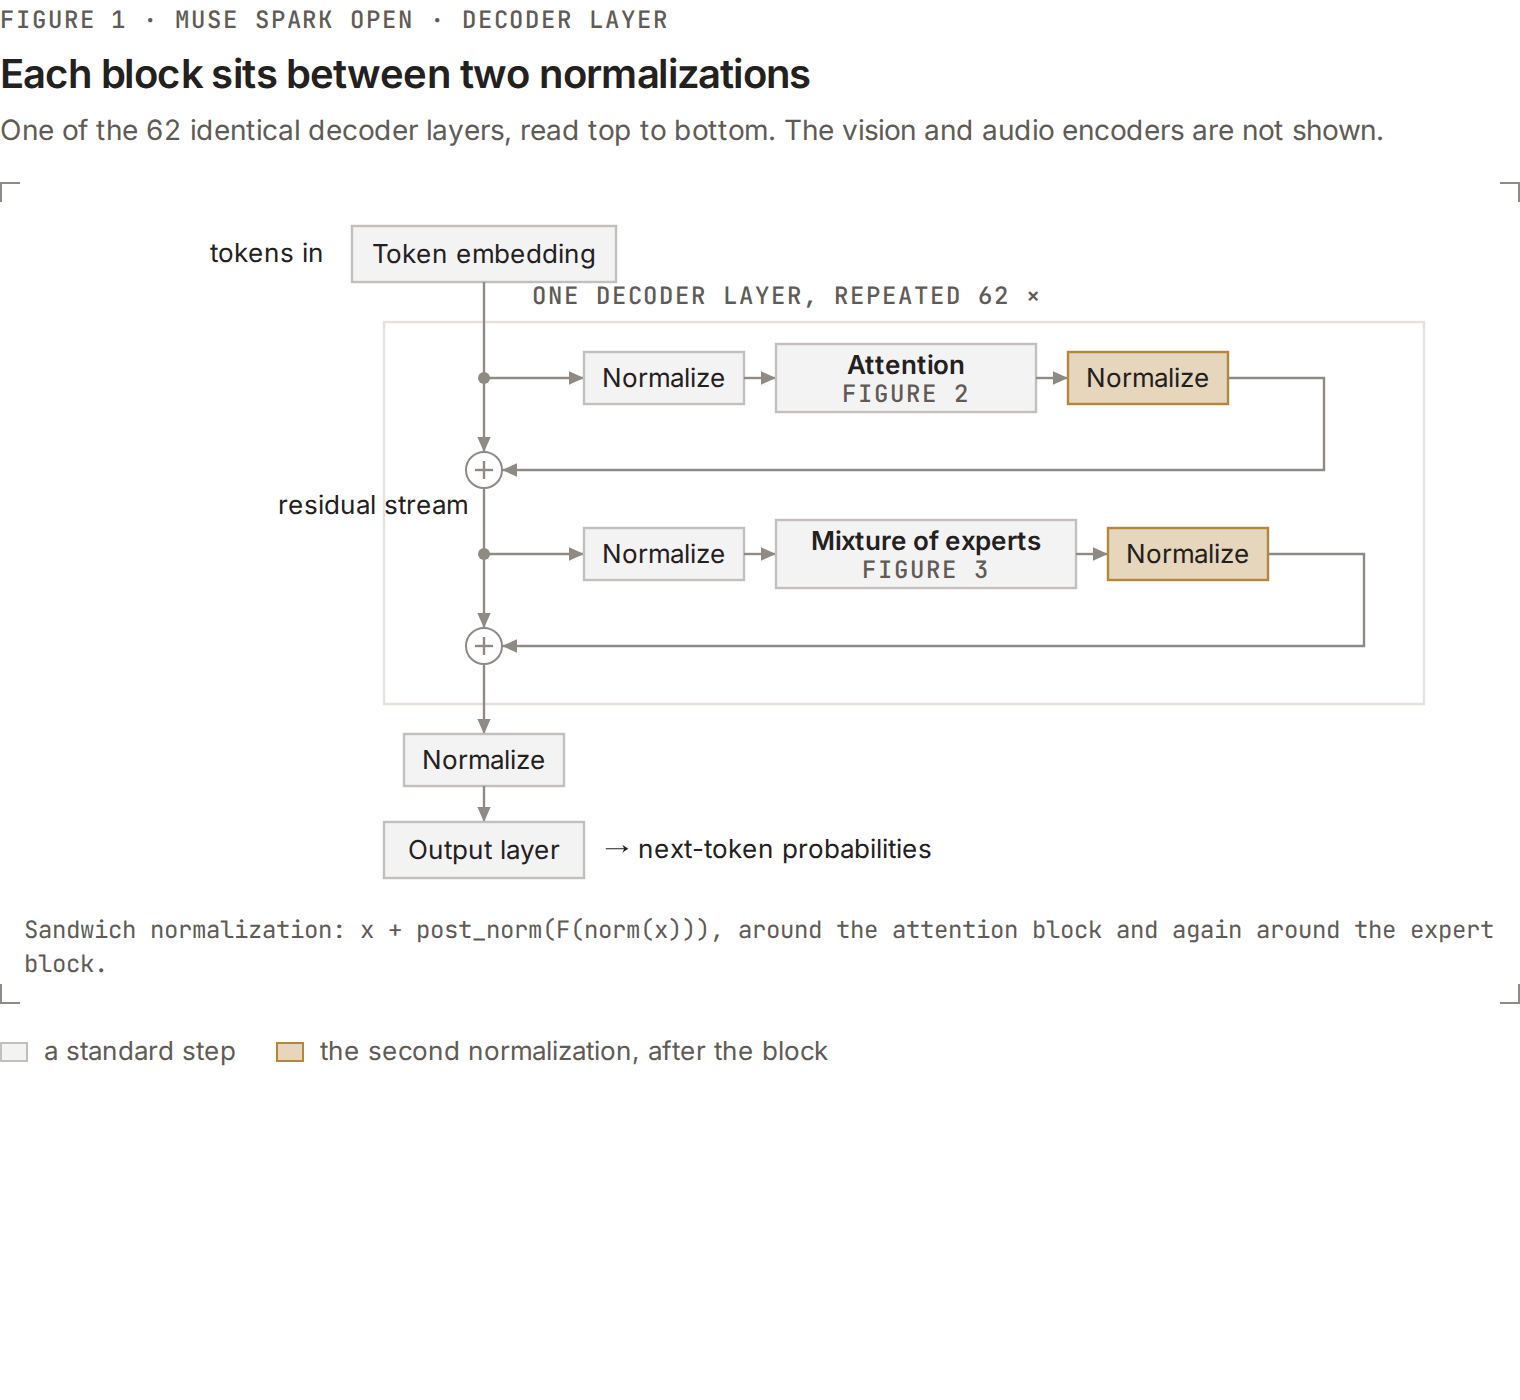
图 1:Muse Spark Open 的解码器层结构,每个块夹在两个 normalization 之间,共 62 层(vLLM 原图 FIGURE 1)。来源:vLLM 官方博客。
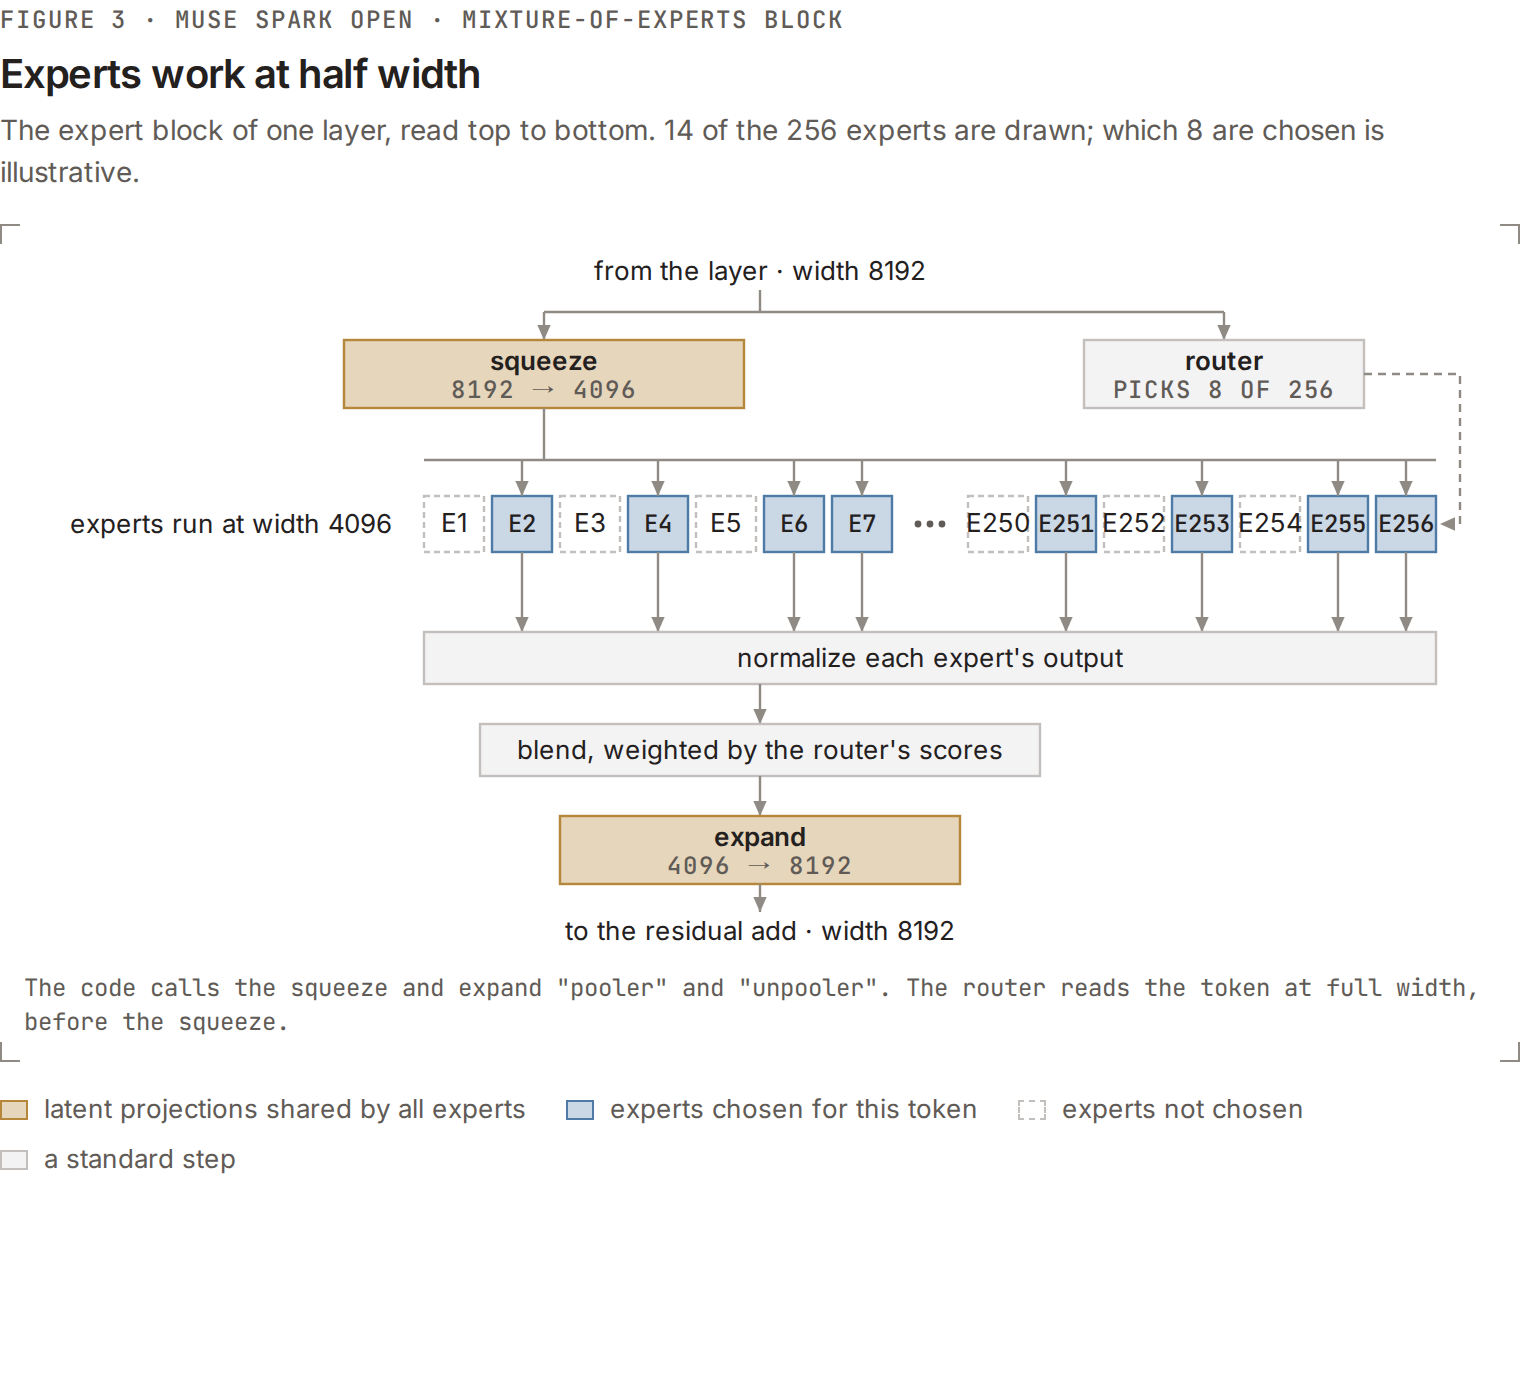
图 2:Latent MoE 的 pooler 与 unpooler——token 宽度先减半再进专家,路由器在 256 个专家里挑 8 个(vLLM 原图 FIGURE 3)。来源:vLLM 官方博客。
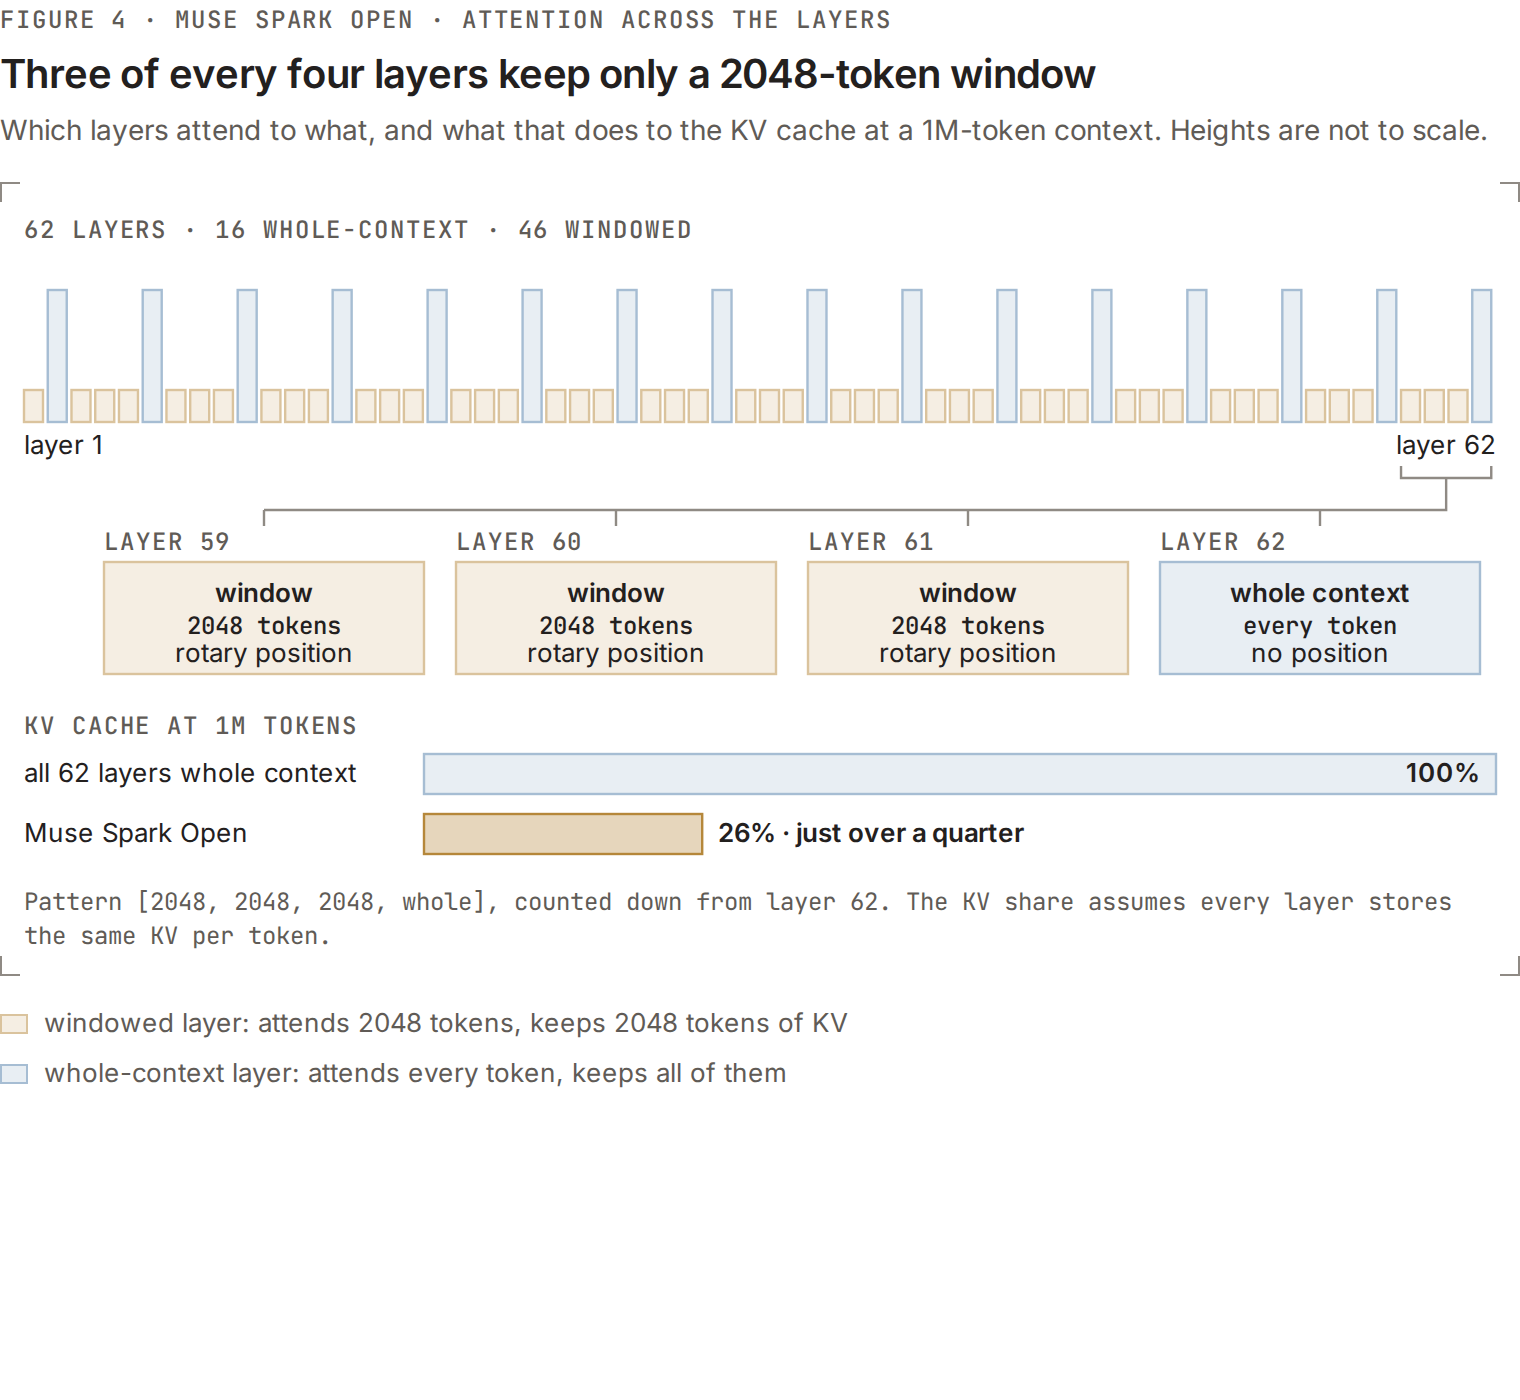
图 3:滑窗注意力与全注意力的混合排布——每 4 层里 3 层只看 2048 token,1M 上下文时 KV cache 约为全注意力的 26%(vLLM 原图 FIGURE 4)。来源:vLLM 官方博客。
多模态那侧有两条边界要记住:视觉用的是 2B 的 Perception Encoder,原生分辨率、不裁方图;音频编码器只有 118M,24kHz 原始波形、每 80 毫秒一个 token,而视频的音轨不处理——要画面加声音,得把视频与音频当成两个独立部分传。
本地 · 两台 Mac Studio 是新给的那条路
Apple 机器学习研究团队同日演示了用新版 MLX 加 macOS 的 RDMA over Thunderbolt,把多台 Mac Studio 连成集群做分布式推理;Meta 称经优化可在两台 M5 Ultra Mac Studio 上运行。另一条更省钱的路来自 Unsloth:2-bit GGUF,称能塞进 256GB 内存的 Mac Studio。
量化与部署侧,Meta 发了 BF16 与 NVFP4,AMD 另发 MXFP4;NVIDIA 与 AMD 都支持张量并行与流水并行,TPU 有初始支持。
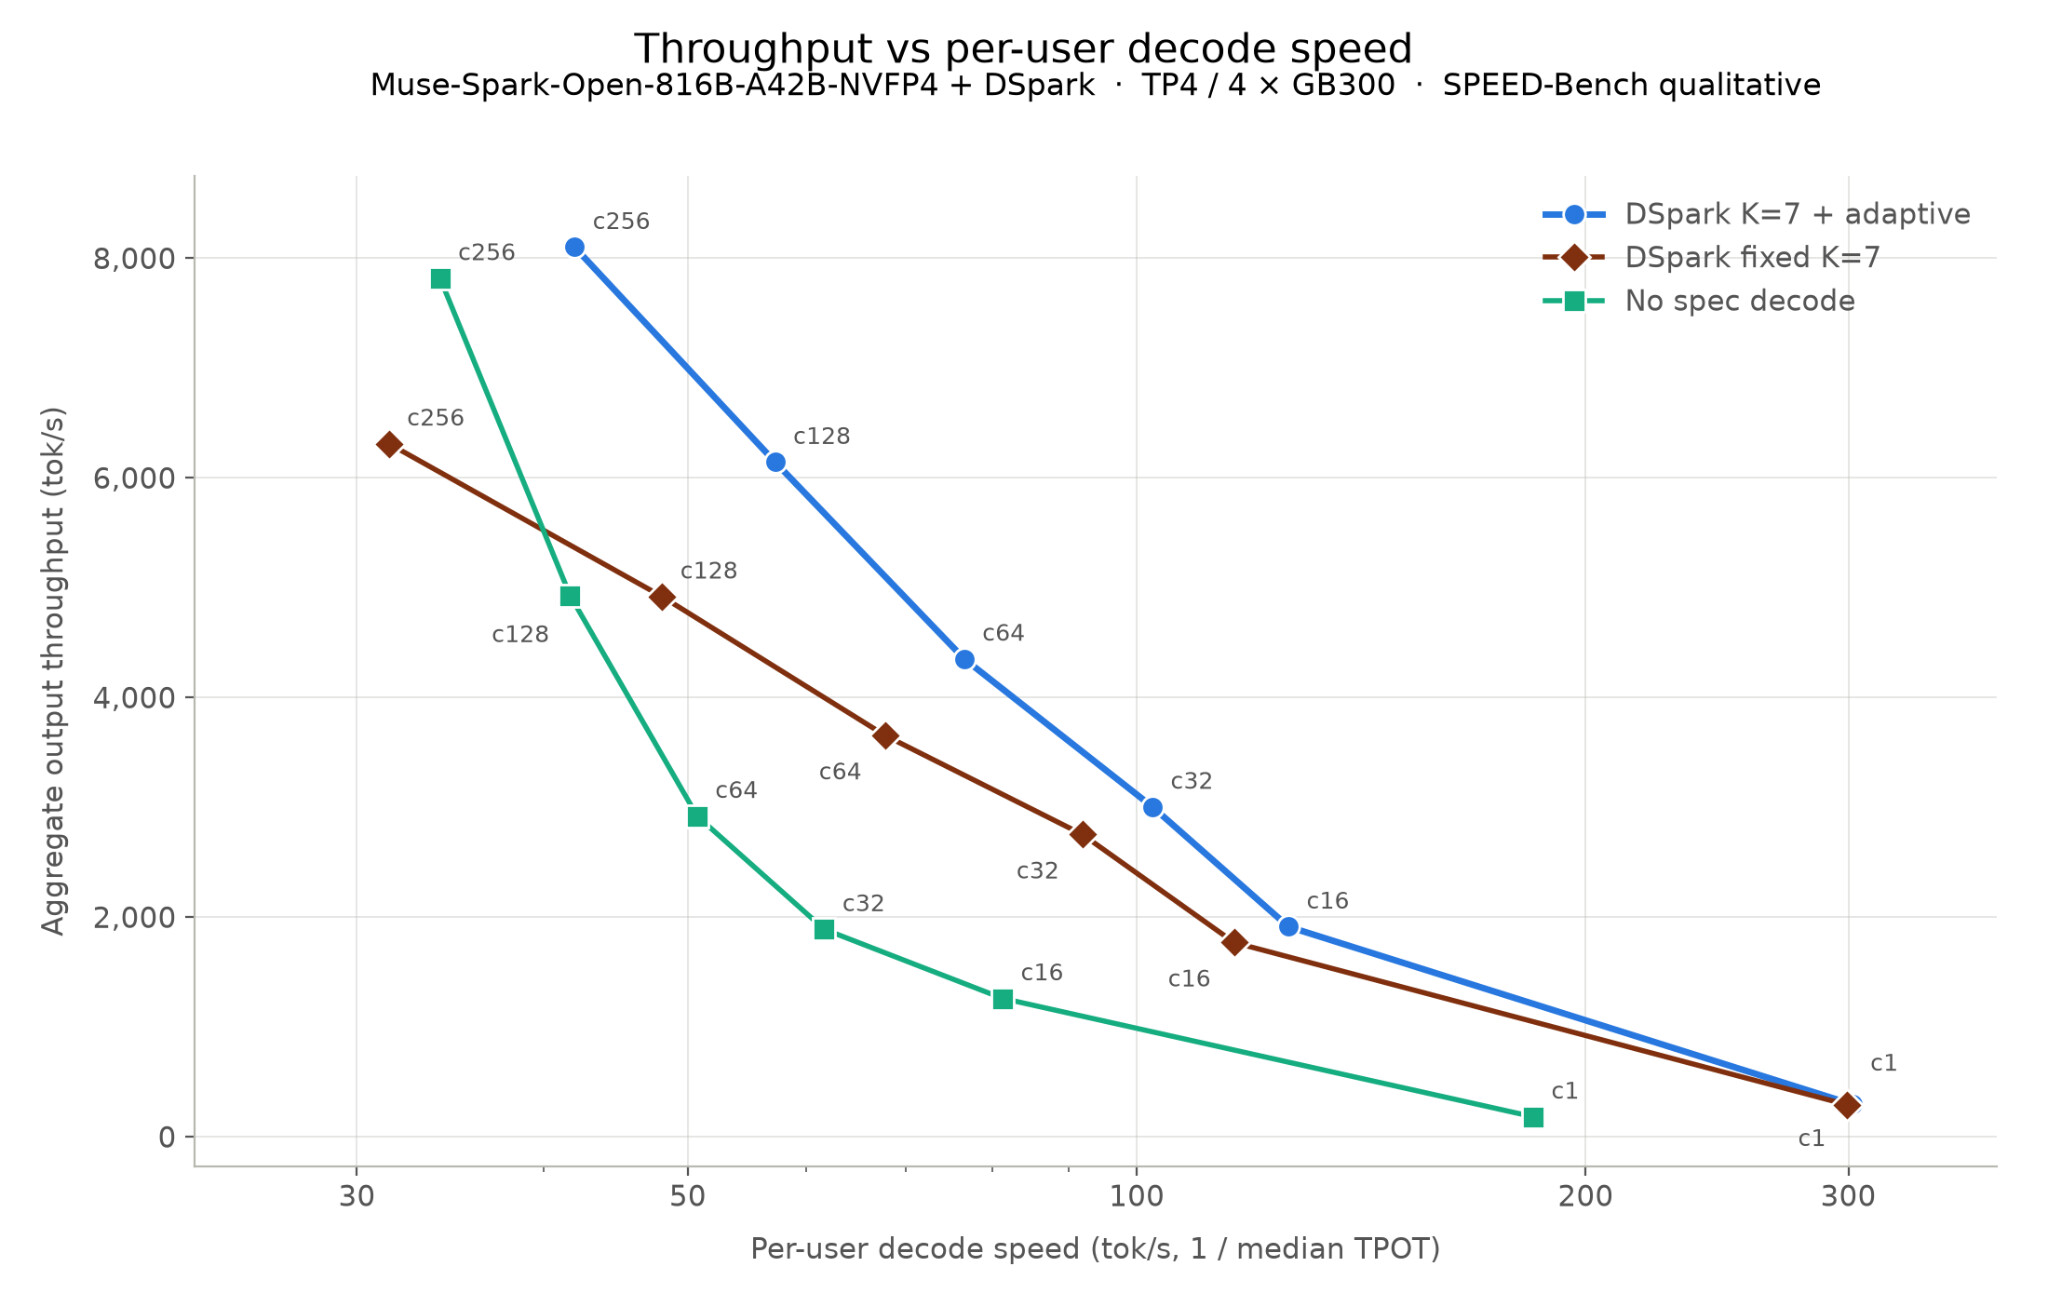
图 4:DSpark 投机解码的吞吐与单用户解码速度(4×GB300、TP4,SPEED-Bench 定性结果)。来源:vLLM 官方博客(vLLM 自测)。
vLLM 自测了一组推理加速读数:配 DSpark 草稿模型时,4 张 TPU v7 超过 650 tokens/s、8 张超过 960 tokens/s,不开投机解码是 270 与 350。训练侧还有两个自测读数:Helion 内核在 GB300 上比手写专有内核快 1.03 到 3.95 倍,AMD MI350 端到端提升 3%;LoRA RL 的演示里,16 张 GB300 训 150 步,AIME-2024 从 0.56 升到 0.85——最后这个数字要看清,它是「这个模型能被 RL 微调」的演示,不是模型本身的基准分。
价格分三层看。权重本身开放下载,没有官方按 token 定价。第三方平台 OpenRouter 挂的是输入每百万 1.25 美元、输出每百万 4.25 美元,这是平台挂价,未在其官方定价页核实。本地跑没有 API 费用,但要两台 M5 Ultra Mac Studio,或者一台 256GB 内存的机器配 2-bit 量化,硬件成本暂未见公开报价。
重点 · 同一天还有五条
OpenAI 上线 GPT-Live-1.1,系统卡自曝四类回归。1.1 是 Plus 及以上档位的默认语音模型,Quip 是其余用户的默认,两者都是全双工,新增法语、德语、印地语、墨西哥西班牙语、韩语、日语六种语言,API 即将推出。系统卡里写了一句不太常见的话:在合成语音提示评测上,1.1 相对上一代在性、心理健康、情感依赖、血腥这四类出现统计显著的回归,OpenAI 称需要更多研究才能理解,计划在后续版本改进。语音模型的迭代通常只讲「更自然」,这份系统卡把退步写在了同一页上;而且它自己也写明,合成集与生产提示集都不能代表真实流量中的表现。
英伟达开源 Nemotron 3.5 Super VL,端侧两款一起给。120B 总参、12B 激活,混合 Mamba-Transformer 的 MoE,把推理、工具调用与文本/图像/文档/GUI/视频理解整合在一起;同期发布端侧 Bolt 74B-A9B(24GB)与 Bolt E4B(4GB,10 月 23 日上线)。Artificial Analysis 给的智能指数是 26,是上代 Nemotron 3 Super(13)的两倍——但离同期闭源前列的 50 分以上还有明显距离,这个对照比「两倍」更值得记。英伟达另外自述单 GPU 吞吐最高可达同规模开放模型的 5 倍,对比清单没有细说。
Anthropic 三季度收入 168 亿美元,增速换了挡。据 The Information 与 FT 报道,Anthropic 在闭门投资者会上披露三季度收入 168 亿美元,环比增速从二季度的 147% 降到约 45%;同批数字里还有年内调整后营业利润率 11%、现金流为正。公司方面未见公开确认。168 亿是季度收入、不是 ARR,两者不可互算;「增速放缓」这件事,比收入体量更值得记。
微软 MAI-Base-2 预训练完成,但只有一条转述。微软 MAI 称它预训练算力效率比最强的开放基座 DeepSeek-V4-Pro-Base 高 4 到 12 倍,并称已在内部建成 3T 参数级的基座;目前没有微软官方博客或模型卡。FLOPs 效率说的是训练时的算力利用率,不等于同等能力更便宜。
DeepSeek 中断 4 小时 52 分钟,补偿按故障前一周的消耗算。官方状态页显示 10 月 15 日 08:11 到 13:04 中断,随后恢复;DeepSeek 致歉称已启动稳定性排查、剥离单点依赖,并按账号 10-08 至 10-14 的消耗金额以赠金形式全额返还,自动到账、API 计费先从赠金扣。补偿基数是一周、不是全部历史消费,赠金也不能提现。
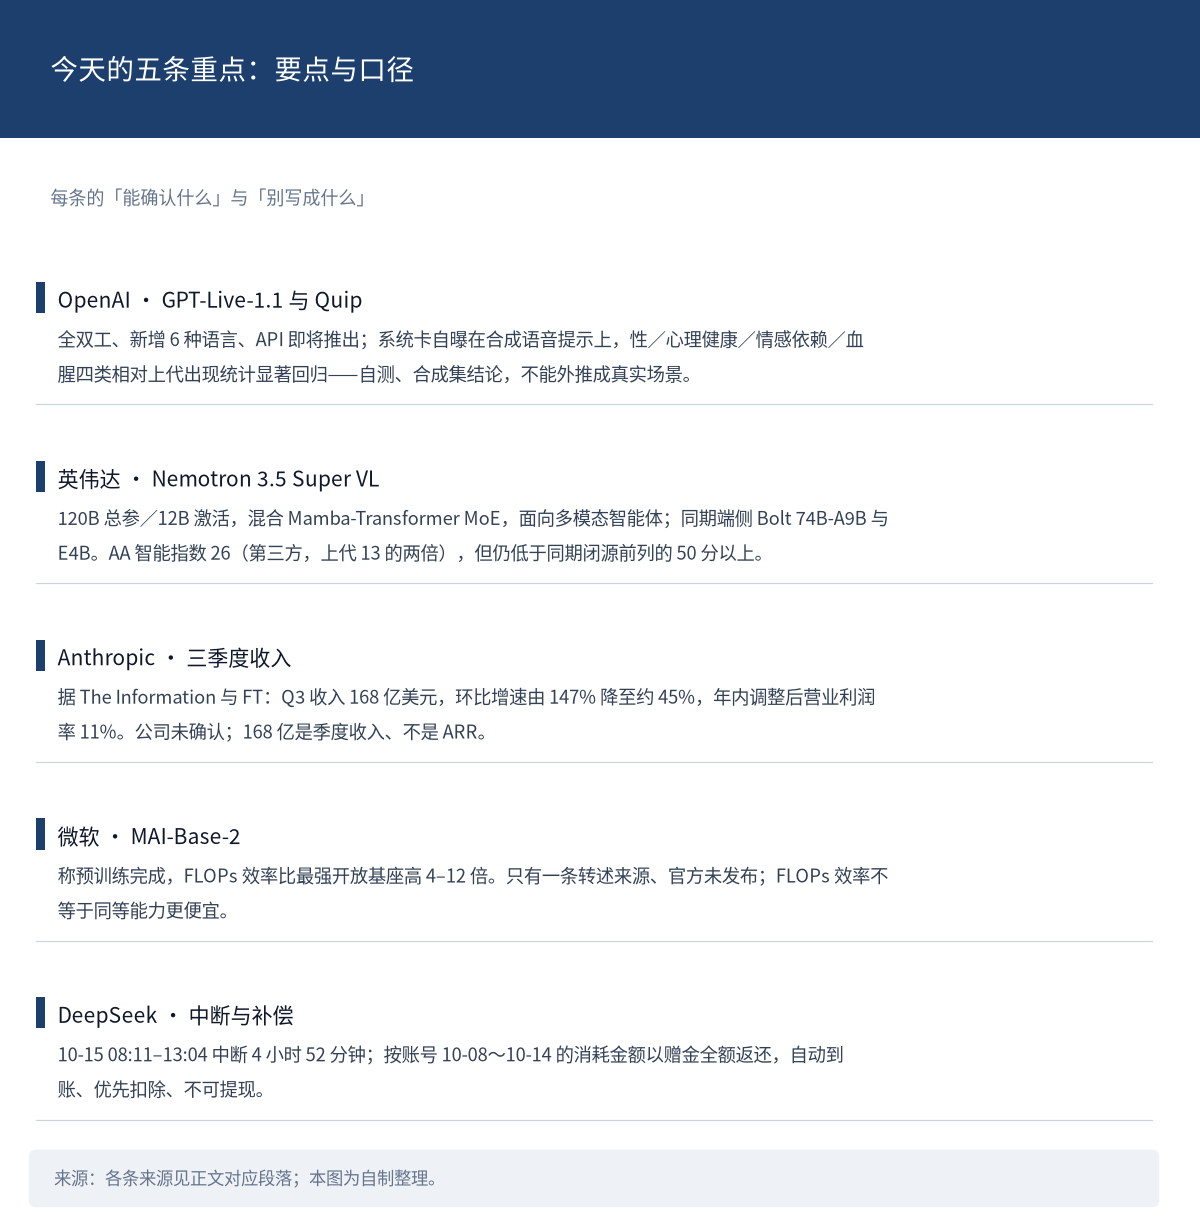
图 5:同一天五条重点的要点与口径。来源:OpenAI 系统卡、Artificial Analysis、The Information 与 FT 报道、Testing Catalog 转述、DeepSeek 官方公告;本图为自制整理。
速览 · 15 条
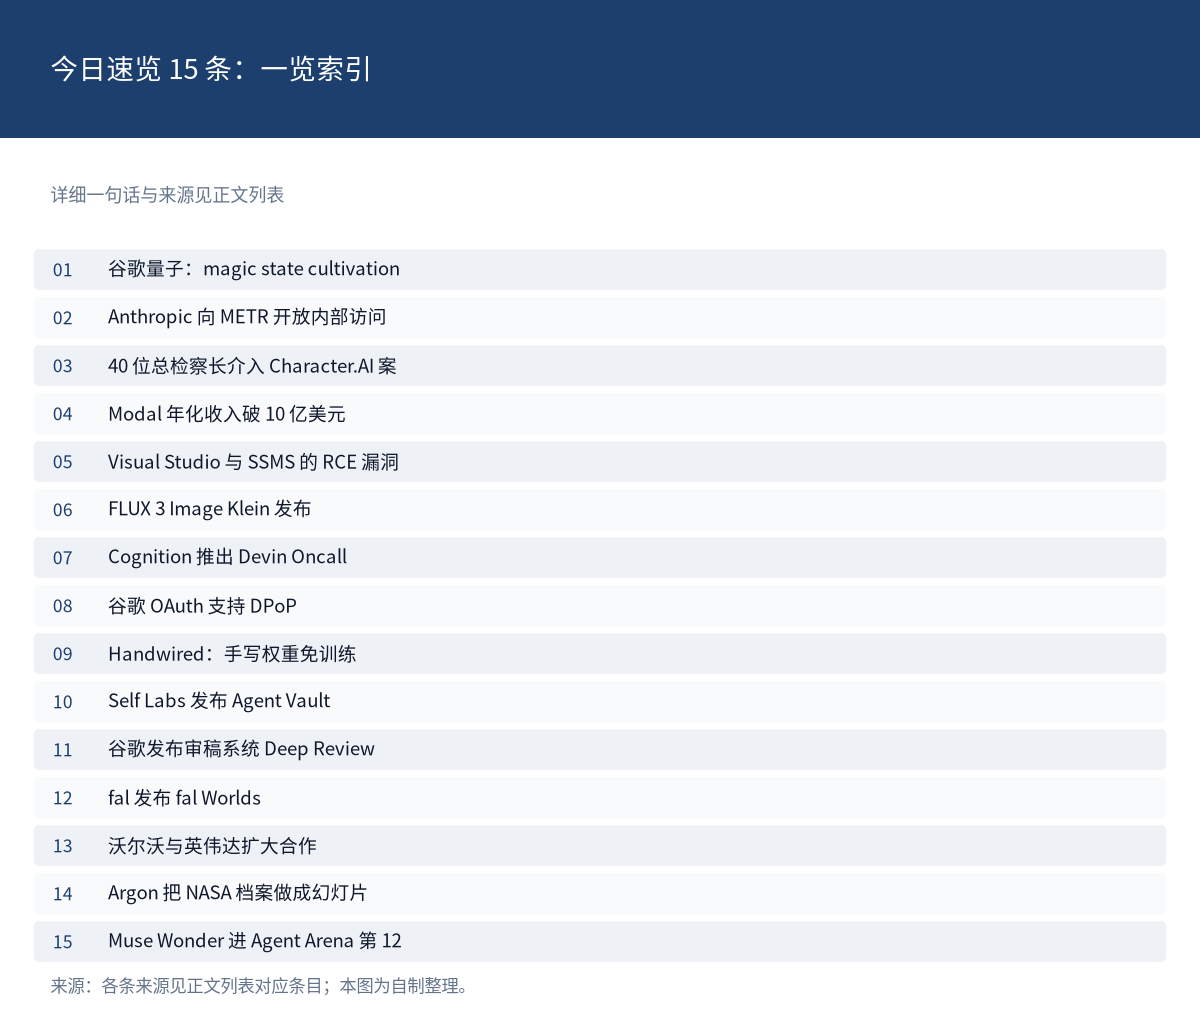
图 6:今日速览一览索引。来源:各条来源见下方列表;本图为自制整理。
- 谷歌在 Willow 处理器上首次于硬件演示 magic state cultivation,称相对此前方法错误降低 40 倍、逻辑保真度 99.99%,论文发表于 Science。来源:谷歌官方(10-16)。属量子计算,是 AI 的相邻领域。
- Anthropic 向 METR 开放 6 名评估员的内部访问,配公司硬件与内部工具权限,METR 可自行发布结论、Anthropic 无权否决。来源:转述(10-16),暂未见官方公告。
- 40 位总检察长介入 Character.AI 破产案,要求保护用户对话数据。来源:The Verge(10-15)。属该案后续。
- Modal 年化收入突破 10 亿美元,完成 7.5 亿美元 D 轮,投后估值 157.5 亿美元,Accel 领投。来源:Modal 官方博客(10-14~10-15)。
- Visual Studio Copilot 与 SSMS 存在远程代码执行漏洞 CVE-2026-103572:文件名末尾多加一个点即可绕过路径校验、写入受保护配置文件。来源:披露方技术分析(10-15)。
- Black Forest Labs 发布 FLUX 3 Image Klein,5.6B 参数、原生 4K,分 Base 与 Distilled 两版;官方称内部评测得分高于 Qwen-Image 2.1(为自测)。来源:Comfy 博客(10-16)。
- Cognition 推出 Devin Oncall,让 Devin 自动调查告警与 bug,官方称每天已为一些大型公司处理数千条告警。来源:Cognition(10-16,厂商自述)。
- 谷歌发布 OAuth 的 DPoP 支持(RFC 9449),把客户端密钥与 refresh token 绑定,token 被盗也无法重放。来源:Google Developers Blog(10-15)。
- Mac 侧新工具 Handwired 开源:把程序里的 if-else 与循环手写成神经网络权重、无需训练,输出与对应 JS 程序一致;支持 MIT 许可,但不支持次数未知的循环。来源:作者项目页与 GitHub(10-16)。
- Self Labs 发布 Agent Vault,让编码智能体用占位符令牌完成登录与刷卡,真实卡号只在填写瞬间注入,被注入的智能体最多只能在设定额度内消费。来源:作者帖(10-16)。
- 谷歌发布智能体审稿系统 Deep Review,起初面向计算机科学论文,现已扩展到法律与金融。来源:Google Research 博客(10-15)。
- fal 发布 fal Worlds 与配套的世界模型推理引擎,可实时创建并交互 AI 生成的世界。来源:fal(10-16)。
- 沃尔沃与英伟达扩大合作,基于 Hyperion 架构、Halos OS 与 Alpamayo Stack 做门到门自动驾驶,逐步引入 eyes-off 与 mind-off。来源:NVIDIA Newsroom(10-16)。
- Gemini 4 Argon 把 NASA 开放档案里的 8 万个文件处理成演示文稿,按严格设计规范生成 Google Slides。来源:谷歌官方演示(10-16,非评测)。
- Meta Muse Wonder (Max) 进入 Agent Arena 第 12 名,官方称净提升 6.4%(Arena 口径)。来源:Arena(10-15)。这条与人工分析榜「无公开可用 API」那个关注点不同,别合并。
积木观察
今天两条开源发布放在一起看,路线差异很清楚:Meta 押的是大而全——816B 的智能体基座,再配上「两台 Mac Studio 本地跑」这条不租云的路;英伟达押的是中等规模加单 GPU 吞吐,还顺手把端侧两款一起放出来。两家都把开源当成企业部署的入口,而不是研究者的玩具。
对读者的直接含义有两条。要做选型的,先别急着按「美国开源最强」下单——这条的能力数字目前只有一张转述图和一句厂商主张,Arena 评分还没出来,等出分再比;反倒是可交付的东西(权重、量化格式、部署命令、许可)已经齐了。要评估成本的,把「本地跑」当成一个真实选项算一遍:软件路径已经给了,卡点在硬件和许可条款。还有一条别漏:同一天 OpenAI 用一份系统卡承认自家语音模型在四类安全评测上退步——这类公开的退步,比任何跑分都更值得存档。
结尾互动
如果让你选一条路线落地,你会先试「两台 Mac Studio 本地跑 816B」,还是先把 Nemotron 这类中等规模模型接进现有单卡流程?
来源链接
- 官方 · PyTorch 博客(Meta 团队,Muse Spark Open 权重发布,2026-10-15):https://pytorch.org/blog/muse-spark-open/
- 官方 · vLLM 官方博客(Day 0 支持、架构与部署命令,2026-10-15):https://vllm.ai/blog/2026-10-15-muse-spark-open
- 官方 · OpenAI 部署安全页(GPT-Live-1.1 系统卡,2026-10-15):https://deploymentsafety.openai.com/gpt-live-1-1
- 官方 · DeepSeek 状态页:https://status.deepseek.com
- 官方 · Google Developers Blog(OAuth DPoP):https://developers.googleblog.com
- 第三方 · Artificial Analysis(Nemotron 3.5 Super VL 智能指数):https://artificialanalysis.ai
- 独立 · The Information 与 Financial Times(Anthropic 三季度收入,经转述)
- 独立 · The Verge(Character.AI 后续)、IT之家(DeepSeek 中断与补偿)
- 转述 · Testing Catalog(微软 MAI-Base-2)、Thomas Wolf 转发的基准配图(Muse Spark Open 能力数字)