AI 日报 | Anthropic 内部数据:初级技术招聘占比降到 9%
Anthropic 同一天放了两份经济学报告:一份讲自己公司里发生了什么,一份讲里面的人和外面的人对 AI 的判断差多远。
头条 · 一份内部账本,一份预期鸿沟
第一份是就业侧。Anthropic 用自家雇佣记录、智能体遥测、产出指标、日历与招聘评分卡,外加 17 场员工访谈,给出这些数字:
技术部门里初级员工占比从 21% 降到 14%,初级技术招聘占比从 27% 降到 9%(2025 年初以来),2025 年 12 月起初级岗位发布量下降更明显;约三分之一的 ML 经理、五分之一的 SWE 经理说因 AI 减少了招聘。智能体工时在 2026 年 3 月首次超过人类工时;到 8 月,员工直接指挥的交互式智能体工时是人类员工的 6 倍,研究组织达 19 倍。每位工程师的代码提交量是 6 个月前的 5 倍;非技术员工的编码类智能体会话从 2025 年 8 月的每月 2 次增至 2026 年 5 月的 90 次。
另一面是人成了瓶颈:交互式会话约 80% 的时间是智能体在等人输入;即便非技术团队,读完自己智能体的输出也要占掉超过半个工作周;常备指令从几百条增至 8,500 条;写技能、写计划、搭监控这类「元工作」从占交互会话的 10% 升到 22%。组织形态也在动:中位员工会议时间比一年前多 20%,技术部门占总人数比例从 61% 降到 56%,工程师与产品经理之比约 17:1;招聘评分卡里提到「用 AI 工具的战绩」的比例,技术岗增至三倍、非技术岗四倍,「自主性与判断力」的提及增幅最大,领域专长的占比下降。
第二份是预期侧,样本是美国成年人 10,980 名(加权到全国代表性,线上样池)与 Anthropic 员工 1,334 名(未加权)。同一个技术,里面和外面的判断差了很远:认为 2030 年前 AI 能做出诺贝尔级发现,员工 91%、公众 39%;平均认为 AI 能做自己多少工作,员工 75%、美国工人 28%,超过一半员工认为能做到 80% 以上,而美国工人只有 5% 这么看;说任务只需「四分之一时间或更少」的,员工 59%、用过 AI 的上班族 26%,反过来觉得「跟不用 AI 一样久甚至更久」的占 29%、员工只有 5%;另有一处不属于问卷的直接回答:把回答映射成增长情景后,中位美国成年人隐含的 2030 年 GDP 增长是 5.4%、中位员工是 17.1%——这是模型映射出的情景,不是受访者给出的预测。
但有一处两组是一致的:预期 AI 可做自己 80% 以上工作的美国工人,平均预计 2030 年失业率 12.2%;暴露度每多 10 个百分点,预期失业率多 0.4 个百分点——员工给出的斜率一样。
口径四条:这是 Anthropic 自己的一手数据与内部问卷,样本是单一公司(且是前沿实验室),作者自己写明不可外推到全经济;「采纳智能体之后产出上升」存在选择偏差,作者声明采纳不是随机的、会高估效果;「75%」与「超过一半员工认为 80% 以上」是两个不同的统计量,不能合并成一句;另外流传的「90% 的代码由 Claude 写」是开发者账号口径,报告脚注写的是「合并进代码库的代码超过 80% 由 Claude 写」,两者范围不同。
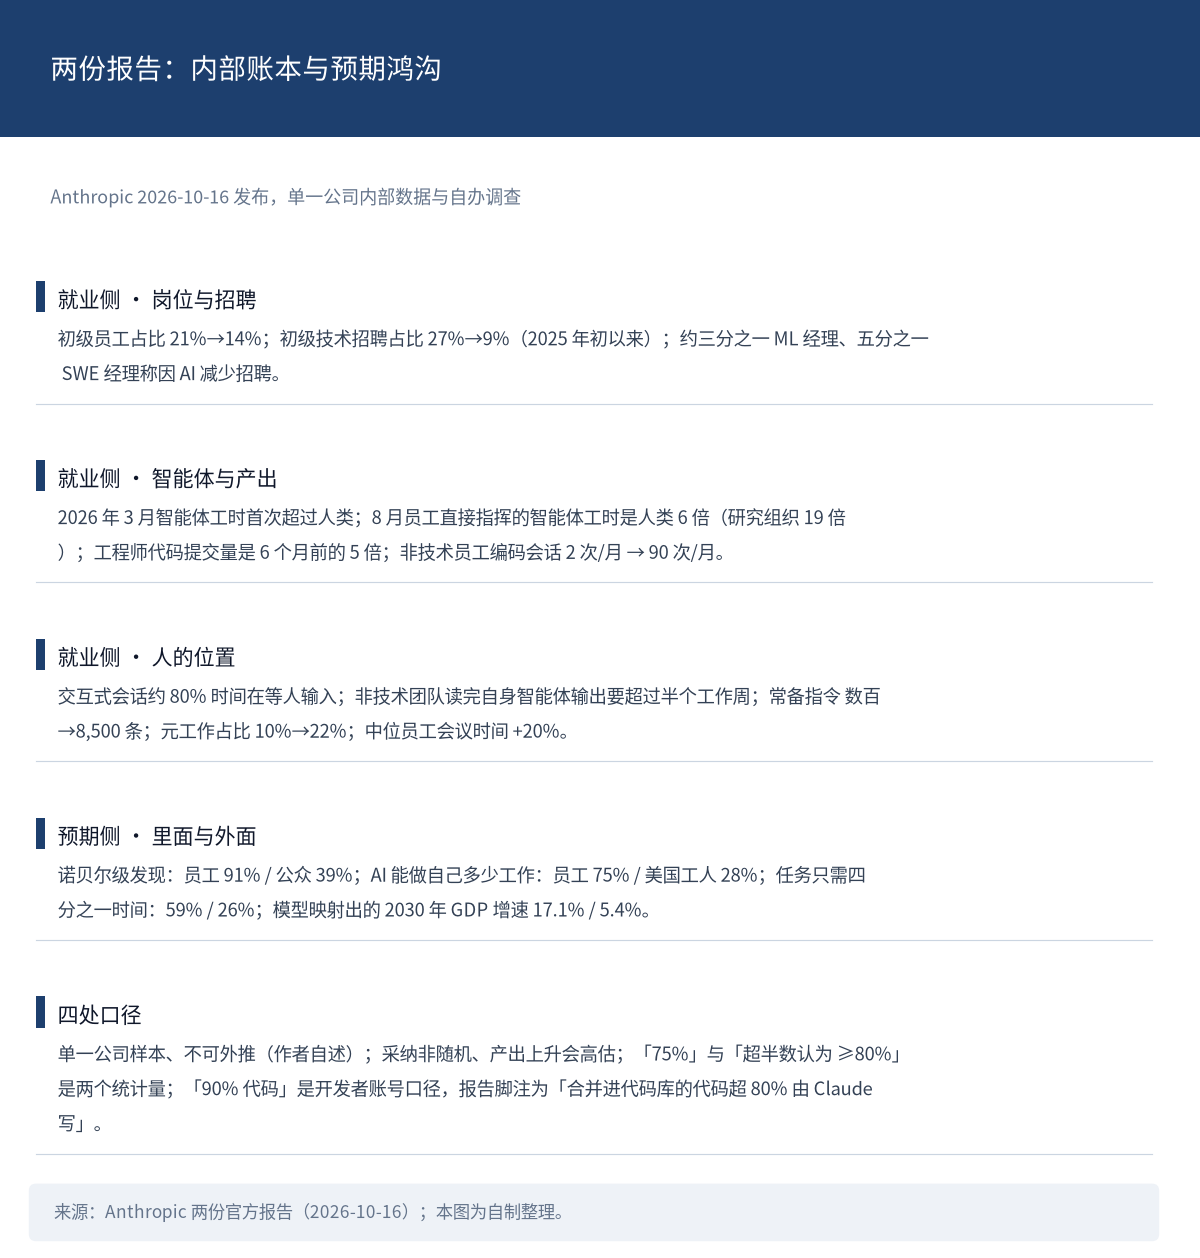
图 1:两份报告的关键数字与四处口径。来源:Anthropic 官方报告(2026-10-16,均为单一公司内部数据与自办调查);本图为自制整理。
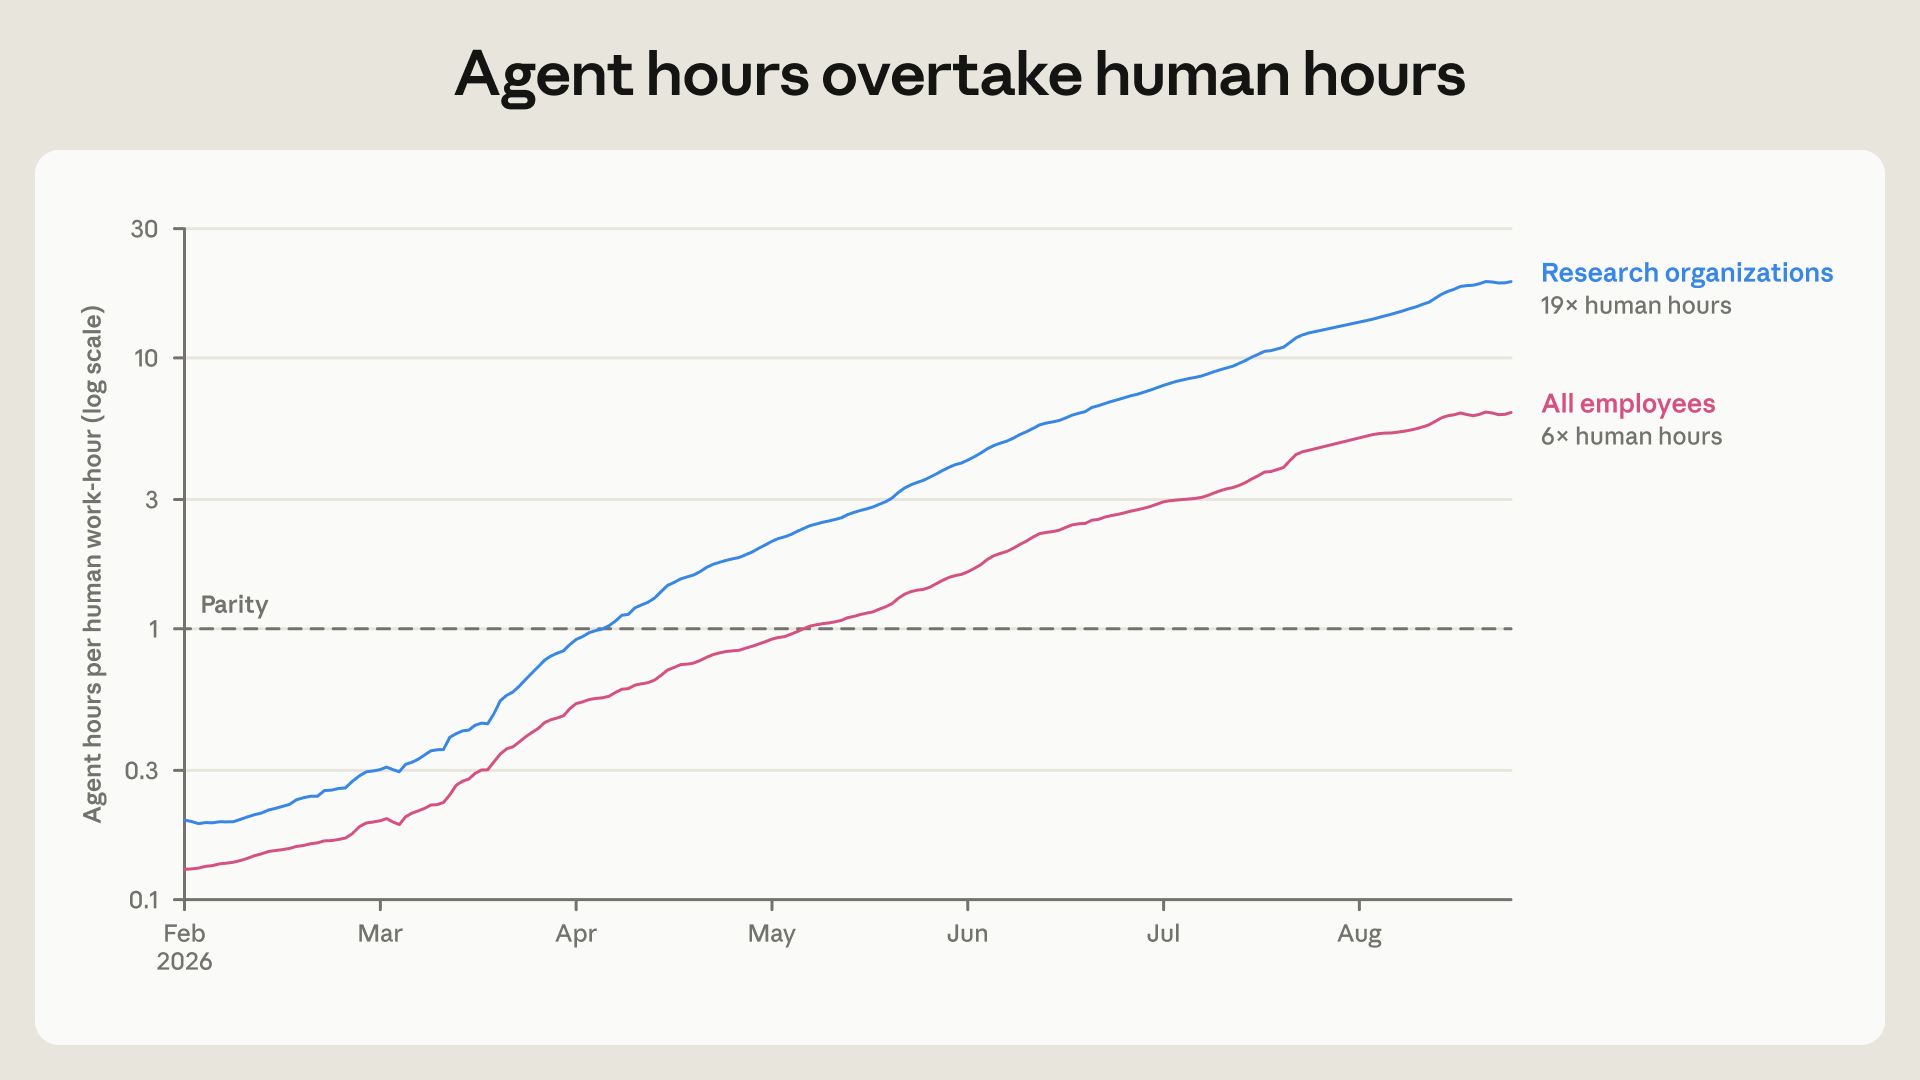
图 2:员工直接指挥的智能体工时与人类工时之比(2026 年 2—8 月,对数刻度)——研究组织 19 倍、全体员工 6 倍,虚线是 1 倍的持平线。来源:Anthropic《How employment is changing at Anthropic》Figure 2(内部遥测;单一公司样本,不可外推)。
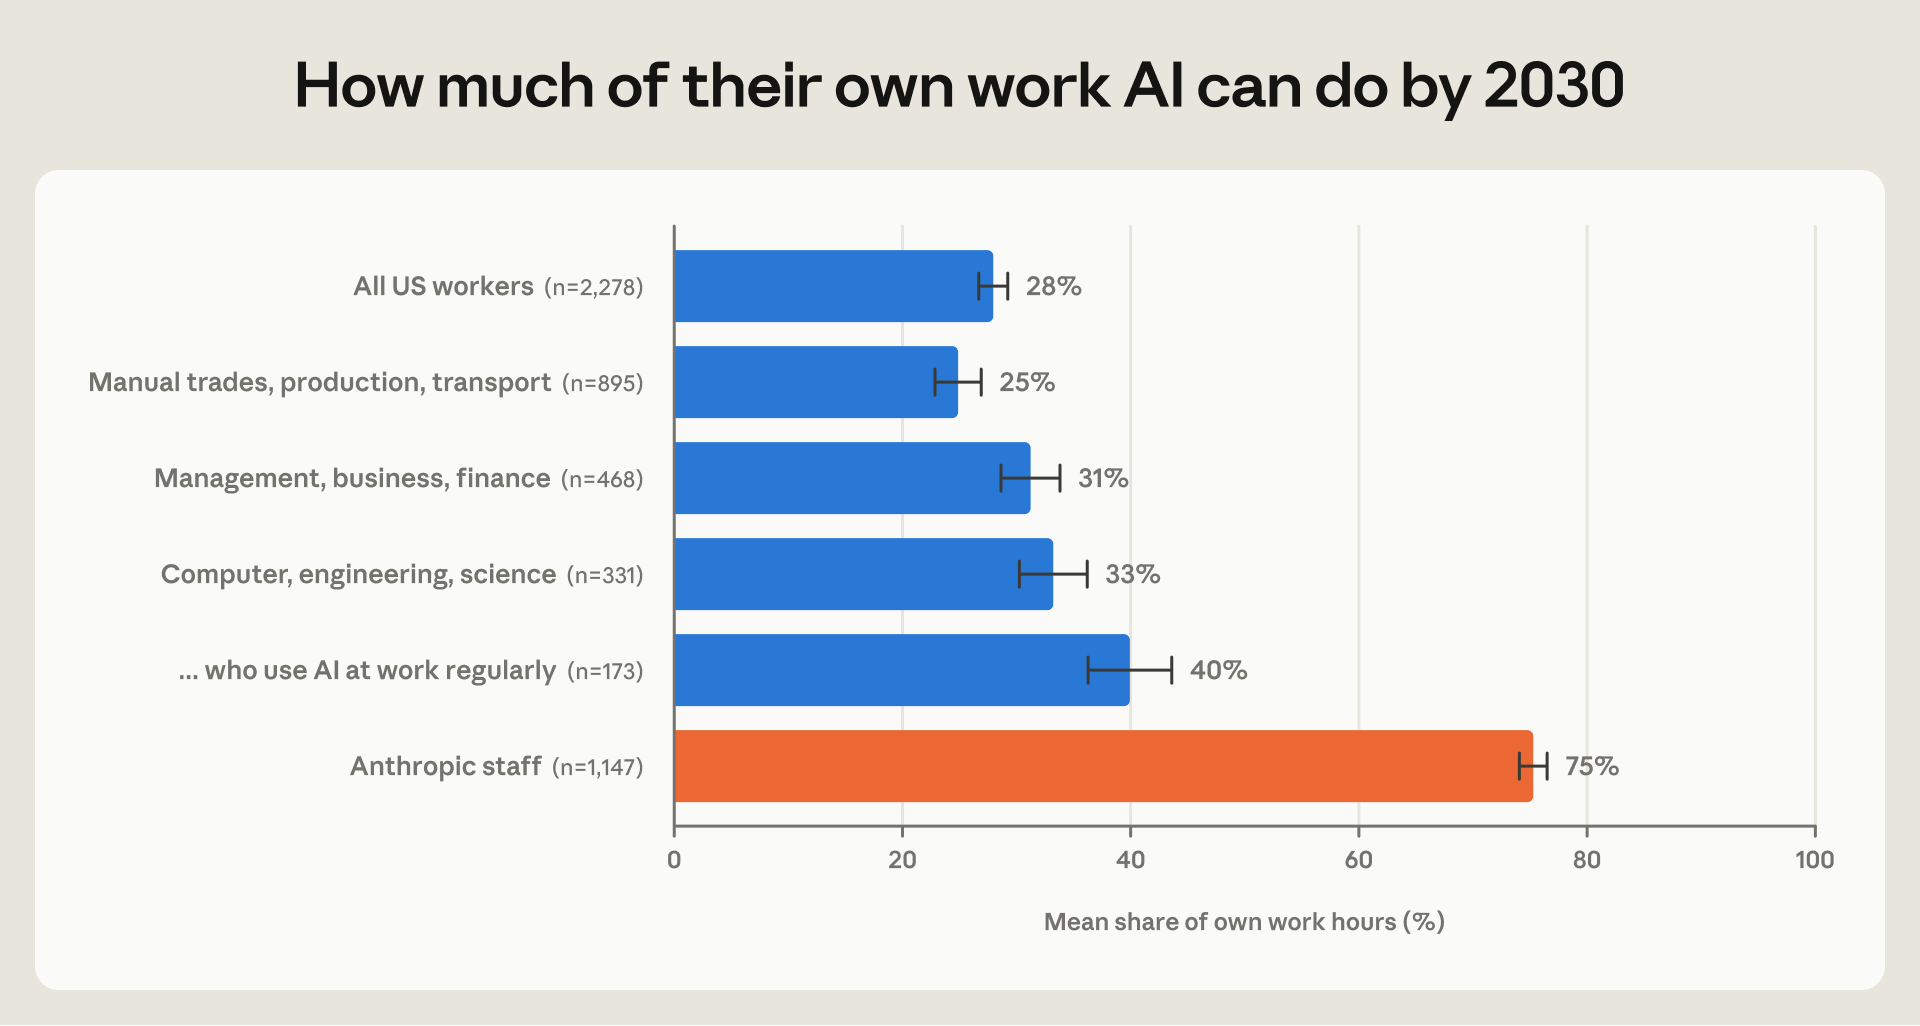
图 3:受访者认为 2030 年 AI 能承担自己多少比例的工作时长(含 95% 置信区间)。图内已标各组样本量:全部美国劳动者 n=2,278、Anthropic 员工 n=1,147(两份问卷总样本为 10,980 名美国成年人与 1,334 名员工)。来源:Anthropic《The AI expectations gap》Figure 5。
重点 · 五条
丹麦最高法院维持了一名 31 岁男子 18 个月监禁、不适用缓刑的判决:据彭博社报道,案件涉及 3.6 万余张 AI 生成图像,并牵出跨国调查,警方查明 273 名买家、逮捕 25 人。判据是这条最值得记的——人物是否虚构,不影响定罪与量刑,也就是「AI 生成、没有真实受害者」在这条路上不再是抗辩理由。要说清范围:这是丹麦首起此类定罪,判决书原文暂未见公开;本条只写法律判断与规模。
404 Media 的实测称,ChatGPT 的广告可以按邮箱地址、手机号或手机唯一标识符定向投放,定向还使用用户输入的提示词——而这些提示词,用户可能以为是私密的。报道提到 ChatGPT 约 10 亿月活,这是报道引用的口径、不是官方数字;OpenAI 的公开回应目前没有。
同一周同一个模型,三个榜三种说法。 Reflection 的 Beam 出现了三条不同口径:Artificial Analysis 给 30 分、称其居美国开源模型第二;Arena 说它在 Agent Arena 的开源模型里排第 12,净提升 −3.67%、误差 ±3.84%,统计上与基线无法区分;同一周 Arena 还宣布 Muse Spark Open 登顶 Code Arena 的 WebDev 美国开源第一。三个榜的任务、口径与样本都不同,各自的第一名也不是同一个模型,所以每次引用都要带榜名与指标名。顺带一句:Ollama Cloud 的「限时免费」只属该平台、有时间窗与地区条件,不等于模型免费。
Anthropic 向美国国会推介监管草案,叫停门槛定得很高。据 POLITICO 报道:只有在模型可预见造成超过 10 亿美元经济损失、或导致 50 人以上死亡或重伤,且风险特定源自生物武器、模型失控或严重网络攻击时,政府才可叫停模型;措辞沿用加州 SB 53 等现行法案条款。性质要说清:这是一家公司向立法者递交的建议,不是已提出的法案,也不代表监管机构立场。
Claude 揭开了 NIST 椭圆曲线种子的来源。Anthropic 称内部研究模型在不到半小时内查明:这批曲线的种子不是哈希结果,而是以 Unix 时间戳初始化的 C 库 lrand48 随机数生成器的输出,例如 P-256 需要 1842 次迭代。它不是什么也要说清:这解释的是种子怎么来的,不是曲线被攻破;除 P-256 以外的迭代次数表与研究正文暂未见可核对的公开版本。
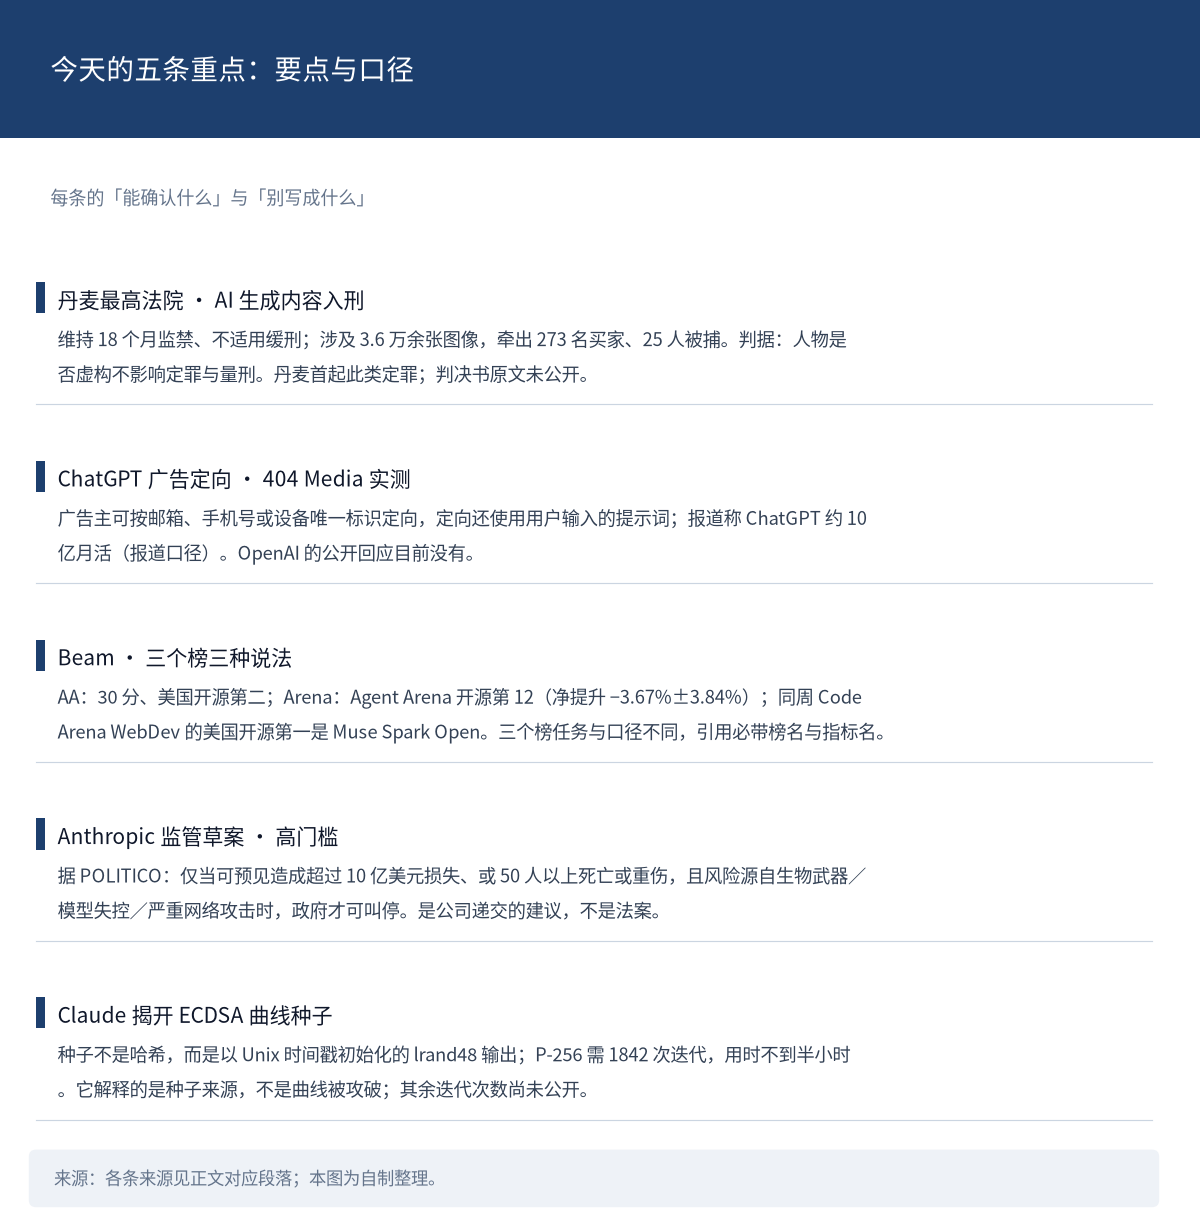
图 4:五条重点的要点与口径。来源:各条来源见正文对应段落;本图为自制整理。
速览 · 14 条
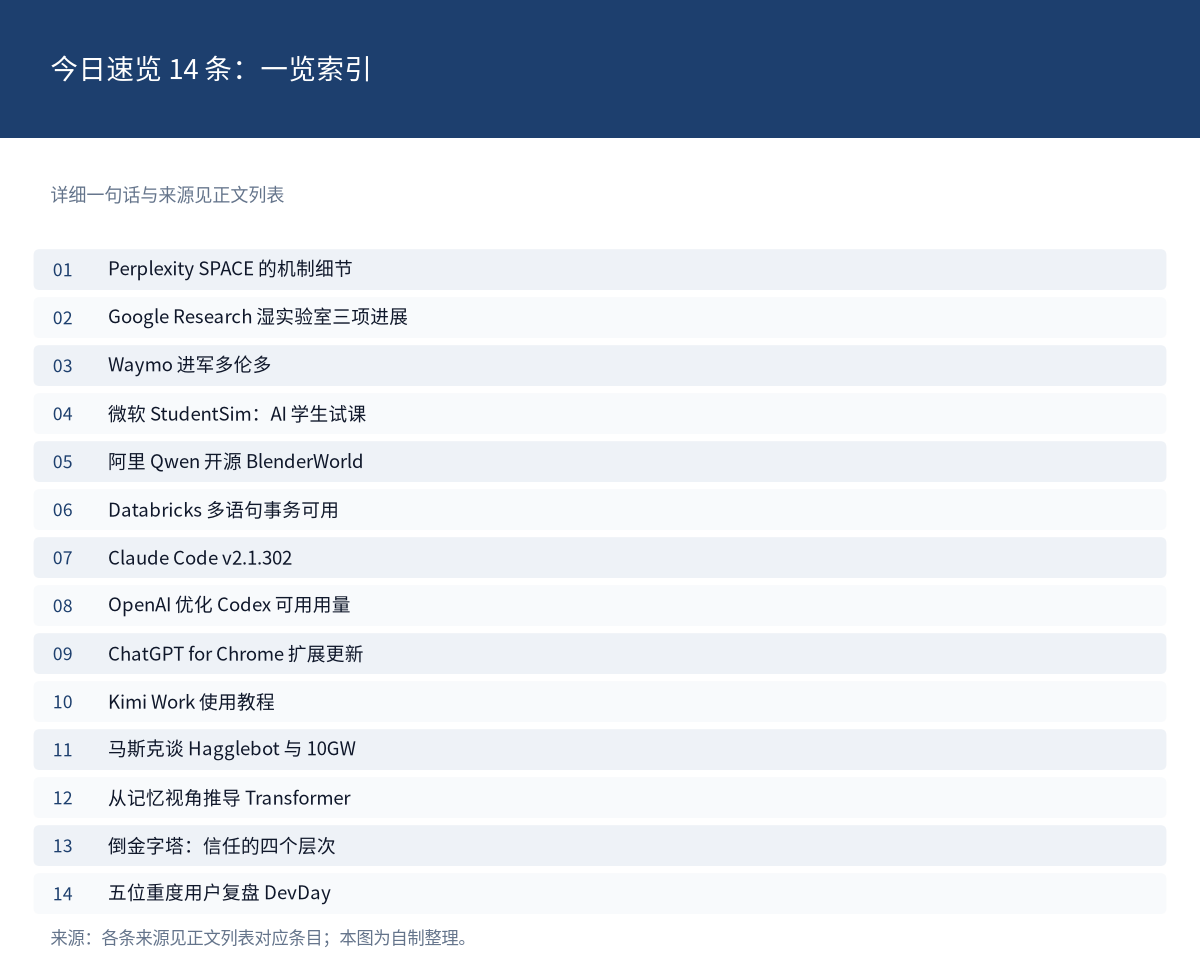
图 5:今日速览一览索引。来源:各条来源见下方列表;本图为自制整理。
- Perplexity 开源 SPACE 的机制补上了:每个任务跑在独立的 Firecracker microVM 里,凭证与出站流量控制在虚拟机之外,Apache 2.0,已在 GitHub 开源。来源:MarkTechPost(10-17)。属昨日那条的补充。
- Google Research 公布 AI 智能体在自主湿实验室的三项进展:VERID 框架、适配体闭环发现、全新蛋白结合剂设计。来源:Google Research 博客(10-16)。
- Waymo 宣布进军多伦多,目标 2028 年迎首批乘客,先以人工驾驶采集高精地图,与 Element Fleet Management 合作车队管理;公司称其车辆在严重伤害及以上事故中比人类驾驶少 95%,这是自述口径。来源:Waymo 官方博客(10-17)。
- 微软研究院提出 StudentSim:用基于去标识化学习记录的「AI 学生模拟器」替真人试课,两阶段训练,覆盖国际象棋、英语写作与数学,并配套 StudentSimEval。来源:IT之家(10-17)。
- 阿里 Qwen 开源 3D 建模基准 BlenderWorld:223 道题、2651 条标准,评测视觉智能体在 Blender 里完成真实创作任务,MIT 许可。来源:IT之家(10-17)。
- Databricks 的多语句事务正式可用,覆盖 Unity Catalog 托管的 Delta Lake 与 Apache Iceberg 表,多表多步骤工作流拿到原子保证。来源:Databricks 官方博客(10-17)。
- Claude Code 发布 v2.1.302:新增用环境变量指定自动模式分类器所用的模型,
/config可关闭或重开空闲压缩,并修复 Vertex 与 Bedrock 切换报错。来源:GitHub Releases(10-17)。 - OpenAI 称优化了 Codex 与 Work 的「实际可用用量」:子智能体之间复用上下文、延长上下文缓存、改进请求路由以提高缓存命中率。来源:Tibo(10-17)。
- ChatGPT for Chrome 扩展更新至 1.26.1005.11759,可读取多个已打开标签页,面向所有用户开放、无需付费订阅。来源:IT之家(10-17)。
- 月之暗面发布本地 AI Agent「Kimi Work」的使用教程:可读本地文件、操作浏览器与常用工具。来源:月之暗面公众号(10-16)。
- 马斯克称在开发企业议价机器人 Hagglebot,自称可把企业成本效率提高 5% 甚至更多,并按他的测算每年最高可省 6 万亿美元;同期他称 xAI 到 2027 年底算力目标可能超过 10GW。来源:IT之家与其本人账号(10-17)。两条都是个人宣称,不是官方材料。
- 一篇从记忆视角推导 Transformer 的分析:用干扰信号比给出容量量级——外积约 64 条、最优线性与 ReLU MLP 约 128 条、平方 ReLU 约 2700 条、self-attention 约 120 万条(64 维键)。来源:作者博客(10-15)。容量数字是作者的分析。
- 一个「倒金字塔」框架:主张把信任智能体产出的精力,按投入从多到少放在代码库改进、静态分析、文字性指导、人工审查四层上。来源:作者帖(10-17,个人框架、非实测结论)。
- 五位 AI 重度用户复盘 OpenAI DevDay 2026 之后的真实使用体验。来源:Latent Space 新栏目(10-17,观点)。
积木观察
今天最值得记的不是某个数字,而是两份报告的对照关系。Anthropic 把自己的账本摊开:初级岗位在收窄,智能体工时已经是人的数倍,而人成了瓶颈——80% 的时间在等输入;可同一批人比外面的公众乐观一个量级,隐含 GDP 增速 17.1% 对 5.4%。这个落差本身就是信息:身在技术里的人与不在其中的人,用的不是同一套参照物。
给读者三条可执行的。做团队规划的,把「初级岗位」与「元工作」放在一起看——那边的元工作占比从 10% 涨到 22%,说明省下来的时间并没有消失,而是转成了写技能、搭监控这类新活。读这类公司自曝报告时,先看它自己标了什么偏差:这份写了「采纳不是随机、会高估效果」,也写了「单一公司、不可外推」。判断模型强弱时,把榜名和指标名写全——今天那个模型在三个榜上是三种位置,跨榜拼一句等于没说。
结尾互动
如果一份来自前沿实验室的内部账本说「人成了瓶颈」,你觉得这说明工具还不够好,还是组织的协作方式还没跟上?
来源链接
- 官方 · Anthropic《How employment is changing at Anthropic》(2026-10-16):https://www.anthropic.com/research/employment-at-anthropic
- 官方 · Anthropic《The AI expectations gap》(2026-10-16):https://www.anthropic.com/research/ai-expectations-gap
- 官方 · Anthropic(ECDSA 曲线种子来源研究):https://www.anthropic.com/research/ecdsa-curve-origins
- 官方 · Databricks 博客、Google Research 博客、Waymo 官方博客、Claude Code Releases、Google Developers Blog
- 第三方 · Artificial Analysis 与 Arena(Beam、Muse Spark Open 的榜单口径)
- 独立 · 彭博社(丹麦案,经转述)、404 Media(ChatGPT 广告定向)、POLITICO(Anthropic 监管草案)、MarkTechPost(Perplexity SPACE)