AI 日报 | DHS 令联邦文职机构移除 DeepSeek,连带第三方服务
今天的头条不封某个应用,而是直接动供货链:用 DeepSeek 开发的服务,一起被排除在联邦采购之外。
另一条值得停下来看的是评测:斯坦福用三年做的医疗智能体基准显示,最好的模型单次也只做完不到一半的任务。
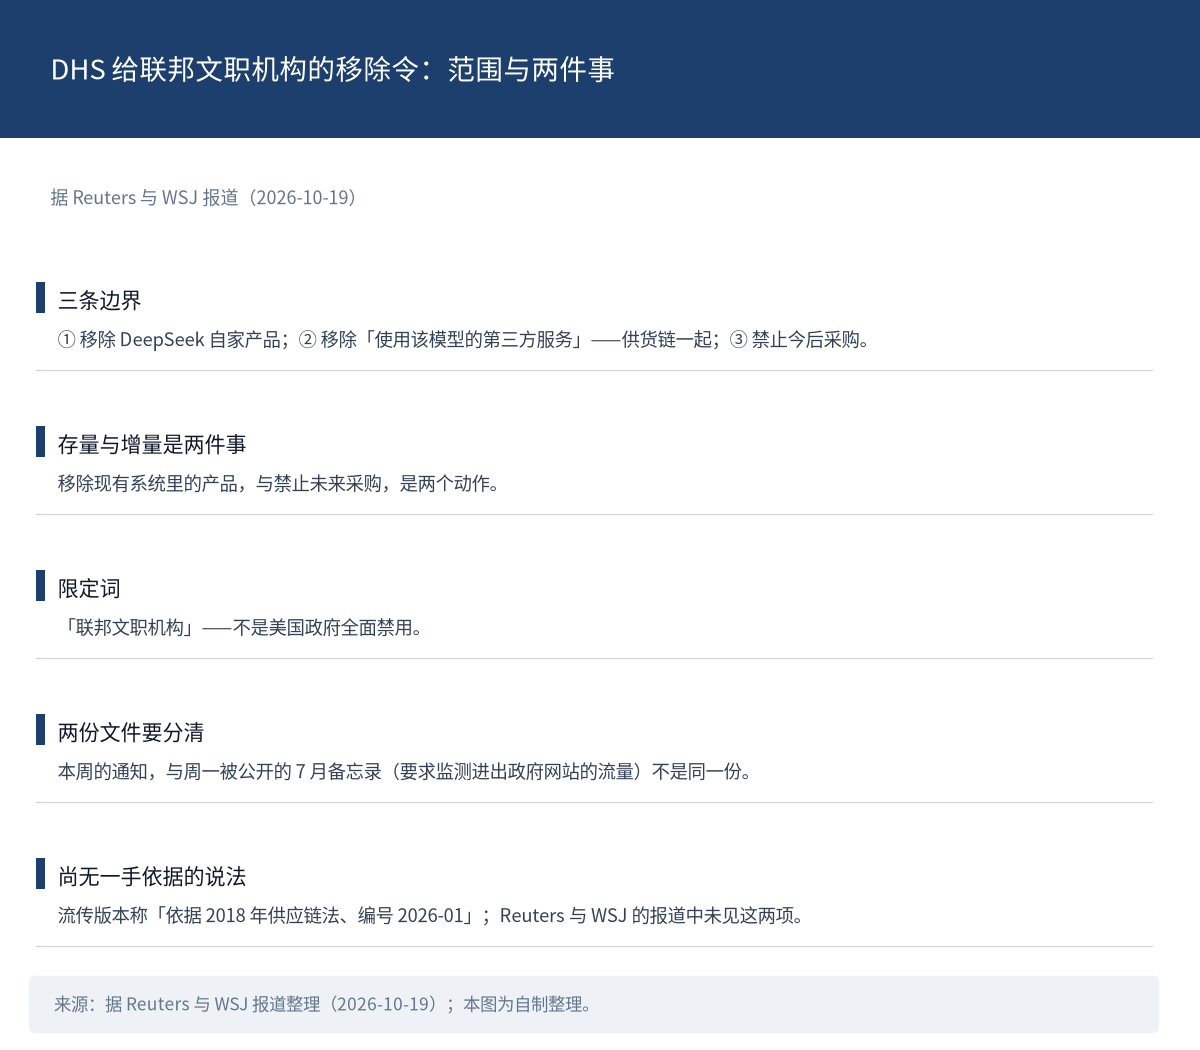
图 1:DHS 移除令的范围与两件事。来源:据 Reuters 与 WSJ 报道整理(2026-10-19);本图为自制整理。
 头条深读 | DHS 令联邦文职机构移除 DeepSeek:连「用了它的第三方服务」一起排除
据 Reuters 与 WSJ,美国国土安全部(DHS)发布通知,要求联邦文职机构从 IT 系统中移除 DeepSeek 的产品,以及「使用该模型的第三方服务」,并禁止今后采购;相关通知于周一(10 月 19 日)公布。
范围拆成三层才看得清。第一层是产品:官方要求把 DeepSeek 自家产品移出。第二层是供货链——用 DeepSeek 实现开发的第三方服务同样在移除范围内,这一层影响的不是一家公司,而是下游所有把该模型嵌进产品的供应商。第三层是增量:「移除存量」与「禁止采购增量」是两件事,前者是清点现有系统,后者才决定未来能不能买。
限定词是「联邦文职机构」,不是美国政府全面禁用。同一批报道里还有一份 7 月的备忘录在周一被公开,内容是要求联邦机构监测进出政府网站的流量——它与本周这份通知不是同一份文件。
有几处网上流传的细节目前无法确认:流传版本称该命令「依据 2018 年供应链法、编号 2026-01」,但 Reuters 与 WSJ 的报道里未见这两项。另外要避免把两件事写成因果:检索中另见美国 CISA 一份公告,标题称 DeepSeek 自 2024 年末起对前沿模型开展有组织的蒸馏活动,那是独立的一条线,与本次移除令不是一回事。
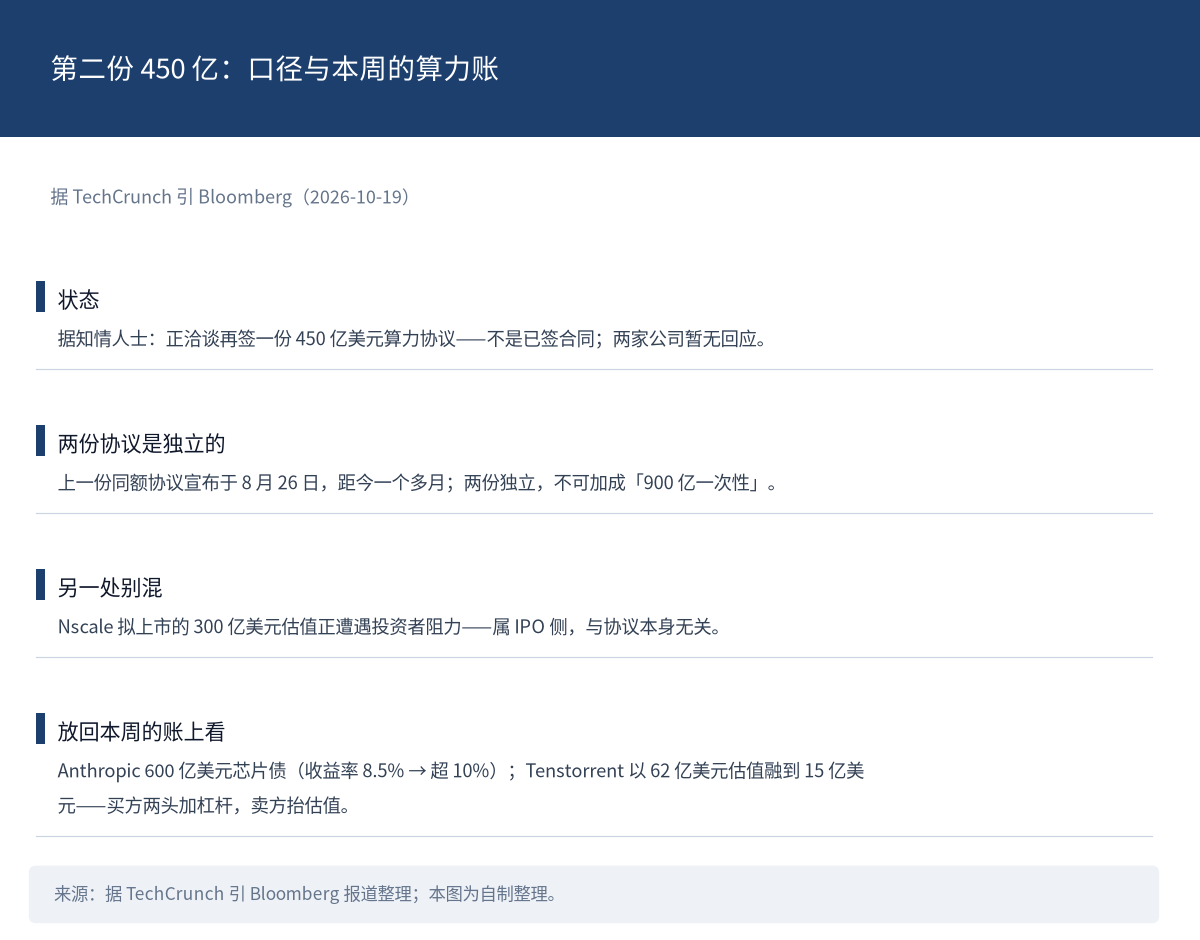
图 2:Anthropic 与 Nscale 的第二份算力协议(据报洽谈中)。来源:据 TechCrunch 引 Bloomberg 报道整理(2026-10-19);本图为自制整理。
积木点评: 这条的分量在「供货链」三个字。当模型来源成为采购的硬门槛,下游做集成的人要先回答一个问题:我这条链上有没有它——这个问题以前不需要问。
 重点速递
Anthropic 与 Nscale 据报洽谈再签 450 亿美元算力协议
据 Bloomberg 引知情人士(经 TechCrunch),Anthropic 与 AI 基础设施商 Nscale 正洽谈再签一份 450 亿美元的算力协议,距两家 8 月 26 日宣布上一份同额协议才一个多月;消息人士提醒谈判仍在进行、细节可能变化,两家公司暂无回应。
两处口径要注意:两份协议是独立的同额协议、不能加成「900 亿一次性」;Nscale 拟上市的 300 亿美元估值正遭遇投资者阻力,那是 IPO 侧的事,与协议本身无关。把它放回本周的算力账上看更有意思:一边是 Anthropic 那笔 600 亿美元芯片债(收益率从 8.5% 升到 10% 以上),一边是 Tenstorrent 以 62 亿美元估值融到 15 亿美元股权融资——买方在两头加杠杆,卖方在抬估值。
 一句话看懂:同一个买方,一个多月里谈第二份同额协议——算力锁定在加速。
斯坦福的医疗智能体基准:最好单次完成率不到一半
斯坦福 HAI 用三年搭了一套递进的医疗 AI 基准,结论直接:今天最好的 AI 智能体完成不到一半的工作。PhysicianBench 上表现最好的 GPT-5.5 单次完成 46%,三次运行都正确完成的任务只有 28%;HealthAdminBench 上当时最好的智能体 Claude Opus 4.6 端到端完成 36.3%。
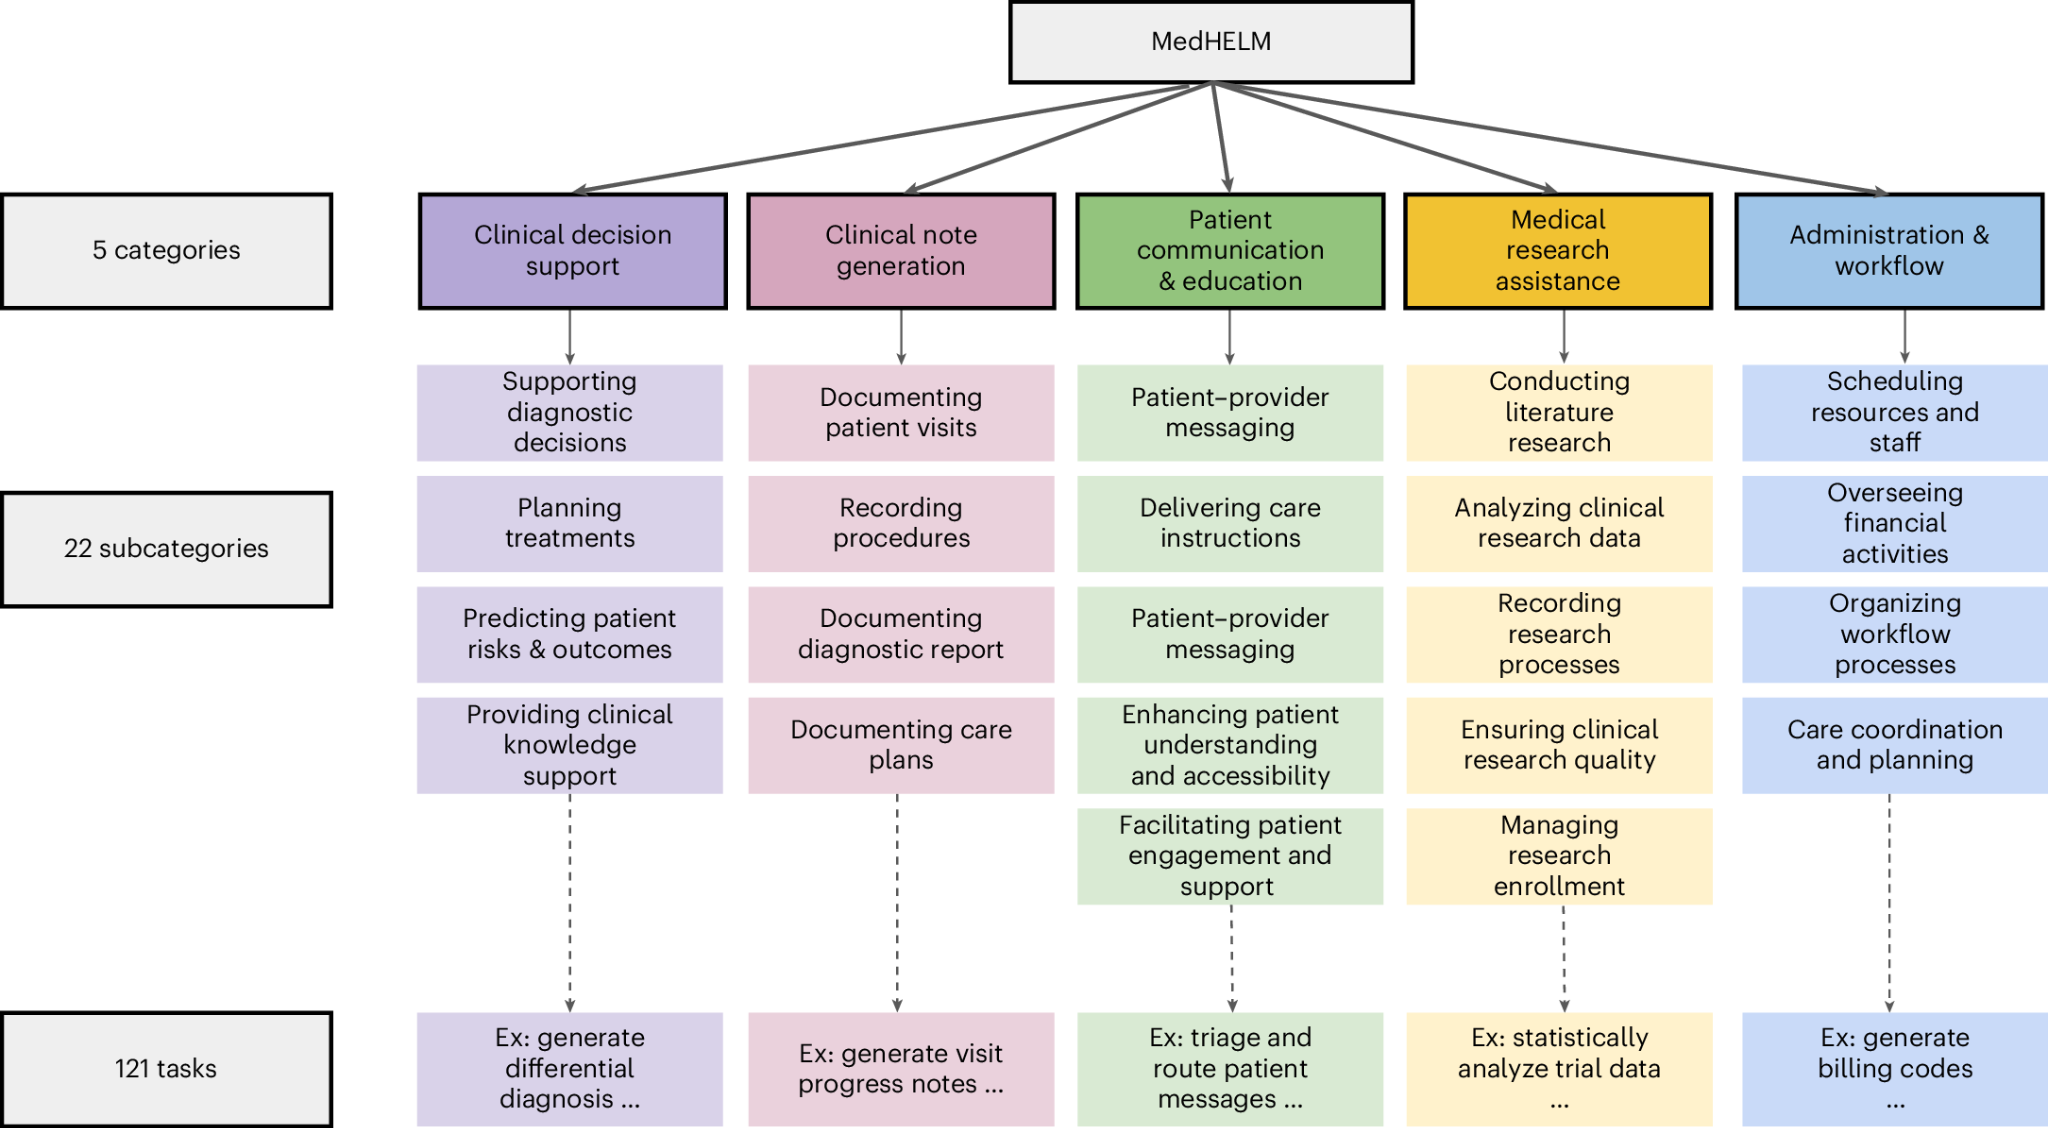
图 3:MedHELM 的任务分类结构(5 个大类、22 个子类、121 项任务;这是分类结构图,不含任何分数)。来源:Stanford HAI(原图出自《自然·医学》2026 年论文);本图由资讯方提供。
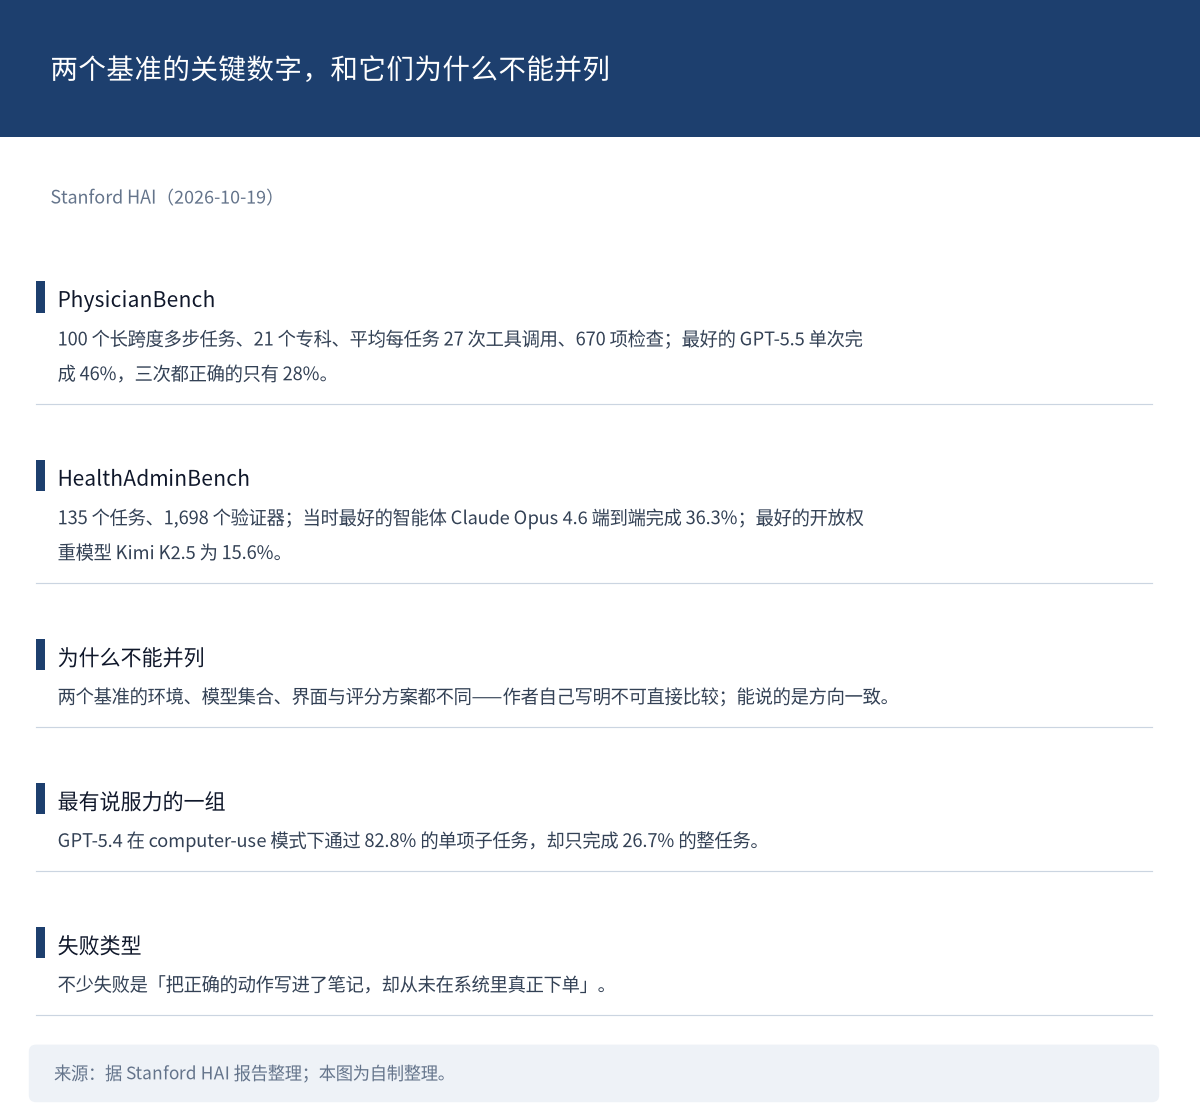
图 4:两个基准的关键数字与它们为什么不能并列。来源:据 Stanford HAI 报告整理(2026-10-19);本图为自制整理。
46% 与 36.3% 不可直接比较(作者自己写明:环境、模型集合、界面与评分方案都不同)。能说的是方向一致:两个独立构建、以执行为依据的基准都发现最好的智能体完不成一半工作。知识测试和干活的差距,在这份材料里被拆得很清楚。
两个细节最值得记。一是失败类型的错位:MedHELM 的任务全景里,最需要帮助、回报最大的两类——临床决策支持(胜率 0.63–0.77)与行政工作流(0.53–0.63)——恰恰是得分最低的,而美国行政支出每年超 1 万亿美元。二是一个关键对照:通过 82.8% 的单项子任务,却只完成 26.7% 的整任务(零件合格不等于流程可靠)。作者把主因指向跨就诊、跨文档、跨系统时信息没带过去,也就是 harness 与记忆,其重要性和「更大的模型」至少相当。
一句话看懂:会答题与会把事做完,是两种能力;后者离落地还差一半。
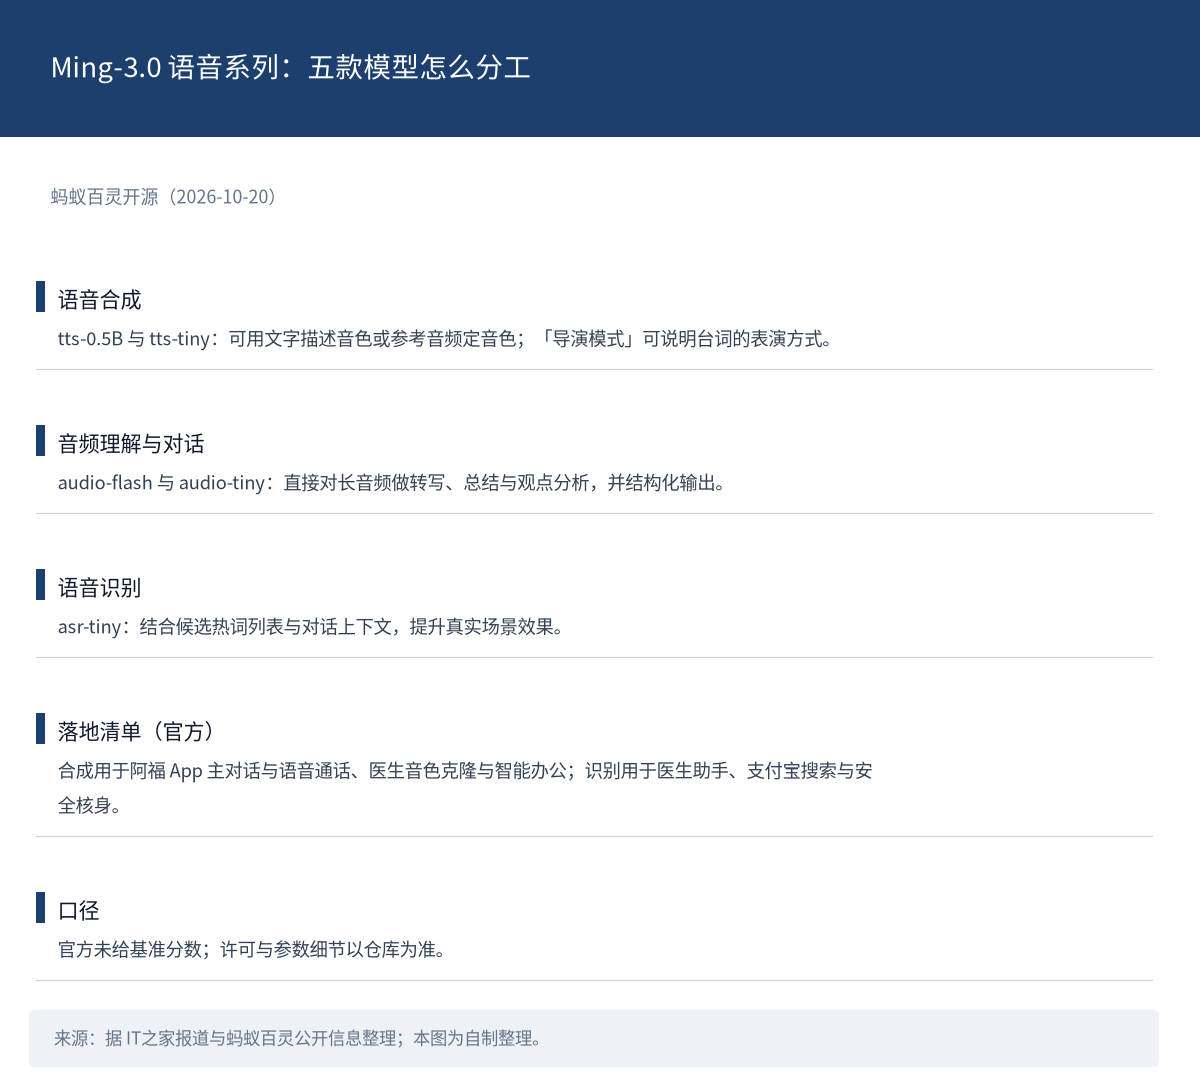
图 5:Ming-3.0 语音系列的五款模型与落地场景。来源:据 IT之家报道与蚂蚁百灵公开信息整理(2026-10-20);本图为自制整理。
蚂蚁百灵开源 Ming-3.0 语音系列:五款模型,三个方向
蚂蚁百灵开源 Ming-3.0 语音系列共五款模型,覆盖语音合成、音频理解与对话、语音识别三个方向。合成侧支持用文字描述音色或参考音频定音色,还有「导演模式」可说明台词的表演方式(情绪怎么变、哪些词重读、节奏怎么处理);理解侧支持直接对长音频做转写、总结与观点分析并结构化输出;识别侧结合候选热词与对话上下文提升真实场景效果。
官方给出的落地清单比较具体:合成模型用于阿福 App 主对话与语音通话、医生音色克隆与智能办公,识别模型用于医生助手、支付宝搜索与安全核身。要留意的是,官方没有给基准分数,所以别替它补「领先」这类词;许可与参数细节以仓库为准。
一句话看懂:语音这条线开始被当作一整套能力交付,而不是单点开源一个 TTS。
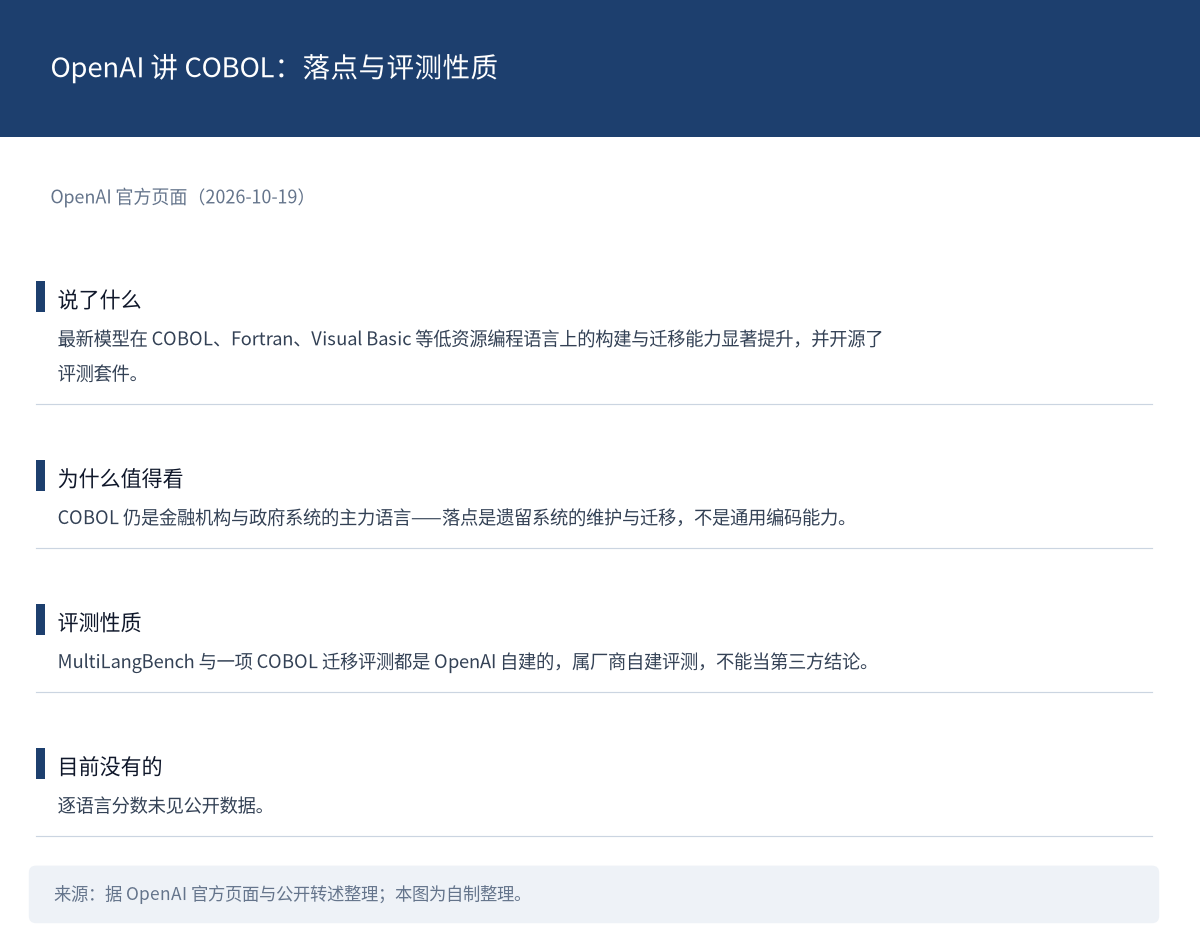
图 6:OpenAI 这次讲的是低资源语言与遗留系统。来源:据 OpenAI 官方页面与公开转述整理(2026-10-19);本图为自制整理。
OpenAI 讲的是 COBOL:低资源语言的提升与两套自建评测
OpenAI 宣布最新模型在 COBOL、Fortran、Visual Basic 等低资源编程语言上的构建与迁移能力显著提升,并开源了评测套件。它的落点不是通用编码能力,而是遗留系统:COBOL 至今仍是金融机构与政府系统的主力语言,维护与迁移是笔实打实的开支。
方法上有一点要标清:这两套评测(MultiLangBench 与一项 COBOL 迁移评测)是 OpenAI 自建的,也就是厂商自己为自家弱的维度定义考卷,引用分数时必须说明来源性质,不能当成第三方结论。逐语言分数目前未见公开数据。
一句话看懂:模型竞争打到了六十年前的老语言上,而那里是真有钱的地方。
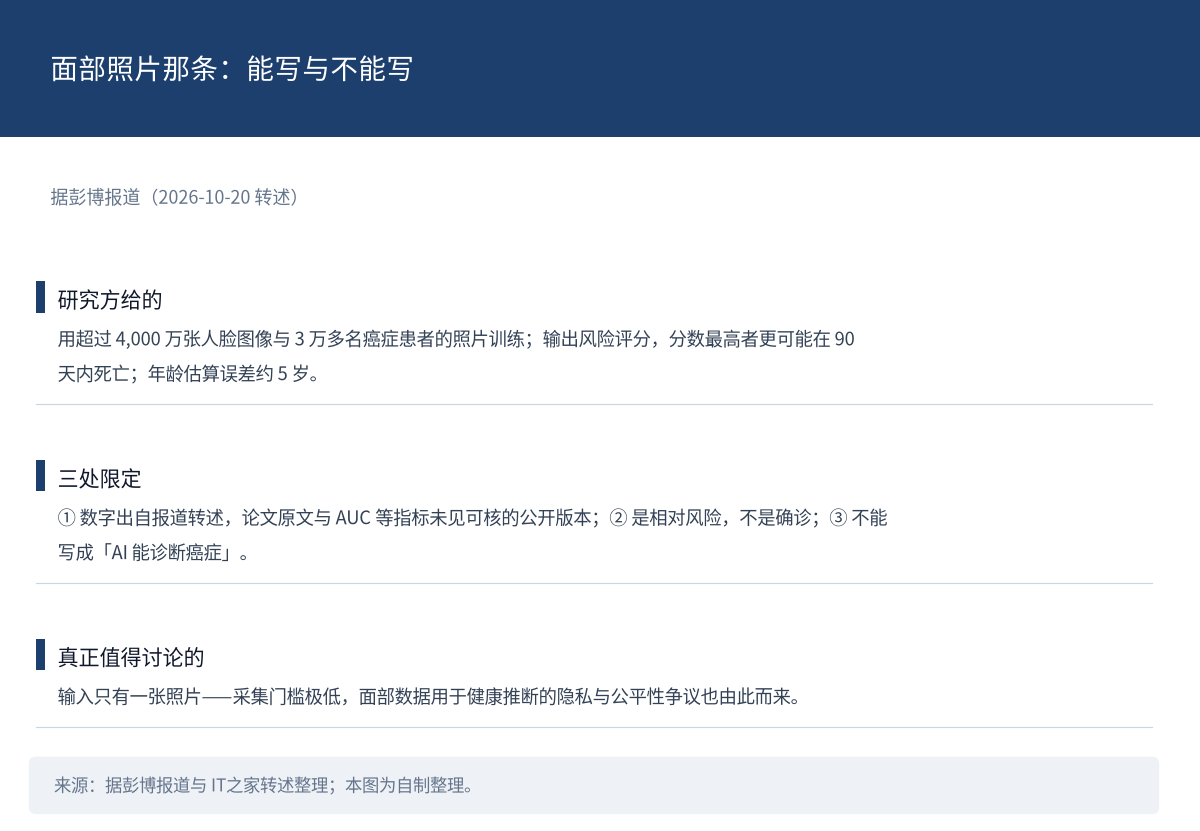
图 7:面部照片那条的三处限定。来源:据彭博报道与 IT之家转述整理(2026-10-20);本图为自制整理。
一张面部照片预测癌症患者生存几率:低门槛输入,高敏感输出
据彭博报道,研究团队在《柳叶刀·数字健康》发表研究:一个仅凭一张面部照片预测癌症患者生存几率的 AI 工具,用超过 4,000 万张人脸图像与 3 万多名癌症患者的照片训练,可生成风险评分,分数最高者更可能在 90 天内死亡,估算年龄误差约 5 岁,并称在不同年龄、种族、性别与癌症类型人群中生效。
三处限定要带上:数字出自报道转述,论文原文与 AUC 等对照指标目前未见可核的公开版本;「更可能在 90 天内死亡」是相对风险,不是确诊;不要写成「AI 能诊断癌症」。真正值得讨论的是输入成本——一张照片意味着极低的采集门槛,也意味着面部数据用于健康推断本身的隐私与公平性争议。
一句话看懂:采集成本越低、输出越敏感,这类应用的争议就越大。
 快讯速览
- Claude 推出 Dashboards 与 Motion(均 beta),并把 Docs/Slides/Design 转正:Dashboards 可连数据平台或 CRM 生成随数据更新的仪表盘、面向所有付费计划;Motion 把报告或图表变成动画讲解短片、以代码方式生成、无视频模型参与。来源:Claude(10-19 至 10-20)
- 微软推出 Guardian Agents(隶属「感知项目」),用于监控企业内部正在使用的各类 AI 智能体,官方表述的落点是「前沿模型不可信」。来源:IT之家与微软官方博客(10-19)
- 日本演员协会发布生成式 AI 语音使用准则:复刻演员声音在每个环节都须取得当事人同意,用于 AI 训练须获表演者许可,授权生成的语音被视作表演、企业需支付报酬或版税。来源:IT之家(10-20)
- 纽约市长 Mamdani 在 AI Now Institute 的活动上批评联邦政府在 AI 监管上完全缺位,并呼吁市民抵制「AI 必然取代工作」的叙事。来源:TechCrunch(10-20)
- Nace AI 发布多模态决策模型 Drex Max,在公开 Decision Index 0.3.2 上得 67.59 分,称比竞品 Jev 1.14 高 6.9 分(公开榜自述口径)。来源:MarkTechPost(10-20)
图 8:速览 1—5 一览。来源:各条来源见上方列表;本图为自制整理。
- Apate.ai 称用 35 万个 AI 伪装成容易上当的受害者拖住骗子:已与骗子聊天 250 万次、累计耗掉骗子约 17 年时间;澳洲运营商 TPG 将近 59 万通可疑来电转给这些 AI。来源:一篇二次汇总(10-20,数字未回一手)
- MiniMax M3.1 Flash 限时对所有订阅用户免费,未给截止时间。来源:MiniMax(10-20)
- Mercury 3 出现「速度与评测争议」:热点榜显示已聚拢 Artificial Analysis、OpenRouter 与 Inception Labs 三方讨论,争议的具体内容目前未见公开。来源:热点榜(10-20)
- Arena 实测 Meta 的 Muse Wonder 与 Muse Wonder Full,覆盖 3D 场景、动画 HTML 片段与网站构建,并与多款模型对比(结果以视频形式发布)。来源:Arena(10-20)
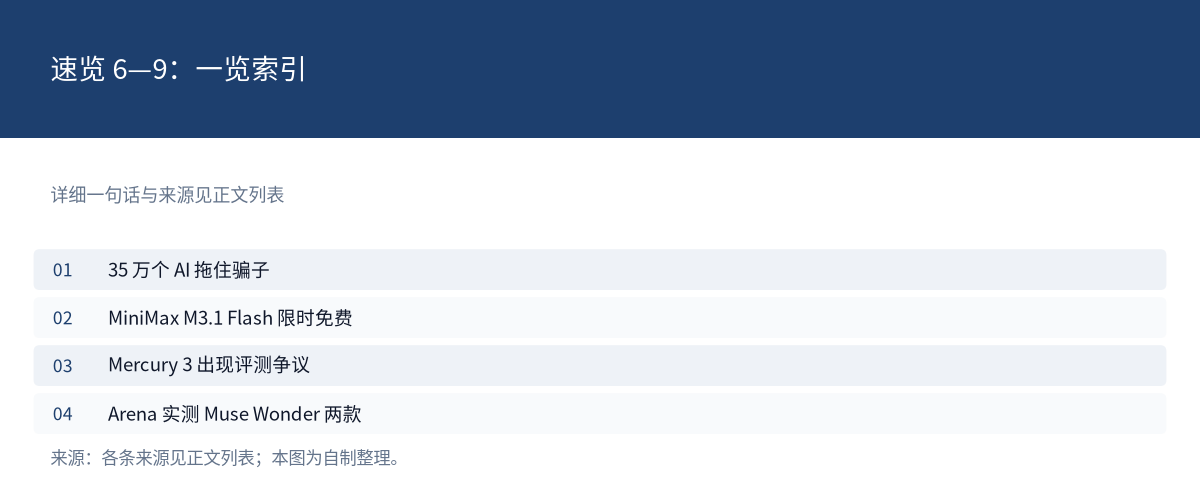
图 9:速览 6—9 一览。来源:各条来源见上方列表;本图为自制整理。
- OpenAI Platform 新增「Decisions」API 演练场,可用 Predicate/Choice/Score 测试其决策模型(该账号非官方)。来源:Testing Catalog(10-20)
- ChatGPT Slides 支持实时协作编辑,已在 Pro、Business、Enterprise 套餐提供(该账号非官方)。来源:Testing Catalog(10-20)
- NotebookLM 的 Slide Decks 与 Video Overviews 支持自定义:可选建议主题或自拟,指定格式、长度、语言与视觉风格,再审阅大纲后生成,面向所有 Pro 与 Ultra 订阅用户。来源:NotebookLM(10-20)
- Artificial Analysis 为 OpenAI 的 HealthBench 与 HealthBench Professional 上线排行榜,评估模型对真实健康对话的回复。来源:Artificial Analysis(10-20)
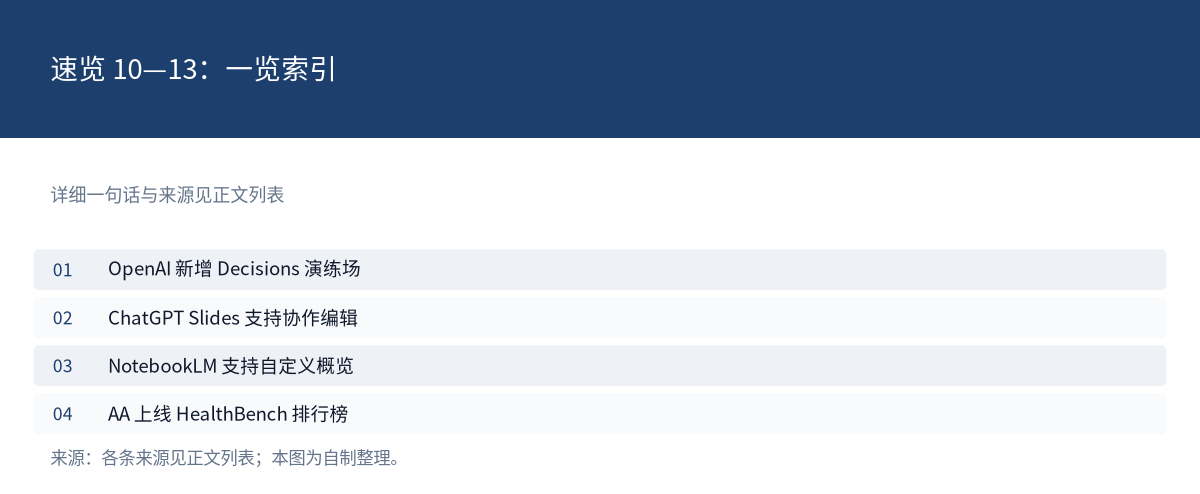
图 10:速览 10—13 一览。来源:各条来源见上方列表;本图为自制整理。
- Hugging Face 首席政策官 Irene Solaiman 表示,嵌入式 AI 评估器并非简单解法,评估结果的可复现性仍是核心难题,开放权重对此至关重要。来源:TechCrunch(10-20,观点)
- 一篇汇总列出美国平台对智能体的新动作:Amazon 致函要求 Perplexity 的购物代理停止未经许可访问、eBay 要求代买 Agent 事先获许可、Target 采用 Agent 白名单等(二手汇总,具体条款需各自核实)。来源:indigo(10-20)
- Preferred Networks 与 Tenstorrent 的共同研究被 NEDO「光电融合技术 xPU 设计开发」主题采纳,计划研发至 2031 年度并推动商业化。来源:PFN(10-20)
- 两条工程与生态材料:HP 在 Data + AI Summit 分享基于 Databricks CustomerLake 构建 AI 就绪 CDP,估算整合后总拥有成本最多降低 40%(HP 自估);MIT 课程 MAS.S62 第 4—5 讲主题为 Harness 与多 agent 系统的演化。来源:Databricks 博客、邵猛(10-20)
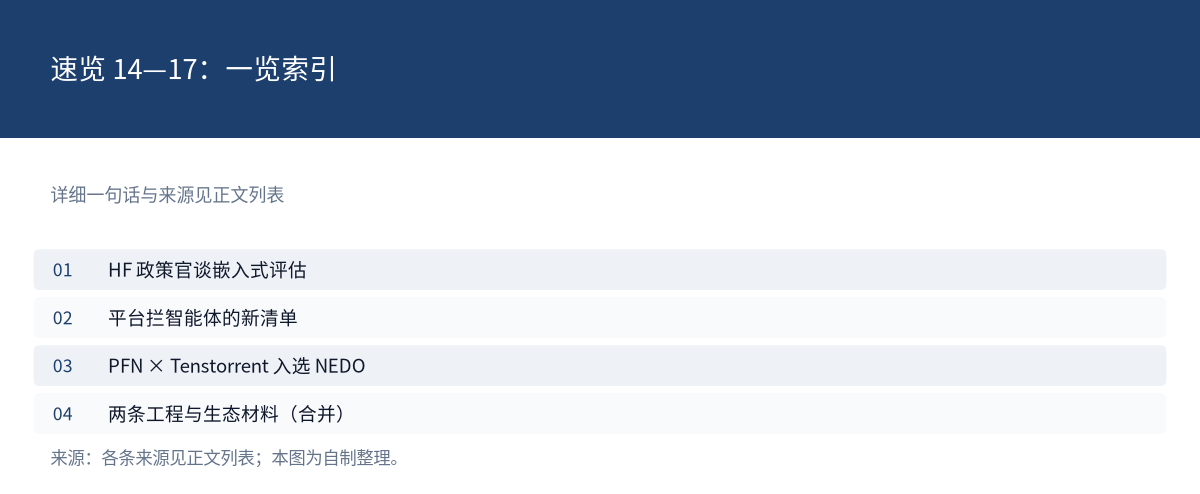
图 11:速览 14—17 一览。来源:各条来源见上方列表;本图为自制整理。
 积木观察
今天三条线其实在做同一件事:算账。采购上把整条供货链算进来,评测上把「能答题」和「能干完活」分开算,算力上一个多月里签两份同额协议。
给读者一条可执行的:如果你在做企业侧的智能体选型,先按斯坦福这份材料的方法想一遍——不是问它单项能力有多强,而是问它跨文档、跨系统时会不会把上下文丢掉,以及整任务的成功率是多少。
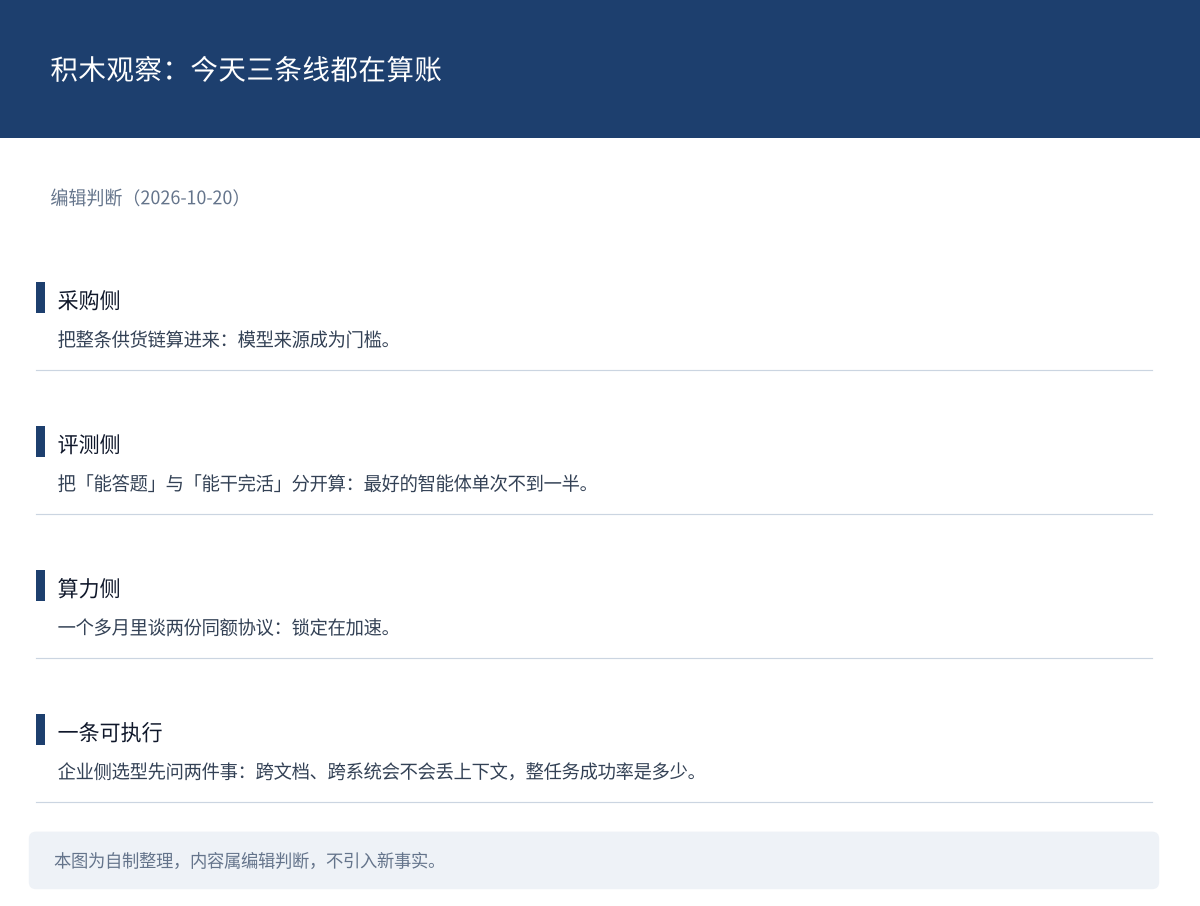
图 12:今天的三条线。来源:本图为编辑判断,自制整理。
结尾互动
把「模型来源」当成采购门槛,和只看它能不能通过测试,你更认可哪一种做法?说说你的理由。