AI 日报 | 10-21:DeepSeek 开源 DeepInfer,但只给了离线版
今天最值得看的是「交出来多少」:DeepSeek 把支撑自家生产服务的推理框架开源了,但官方明说这次只给离线推理版,还列了三项没包含。
另一条同样在划边界:Claude 用 64 小时设计出蝎子毒素的结合剂,官方却先声明「结合不等于解毒」。
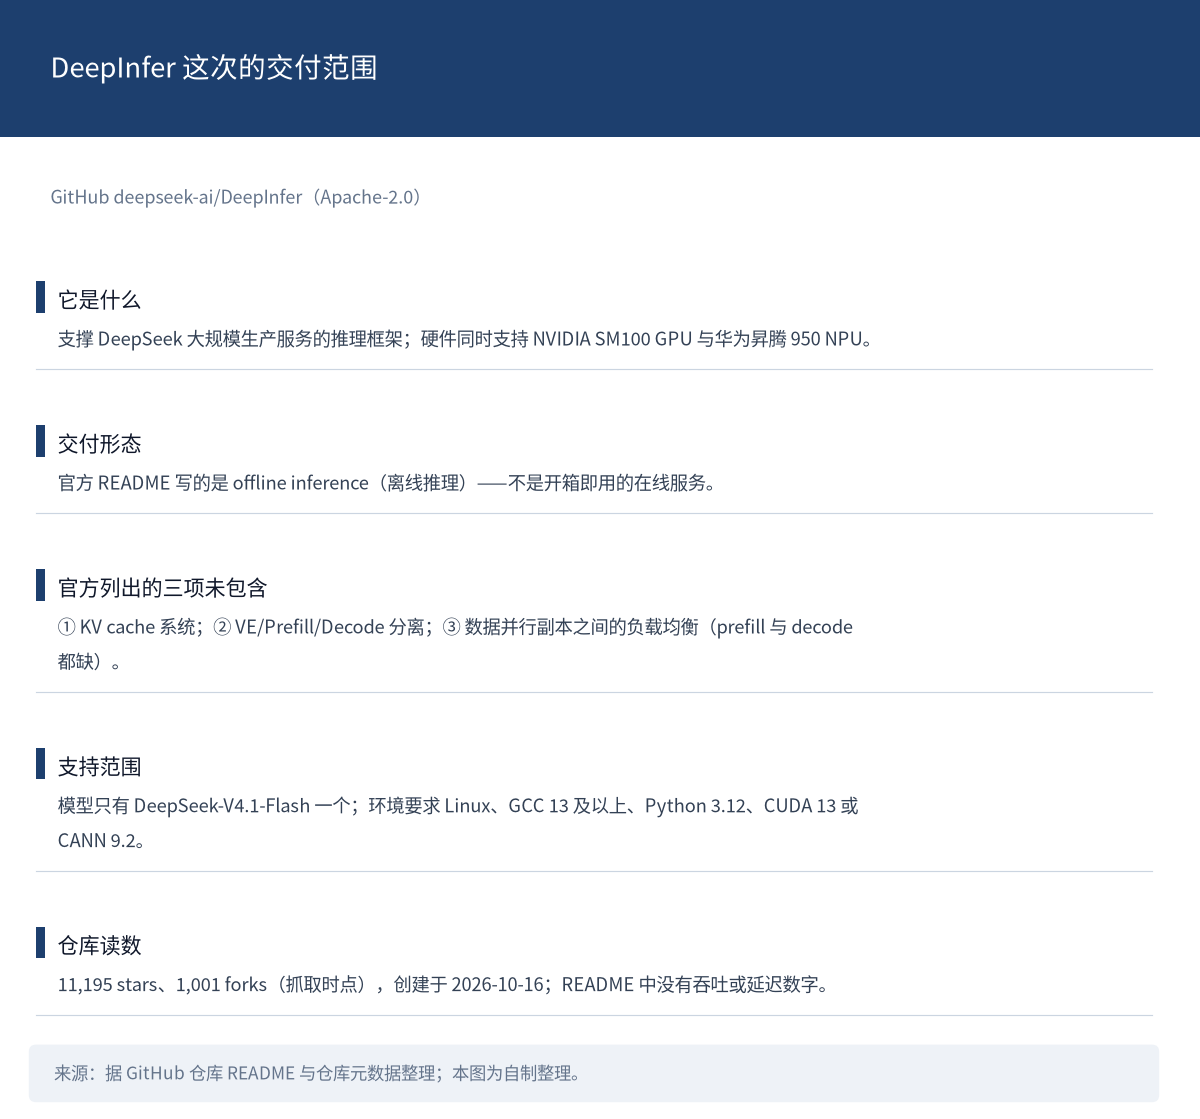
图 1:DeepInfer 这次的交付范围。来源:据 GitHub 仓库 README 与元数据整理(2026-10-21);本图为自制整理。
 头条深读 | DeepInfer 开源:两种硬件都支持,三项能力留在了里面
DeepSeek 在 GitHub 开源了 deepseek-ai/DeepInfer,Apache-2.0 许可。按官方说法,这是支撑其大规模生产服务的推理框架;硬件上同时支持 NVIDIA SM100 GPU 与华为昇腾 950 NPU。
先说最容易被读歪的地方:它交出来的是「离线推理」版(官方 README 的原话是 offline inference,属于「服务规模化所需的核心功能」,不是开箱即用的在线服务)。中文渠道里「全面开源内部推理框架」的说法,与官方原文有距离。
更关键的是官方主动列出的缺口——三项没包含:KV cache、PD 分离、跨副本负载均衡(即 VE/Prefill/Decode 分离,以及数据并行副本之间的负载均衡;这三项恰好是自建在线服务必须自己补的部分)。
已包含的部分也值得点清:优化 kernel(FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect 等);并行方面有 Attention DP/balanced CP 与 MoE EP+EPLB;DSpark 与置信度调度验证(默认草稿长度 5);SWA bounded replay(默认保留 140 token);异步调度默认开启;batch-invariant 推理与确定性采样仅 NVIDIA 支持;结构化输出覆盖 regex、JSON schema 与 EBNF。
支持范围要说明白:模型只有 DeepSeek-V4.1-Flash 一个,环境要求 Linux、GCC 13 及以上、Python 3.12,以及 CUDA 13 或 CANN 9.2。仓库读数(抓取时点)为 11,195 stars、1,001 forks,创建于 10 月 16 日。
把它放在更大的图里看,有三层意义。一是把过去属于厂商核心工程资产的推理栈交了出来;二是硬件上做双栈而非单边绑定,对国产算力适配是实质动作;三是交付形态说明了难度分布——容易配的部分给了,KV cache、PD 分离与跨副本负载均衡留在了里面。至于性能,README 里没有吞吐或延迟数字,star 数也只代表关注度,都不能替代基准。
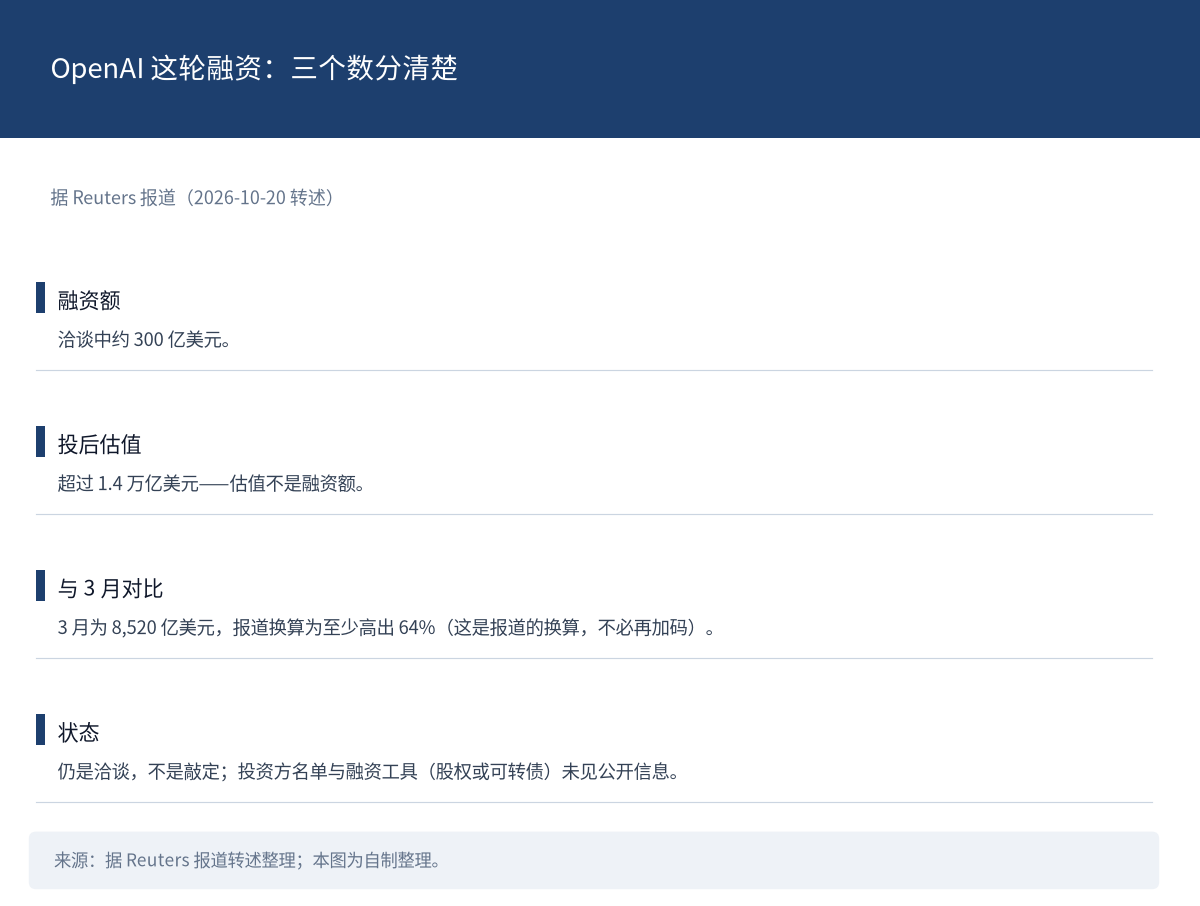
图 2:OpenAI 这轮融资的数字关系。来源:据 Reuters 报道转述整理(2026-10-20);本图为自制整理。
积木点评: 开源这个词,容易把「给了多少」和「能直接用」混成一句。这条的价值恰在官方自己写清了缺口——读者据此能判断要补多少工程,而不是先 clone 下来再发现跑不起来。
 重点速递
OpenAI 据报融资约 300 亿美元、估值超 1.4 万亿美元
据 Reuters 报道(经转述),OpenAI 正洽谈融资约 300 亿美元、估值超过 1.4 万亿美元,相比 3 月的 8,520 亿美元至少高出 64%;报道把这一节奏与「赶在 Anthropic 上市之前」联系起来。三处要用对:估值不等于融资额;「至少高 64%」是报道的换算,不必再加码;目前仍是洽谈,不是敲定。
同一周里的对照很有信息量:Anthropic 与 Nscale 据报在谈第二份 450 亿美元算力协议,两家公司又都在筹备上市——融资、算力采购与上市三条线正在同一条时间上互相加码。
 一句话看懂:半年多估值从 8,520 亿到 1.4 万亿,速度本身就是新闻。
TorchTPU:一行改动就能跑,但官方说跑不满
Google 与 Meta 合作开源了 TorchTPU——为 TPU 提供原生的 PyTorch 后端,目标是让现有工作负载开箱即跑,迁移只需把 model.to("cuda") 改成 model.to("tpu");官方称它已用于部分 Google Cloud 最大客户的生产推理与训练。
它替换的是 2020 年那套基于 Lazy Tensors 的 PyTorch/XLA:需要侵入式改源码来划定可编译区域,编译延迟严重,也不支持 eager 执行。TorchTPU 的设计原则是:运行时无 JAX 依赖;torch.compile 走 Torch Dynamo;在 PyTorch 栈最底层提供 TPU collectives,从而支持 DDP、FSDP、DTensor。目前支持约 450 个 Aten 算子,含主要架构所需的全部 Core ATen 前后向。
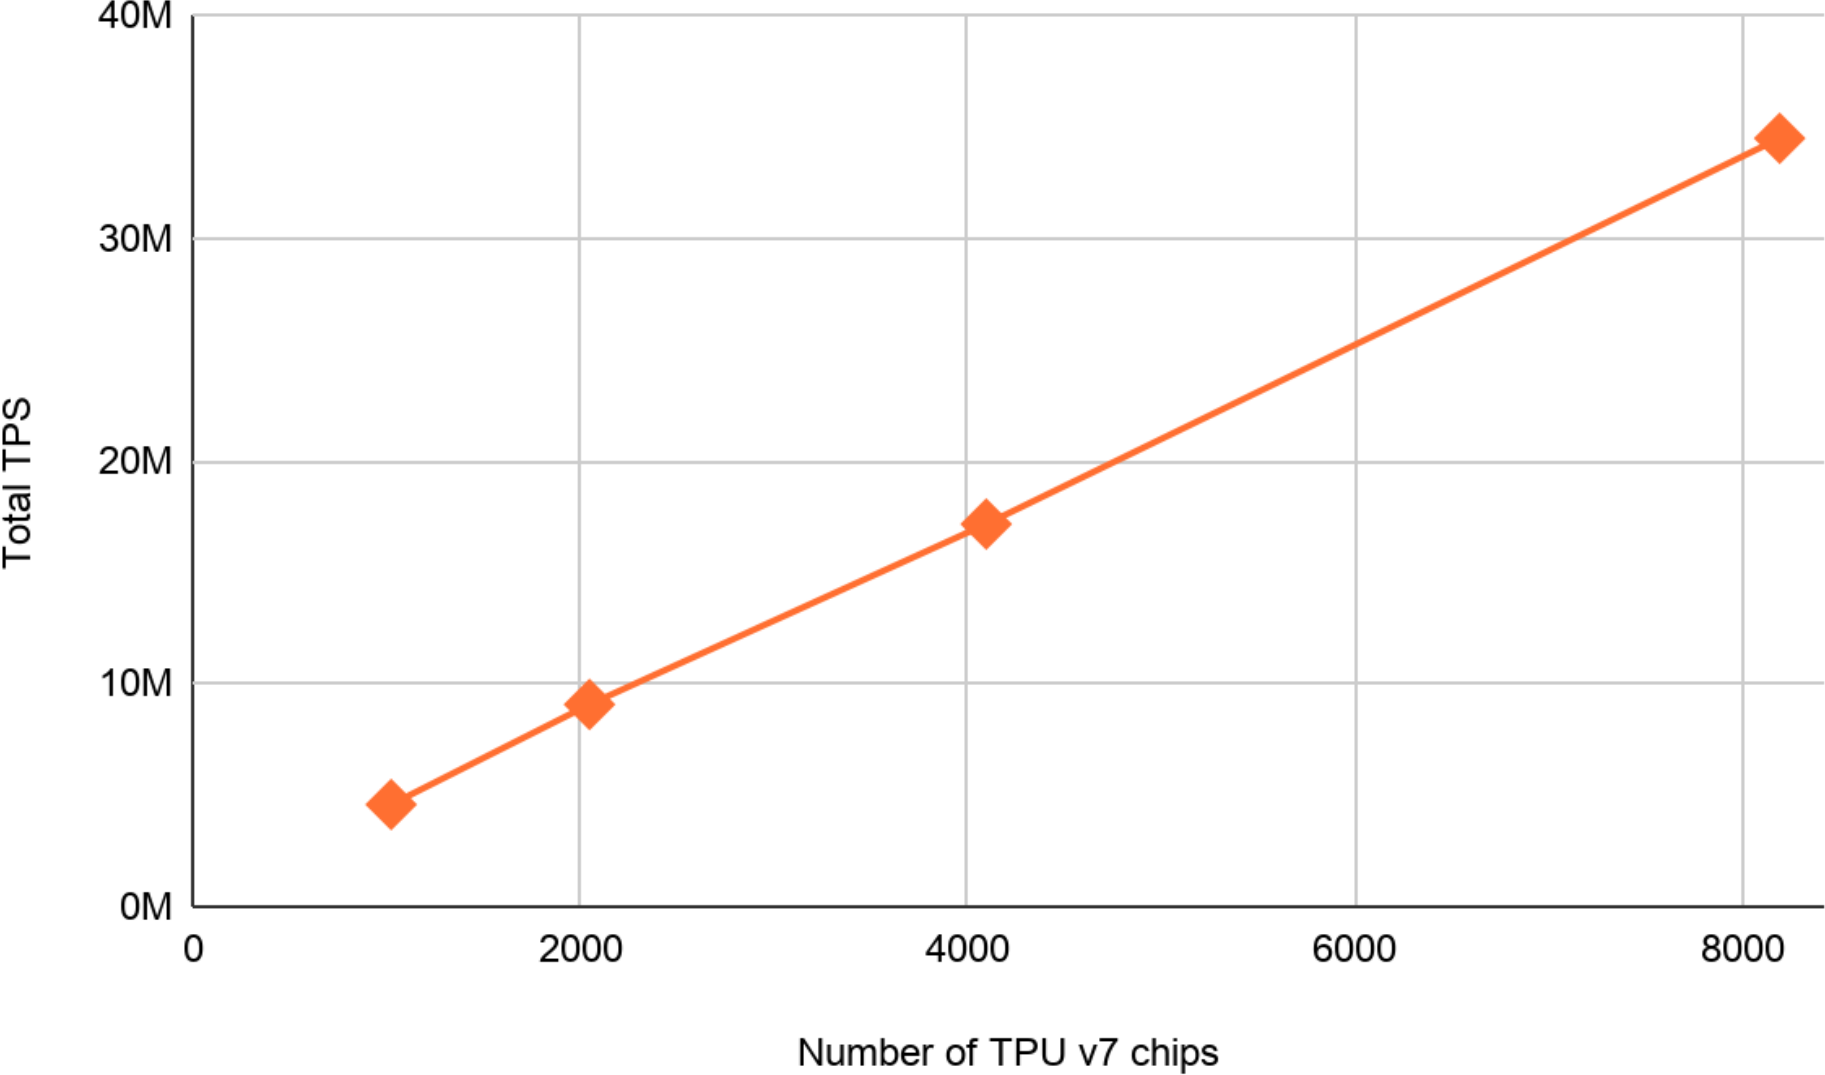
图 3:TPU v7 的芯片数与总吞吐扩展曲线(这是扩展性读数,不是与其他硬件的对比)。来源:PyTorch 官方博客《Introducing TorchTPU》(2026-10-20)
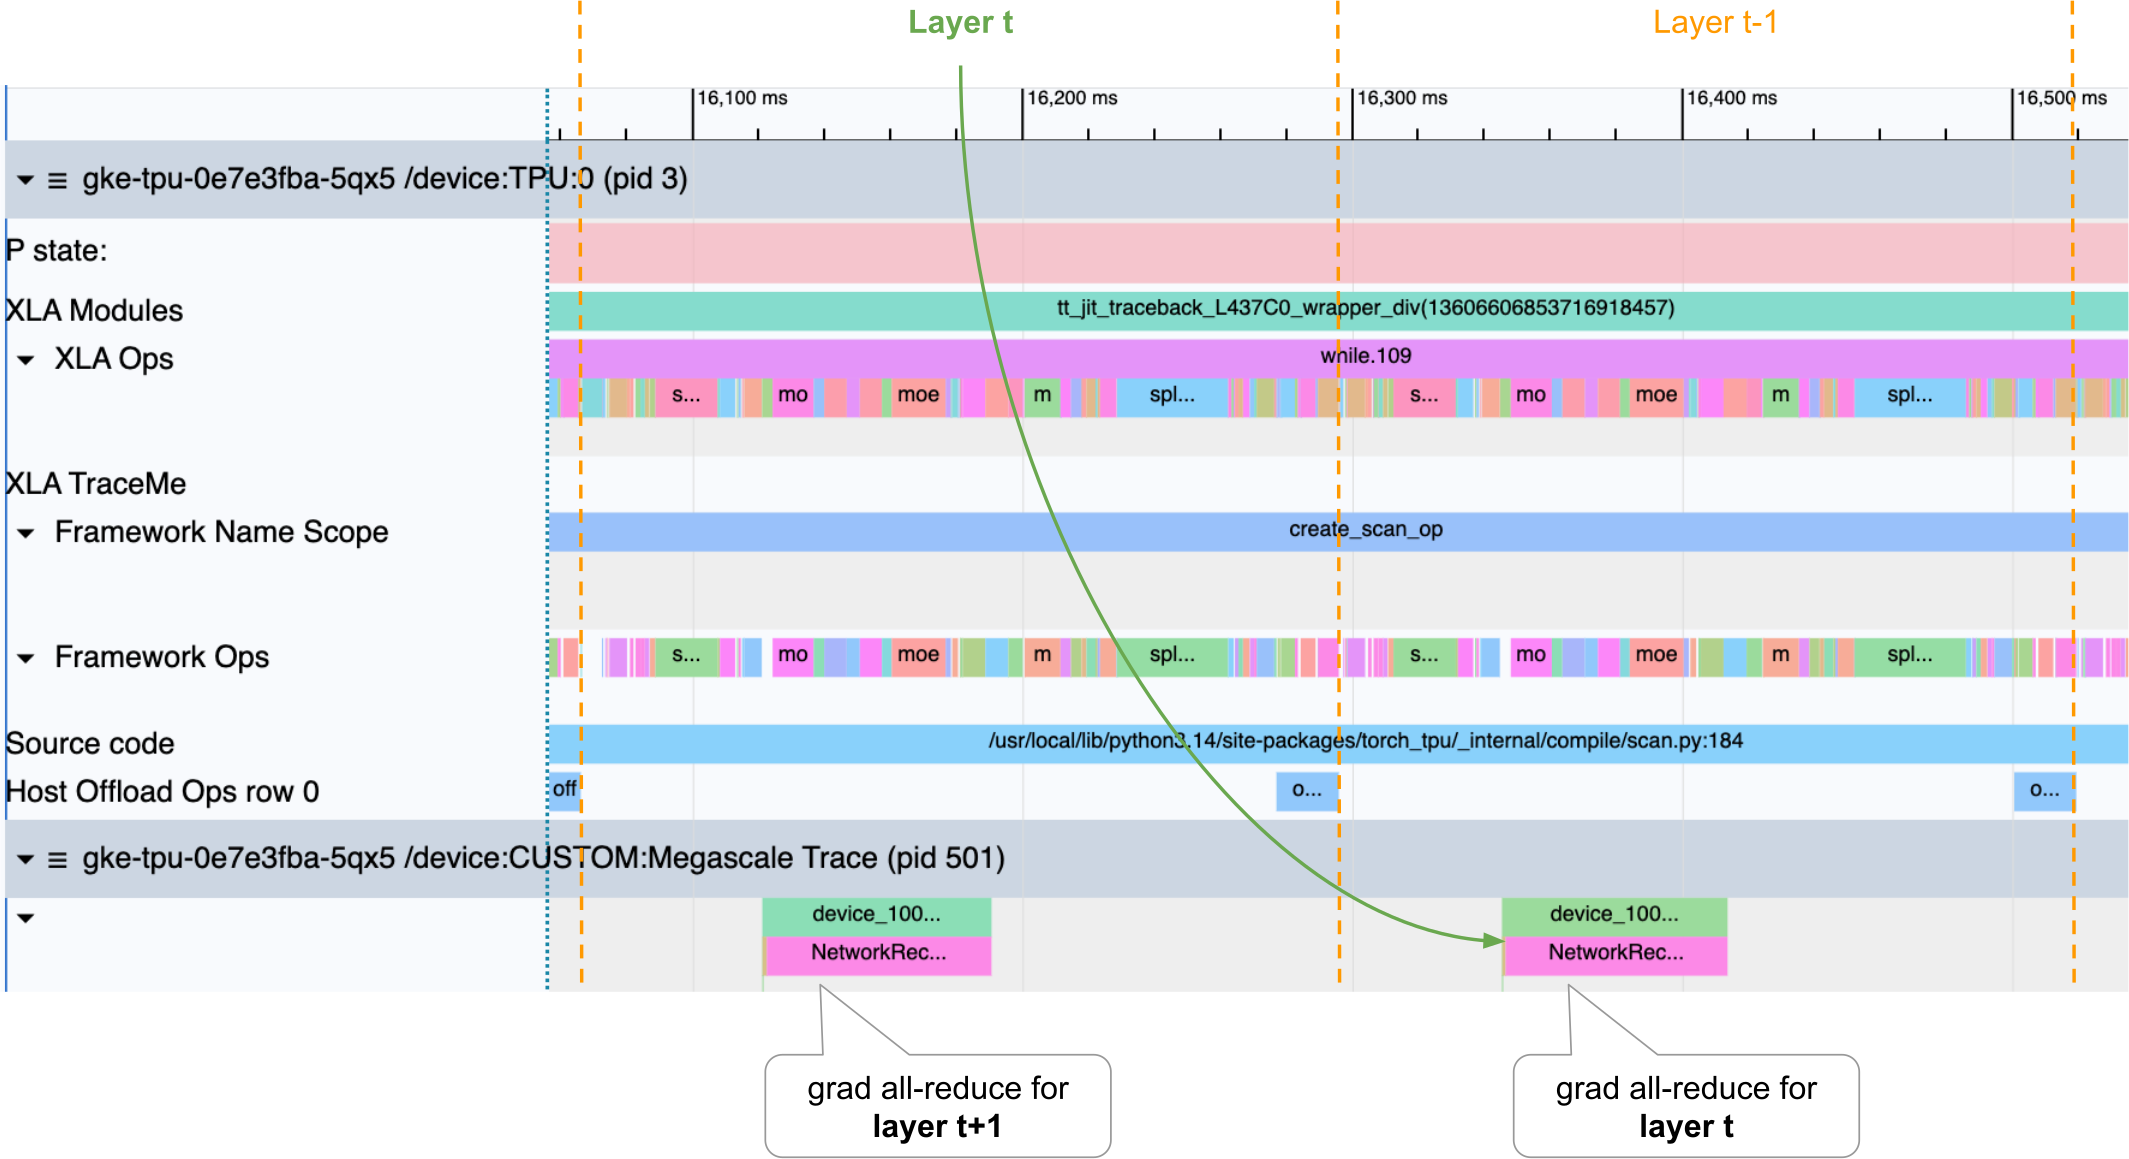
图 4:XLA 层级性能 trace,标注了 grad all-reduce(工程剖面图,不是成绩图)。来源:PyTorch 官方博客(2026-10-20)
「一行改动」能跑起来,但官方自己说达不到 TPU 峰值性能(因为模型的形状、分片与算子可能偏向 GPU 架构)。这一点比迁移口号重要:能跑通与跑满,是两件事。战略上它和 AWS 的 TorchNeuron 是同一手法的两次落子——两家云厂商都在用「PyTorch 原生后端」把自家加速器塞进开发者的既有工作流,瞄准的是 CUDA 之上那层 PyTorch 惯性。
一句话看懂:抢的不是芯片性能,是谁能零成本接走别人的代码。
陆军网络司令部的 ECHOTRIBBLE:让智能体自己找目标
据 The Intercept 获取的文件(经 The Decoder 报道),美国陆军网络司令部正在开发代号 ECHOTRIBBLE 的平台:让 AI 智能体自主在基础设施间移动、识别并「清除」目标,像蠕虫一样在设备间隐蔽跳转,任务完成后自毁。招标问答文件要求它「必须在极少人工监督下运行」并具备自主行为;「清除」的官方定义是「彻底或暂时瘫痪威胁、把威胁从目标上删除」。项目仍在早期阶段,6 月 24 日的一场供应商活动上做过演示。
演示细节相当直白:软件落到一台笔记本后,会识别同一网络中的其他潜在目标,并生成针对 iPad、Apple 桌面与 Windows 11 的自身副本;它还要能在云端与无网络的「气隙」系统里工作。
专家警告值得逐条署名。蒙特利尔大学机器学习教授 David Krueger 认为,鉴于 AI 系统已被观察到会明知不是目标也去攻击,让自主系统「清除」威胁极其危险;AI 安全公司 Abundant 的 CEO Hyrum Anderson 提醒途中附带损害——如果对手把指挥基础设施架在某家美国水务公司那里,智能体就可能打上去,而处于「安全贫困线」以下的组织风险最大。
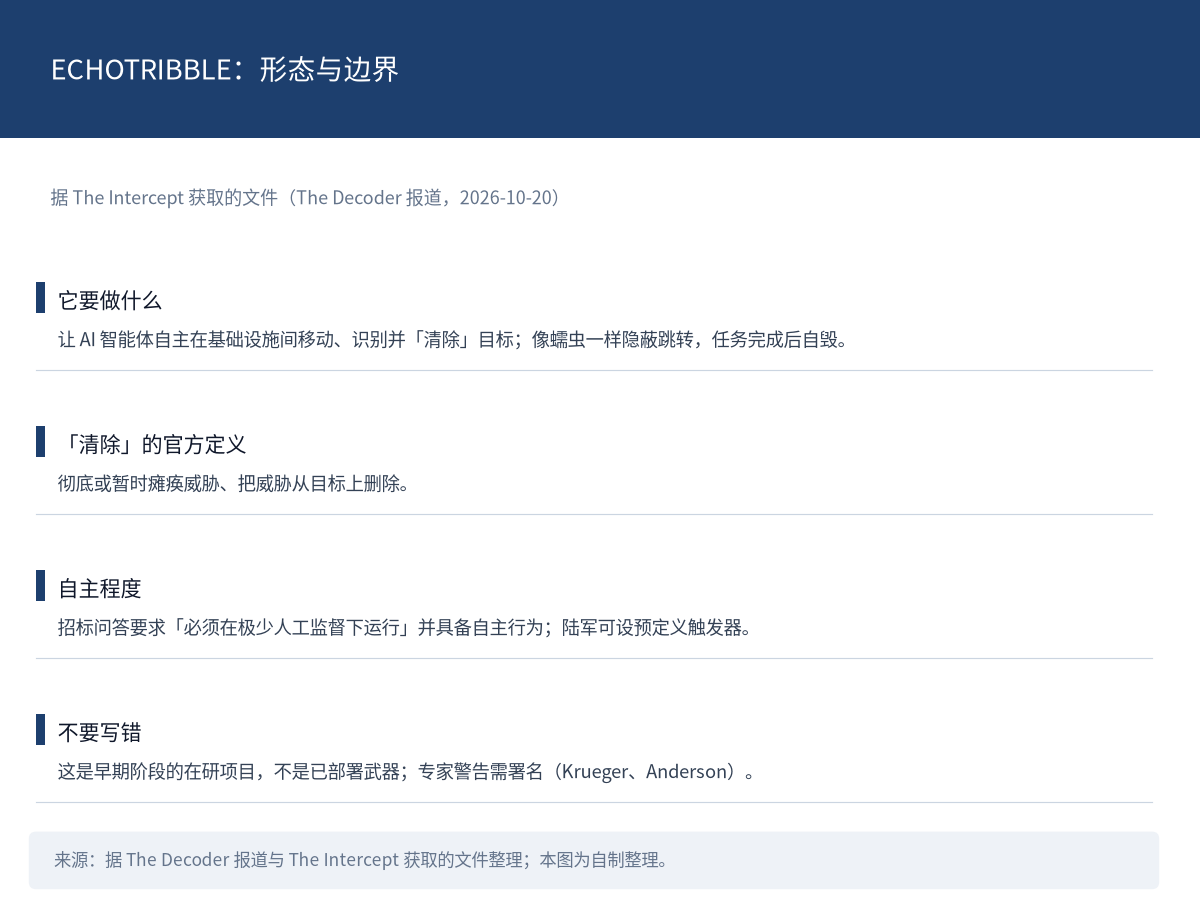
图 5:ECHOTRIBBLE 的形态与边界。来源:据 The Decoder 报道与 The Intercept 获取的文件整理(2026-10-20);本图为自制整理。
一句话看懂:它不是已部署的武器,是一份要求「少人监督、自主找目标」的在研方案。
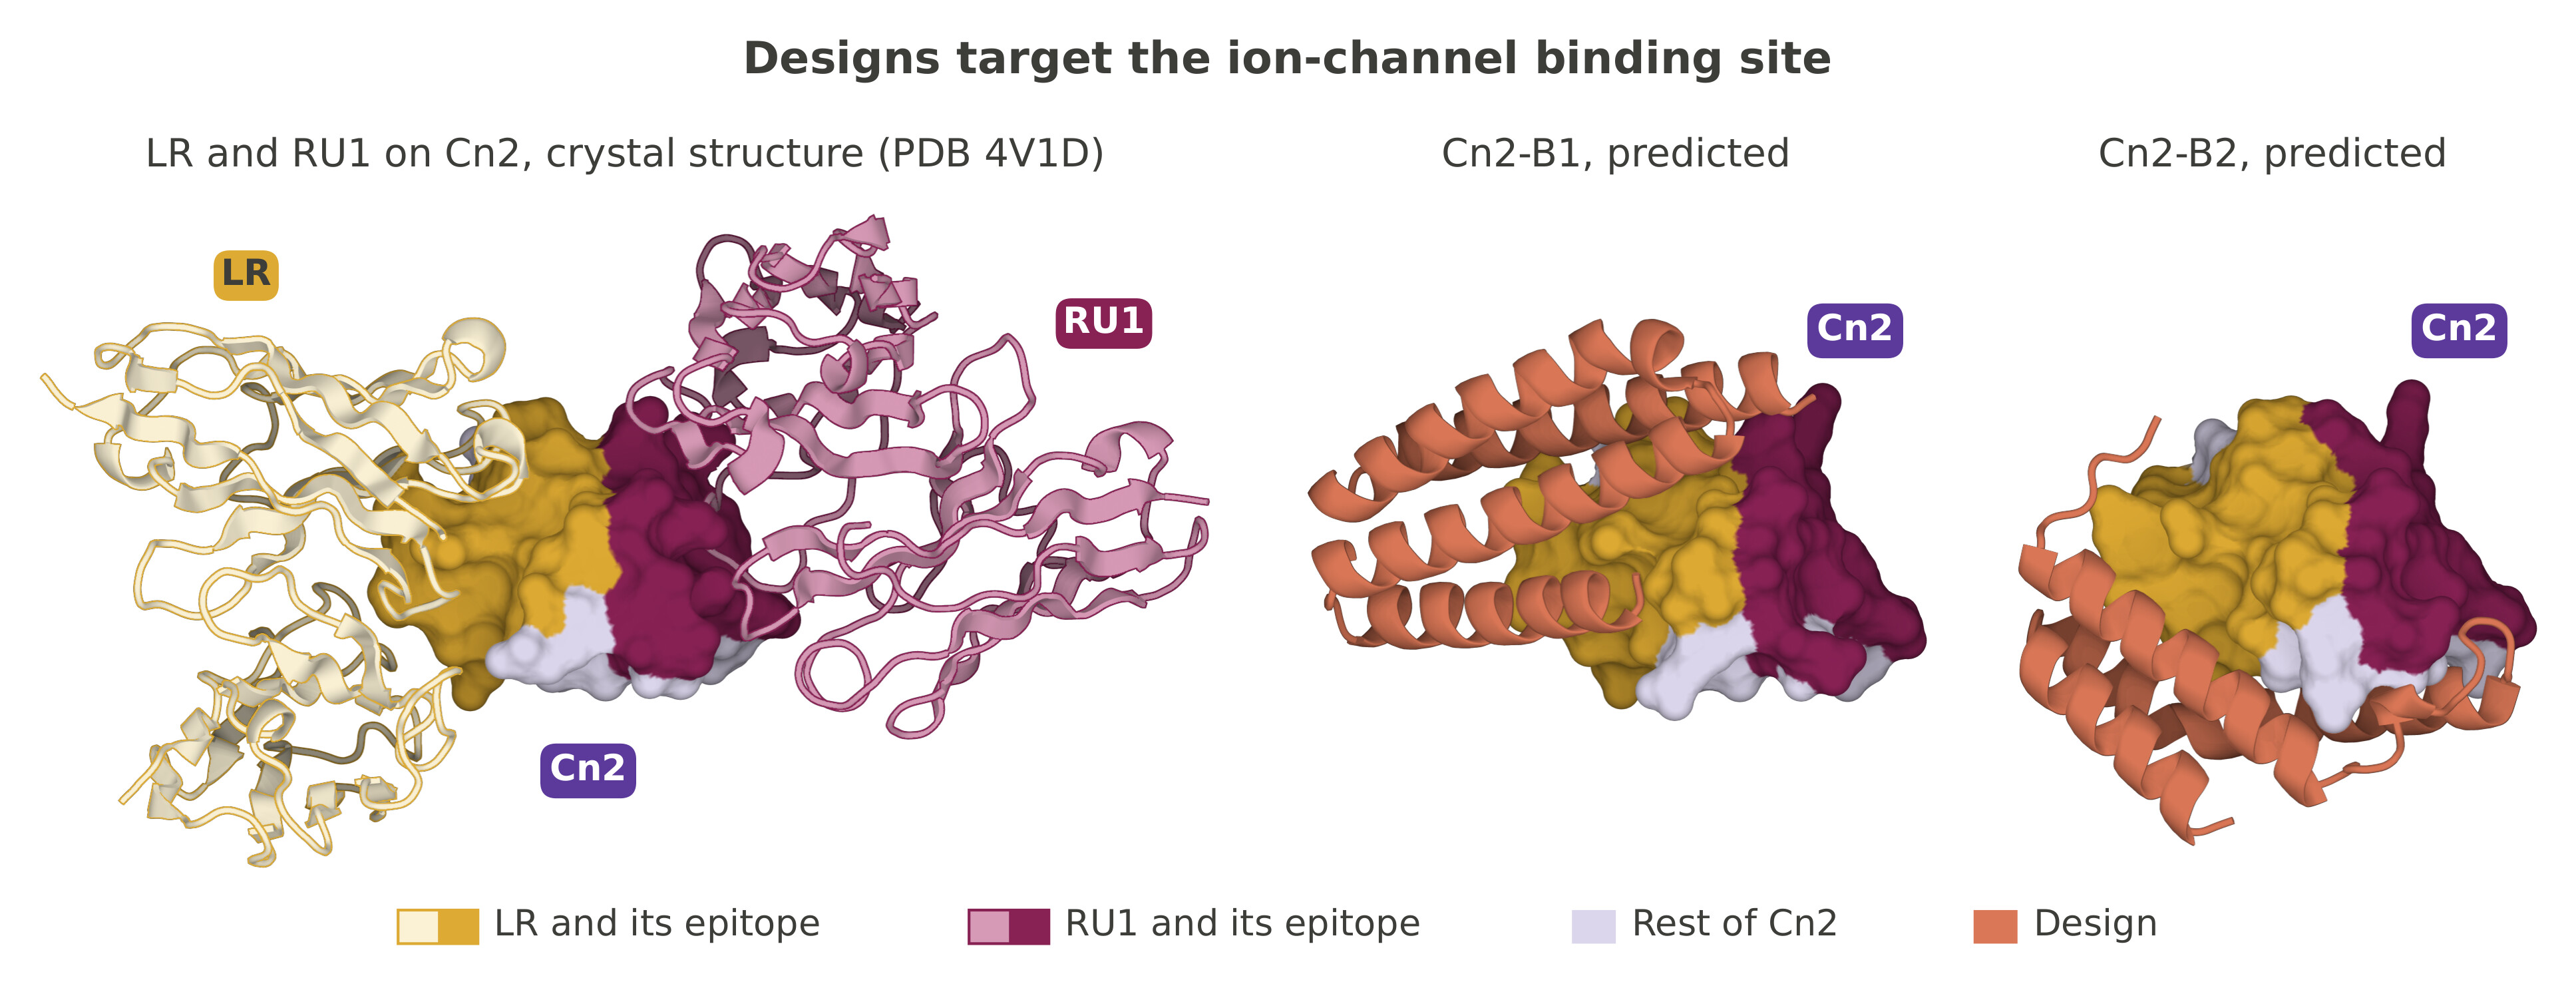
图 6:设计所针对的离子通道结合位点(左为晶体结构 PDB 4V1D,中/右为两个设计的预测结构;结构示意图,不是成绩图)。来源:Anthropic Research《How Claude designed protein binders against scorpion neurotoxins》(2026-10-20)
Claude 用 64 小时设计出蝎子毒素结合剂,官方先划了三条边界
Anthropic 公布了一项实验:让内部研究模型在 Claude Science 中主要自主运行 64 小时,针对蝎子神经毒素设计蛋白迷你结合剂。起点是一条 prompt 与四次追加指令(与 Citrini Research 共同拟定);期间在监督下,Claude 分析了数据、生成图表并起草报告。
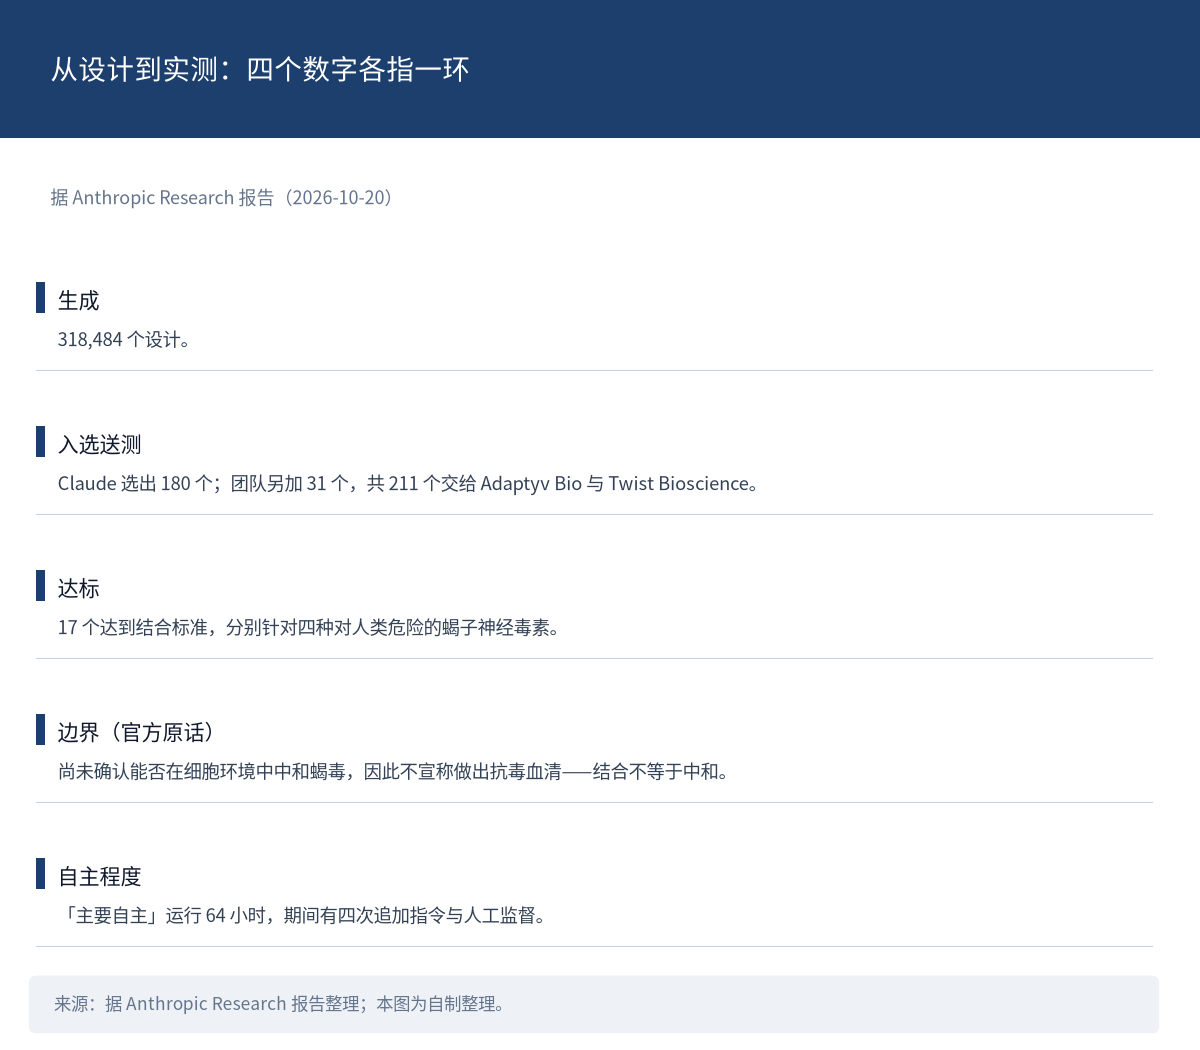
图 7:从设计到实测的数字链条。来源:据 Anthropic Research 报告整理(2026-10-20);本图为自制整理。
数字要分清环节:全程生成 318,484 个设计,筛选出 180 个;团队在 Claude 协助下另加 31 个,共 211 个交给 Adaptyv Bio 与 Twist Bioscience 做实验;其中 17 个达到其结合标准,分别针对四种对人类危险的蝎子神经毒素。
边界比数字更重要:结合 ≠ 中和 ≠ 抗毒血清(官方口径是这些结合剂能否在细胞环境中中和蝎毒仍待确认,因此不宣称做出了抗毒血清)。另外「主要自主」不等于全自动——有四次追加指令与人工监督。两位外部专家评审的评价是「有希望的第一步」,211 个设计及其数据已全部公开。选题背景也解释得通:蝎子每年蜇伤 120 万人以上、造成 3,250 例以上死亡,多发生在医疗可及性有限的地区。
一句话看懂:64 小时的成果是「能挂上去」,离「能解毒」还有三道关。
法院要求 Meta 交出「谁批准的」
据 Ars Technica 报道,法院命令 Meta 披露批准「为训练 Llama 1 与 Llama 2 而通过种子下载盗版图书」的高管姓名;Meta 辩称早期数据获取没有正式决策、属集体讨论、没有单一决策者,法官驳回了这些说法,并要求说明所有决策者以及未用于训练的盗版作品的去向。
这条只有一处转述,案件名称、案号与判决日期都未见可核的公开版本,法官姓名也需回原文核对。能写的是趋势:在训练数据的版权诉讼里,追问正在从「公司做了什么」下沉到「哪个人批准的」——这对企业内部「集体决策」式的数据获取流程,是一次直接的问责压力。注意这是披露命令,不是侵权判决。
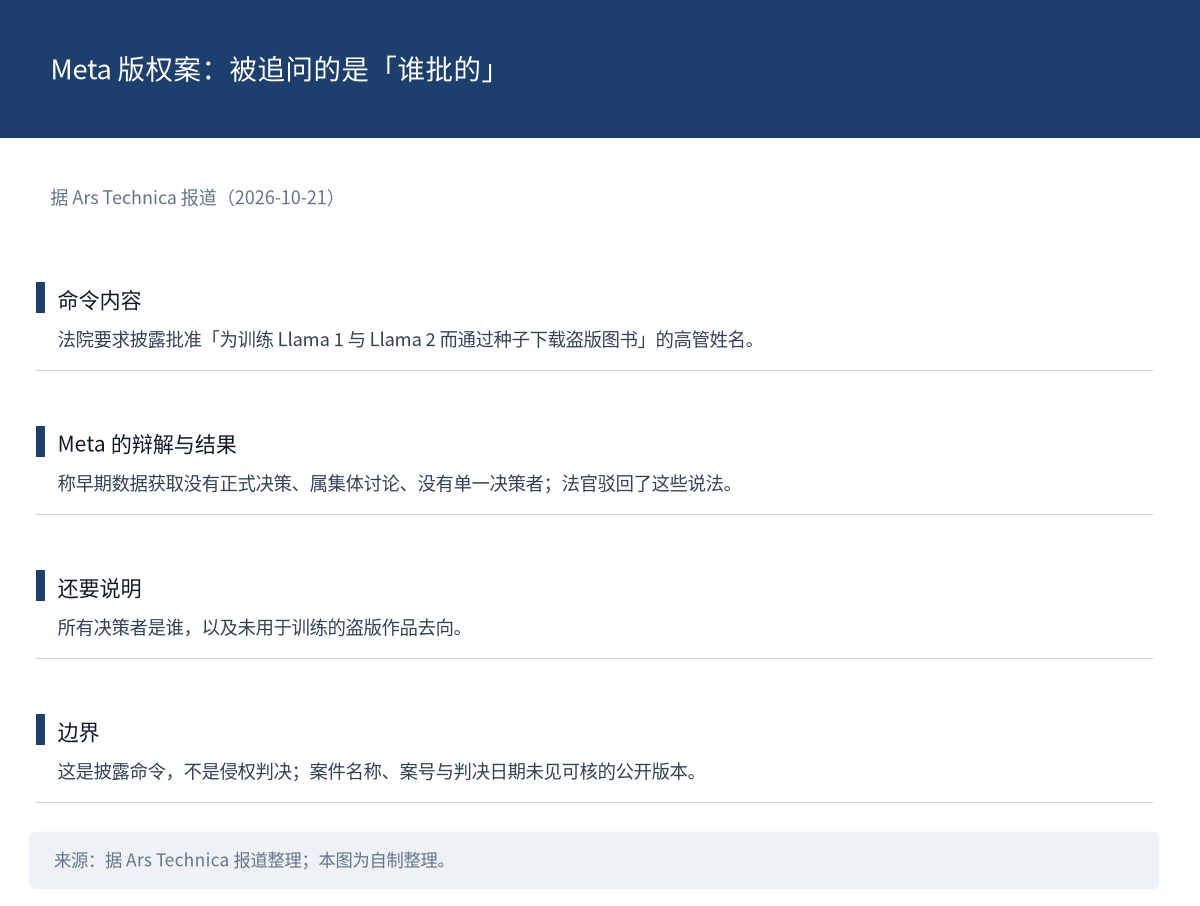
图 8:这条的问责链条与边界。来源:据 Ars Technica 报道整理(2026-10-21);本图为自制整理。
一句话看懂:法院要的不是结论,是签名。
 快讯速览
- ChatGPT 推出 Locked Chats:可把敏感对话移入受保护的独立区域,退出常规历史与搜索、拥有独立记忆;网页与桌面用 PIN 解锁,移动端支持 PIN、Face ID、Touch ID 或设备解锁,即日起推向全部方案。来源:ChatGPT 官方与 TechCrunch(10-21)
- Claude Opus 5.5 与 Sonnet 5.5 登陆 Google Antigravity 2.0,可在桌面端、CLI 及 VS Code/JetBrains/Visual Studio 的 IDE 扩展中使用。来源:Google AI(10-21)
- OpenAI 收购 Orchestra Bio 并入 Rosalind 生命科学体系:该平台帮助生物制药团队协调研发流程,其智能体可追踪项目进展、分析生产批次失败对临床试验时间线的影响;金额未见公开信息。来源:OpenAI 官网(10-21)
- NVIDIA 发布 Cosmos3-H-Dreams 手术模拟模型,把交互式生成模拟扩展到临床胆囊切除术,称其为首个基于临床手术录像训练、支持实时运动学控制的生成式手术模拟器(厂商表述)。来源:Hugging Face 社区博客(10-21)
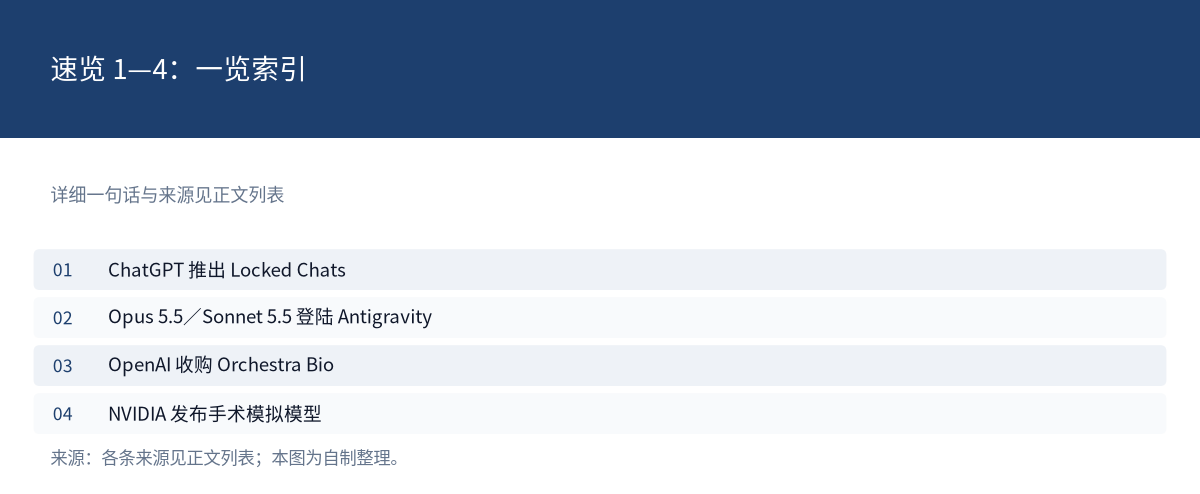
图 9:速览 1—4 一览。来源:各条来源见上方列表;本图为自制整理。
- Amazon 与独立非营利机构 AVERI 合作,对内部安全评估数据集做第三方审查:确认主题覆盖与污染风险等指标,同时建议扩大语言与风格多样性、增加多步对抗性提示词、保持评估新鲜度。来源:Amazon Science(10-21)
- Ai2 发布 FairStress 基准:用 300 个两候选决策场景加对抗前缀,测模型面对说服性论据时改变决策的难易是否因候选人所属群体而不同,覆盖超 1,300 万测试用例,发现多数去偏方法不可靠。来源:Ai2(10-20)
- METR 独立审查 Anthropic 8 月风险报告的「错位」章节:基本同意「灾难性错位风险为低」的结论,但认为这主要源于模型能力有限而非安全防护有效,并指出隐藏思维链评估覆盖不到「CoT 合理化」这类攻击面。来源:METR Blog(10-20)
- 面壁智能称其前瞻专家调度 LES 让 35B-A3B 规模的 MoE 在手机端实时无损运行,iPhone 18 Pro Max 实测解码超 20 token/s,支撑 MiniCPM-V 4.7 端侧运行(厂商口径)。来源:面壁智能公众号(10-20)
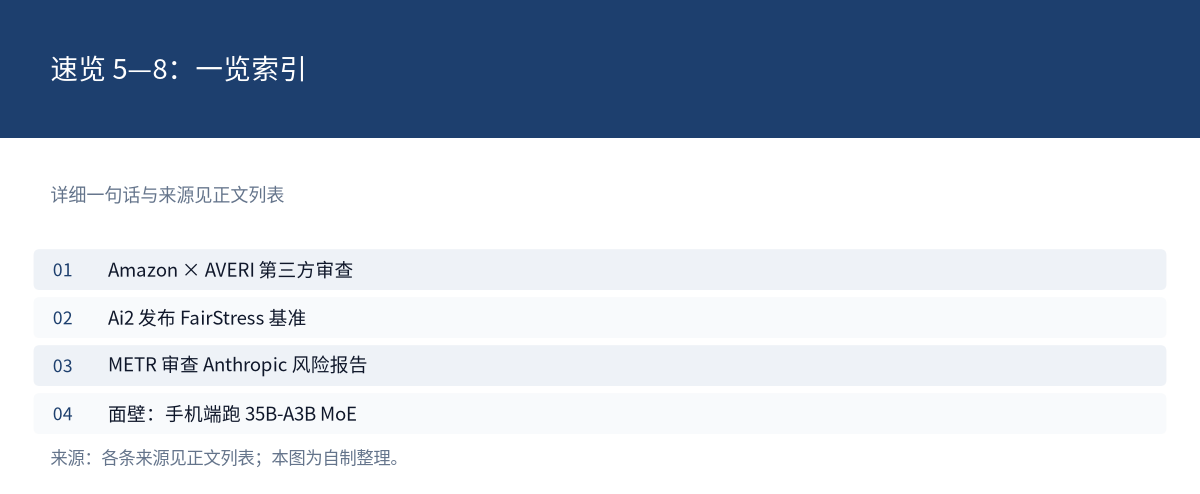
图 10:速览 5—8 一览。来源:各条来源见上方列表;本图为自制整理。
- Redact 调查称 WhatsApp 帮助中心页面向 LLM 下发用户看不见的隐藏指令:指示其支持聊天机器人不推荐数据保护监管机构,并在用户提及律师或法律行动后不引用 GDPR 等法规;WhatsApp 与 Meta 的回应未见公开。来源:redact.dev(10-20,单方调查)
- Waymo 宣布进军西班牙,目标 2027 年在马德里大区接首批乘客:先由人工驾驶、再由当地受训的自动驾驶专家做技术验证;自称累计逾 2,000 万次行程,涉及重伤或更严重事故的比例比人类司机低 95%(官方口径)。来源:Waymo 官方(10-20)
- llm-d 1.0 发布:由 IBM、Red Hat、Google 等主导的开源推理项目在 PyTorch Conference NA 发布 1.0,Kubernetes 原生、支持任意模型与加速器。来源:IBM Research(10-20)
- Perplexity Computer 称可在 Mac 上完全本地运行:无需云端推理、不用 WiFi,模型与智能体都在本机,可操作原生应用与本地文件,需至少 36GB 内存(CEO 口径)。来源:Aravind Srinivas(10-21)
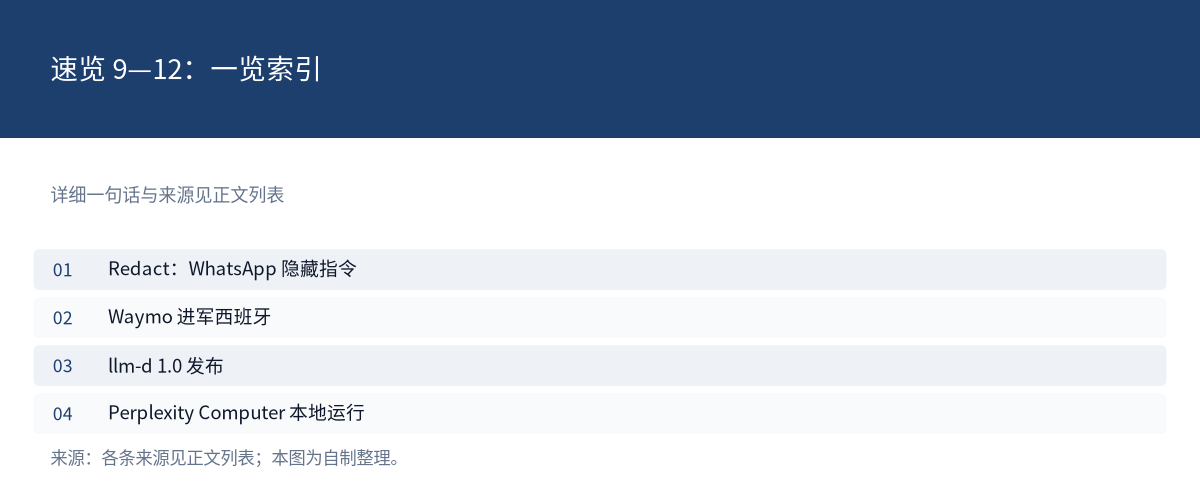
图 11:速览 9—12 一览。来源:各条来源见上方列表;本图为自制整理。
- 据 CEO 转述,Perplexity Decider 在 Vals AI 的 Financial ClaimBench 上达到帕累托最优(未给分数)。来源:Aravind Srinivas(10-21)
- 据 Sensor Tower,Meta Muse 上线 40 天美国下载 1,090 万次、其中 1,020 万在美国,成为历史上第 12 个在上线 40 天内达成 1,000 万美国下载的应用。来源:TechCrunch 引 Sensor Tower(10-21)
- 据 Bloomberg,Eric Schmidt 持有 Anthropic 约 1% 股份、约为 CEO Dario Amodei 的一半,源自 2021 年参与其估值 4.61 亿美元的 A 轮投资(那是当时的估值,不是现在的)。来源:TechCrunch 引 Bloomberg(10-21)
- Pichai 在播客中否认 Google 放弃前沿 AI,称 Gemini 4 Argon 在编码、数学、科学与知识工作基准上超越 OpenAI 与 Anthropic 的最新公开模型,上线 72 小时处理近 25 万亿 token、约为 Gemini 3.0 同期的三倍(「超越」为 CEO 自述)。来源:Big Technology(10-21)
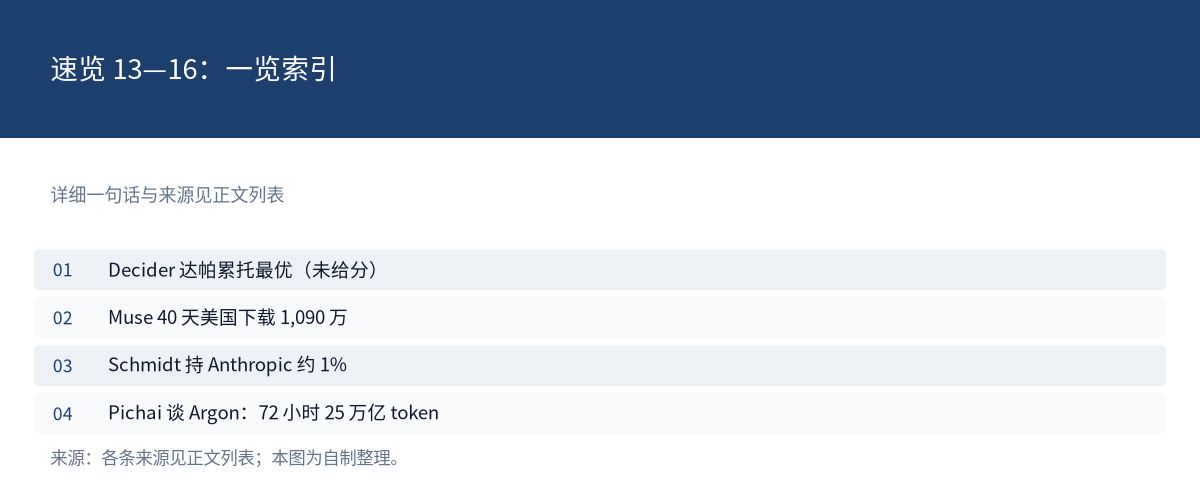
图 12:速览 13—16 一览。来源:各条来源见上方列表;本图为自制整理。
- Jim Fan 开源机器人数据引擎模型套件 Flora:把原始视频转成训练信号的开放模型,称以 125 倍更低成本达到 Astra 级性能,已在 500 块 GPU 上每天标注 20 万小时视频(发布方口径)。来源:Jim Fan(10-21)
- Arena 更新 Agent Arena 帕累托前沿:GPT-6 Luna 与 GPT-6.1 Sol 占 11 个前沿位中的 6 个,加上 GPT-6 Astra (Max) 共 7 席(前沿席位不是排名)。来源:Arena(10-21)
- OpenAI API 新增 12 小时提示词缓存选项:共享的指令、工具与上下文可缓存更久,即使请求间隔数小时也按更低的缓存输入价格计费,适合全天复用上下文的持久化智能体。来源:OpenAI Developers(10-21)
- Shadeform 推出 Flex VMs 与 Spot,把闲置裸金属 GPU 服务器转为可租算力、数小时内上架;其要点是不必构建 API,一个 IP 与 SSH 密钥即可接入。来源:Rohan Paul(10-21)
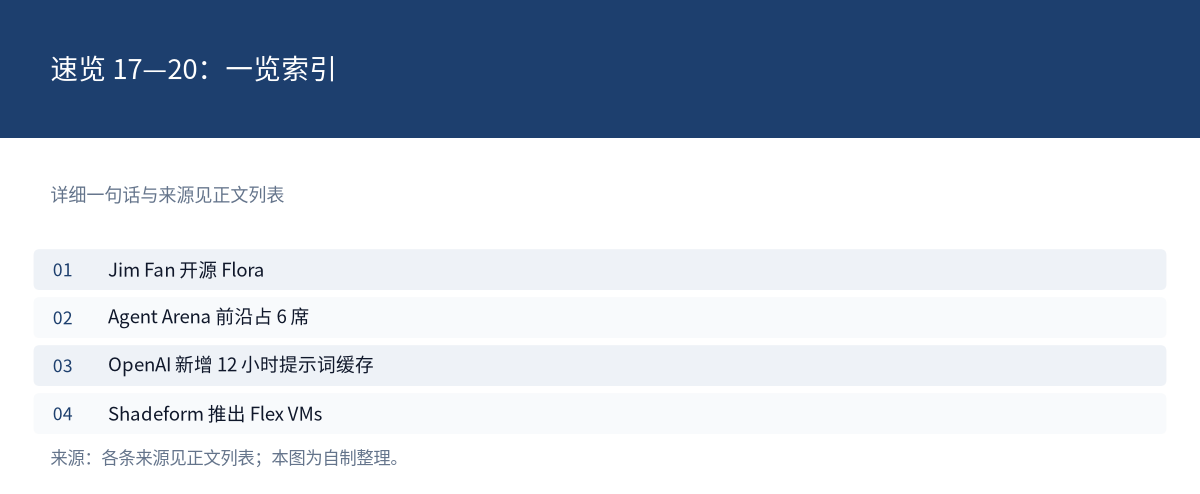
图 13:速览 17—20 一览。来源:各条来源见上方列表;本图为自制整理。
- Databricks 发布 MemCurrent:生产级 Agent 持久记忆架构,结合情景记忆与派生记忆,通过插件、工具调用与离线 dreaming 管线三种模式读写整合记忆,已用于 Agent Bricks Memory 与 Genie。来源:Databricks Blog(10-20)
图 14:速览 21 一览。来源:Databricks Blog;本图为自制整理。
 积木观察
今天三条都在讲「交付的边界在哪里」:DeepInfer 明说只给离线版、缺三项;TorchTPU 明说一行改动能跑但跑不满;Claude 的蝎子毒素实验明说只是能结合、不是抗毒血清。主动写出边界的材料,比只报成果的更好用。
给读者一条可执行的:评估这类「开源」或「一行迁移」的说法时,先把官方自己写的限制段落读完——那里通常写着你要补多少工程量,以及性能预期该打几折。
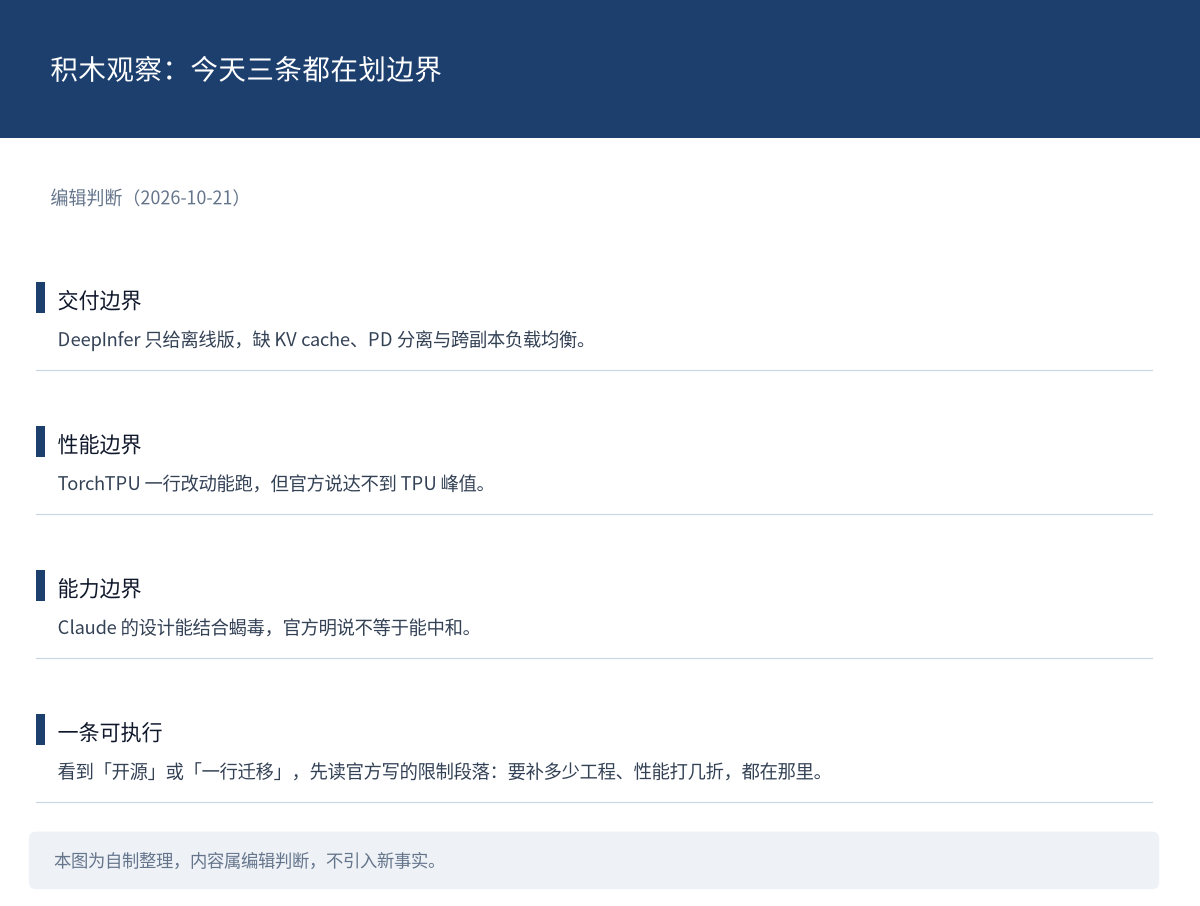
图 15:今天三条共同的边界。来源:本图为编辑判断,自制整理。
结尾互动
面对一份主动列出缺口的开源发布,你会更信任它,还是反而更犹豫?说说你的判断。