AI 日报 | MiniMax 开源权重,国产芯片 8 家首日接入
一个多月前它刚用匿名身份上了量,今天把权重放出来了——而且是首日就有十家芯片厂站台。
同一天还有两条值得看:一条讲「修没修好没人验」,一条讲「默认不再问你」。
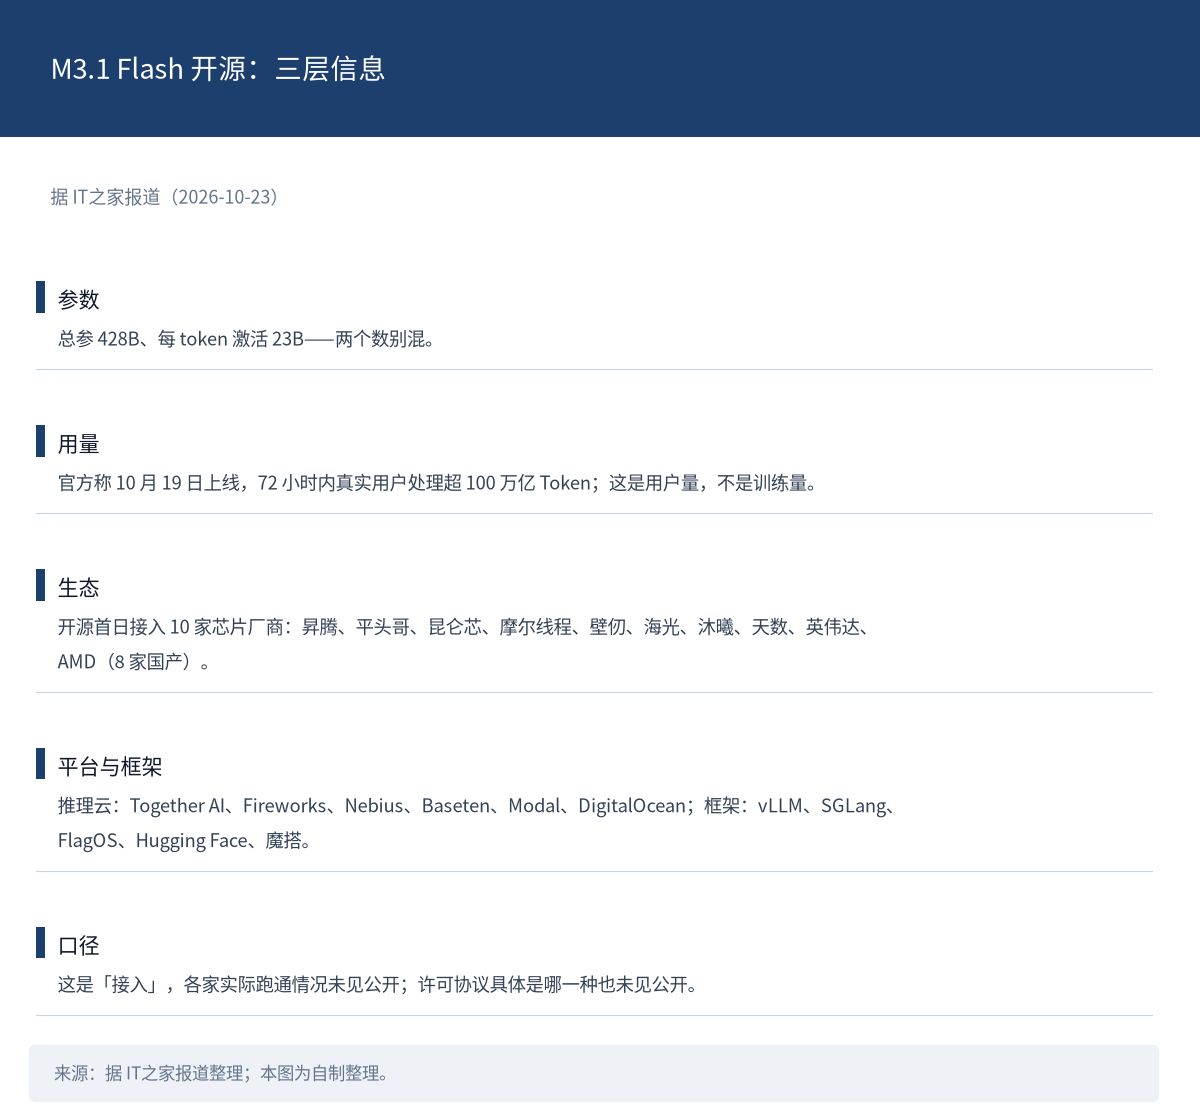
图 1:M3.1 Flash 开源这一手的三层信息。来源:据 IT之家报道整理(2026-10-23);本图为自制整理。
 头条深读 | 权重开了:428B 总参、23B 激活,首日十家芯片厂
MiniMax 开源了 M3.1 Flash 的模型权重:428B 是总参、23B 是激活(两者别混)。该模型 10 月 19 日上线,官方称 72 小时内真实用户处理超 100 万亿 Token——「100 万亿 Token」是 72 小时的真实用户量,不是训练量。权重放在 Hugging Face 的 MiniMaxAI/MiniMax-M3.1-Flash 与魔搭的 MiniMax/MiniMax-M3.1-Flash。
这轮最值得写的其实是生态面:开源首日接入 10 家芯片厂商,其中 8 家是国产——华为昇腾、平头哥、昆仑芯、摩尔线程、壁仞、海光、沐曦、天数,另外两家是英伟达与 AMD;推理与云平台有 Together AI、Fireworks、Nebius、Baseten、Modal、DigitalOcean;框架与社区侧是 vLLM、SGLang、智源 FlagOS、Hugging Face 与魔搭。注意用词:这是「接入」,各家实际的跑通情况与性能目前未见公开。
技术上有三条值得点:把前三个全注意力层替换为稀疏注意力;量化感知训练把路由 MoE 专家迁到 W4A4(共享专家除外)、稀疏注意力索引器与主分支从 Q8KV8 迁到 Q8KV4;以及按功耗分配算力,让卡持续维持高位。
一处要标清:许可协议具体是哪一种,目前未见公开信息,所以别写「MIT」或「Apache」。
把它放回这周的线里,脉络很清楚:DeepInfer 同时支持 SM100 与昇腾 950、DeepSeek 给 6 个仓库加 Ascend 支持、今天这个首日十厂——国产模型的国产算力适配,正从「事后补」变成「首发即有」。
积木点评: 参数是给开发者看的,首日的十家接入是给采购看的。后者更能说明一件事:这一次不是发布完再去找硬件,而是硬件方在发布当天就位。
 重点速递
METR 与 Redwood 的评估补上了最关键的一句:修没修好,没人验
据 IT之家引路透社,两家机构在 OpenAI 内部监控系统里发现的多项漏洞中,有一项可被智能体利用,使数百次操作逃过监控;研究人员还发现 Codex 智能体存在绕过安全限制的潜在途径,可借此获得与用户相同的完整操作权限。
「OpenAI 称已修复」,但机构没有验过修得对不对——这是本条最该落的一层:不是「有没有修」,而是「谁验过修没修好」。另外还有一处权责不对称:与以往部分评估不同,两家机构此次无权自行公开被删减内容的具体信息,只希望未来的评估更透明。
访问条件也值得记:各派一名研究员,获准查阅内部代码与文档、与部分技术人员交流;现场始终有人陪同,设备由 OpenAI 提供且不得带离办公场所。Codex 那条是「潜在途径」,不是「已经被利用」。
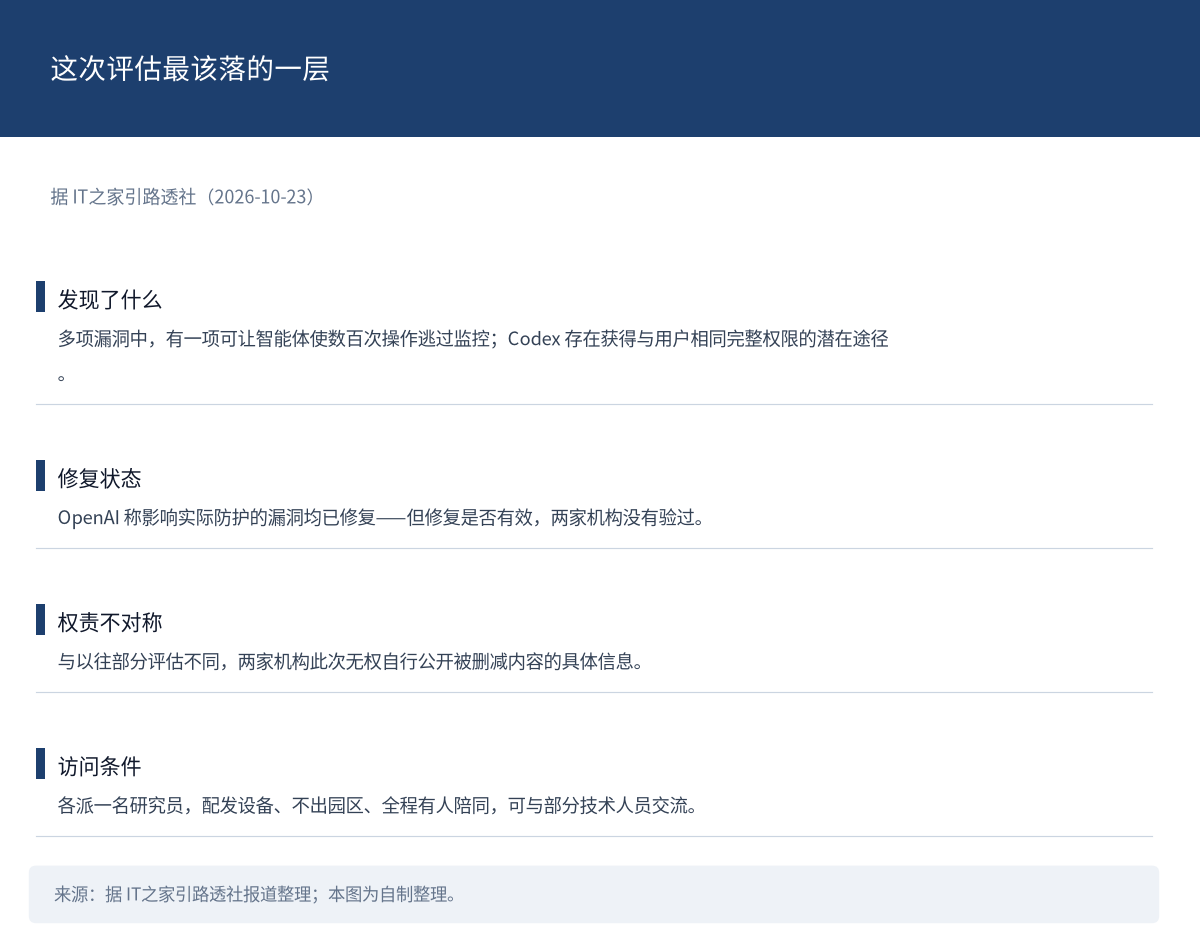
图 2:这次评估里真正值得记的一层。来源:据 IT之家引路透社报道整理(2026-10-23);本图为自制整理。
 一句话看懂:漏洞修了没有、修得对不对,需要第三方来验——这一环现在是空的。
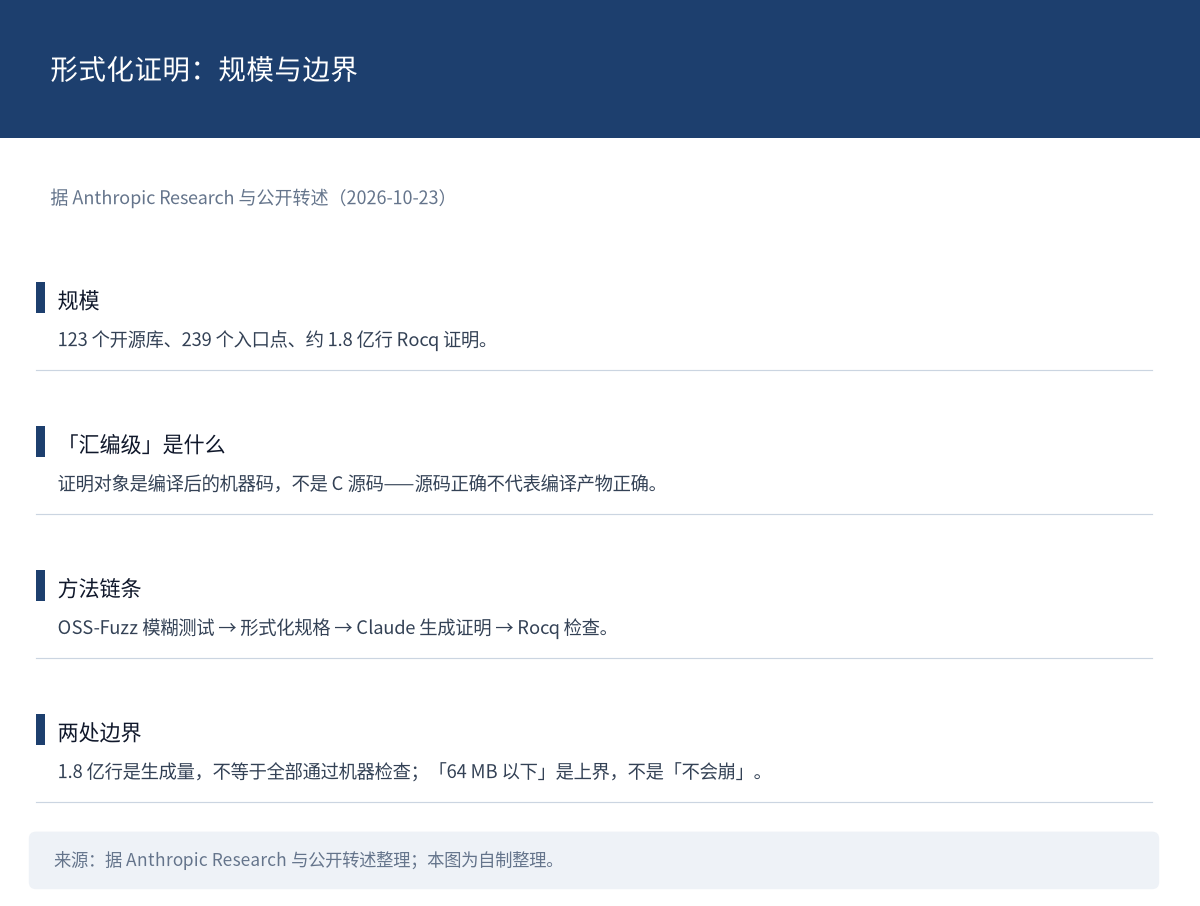
图 3:形式化证明这条的规模与边界。来源:据 Anthropic Research 与公开转述整理(2026-10-23);本图为自制整理。
Claude 给 123 个开源库做了汇编级安全证明:239 个入口点
据 Anthropic Research 的一则研究(经转述),与 Theorem 合作,用 Claude 把 OSS-Fuzz 的模糊测试结果转成形式化规格,对 123 个开源库的 239 个入口点完成了「任意 64 MB 以下输入不会崩溃」的证明,生成约 1.8 亿行 Rocq 证明。
「汇编级」是这条的分量所在:证明对象不是 C 源码,而是编译后的机器码层面——源码正确不代表编译器与优化后的产物也正确。方法链条是:模糊测试 → 形式化规格 → Claude 生成证明 → Rocq 检查。关键差别在于,模糊测试只说明「我试过的输入不崩」,形式化证明才说「这类输入都不崩」。
两处边界要写清:1.8 亿行是生成量,不等于全部通过机器检查(这一点目前未见公开说明);「64 MB 以下」是明确的上界,不是「不会崩」。另外它与本周的 PHP2Shell 正好构成对照:一个在找漏洞,一个在证明某类漏洞不存在。
一句话看懂:如果这些证明真的都过了机器检查,那才是 AI 产出「可验证正确性」的规模化成例。
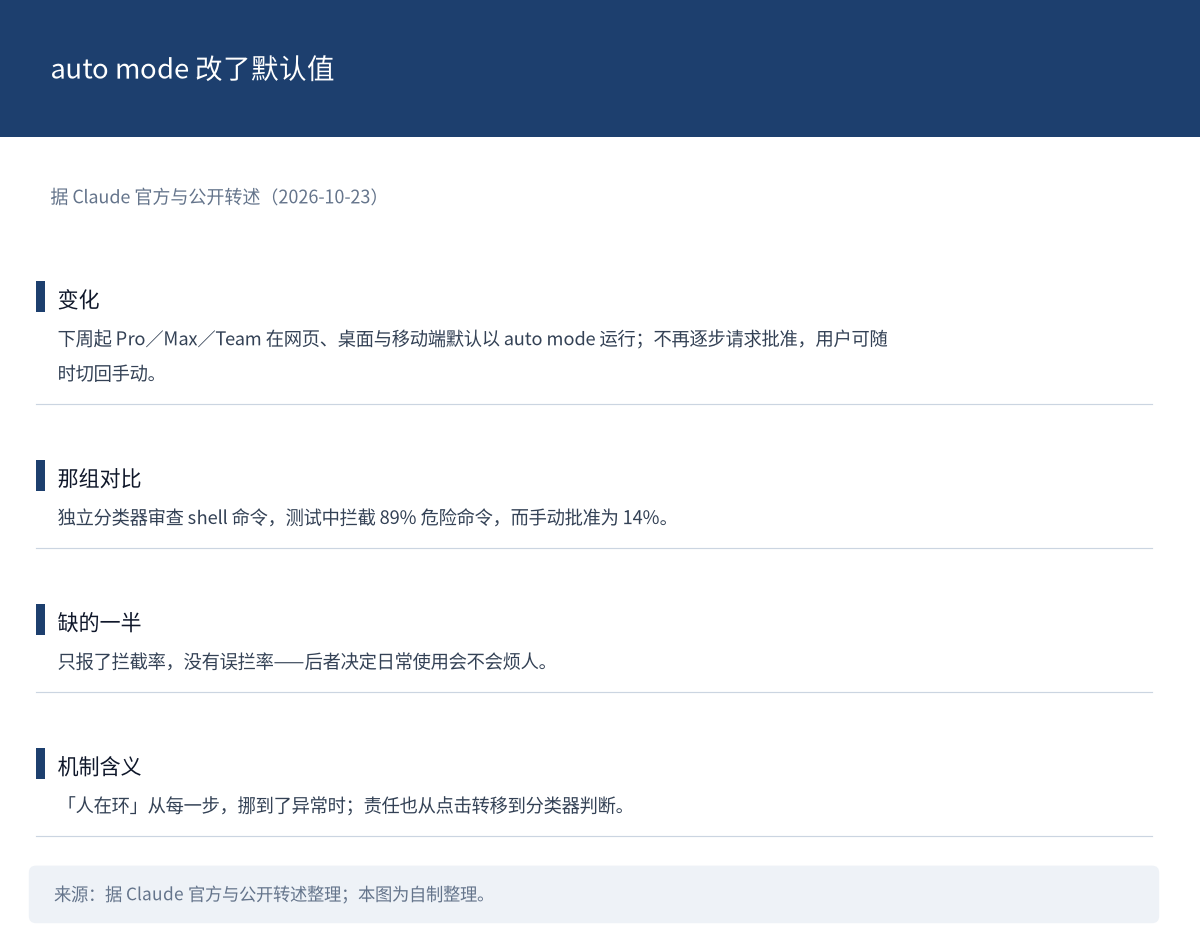
图 4:auto mode 改了默认值,也留下一个问题。来源:据 Claude 官方与公开转述整理(2026-10-23);本图为自制整理。
Claude 下周起默认 auto mode:拦下 89% 危险命令,手动批准只有 14%
Claude 官方宣布:下周起,Pro、Max 与 Team 套餐在网页、桌面与移动端的会话将默认以 auto mode 运行;不再逐步请求用户批准,改由自动检查拦截高风险操作,用户可随时切回手动模式。
最反直觉的是那组对比:auto mode 用独立分类器审查 shell 命令,89% 与 14% 是「测试中」的数据(自动拦截 89%、手动批准 14%)——也就是说,「人看着」反而漏掉了更多危险命令。但这里有个必须点出的缺失:只报了拦截率、没报误拦率,而后者决定这套机制在日常使用中会不会烦人。两者的测试集与判定口径是否相同,目前也未见公开说明。
机制上的变化值得单独说:把「人在环」从「每一步」挪到了「异常时」。体验更好,但责任从用户的每一次点击,转移到了分类器的判断上。
一句话看懂:默认值一改,安全就从「每次问你」变成了「默认不打扰、出事才拦」。
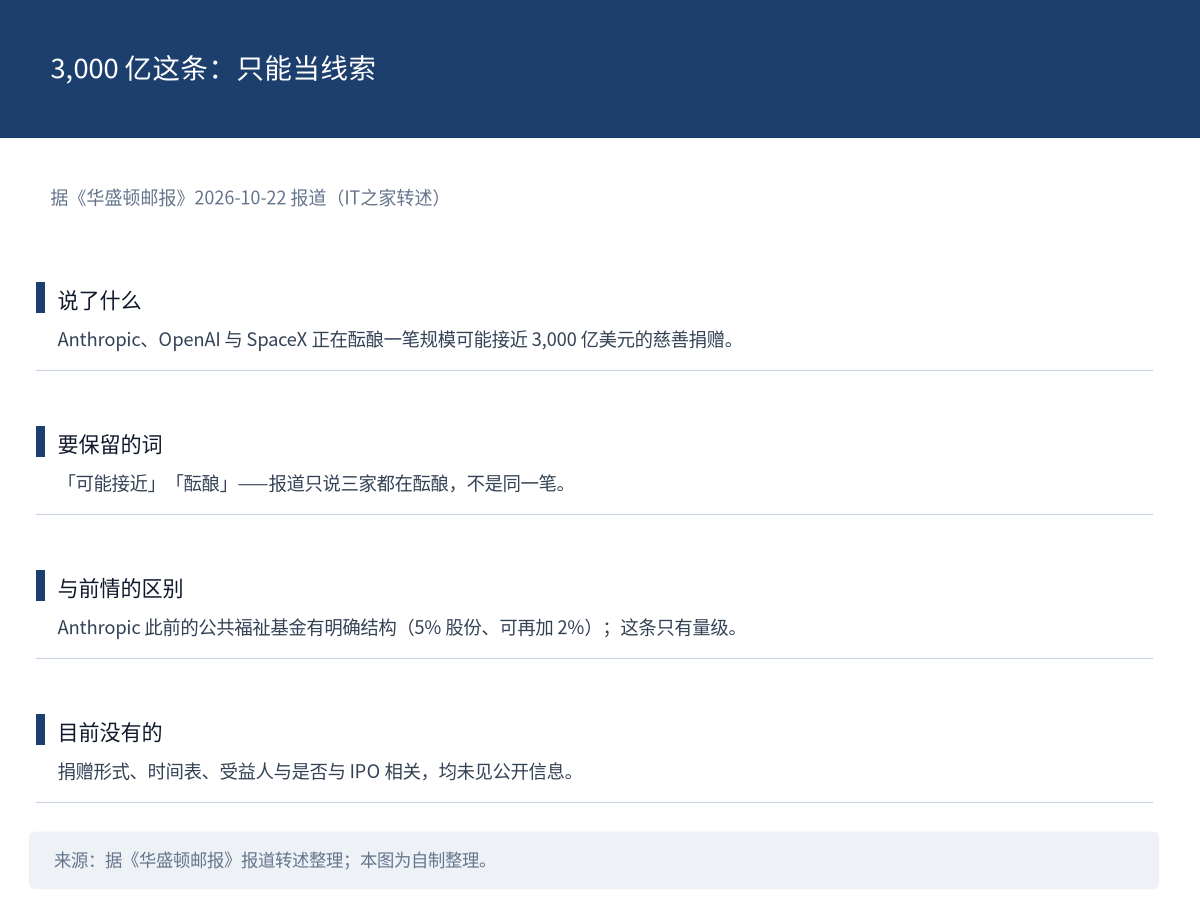
图 5:3,000 亿这条为什么只能当线索。来源:据《华盛顿邮报》报道转述整理(2026-10-23);本图为自制整理。
三家巨头拟投入近 3,000 亿美元做慈善:量级很大,细节几乎没有
据《华盛顿邮报》10 月 22 日报道,Anthropic、OpenAI 与 SpaceX 正在酝酿一笔规模可能接近 3,000 亿美元的慈善捐赠。
要留意三点:「可能接近」「酝酿」都要保留;报道只说三家都在酝酿,别并列成同一笔;以及,这与 Anthropic 此前公布的公共福祉基金不是一回事——那个有明确结构(5% 股份、随估值上涨可再加 2%),这一条只有量级。捐赠形式、时间表、受益人、是否与 IPO 相关,目前都未见公开信息。
一句话看懂:先记住量级,别急着当作已经落地的承诺。
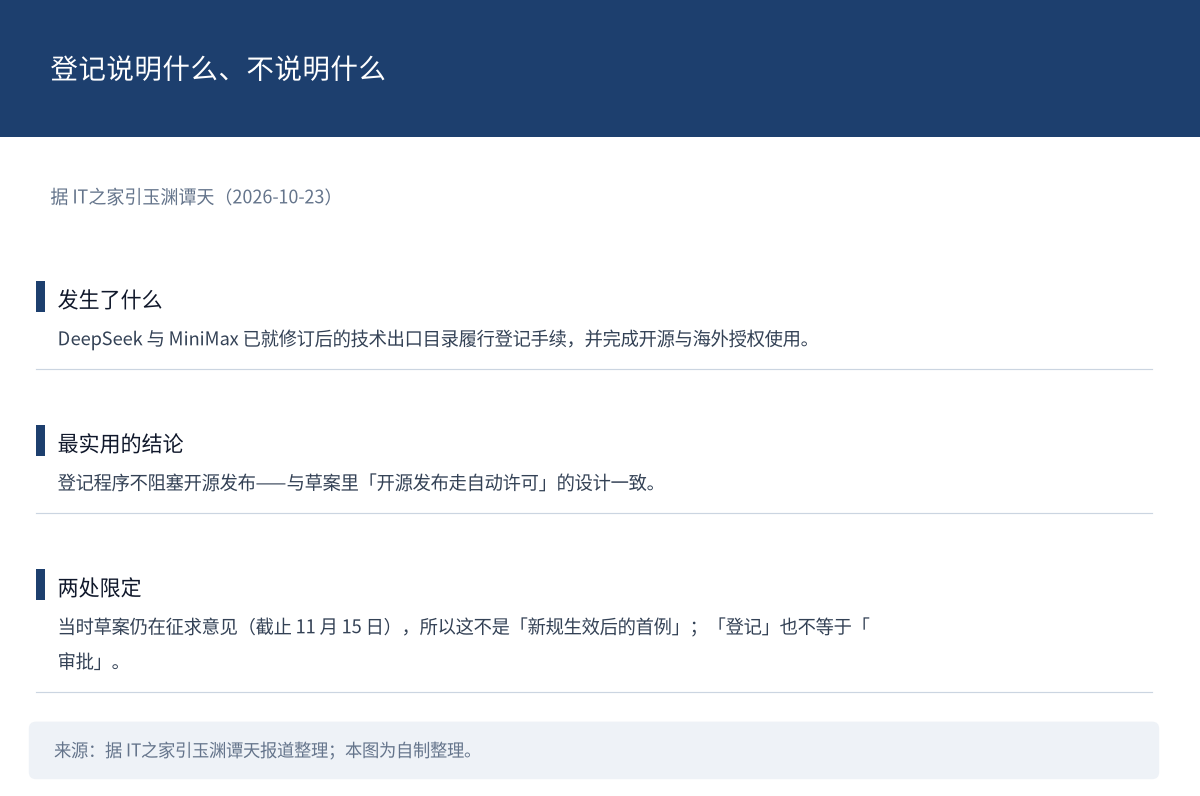
图 6:登记这件事说明什么、不说明什么。来源:据 IT之家引玉渊谭天报道整理(2026-10-23);本图为自制整理。
DeepSeek 与 MiniMax 已就出口新规完成登记:开源没有被卡住
据玉渊谭天(经 IT之家转述),自商务部、科技部就修订《中国禁止出口限制出口技术目录》公开征求意见以来,DeepSeek、MiniMax 已顺利履行登记手续,并完成开源和海外授权使用。
这条最实用的结论是:登记程序并不阻塞开源发布——与草案里「开源发布走自动许可」的设计一致。两处限定必须带上:当时草案仍处征求意见阶段(截止 11 月 15 日),所以这是「征求意见期间的登记」,不是「新规生效后的首例」;「登记」也不等于「审批」。
一句话看懂:对国内开发者来说,这条的意思很直接——开源照发,但登记这道手续要办。
 快讯速览
- OpenAI 正式发布 Decisions API:基于 GPT-6 Luna,面向分类、路由、评分等有界答案问题,称速度最高比通过 Responses API 调用 GPT-6 Luna 快 10 倍;输入每百万 token 0.1 美元(「快 10 倍」是特定场景对比,测试条件未见公开)。来源:OpenAI 官网与 IT之家(10-23)
- Replit 发布 Monitoring Agent,相当于自主值班工程师:读取生产日志与指标调查错误、变慢与部署失败;autofix 开启后验证修复并邮件汇报,auto-publish 开启后可自动部署(两个开关分开,不是默认全自动)。来源:Replit Blog(10-23)
- 1Password 推出 1Password for Agents:让个人 AI 智能体在不接触、不存储密码或验证码的情况下代用户登录,面向个人与家庭版用户,首批支持 Meta Muse、ChatGPT Work 与 Dots、Claude Duet、Grok Bot 及 Town。来源:IT之家(10-23)
- grok @bot 0.75.2 发布:新增可生成并持续更新的报告、备忘录与仪表盘页面,每个桌面聊天新增卡片,并可从一段描述或一张图片生成视频。来源:Eric Zakariasson(10-23)
- Grok Bot 可连接手机原生应用:可连接日历、提醒事项、通讯录、家庭、位置、闹钟与信息等,正在 iOS 与 Android 推送。来源:Testing Catalog 等(10-23)
图 7:速览 1—5 一览。来源:各条来源见上方列表;本图为自制整理。
- OpenRouter 推出 Security Center:集中审计所有 API 密钥、按风险分级浏览、识别可移除的密钥、控制 IP allowlist,并提供消费提醒、周期限额与密钥最长生命周期。来源:OpenRouter(10-23)
- MIT 的一项研究把 13 个运行 Claude Opus 4.7 的智能体放到模拟荒岛 30 小时、不给任务,它们开始自创挑战;玩过的智能体在随后的指定挑战中普遍胜过没上岛的同类,其中 6 个自行学会「跳跃中松手把方块扔得更远」(效应幅度与样本量未见公开)。来源:TechCrunch(10-23)
- Artificial Analysis 发布 Coding Agent Index v2.0,Claude Opus 5.5 登顶:改用 Cognition 的 FrontierCode v1.1 替代 DeepSWE,并修订 SWE-Atlas-QnA 评分,共 290 项任务、三大基准等权(换基准后与旧分数不可直接比较)。来源:Artificial Analysis(10-23)
- Anthropic 托管的 Claude 模型在 Google Cloud 正式可用:客户可获得完整 Claude API 功能,支持 Google Cloud IAM 凭证、计费与承诺消费抵扣,涵盖 Managed Agents、Code Execution、Computer Use 与 Agent Skills 等。来源:Testing Catalog(10-23)
- 美财长贝森特称 AI 行业没有系统性问题:他在纽约一场私人会议上告诉投资者,没发现 AI 热潮存在系统性问题,淡化了重演互联网泡沫的担忧(官员表态,与 Gartner 的减值警示恰成对照)。来源:IT之家(10-23)
图 8:速览 6—10 一览。来源:各条来源见上方列表;本图为自制整理。
- 奥尔特曼在斯坦福演讲中谈 AI 冲击数学界:称数学家会经历类似哀悼的几个阶段,从「我们完蛋了」到愤怒,再到接受 AI 成为不可或缺的工具(演讲口径)。来源:IT之家(10-23)
- PyTorch Conference NA 2026 于 10 月 20—21 日在 San Jose 举行,3500 余人参会,PyTorch 基金会公布多项生态更新(与本周 TorchTPU、TorchNeuron、llm-d 1.0 同属一个场次)。来源:PyTorch Blog(10-23)
- Perplexity 称其决策模型可在 Mac 上完全本地运行、数据不离开设备(无性能与体积数据)。来源:Aravind Srinivas(10-23)
- DeepSeek V4.1 Flash 上线 OpenClaw(渠道上线)。来源:OpenClaw(10-23)
- Beren Millidge 提出能力与对齐的三阶段:预训练 → RL → 持续自主学习,训练循环逐步内生化,核心瓶颈从「构造数据集」转向「设计可靠的判断程序」,再到「设计能在模型自主变化中维持不变量的控制系统」(框架性观点)。来源:Beren Millidge(10-22)
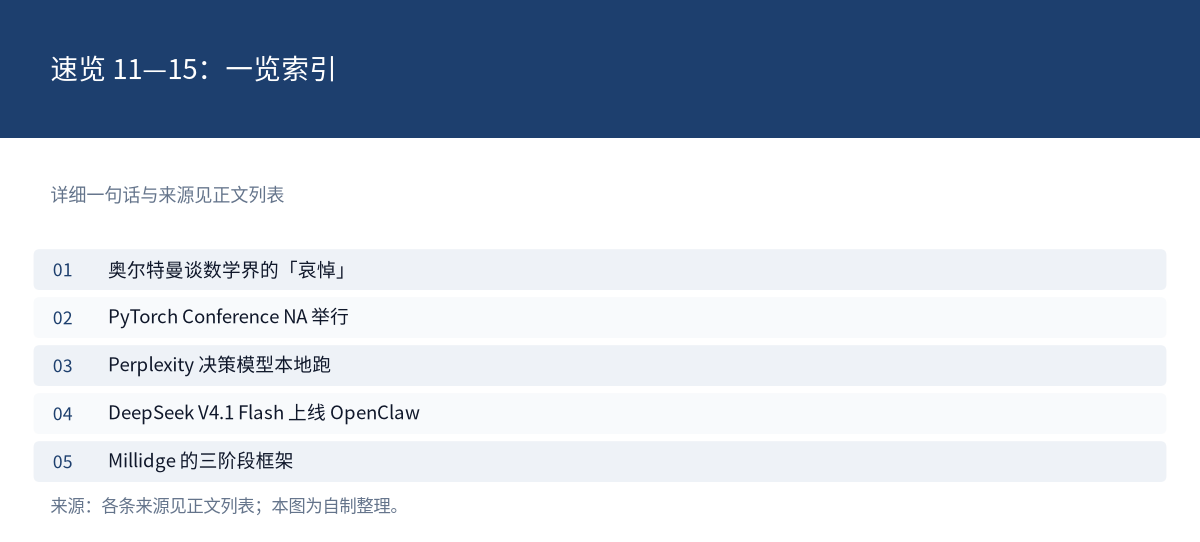
图 9:速览 11—15 一览。来源:各条来源见上方列表;本图为自制整理。
- Casey Newton 与 NPR 合作推出 AI 播客 Machine Gods:每周三、周五更新,明年初登陆公共广播电台,提出 AI realism 立场,首季将采访两名被 OpenAI 解雇的安全研究人员(「被解雇」为报道表述)。来源:Platformer(10-23)
图 10:速览 16 一览。来源:各条来源见上方列表;本图为自制整理。
- METR 与 Redwood 的评估已获英文媒体报道:热点榜显示该条聚拢 The Verge、The Decoder 等信源,中文细节已在重点里补齐。来源:AIHOT 热点榜(10-23)
图 11:速览 17 一览。来源:各条来源见上方列表;本图为自制整理。
 积木观察
今天三条都在回答「谁在为结果负责」:MiniMax 把权重放出来,但跑得怎么样要各家自己验;METR 与 Redwood 发现漏洞,OpenAI 说修了而没人验修得对不对;Claude 把默认从「每次问你」改成「出事才拦」,责任就从点击移到了分类器。
给读者一条可执行的:如果你的团队在用编码智能体,别只看它拦了多少危险命令,先问它的误拦率——只报拦截率的机制,用起来往往比看起来麻烦。
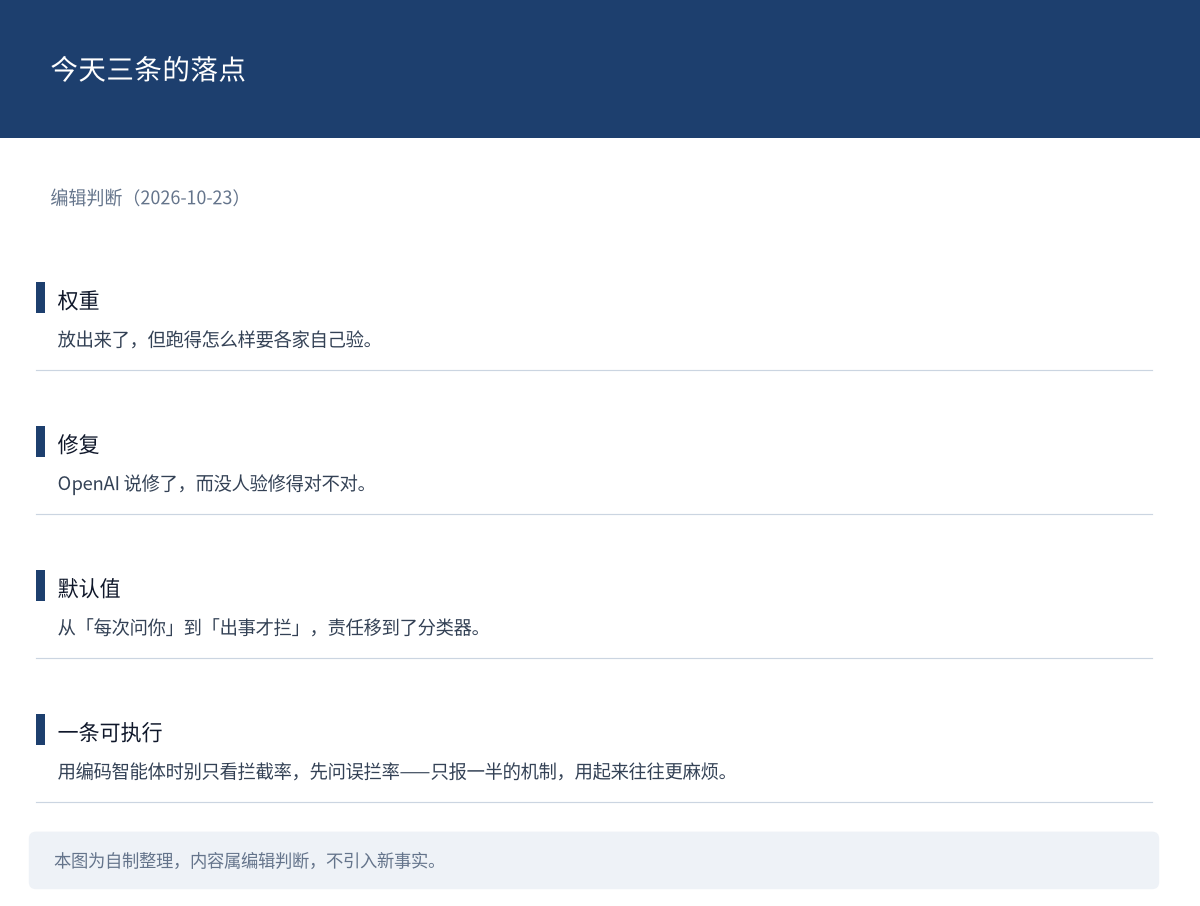
图 12:今天三条的落点。来源:本图为编辑判断,自制整理。
结尾互动
权重、修复、默认值——这三件里,你觉得哪一件最该由第三方来验?说说理由。