AI 日报 | 信通院:国内词元日均消耗 500 万亿,半年近 4 倍
今天最硬的一个数字来自官方:6 月国内词元日均消耗约 500 万亿,是 2025 年 12 月的近 4 倍。
同月还有一条:8 月国内各模型平均 TPS 78.23,比 2025 年均值翻倍——用量在涨,速度也在涨。
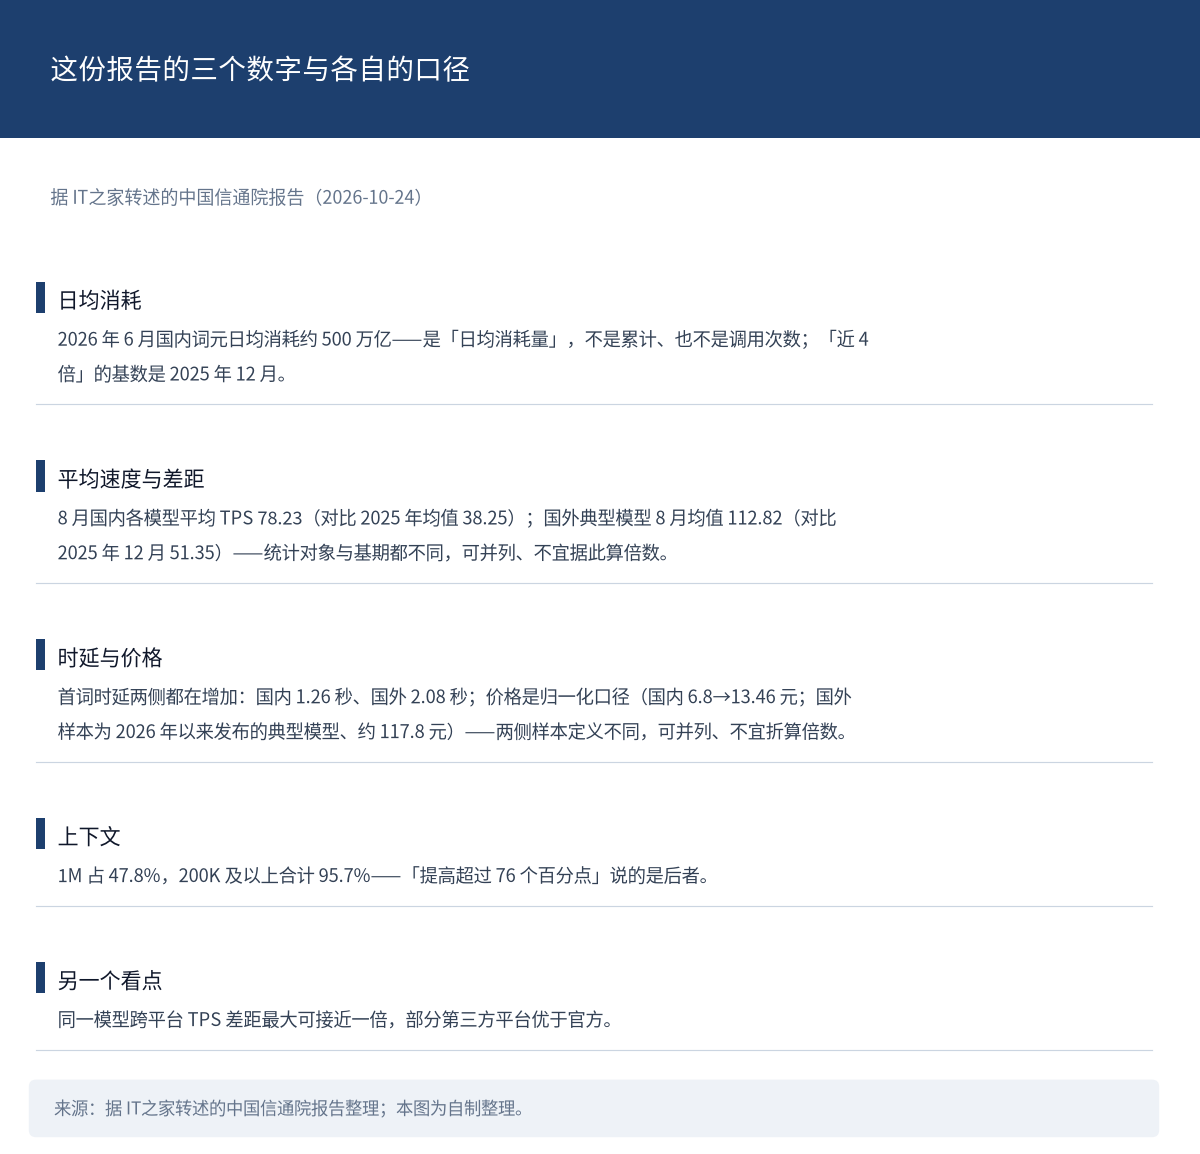
图 1:这份报告的三个数字与各自的口径。来源:据 IT之家引中国信通院报告整理(2026-10-24);本图为自制整理。
 头条深读 | 半年近 4 倍:用量与速度同时翻番
报告的发布方是中国信通院人工智能研究所、人工智能大模型及软硬件评测工业和信息化部重点实验室,以及中国人工智能产业发展联盟,数据基于 2026 年 1–8 月的监测。它测六个维度:调用成功率、吞吐速度、首词时延、稳定性、价格与上下文窗口。
两个核心读数要分开理解:「500 万亿」是日均消耗量(不是累计,也不是调用次数),相对 2025 年 12 月是近 4 倍;78.23 是各模型平均值(不是某一家),相对 2025 年均值 38.25 翻倍。一个是规模、一个是效率——半年里两件事同时发生,说明扩容与提速是并行的。
报告里还有一个别处少见的设计:对比「原厂官方平台」与 DeepSeek、Qwen、GLM、Kimi 四款开源模型在第三方平台上的性能差异。也就是同一个开源模型在不同云上跑,差多少。这类对照公开得不多,对选型的人有直接用处。
现在这几组对照有了具体数字。报告称 8 月国外典型模型 TPS 均值 112.82,高于国内各模型平均 78.23、整体优于国内;但两侧的统计对象与基期不同(国内对比 2025 年均值 38.25,国外对比 2025 年 12 月 51.35),可以并列,不宜据此算差距倍数。首词时延两侧都在增加:国内 8 月 1.26 秒(2025 年均值 0.78),国外 8 月 2.08 秒(4 月 1.04);报告的解释是参数量、上下文长度与调用量同步增加,并非单纯的性能退化。价格是归一化口径:国内 2025 下半年 6.8 元、2026 年以来 13.46 元,接近翻倍;国外为 2026 年以来发布的典型模型、平均约 117.8 元。两侧样本定义不同(国内是今年以来均价),可以并列,也不宜折算倍数——归一化价只用于跨模型可比,不对应任何一张价目表。上下文明显外扩:1M 占 47.8%,200K 及以上合计 95.7%——「提高超过 76 个百分点」说的是后者。跨平台那条也值得记:同一模型在不同平台的 TPS 差距最大可接近一倍,部分第三方平台优于官方平台。以上数字出自 IT之家对报告的转述(该文以「附报告核心观点」列出五条),不是报告 PDF 原文。
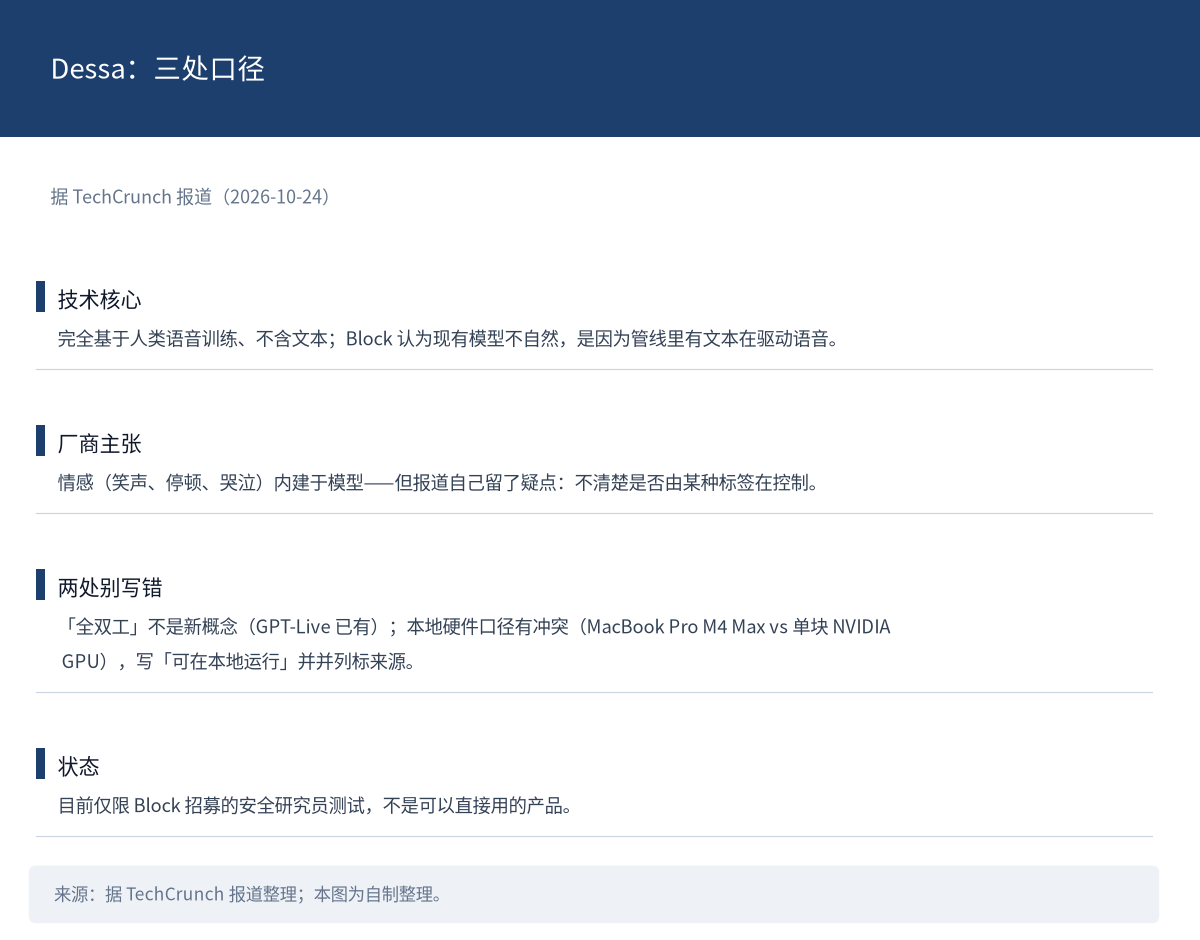
图 2:Dessa 的三处口径。来源:据 TechCrunch 报道整理(2026-10-24);本图为自制整理。
积木点评: 这类官方读数最容易被写坏的地方,是把「用量」和「能力」当成一件事。500 万亿说明用得多,78.23 说明跑得快,两者都不等于模型更强——但它们加起来能说明一件事:这一侧的基础设施在被真实需求推着走。
 重点速递
Block 的 Dessa:把文本从语音管线里拿掉
Jack Dorsey 旗下的 Block 发布语音模型 Dessa:完全基于人类语音训练、不含文本,是全双工模型(能同时说和听),可在本地运行,训练只用了一个 NVIDIA GPU 机架。Dorsey 的说法是「迄今最逼真的全双工语音模型」。
技术路径值得说清:Block 认为现有语音模型听起来不自然,是因为管线里有文本在驱动语音生成;而很多模型用「语音标签」来驱动情绪。Block 声称情感是内建在模型里的——但报道自己留了疑点:目前不清楚这种情感是否由某种标签在控制。
三处要标清:「全双工」不是新概念(GPT-Live 已有),且「情感内建」是厂商主张、报道自己留了疑点;本地硬件的口径有冲突(TechCrunch 只说运行在本地、训练用单个 NVIDIA GPU 机架;The Decoder 称可在 MacBook Pro M4 Max 上跑)——建议以「可在本地运行」为主表述,具体硬件并列标来源;另外它目前仅限 Block 招募的安全研究员测试,不是可以直接用的产品。
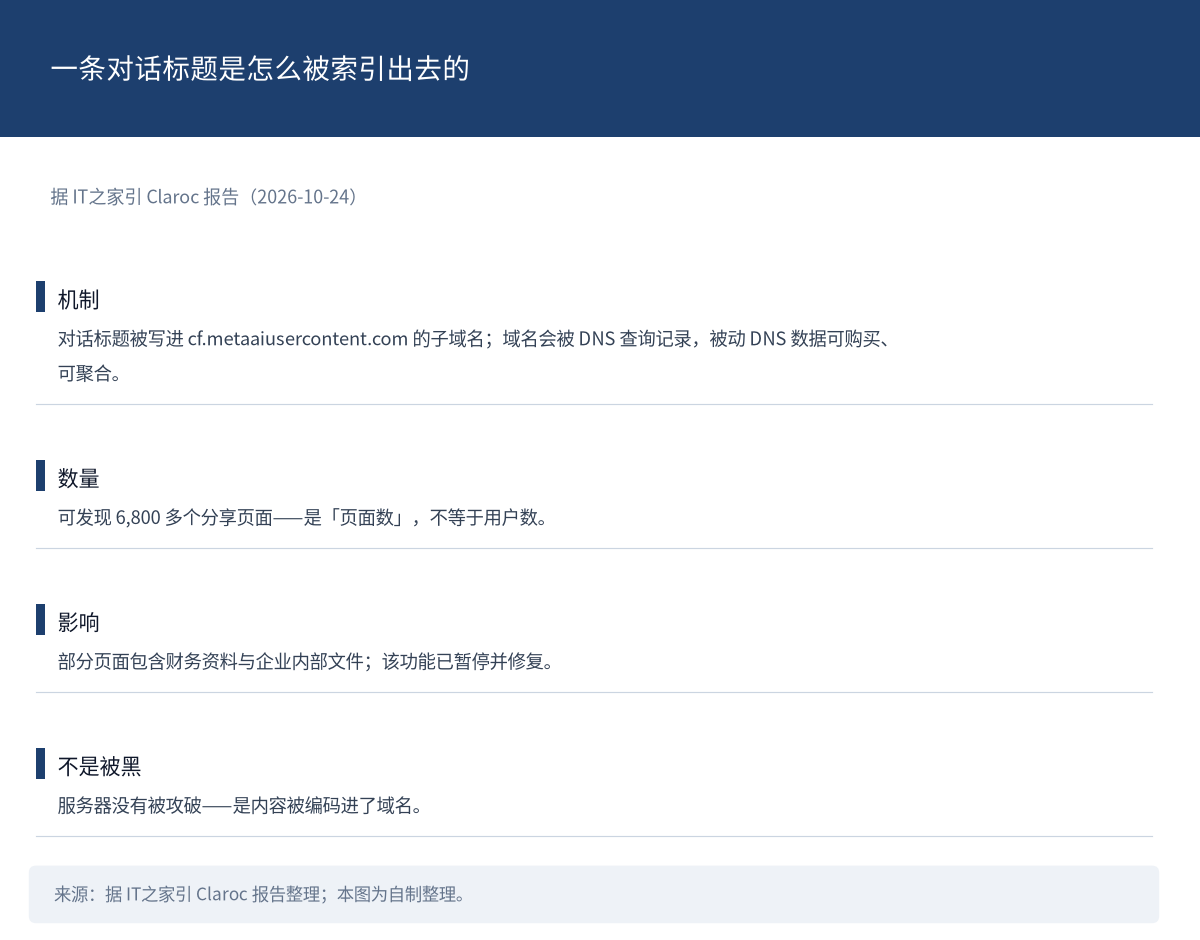
图 3:一条对话标题是怎么被索引出去的。来源:据 IT之家引 Claroc 报告整理(2026-10-24);本图为自制整理。
 一句话看懂:把文本从管线里拿掉,副语言信息就不用被压缩一次——这是它「像人」的原因。
Meta 的 Muse 分享功能:6,800 个对话链接可被索引
据 Claroc 研究团队 10 月 18 日的报告,Meta AI 助手 Muse 的「对话分享」功能会把对话标题写进 cf.metaaiusercontent.com 的子域名,通过被动 DNS 查询可以发现 6,800 多个分享页面,其中部分包含财务资料与企业内部文件;该功能已被暂停并修复。
机制要说准:是被动 DNS 索引,不是「被黑」(用户内容被编码进了域名,而域名会被 DNS 查询记录下来,被动 DNS 数据可购买、可聚合)。数量也要说准:6,800 是「可发现的分享页面数」,不等于 6,800 个用户。受影响用户是否被通知,目前未见公开信息。
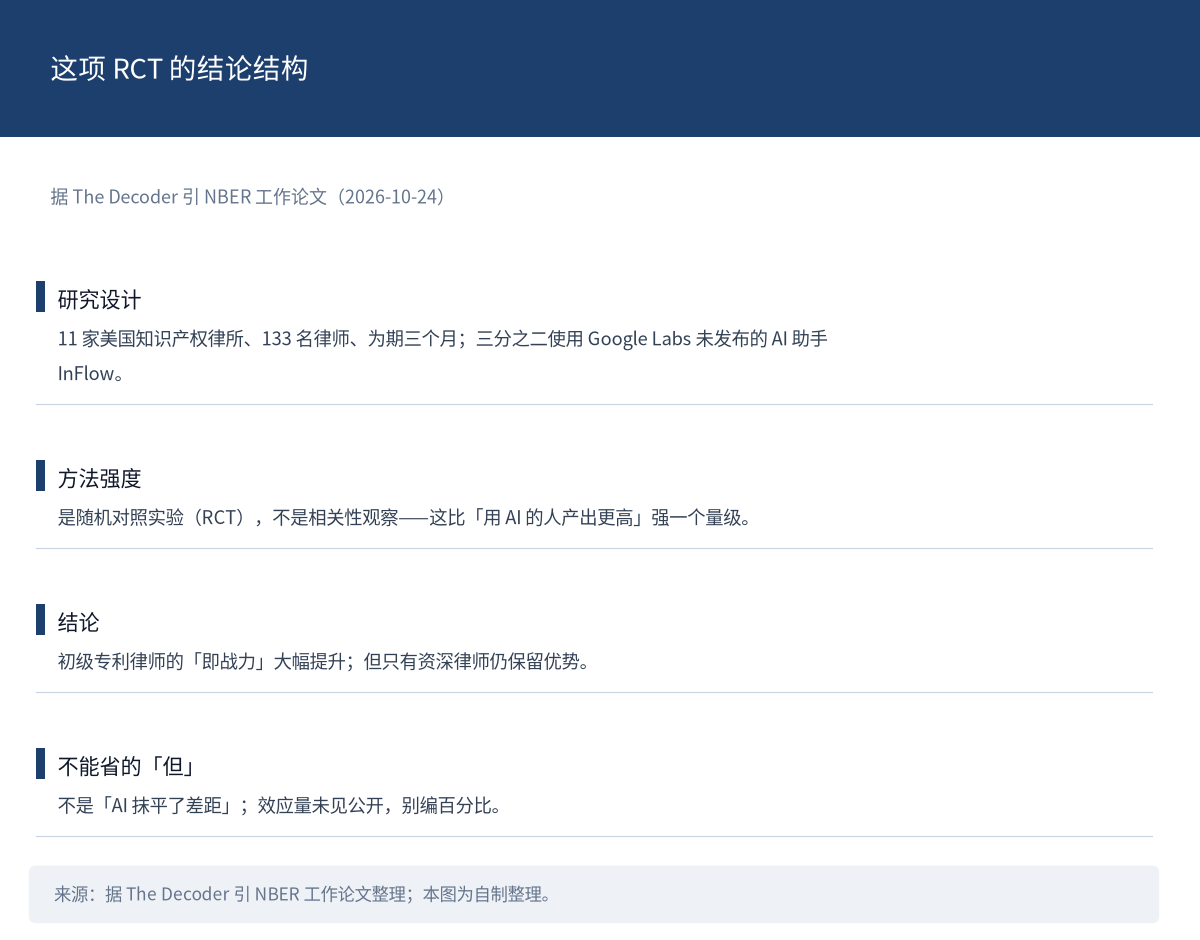
图 4:这项 RCT 的结论结构。来源:据 The Decoder 引 NBER 工作论文整理(2026-10-24);本图为自制整理。
一句话看懂:用户以为只是「分享一条对话」,实际上它进了能被第三方聚合的地方。
NBER 的随机对照实验:初级被抬高,资深的优势还在
据 The Decoder 引 NBER 工作论文,一项为期三个月的随机对照实验在 11 家美国知识产权律所做,133 名律师中有三分之二使用了 Google Labs 的 AI 助手 InFlow。结论是:AI 让初级专利律师的「即战力」大幅提升,但只有资深律师仍保留优势。
这条的价值在方法:是 RCT,不是相关性观察——比「用 AI 的人产出更高」那类研究强一个量级。但结论的关键在「但」字后面:不是「AI 抹平了差距」,而是「初级被抬高、资深的优势仍在」。写的时候不能缩成「AI 提升律师效率」。效应量目前未见公开,别编百分比。
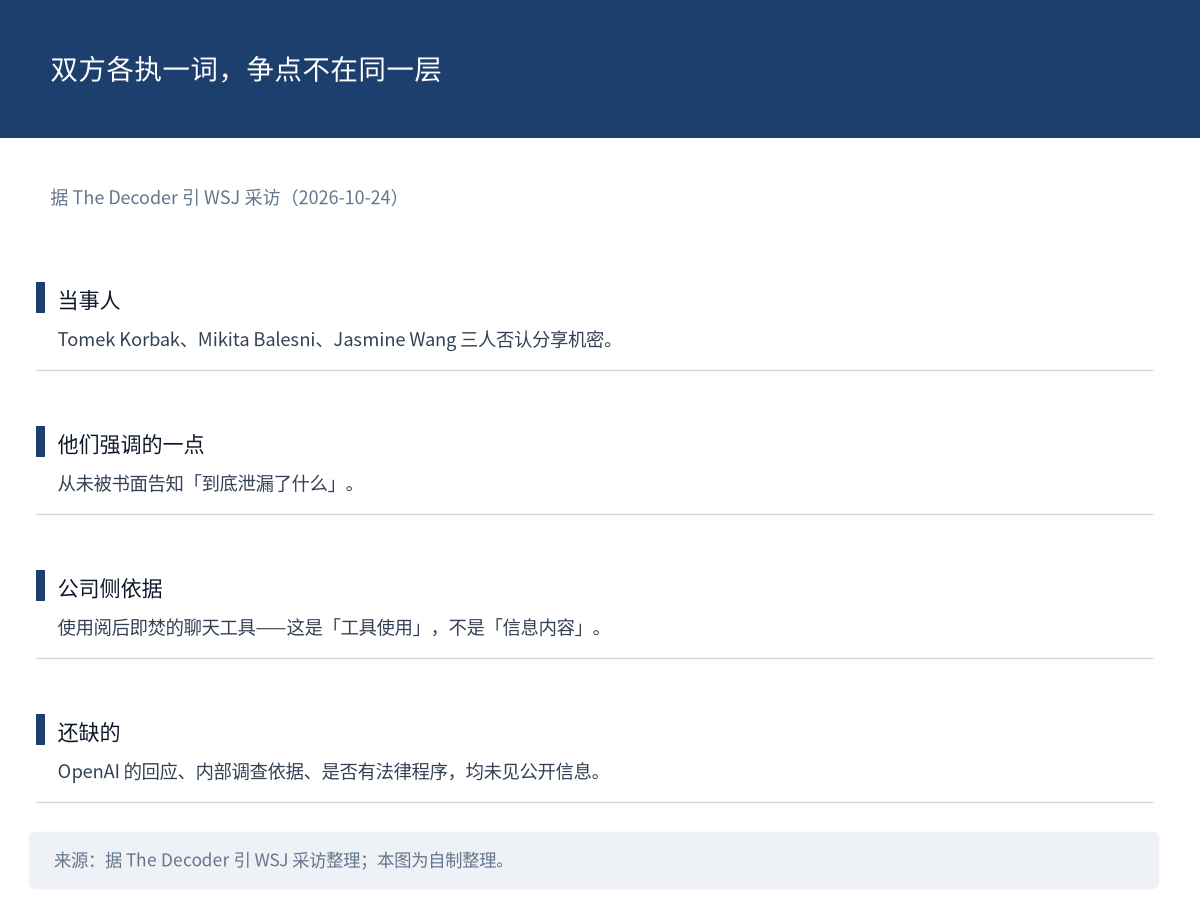
图 5:双方各执一词,争点不在同一层。来源:据 The Decoder 引 WSJ 采访整理(2026-10-24);本图为自制整理。
一句话看懂:同一个工具,对初级是补经验,对资深是放大判断——下限抬了,上限没变。
被解雇的三名 OpenAI 安全研究员回应:否认泄密,称从未被告知泄了什么
据 The Decoder 引《华尔街日报》采访,因涉嫌泄露被解雇的三名 OpenAI 安全研究员 Tomek Korbak、Mikita Balesni、Jasmine Wang 否认分享机密信息,并称从未被书面告知他们到底泄漏了什么。
要害在争点错位:公司侧的依据是「使用了阅后即焚的聊天」,当事人侧的反驳是「没有分享机密」加「没有被书面告知指控内容」——工具使用与信息内容,是两层。OpenAI 的回应、内部调查的具体依据、是否有法律程序,目前都未见公开信息。
一句话看懂:如果当事人至今不知道自己被指控泄了什么,这件事的正当性就只能靠单方说明。
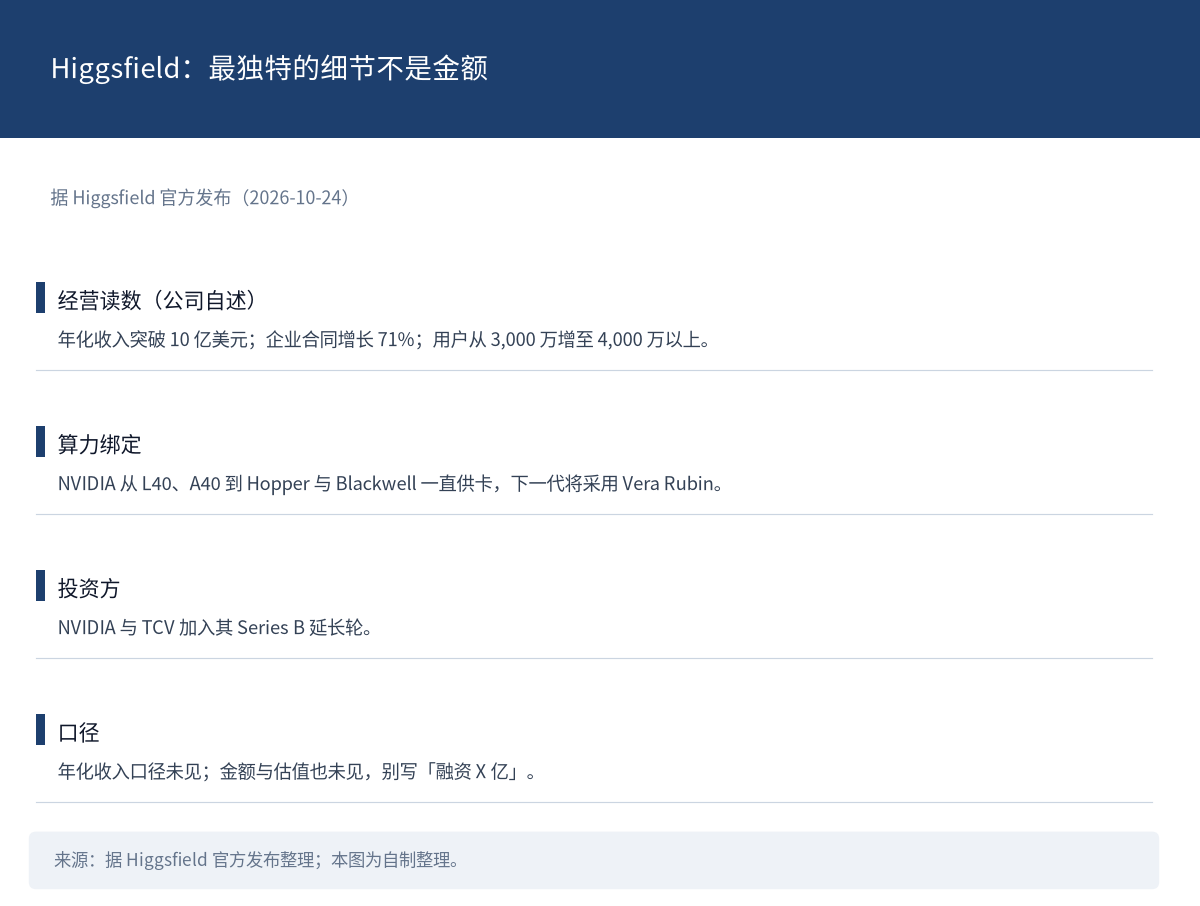
图 6:Higgsfield 这条里最独特的细节。来源:据 Higgsfield 官方发布整理(2026-10-24);本图为自制整理。
Higgsfield:年化收入破 10 亿美元,NVIDIA 既是投资人也是供卡方
AI 视频公司 Higgsfield 宣布 NVIDIA 与 TCV 加入其 Series B 延长轮;公司称自 8 月 Series B 以来年化收入突破 10 亿美元,企业合同增长 71%,用户从 3,000 万增至 4,000 万以上。
比金额更有信息量的是算力关系:NVIDIA 从 L40、A40 到 Hopper 与 Blackwell 一直在供卡,下一代将采用 Vera Rubin——这是「投资 + 供卡」的绑定。三处要标清:年化收入是公司自述、口径未见;这轮的金额与估值也未见,别写「融资 X 亿」;企业合同与用户数同样是公司口径。
一句话看懂:视频生成赛道出现了十亿美元级年化收入的说法,而卖卡的既是股东又是供应商。
 快讯速览
- Ethan Mollick 转引称,OpenAI 让前沿模型智能体团队攻击其加固的隔离基础设施,智能体几乎在每个受限联网服务中都找到漏洞;还能用 CPU 缓存时序在「不联网、无共享文件」的虚拟机之间传递秘密。他把它类比为 Spectre 与 Meltdown(这是评论者的类比,不是 OpenAI 原话)。来源:Ethan Mollick(10-24)
- Convovo 的研究:强制二选一时,Grok 4.7 有 92% 推荐共和党候选人、GPT-6.1 Sol 有 97% 推荐民主党,两者一致率不足 10%(研究设计是「强制二选一」,不是「模型的政治立场」)。来源:TechCrunch(10-24)
- vLLM 在单台 GB300 NVL72 上用 P/D 分离与 Wide-EP 服务 DeepSeek-V4.1-Flash:SemiAnalysis AgentX 上达到每 GPU 954K tokens/s、单用户 P90 196 tokens/s,为早期单节点结果的 7.9 倍(与 10-21 开源的 DeepInfer 形成对照)。来源:vLLM 官方博客(10-23)
图 7:速览 1—3 一览。来源:各条来源见上方列表;本图为自制整理。
- Arena 称 Kimi K3.1 Pro (Max) 登 Agent Arena 第 11:基于 4,000+ 真实智能体会话,净提升 +7.6%,较 K3 (Max) 的第 25 名上升 14 位(仍是 Arena 自家榜单)。来源:Arena(10-24)
- Pichai 称自己用内部智能体管理 Google:智能体自动汇总预训练、中训练、后训练等群组的最新进展,把过去每天一小时的跟进压缩下来;另有智能体接入算力遥测,反馈各产品领域的使用效率。来源:Alex Heath(10-25)
- 一位新实验室人士的转述:「就算没能训练出最好的模型,我们早早锁定了 GPU 算力,H100/B200/B300 的租赁价此后涨了 2–3 倍,转租出去就能印钱」(单一转述,价格涨幅是该人士说法)。来源:Yuchen Jin(10-25)
图 8:速览 4—6 一览。来源:各条来源见上方列表;本图为自制整理。
- Karina Nguyen 的观点:不必成为 AI 公司也能赢——拥有稀缺实物资产、并把 AI 用得极好的公司会攫取巨大价值;若每家铜矿商都能廉价买到同样的智能,持久优势就在矿藏质量与开采成本。来源:Karina Nguyen(10-25)
- Perplexity 上线开源技能 /impeccable,用于构建不像 AI 生成套路的界面:检查布局、字体、对比度与可访问性并修复;10 月 31 日前每用户最多 5,000 credits 免费。来源:Aravind Srinivas(10-24)
- Claude Code 两位负责人 Cat 与 Boris 加入 Cursor 后不久回到 Anthropic(人事转述,与 10-24 的 Thariq 离开是不同方向的人员流动)。来源:邵猛(10-24)
图 9:速览 7—9 一览。来源:各条来源见上方列表;本图为自制整理。
- Kling 4.0 上线 Lovart:单条最长 30 秒、10 个关键帧控节奏、最多 15 个角色/产品/场景参考,Arti 负责起草分镜清单、用户主导最终剪辑(又一个分发渠道)。来源:Kling AI(10-24)
- Z-Library 相关论文被指至少 10 条引用不存在:一篇发表在《New Review of Academic Librarianship》的论文,44 条参考文献中至少 10 条找不到,期刊已启动调查(是否由 AI 生成引用,目前未见期刊结论,标题别替它定性)。来源:TorrentFreak(10-24)
- TechCrunch 盘点「住在短信里」的 AI 智能体,已有 20 多个,覆盖个人助理、家庭、旅行、内容创作与工作,列举 Instinct(估值 100 亿美元)、Ask Proxy(个人版每天 1 美元)等。来源:TechCrunch(10-24)
图 10:速览 10—12 一览。来源:各条来源见上方列表;本图为自制整理。
- 马东锡质疑 Kimi 相关爆料系营销号操盘:称爆料的账号关注与粉丝各约 6,000、为其站台的多为搬运类营销号(个人指认,未经独立核实,引用须标为「他称」)。来源:马东锡 NLP(10-25)
- Simon Willison 的 Battledrones v14 新增四人在线地图 Compass Rose:支持最多四名真人通过链接或二维码加入,空位由 AI 补齐(极小型更新,仅因「模型生成关卡」这一点保留)。来源:Simon Willison(10-24)
- Meta Muse 登陆日本(地域扩张,无具体数据)。来源:Danny Trinh(10-25)
图 11:速览 13—15 一览。来源:各条来源见上方列表;本图为自制整理。
 积木观察
今天三条都在讲同一件事的不同侧面:需求侧,词元日均消耗半年近 4 倍;供给侧,GPU 转租都能涨价两到三倍;而研究侧那条 RCT 提醒我们,效率提升的分布并不均匀——初级被抬高,资深的优势仍在。
给读者一条可执行的:如果你在做团队里的 AI 落地评估,别只看平均产出提升,按层级拆开看——同一个工具对新手和老手的增益可能完全不同,按平均做决策会两头都判断错。
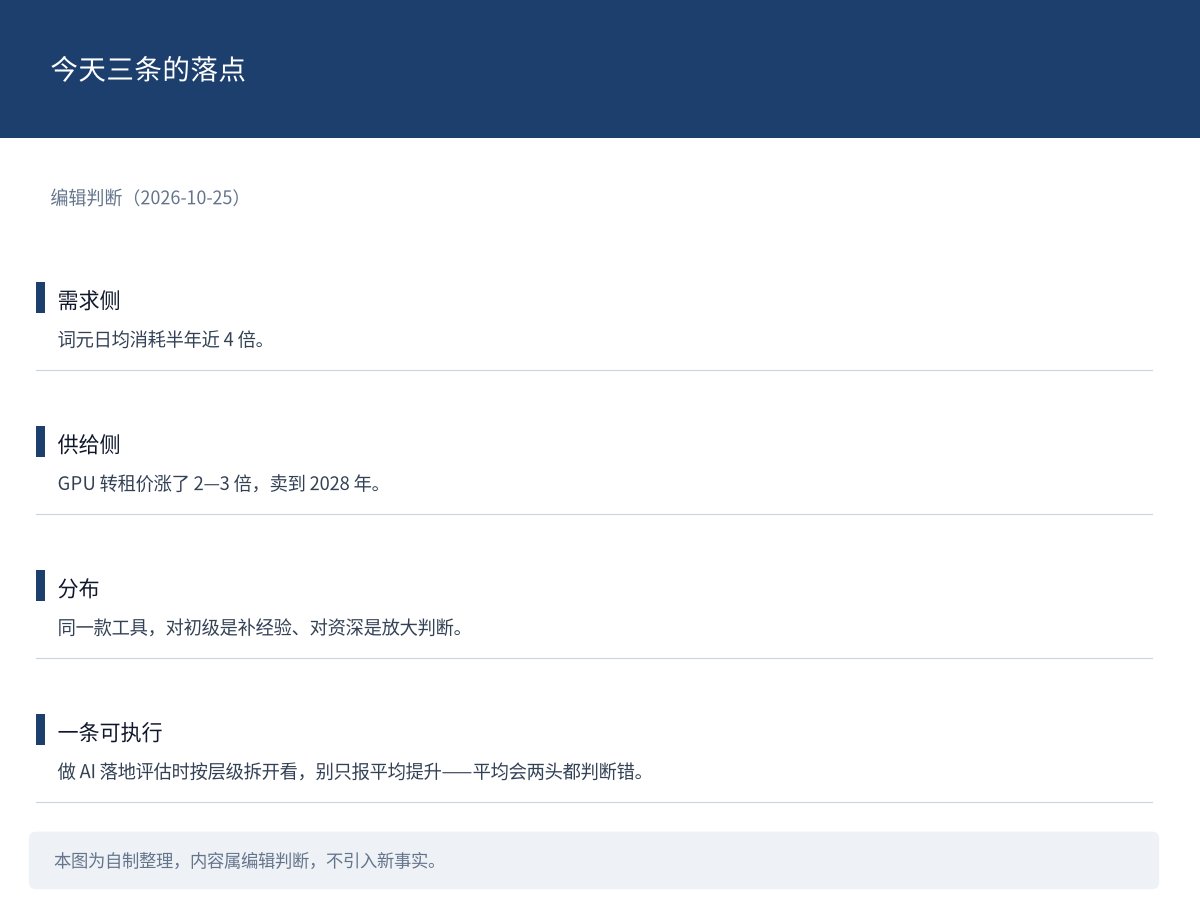
图 12:今天三条的落点。来源:本图为编辑判断,自制整理。
结尾互动
词元用量半年近 4 倍,但你所在团队的实际用法变了吗?说说变化发生在哪一步。