AI 日报 | Anthropic 免费扫漏洞,11 天报 77 危急
一个 AI 扫描器在 11 天里对一个关键开源项目报出 77 个危急、803 个高危缺陷,然后 curl 照着报告修掉了一个真实漏洞。
这条比「模型又拿了个分」重要:它意味着 AI 找漏洞这件事,已经从演示走到了改代码。
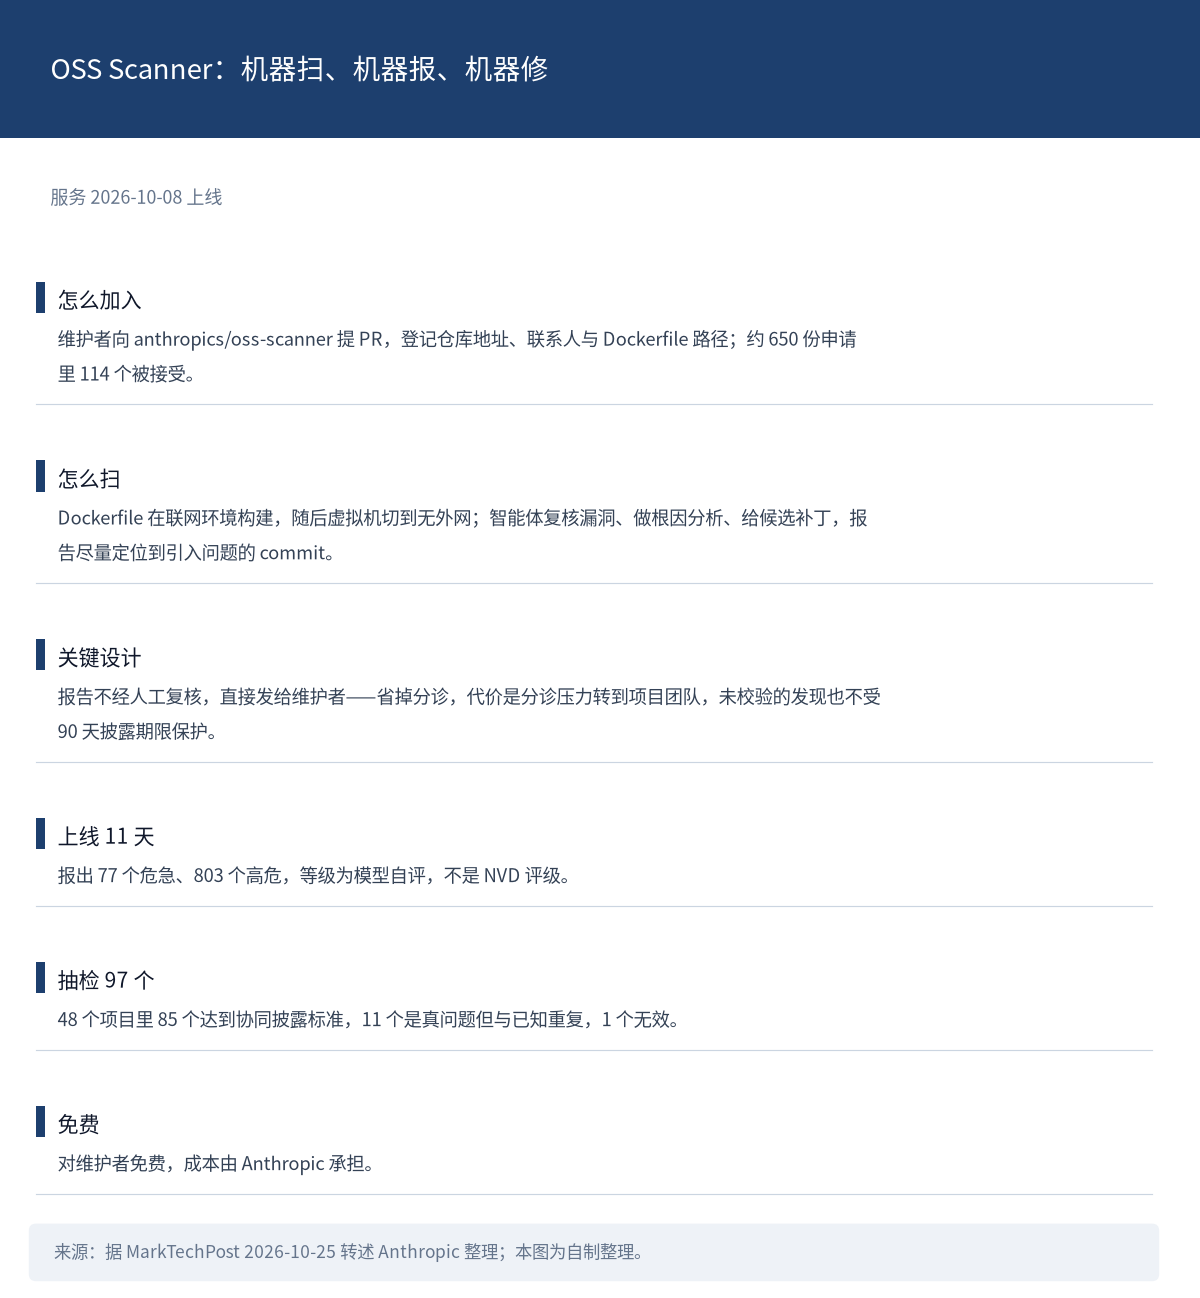
图 1:OSS Scanner 的机制与它已经产生的结果。来源:据 MarkTechPost 2026-10-25 转述 Anthropic 整理;本图为自制整理。
 头条深读 | 报告不经人看,直接发给维护者
Anthropic 的「前沿红队与保障研究」团队做了一个叫 OSS Scanner 的免费扫描服务。维护者的加入方式是向 anthropics/oss-scanner 提交一个 PR,登记仓库地址、联系人、Dockerfile 路径。
扫描流程是:Dockerfile 在联网环境里构建,随后虚拟机切到无外网状态,模型在里面定期审计代码;流水线里的智能体负责复核漏洞、做根因分析、给出候选补丁。每份报告带可独立复现的样本与成因说明,尽量定位到引入问题的那个 commit。
最特别的一处设计是:报告不经人工复核,直接发给维护者。这是一次刻意的取舍——省掉人工分诊,代价是把分诊压力转给了项目团队;而且未经校验的发现不受 90 天披露期限的保护。
这组数字要拆开:Anthropic 让渗透测试员核查了 48 个项目里的 97 个危急与高危发现,85 个达到其协同披露标准,11 个是真问题但与已知问题重复,1 个无效。所以「88% 有效」里含 11 个重复项,把它写成「准确率 88%」是错的。
外部维护者那边有独立的数据点:wolfSSL 收到 74 份报告,除 2 份外均有效,其中 5 个成为 CVE。
已经落地的修复在 curl。它据此修了 CVE-2026-92392,一个高危的 HTTP/2 上传 use-after-free,影响 8.12.0 到 8.22.0,8.23.0 已修复,该版本 10 月 14 日发布。
规模上,截至 10 月 19 日约 650 份申请里有 114 个项目被接受。更早的六个月里,模型累计报出 29,000 多个候选漏洞,人工只分诊了约 6,000 个,另有近 5,000 份未经校验的报告直接发给了「要全量」的维护者。OSS Scanner 就是把这件事制度化。
它借鉴了 Google OSS-Fuzz 的思路,但把模糊测试器换成了语言模型;与 OpenAI 的 Codex for OSS、DeepMind 的 CodeMender 相比,差异在于扫描由 Anthropic 自己跑、维护者不用跑,以及没有人工复核这一环。
「危急」「高危」是模型自评的等级,不是 NVD 评级;这些数字的出处是 MarkTechPost 对 Anthropic 的转述,官方页面本身没有打开。
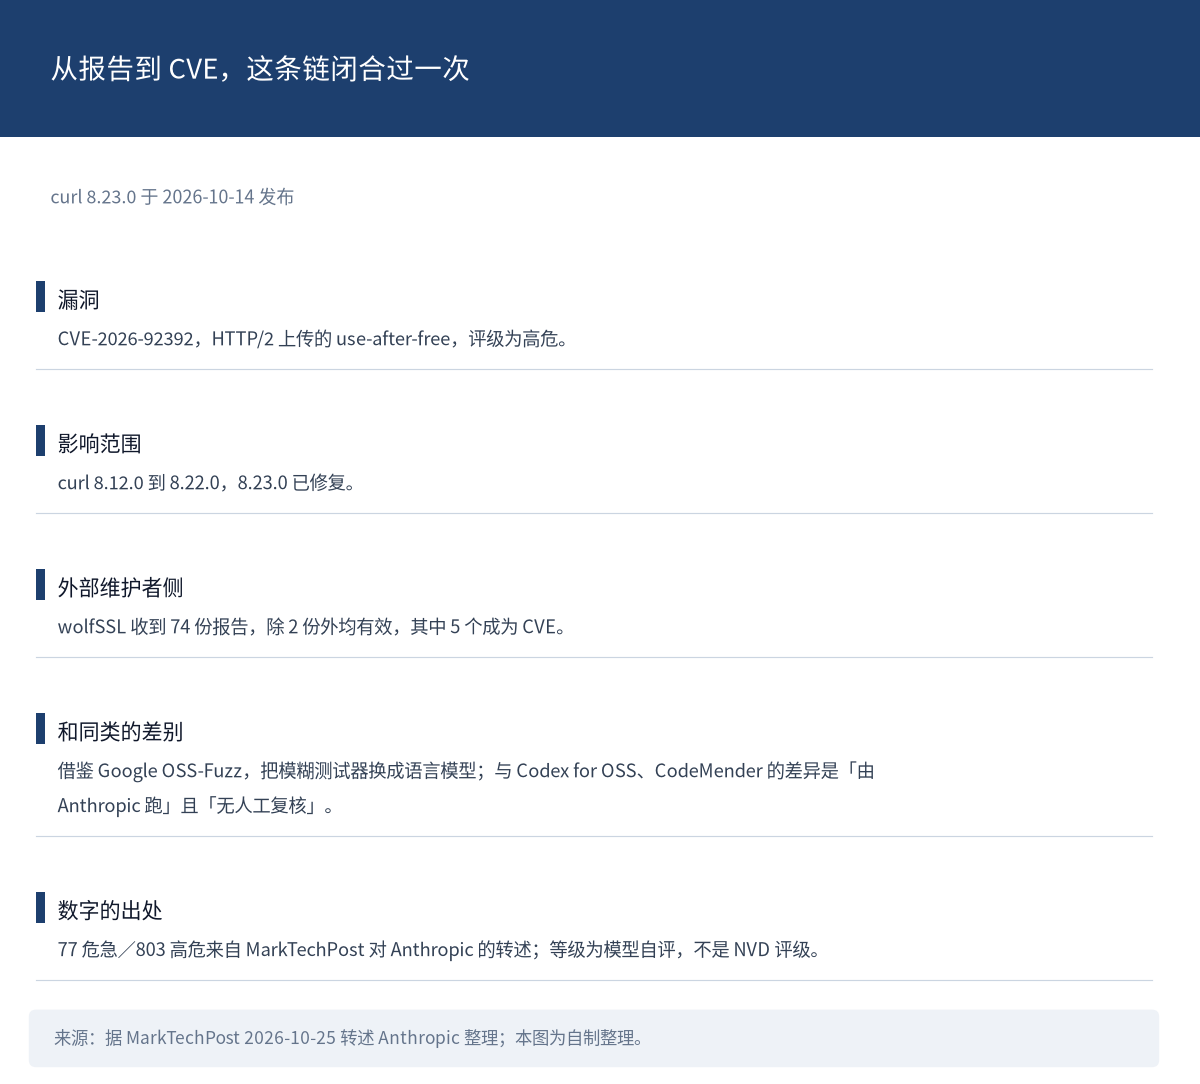
图 2:从报告到 CVE,这条链已经闭合一次。来源:据 MarkTechPost 2026-10-25 转述 Anthropic 整理;本图为自制整理。
积木点评: 免费不是重点,重点是它改动了真实软件——curl 那个 CVE 是硬证据。但「无人工复核」同时意味着维护者要自己当第一道过滤器,这就是它把成本挪走的地方。
 重点速递
三星堆:AI 全流程的第一步,票房 116.2 万
据猫眼专业版,10 月 23 日上映的《三星堆:未来往事》票房 116.2 万,首日超 12.5 万。据 IT之家,它是国内首部获得国家电影局公映许可证的 AI 全流程院线长片,片长 100 分钟。
「首部」这个说法锁的是三件事的交集:获公映许可证、AI 全流程、院线长片。它不等于「首部 AI 长片」;这个说法出自 IT之家,不是官方表述。
制作方式比票房更有信息量。全片依托博纳自研的电影云片场完成,团队历时两年,产出 120 余万张底图,做了上百次全片迭代;参照传统剧组设了 17 个专业分工,参与人员近百人。AI 主要承担生成与执行,创意构思、剧本、镜头设计与审美判断仍由人定。
所有角色都是原创数字形象,不含对真实演员的数字复制。
所以「AI 全流程」不等于「无人」:17 个工种、近百人、两年周期,恰好反驳了「一个人点几下就出一部电影」的想象。制作成本、排片量与密钥延期安排,报道未给出。
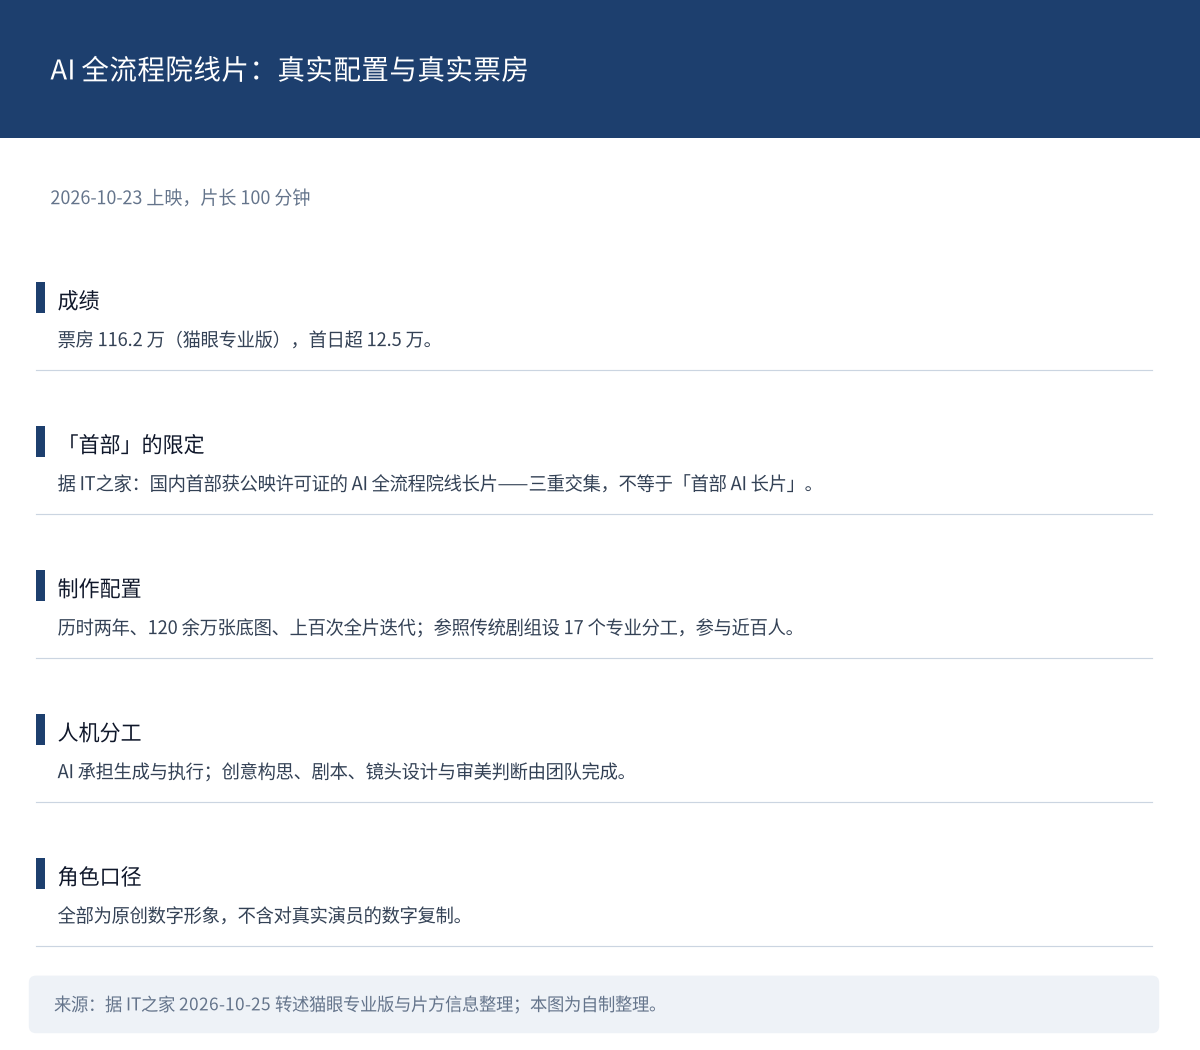
图 3:一部 AI 全流程院线片的真实配置。来源:据 IT之家 2026-10-25 转述猫眼专业版与片方信息整理;本图为自制整理。
 一句话看懂:能拿证、能上映,但票房说明它还只是「跑通了流程」。
Apollo:把七家科技股剔掉之后,AI 的红利看不见了
Apollo 首席经济学家 Torsten Slok 给了「AI 到底有没有让企业更赚钱」一个可复算的口径:看 S&P 493——标普 500 减去 Alphabet、Amazon、Apple、Meta、Microsoft、Nvidia、Tesla 这七家。
结果是利润率与人均营收都持平。他的原话是,尽管在人工智能上有巨额投入与广泛炒作,这项技术给科技行业以外的美国企业带来了「零财务回报」。他还有一句更锋利的:AI 可能是一台很好的计算器,但在商业中,智能主要体现为判断力。
这个减法本身就是论点:科技巨头的回报不能代表整个企业界。Slok 对「只是非科技公司还没跟上」的解释也不买账,认为美国企业很难把越来越便宜的智能转成更高的收入与利润率。
这是投行经济学家的拆解与观点,不是同行评议研究;具体统计期间与原始数值,报道未给出。它和 10 月 25 日那份 NBER 律师实验并不矛盾——一个看企业层面的财务结果,一个看具体岗位任务上的表现。
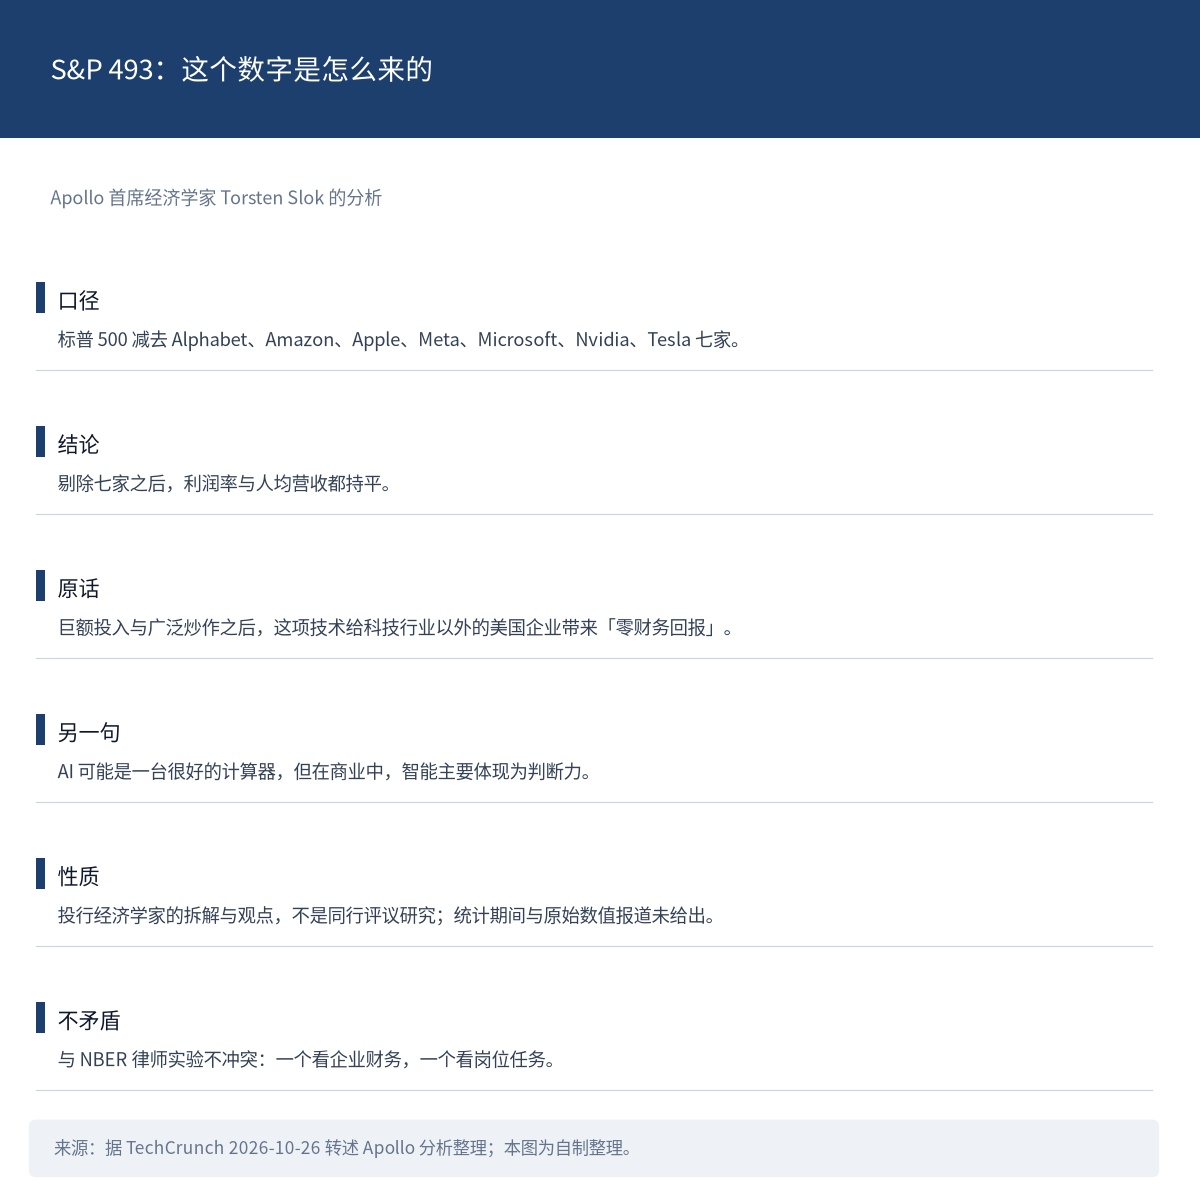
图 4:S&P 493 这个口径是怎么来的。来源:据 TechCrunch 2026-10-26 转述 Apollo 分析整理;本图为自制整理。
一句话看懂:「S&P 493」是一个被设计出来的对照,减掉七家就是它的全部意思。
TokenGate:给现成模型加一道门,长上下文先扫再精读
TokenGate 的思路像人读长文档:先扫一眼,只对值得细看的部分投入注意力。具体做法是在第 L 层用一个小型 MLP 给每个 token 打分,只把 top-K 送进更深层;被剪掉的 token 连 KV 都不建,省的是这部分显存与计算。
关键限制是只有文档部分可剪,问题部分永不剪——用户问的那几句话始终保留。
能训练是它跟免训练启发式的区别。top-K 本身不可微,作者借了 MoE 路由的做法,把保留 token 的分数当作上层注意力 logits 的偏置,给打分器留出梯度;另有可学习的温度,用来补偿每个 query 看到的 key 变少。
数字是区间而不是一个数:对全量 prefill,首 token 时延快 1.4 到 11.3 倍,峰值显存降 1.5 到 3.4 倍。11.3 倍是最佳单项,1.4 倍是下限;对次优基线,加速 1.2 到 6.4 倍。
测速条件是 1 张 A100、batch size 1,不能外推成生产吞吐;论文作者自评,尚无第三方复现。
一个额外的证据点是混合架构。在 Qwen3.5-2B 这种「门控线性注意力加全注意力」的结构上它也成立,而 FastKV 只能剪注意力层。
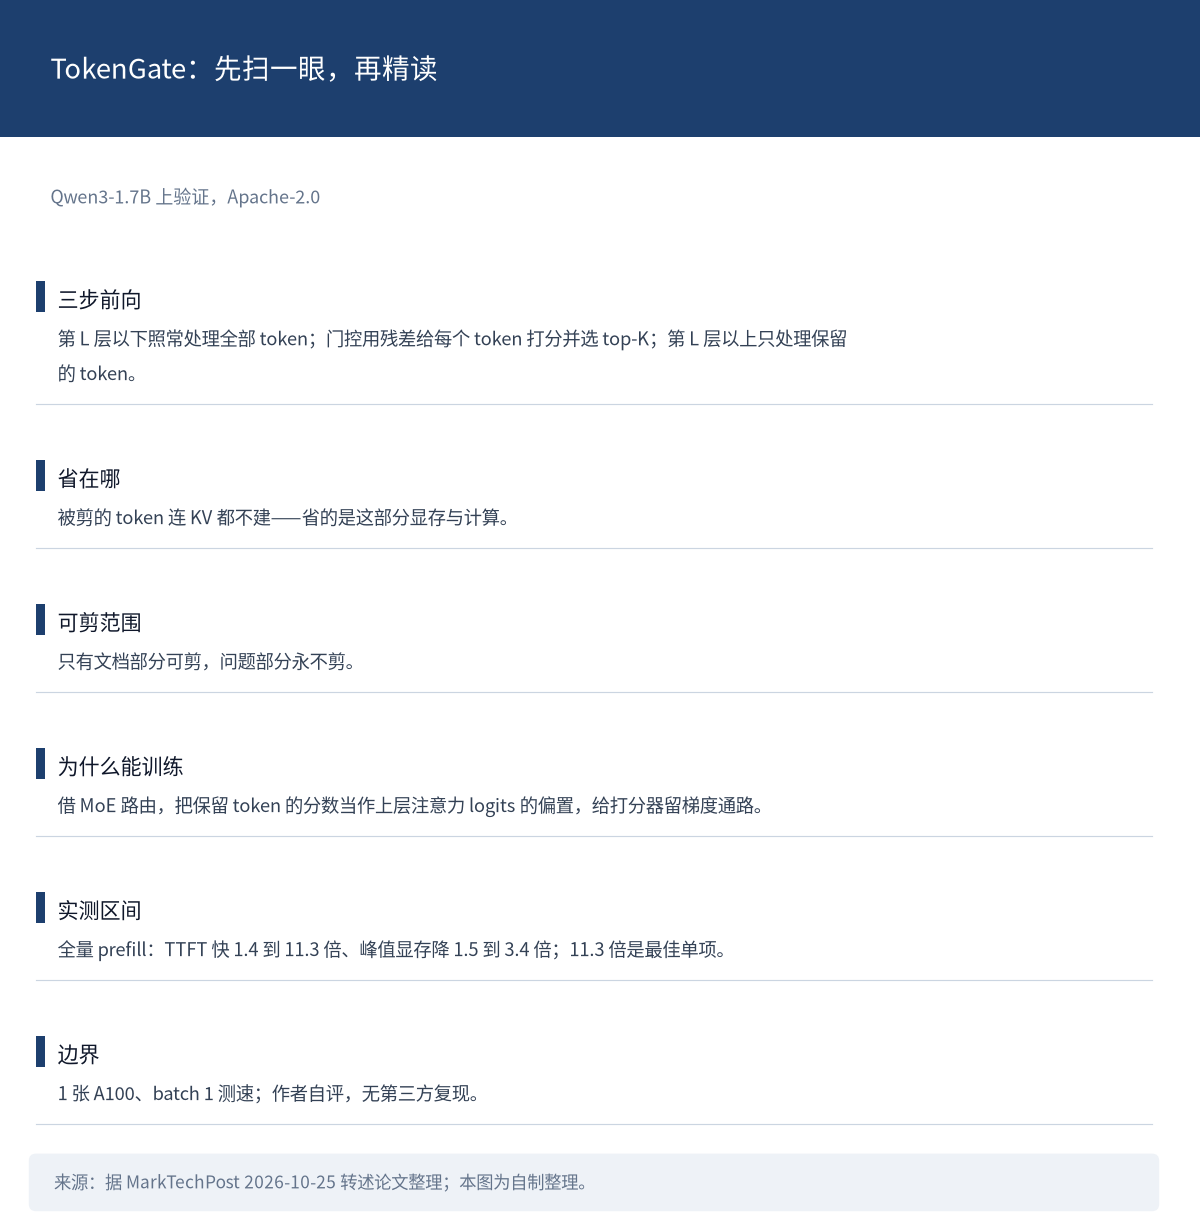
图 5:TokenGate 的三步前向与实测区间。来源:据 MarkTechPost 2026-10-25 转述论文整理;本图为自制整理。
一句话看懂:省下来的不是精度,是「不值得看的 token」的显存与计算。
Carbon-X:14.8B 的 DNA 模型,平均差 0.8 分但两项领先
Hugging Face 联合中关村学院、TIGEM 等机构发布了 Carbon-X:14.8B 稠密模型,40,960 上下文,Apache 2.0 许可,能直接读原始 DNA、用英文回答变异致病性一类问题。
做法是不另设 DNA 编码器,直接从 Qwen3-14B 起步,用混合分词器加了 5,515 个 DNA token。一个 DNA token 覆盖 6 个碱基对——这是理解它的关键:DNA 和英文被放进同一个 token 流、同一个解码器。
5 项 DNA 基准平均 66.7,对比 GPT-6.1 Sol 的 67.5、Opus 5.5 的 60.9、Kimi K3 的 50.4。所以整体落后 0.8 分,但高于另外两家;BioReason Coding 74.9 与 NextBase 39.4 两个子项领先所有被测模型。最差的一项是 GenomeQA 里的剪接位点题,29.8%。
评测条件并不对称:Carbon-X 关掉思考,对手用各自最强的推理强度。这组数字是发布方自评,不是第三方测评。
成本主张也带归属:按 H200 每小时 5 美元、实测吞吐计算,称每个问题的推理成本约为 GPT-6.1 Sol 的 1/1,800;给 240 万个「意义不明变异」打分约 300 美元。这是厂商按自家吞吐估算,不是市场价格。
部署上,1 张 80GB 卡、bf16 即可运行;官方 GGUF 提供 Q8_0 与 Q4_K_M 两个量化版本;llama.cpp 需要较新版本,旧版本会把 DNA 分词切错;必须关闭思考模式。
「首个把 DNA 与自然语言放进同一模型」是转述标题的措辞,原文没有这样表述。原文同时明确说未做临床验证。
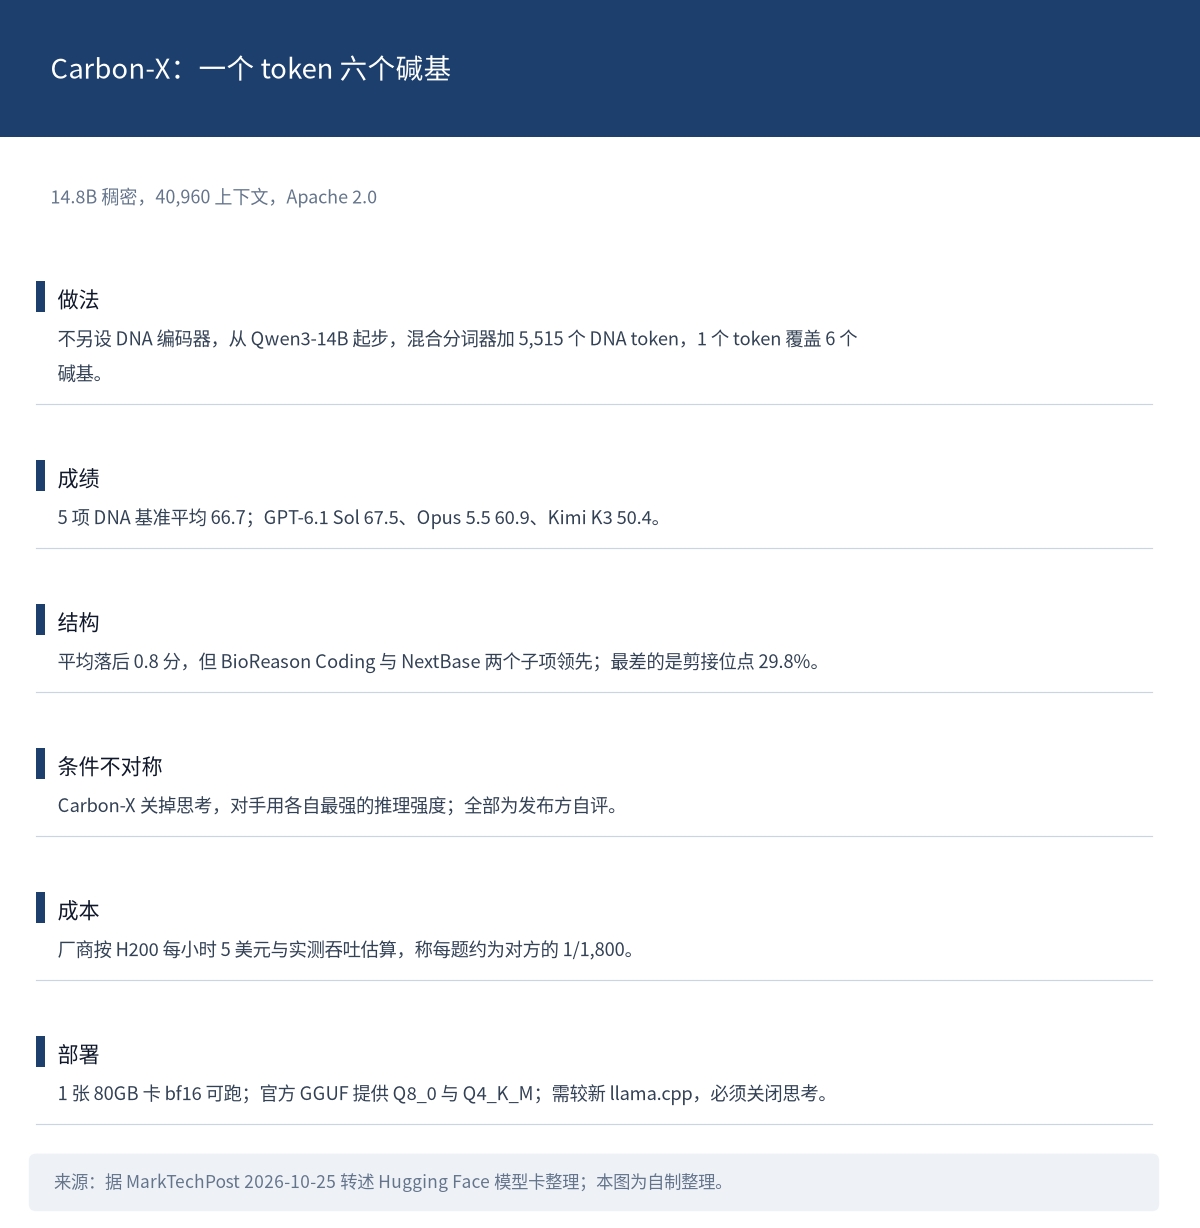
图 6:Carbon-X 的成绩结构与评测条件。来源:据 MarkTechPost 2026-10-25 转述 Hugging Face 模型卡整理;本图为自制整理。
一句话看懂:一个 token 换六个碱基,换来的是成本和上下文,代价是平均分仍差一点。
r/opensource:把「是不是 AI 做的」当成准入条件
Reddit 的 r/opensource 发布了新的提交规则,禁止「使用 AI、由 AI 制作、或面向 AI」的项目,理由是 AI 与该社区不合。新规引发大量不满,并催生了竞品子版 r/trueopensource。
但并不只是一票否决。版主 Wolvereness 表示存在选择性执行空间,举例说偶然用到 AI 无障碍功能的软件可以放行——规则的精神更接近「别把 AI 当卖点」。
这条的价值在于它和开源定义的关系。OSI 那套传统定义看许可证、不看生产方式,而这个社区在用「是不是 AI 做的」划边界。
和 10 月 25 日那条宾州广告法可以并读:一个管披露,一个管准入,都是社区或监管在用规则给 AI 内容定位。
这条目前只到摘要层面:新规原文、生效日期与删帖数量,报道未给出。
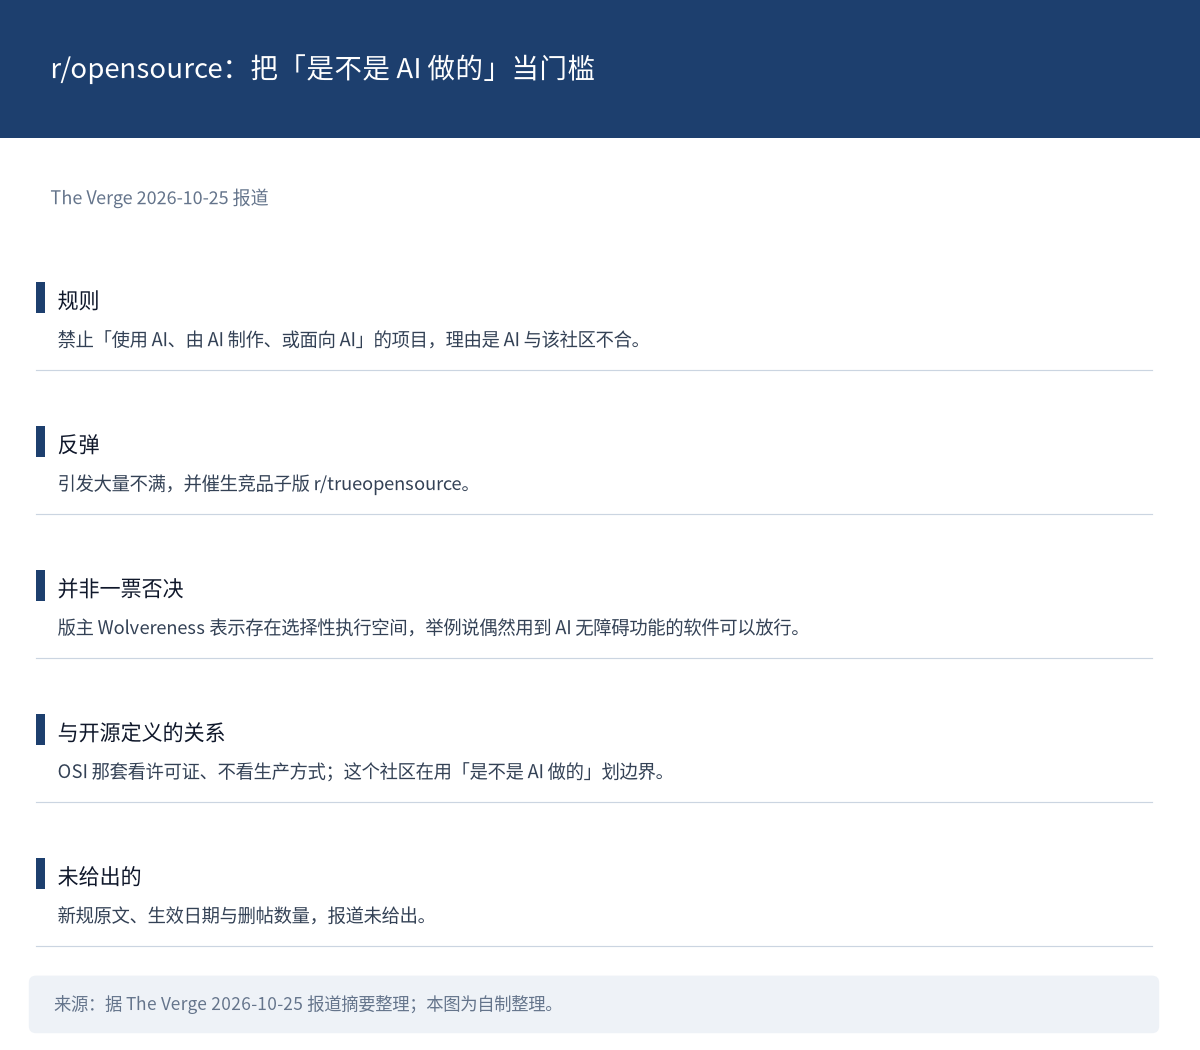
图 7:两种划边界的做法。来源:据 The Verge 2026-10-25 报道摘要整理;本图为自制整理。
一句话看懂:禁的不是 AI 技术,是「拿 AI 当卖点」的项目。
 快讯速览
- 德州大学 Jev-Mem 把记忆构建里的「链接、停止搜索」这类小决策交给快速打分模型批量出概率,记忆构建 158 秒对最快基线 1,044 秒,LoCoMo 回答得分 0.777。来源:Rohan Paul 转述(10-25 22:27)
- 南北阁发布 Nanbeige4.3-33B,称在多数基准上领先、智能体编程与协作任务表现强,并有 3B 版本计划;「领先」是发布方口径,无第三方评测。来源:Testing Catalog(10-26 01:06)
- KRAFTON 预览 Raon-1 mini,30B 总参/4B 激活、MoE 加线性注意力,Apache 2.0 开源并限时免费 API,聚焦韩语兼顾英语。来源:IT之家(10-25 21:27)
- Musk 称 Grok Bot 现在能替用户致电个人或商家、代为提出请求并记录内容发摘要;引用帖提到的实时转录与支付账户连接来自非官方文档。来源:Elon Musk(10-25 22:35)
- Claude 桌面应用换了新界面与侧边栏,由 Claude 帮助设计,从草图到上线不到 3 周;部分用户认为信息密度偏低、项目面板可读性受影响。来源:IT之家(10-25 22:33)
- Google AI Studio 将推托管智能体,用户可在「智能体中心」检查与管理自主智能体的工具、环境与触发器;属未发布功能的线索而非官方公告。来源:Testing Catalog(10-25 21:32)
- Muse 从 10 月 25 日起灰度上线实时语音通话,支持与 Muse 智能体实时语音对话。来源:Testing Catalog(10-26 00:10)
- TechCrunch 盘点 AI 可穿戴价格:Bee 吊坠 49.99 美元、Friend 129 美元、Limitless 99 美元、Omi 89 美元,Meta 的 Muse Charm 尚未发货。来源:TechCrunch(10-25 22:10)
- Musk 预判「我们会看到大量算力搁浅在没建完的数据中心里」,属判断而非事实。来源:Rohan Paul 转述(10-25 23:06)
- Perplexity 为自家浏览器游戏 SF 2049 加上多人模式。来源:Aravind Srinivas(10-25 23:02)
- 卡兹克用 Claude Opus 5.5 做了一个 Agent 流水线可视化小镇,5 天把自动化任务整合成微缩景观式界面,开发消耗约 30% 周额度;额度消耗是作者自述。来源:卡兹克(10-25 21:07)
- Dex Horthy 的经验:同一会话串 5 个 Skill 可以接受,200 个就该换架构,流程步骤宜拆、纯信息可合。来源:Dex Horthy(10-26 01:27)
- Dex Horthy 另给了一个做法:让模型自己写一份详细技能再删掉——读一遍如果正确,说明这些知识已经在权重里。来源:Dex Horthy(10-26 01:40)
- Mollick 称用 Opus 5.5 重做自己的书站,初版需要大量工作才有辨识度,现在 Opus 基本独自完成。来源:Ethan Mollick(10-26 01:10)
- Recode China AI 周报复述 Kimi K3.1 Pro:100 万上下文、Highspeed 快 2 到 3 倍、权重 11 月 4 日前开放,属综述而非新增事实。来源:Recode China AI(10-25 22:46)
- EleutherAI 的新论文显示,教师的「动物偏好」能通过蒸馏传给学生,且不要求共享初始化、数据顺序、语料、规模或架构;「动物偏好」是实验设置里的示例。来源:EleutherAI 博客(10-25 00:00)
- 字节 Seed 的 Recycler 把上一个 token 的顶层隐藏状态经轻适配器送入下一步,覆盖预训练到 RL 全流程,称后期引入仍可超过参数量多 2 到 3 倍的模型;这是作者自评。来源:AIHOT 条目(10-25 00:00)
- LangChain 拆解公司级 harness 的五个组件:驻留用户工作场景、区分 on-behalf-of 与固定凭证、两级记忆、沙箱执行、大量 ambient 触发,属厂商工程经验而非测评。来源:LangChain 博客(10-25 07:49)
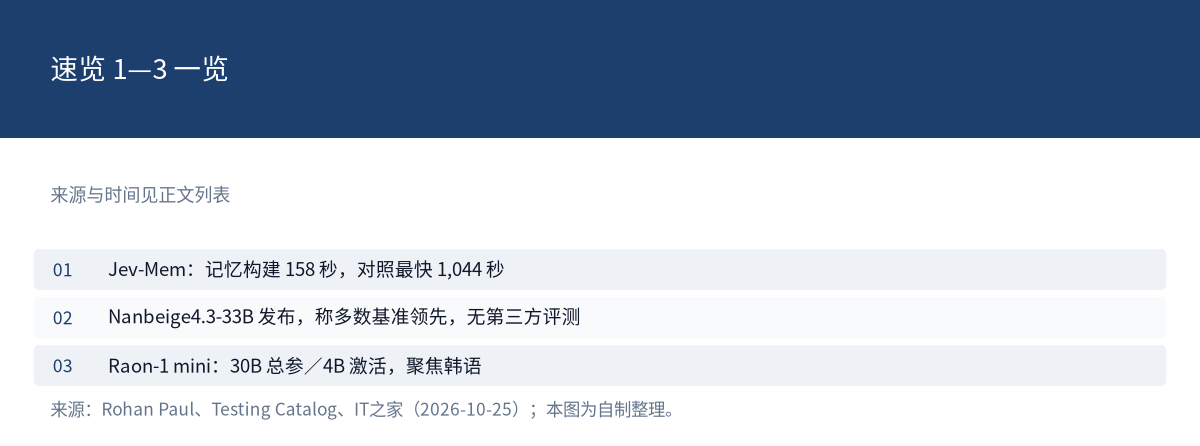
图 8:速览 1—3 一览。来源:各条来源见上方列表;本图为自制整理。
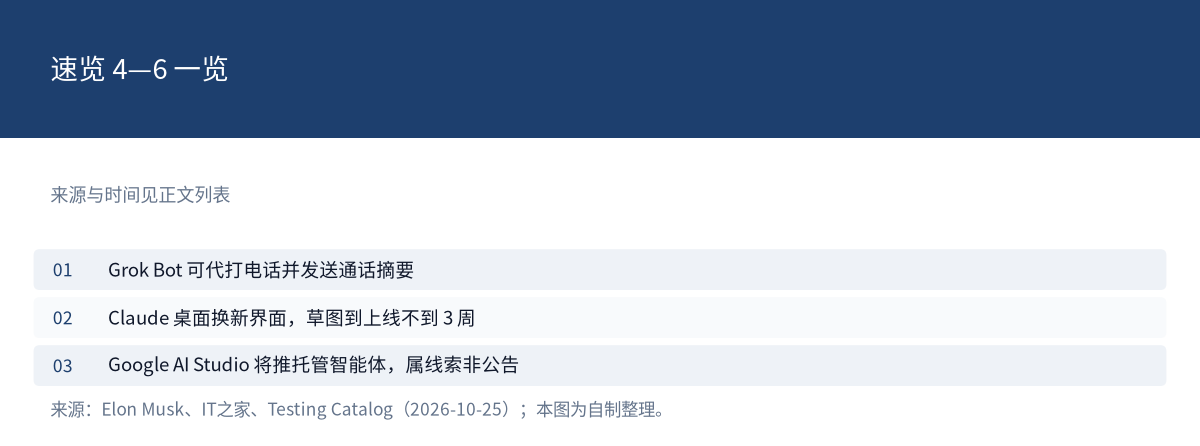
图 9:速览 4—6 一览。来源:各条来源见上方列表;本图为自制整理。
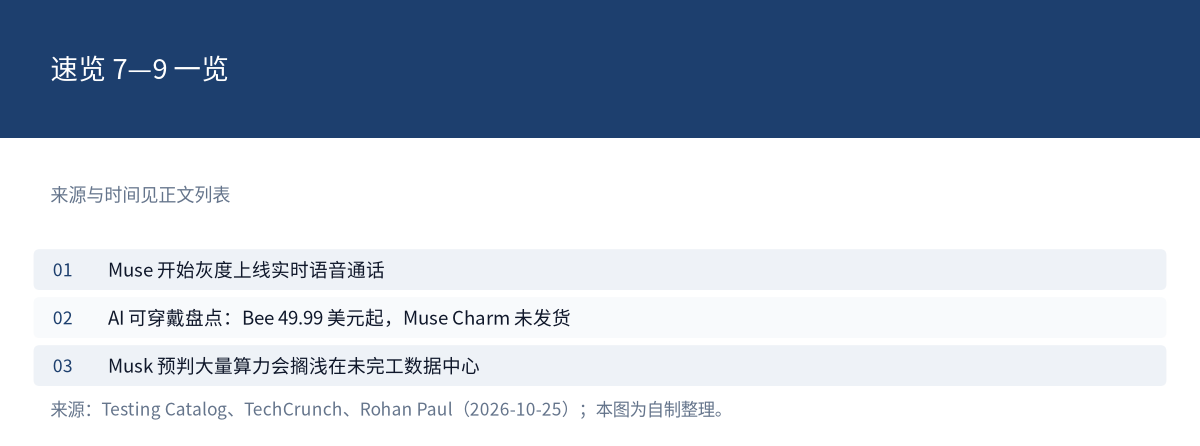
图 10:速览 7—9 一览。来源:各条来源见上方列表;本图为自制整理。
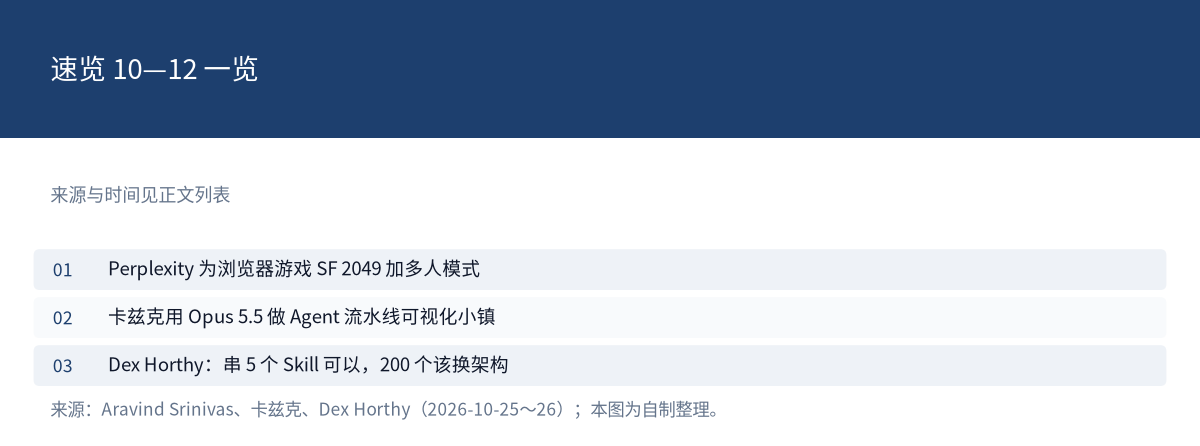
图 11:速览 10—12 一览。来源:各条来源见上方列表;本图为自制整理。
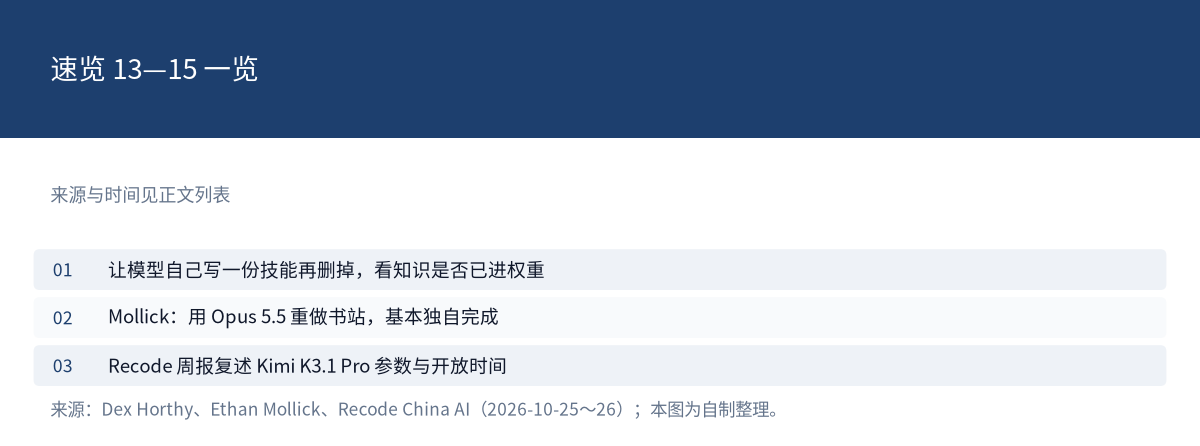
图 12:速览 13—15 一览。来源:各条来源见上方列表;本图为自制整理。
图 13:速览 16—18 一览。来源:各条来源见上方列表;本图为自制整理。
 积木观察
今天三条最有分量的材料,都在说「AI 的产出要拿去被检验」。扫描器的报告被渗透测试员抽检、被 curl 用来发版;Carbon-X 的平均分被摆在三个前沿模型旁边,还得说明自己关着思考;TokenGate 的 11.3 倍被标注成单卡单批量的最佳单项。反过来,三星堆那部电影拿证上映了,票房 116 万——流程跑通和价值兑现之间还隔着一段。
给读者的一条建议:以后看到「AI 提升了 X 倍」或「AI 没带来回报」,先问三件事——对照是谁、口径怎么切、条件对不对等。S&P 493 和 Carbon-X 的评测不对称,都是这三个问题里的同一个。
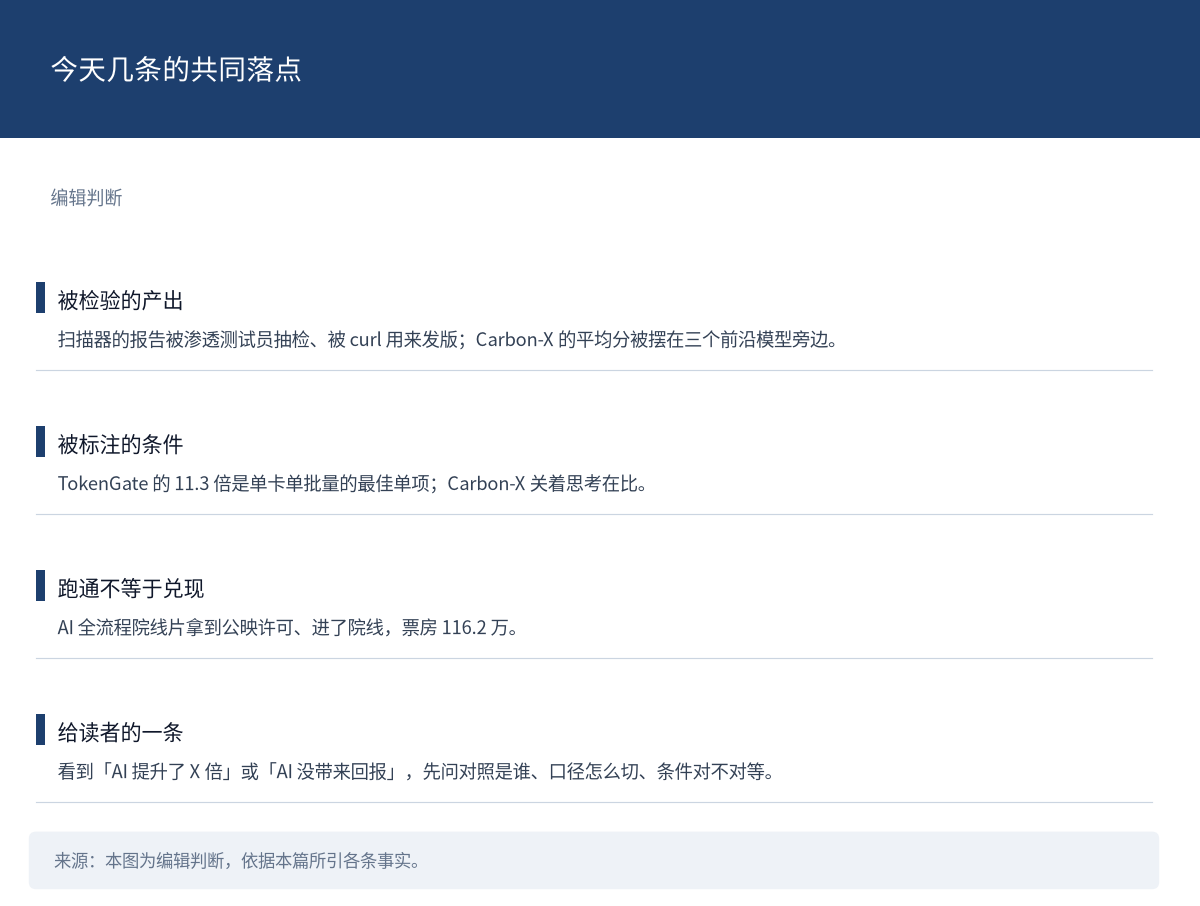
图 14:今天几条的共同落点。来源:本图为编辑判断,自制整理。
结尾互动
如果让你给一个开源项目提漏洞报告,你更希望它「少而准」,还是「多而全、自己筛」?