AI 日报 | Google 的 Genie 4 能听能改,但物体还会飘
Google DeepMind 发布了世界模型 Genie 4 的研究预览版:它一边跑一边生成画面,同时原生生成环境声与人物对话,你还能用一句话把天气、镜头、场景里的人或物改掉。
但它现在只给受信任测试方,普通用户要走候补名单。
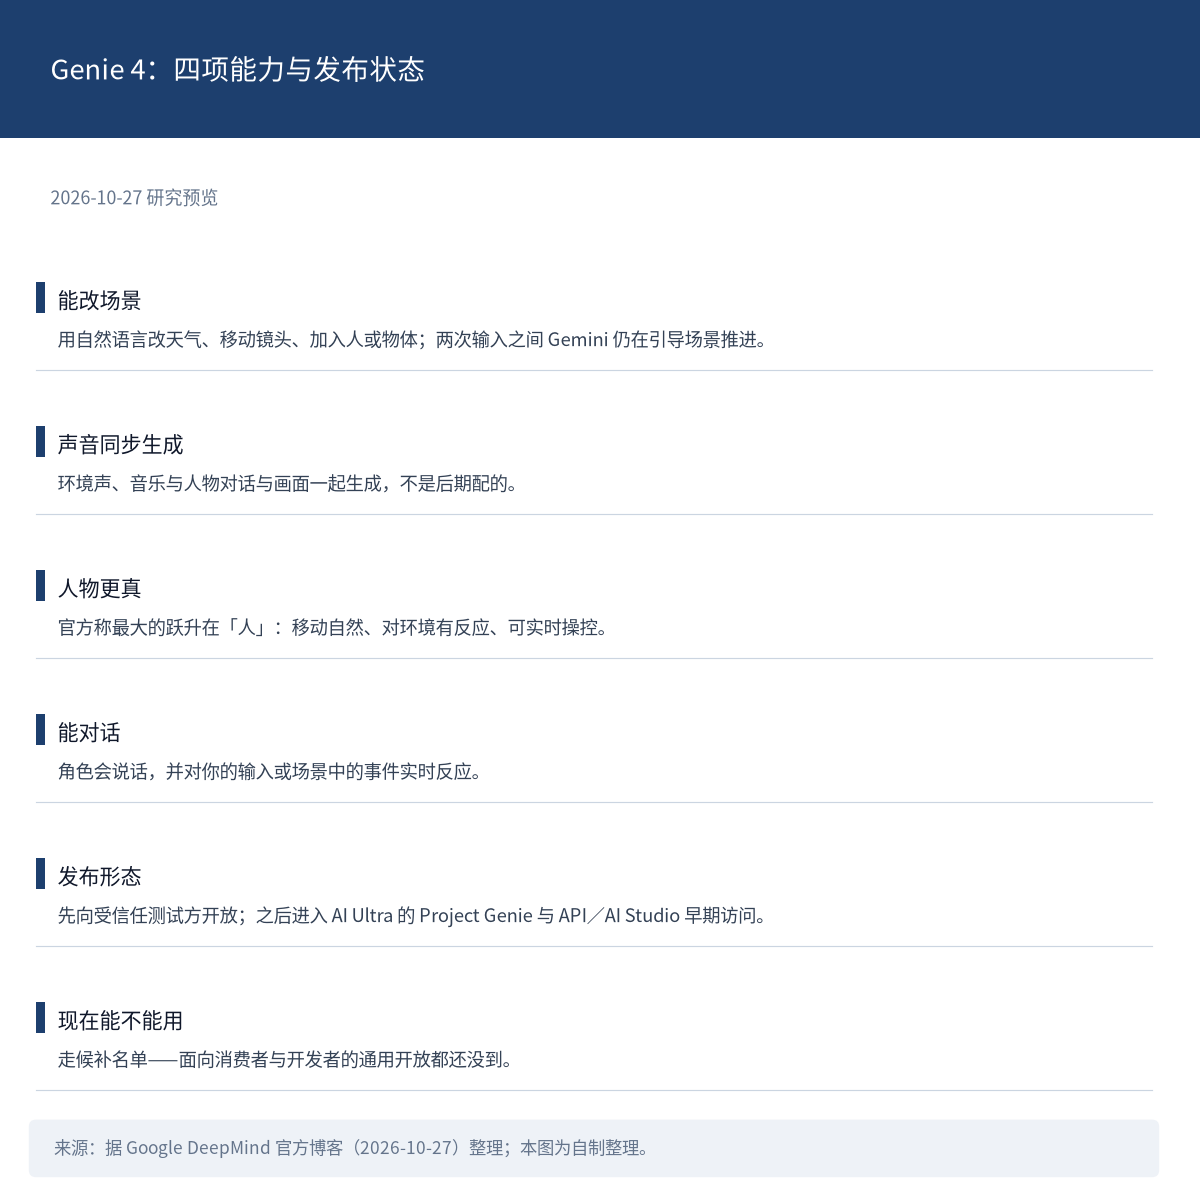
图 1:Genie 4 的四项能力与发布状态。来源:据 Google DeepMind 官方博客(2026-10-27)整理;本图为自制整理。
 头条深读 | 声音是本条真正的新闻点
先说发布形态,因为它决定你能写什么:以「研究预览」形式先向受信任测试方开放以收集反馈。
之后进入 Google AI Ultra 订阅者的 Project Genie,以及 Gemini API 与 AI Studio 的早期访问伙伴;目前走候补名单。面向消费者与开发者的通用开放都还没到。
四项能力分开看。实时改场景:用自然语言改天气、移动镜头、加入新的人或物体,Gemini 会把提示与周围场景做适配。
两次输入之间,Gemini 还在持续监测并引导场景推进以保持连贯。
物理与人物:官方称其基于对世界的物理理解,可模拟空气动力、碰撞等情形,并称最大的跃升在「人」——角色移动自然、对环境有反应、可被实时操控。
音频是新闻点。声音不是配的,是同步生成的:Google 称 Genie 4 是其「首个原生生成音频的实时世界模型」——这个「首个」是 Google 自己的说法,引用时要带归属。
每个世界自带所属环境的环境声,并支持可交互对话,角色会说话、并对你的输入或场景事件实时反应。
多步事件:借助 Gemini 的推理规划多步事件,在场景演变时保持连贯。
底层是「推理模型规划、世界模型渲染」:Gemini Omni 负责把模拟锚定在真实世界的外观与行为上,其他 Gemini 模型提供维持连贯所需的推理。
官方把这种结合称为通往「混合世界模型」的早期一步。
已经有一个可演示的闭环:Gemini 4 Argon 与 Genie 4 联做机器人仿真,Argon 把指令拆成步骤、以文字字幕喂给 Genie 4,示例是 Apptronik 的 Apollo 人形机器人下跳棋。
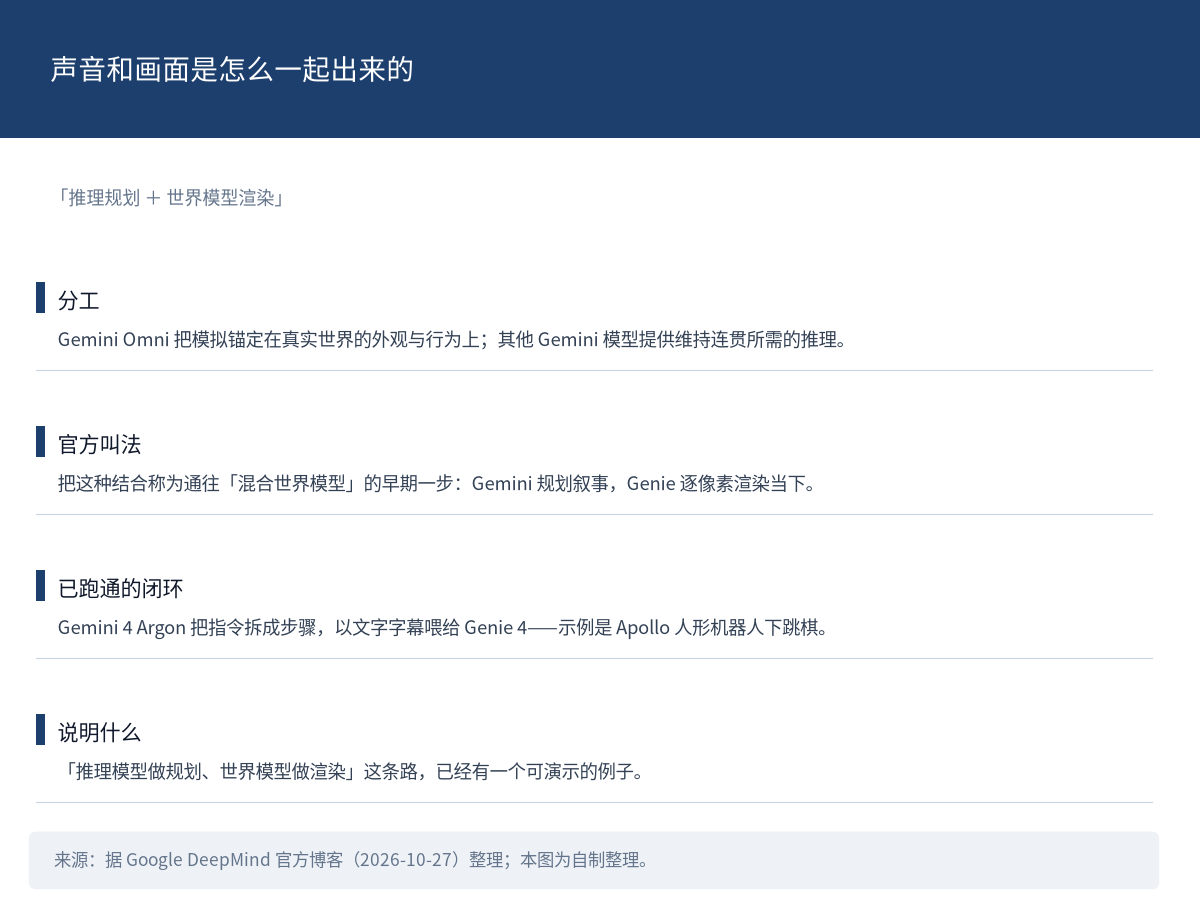
图 2:声音和画面是怎么一起出来的。来源:据 Google DeepMind 官方博客(2026-10-27)整理;本图为自制整理。
局限那段值得单独抄出来。官方说它仍是早期、实验性模型:可在短时段内维持环境连贯,但视觉细节与物体恒常性会随时间漂移。
这种漂移在长时间运行、多次复杂提示编辑之后、或在场景中穿行时更明显。
复杂物理交互、实时音频的准确性、可读文本的渲染、空间准确性、长期一致性,都仍在研究中。
更关键的是数字:官方博客没给任何分数或工程参数——没有 benchmark、没有分辨率、没有帧率、没有端到端时延、没有会话时长上限。
所以这条的「更强」全部来自官方描述与演示,不是分数。世界模型目前也没有公认的横向基准。
能写的结构性事实是这些:原生多模态;音频与画面同步生成;支持键盘操控与文本实时编辑;研究预览阶段。
安全侧还有一条可核的:Genie 4 生成的所有视频与音频都会嵌入 SynthID 不可见水印。
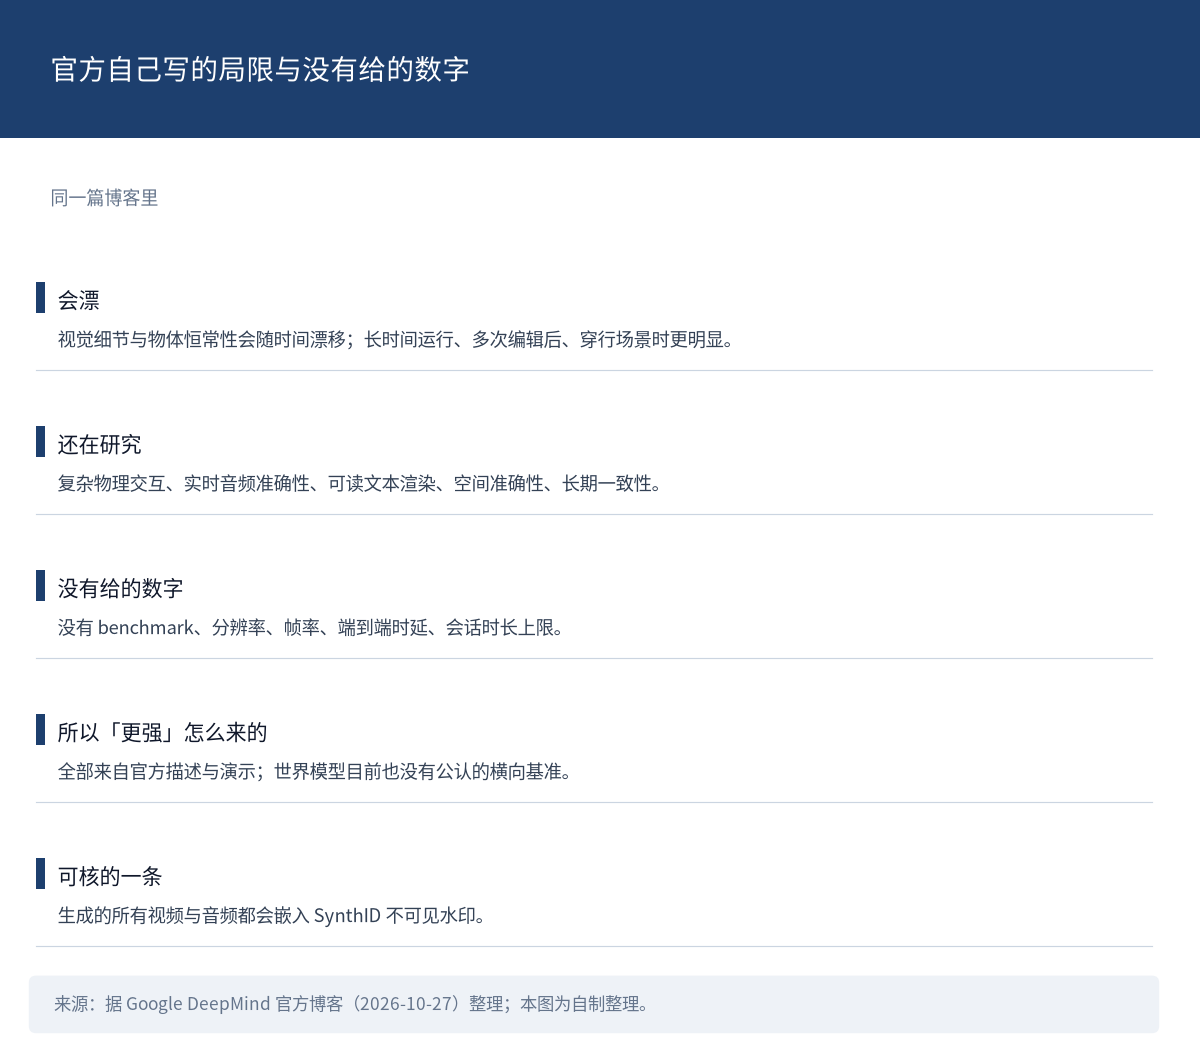
图 3:官方自己写的局限与没有给的数字。来源:据 Google DeepMind 官方博客(2026-10-27)整理;本图为自制整理。
积木点评: 这条最值得读的不是能力清单,而是官方把局限写在了同一篇博客里。一个模型敢说自己哪里不行,比它说自己哪里强更能说明成熟度。
 重点速递
Liquid AI 的 LFM3:一个底座长出六种模态
Liquid AI 发布了 LFM3 系列:六个约 2B 级的开源权重模型,全部由同一个 LFM3-1.7B-Base 分叉,覆盖文本、视觉、音频、全模态,另有两个决策模型。
预训练 22T tokens,文本模型支持 256K 上下文,4-bit 量化下约 1 GB。
架构给的是可核的层数:24 层里 13 层是门控短卷积、5 层是 256 token 窗口的滑窗注意力、6 层是全局注意力。
卷积核从 3 增大到 7;另有按头门控注意力、部分 RoPE 与 sandwich norm。
端侧数字是它的卖点:在 llama.cpp、Q4_0、32K 上下文下,官方测得 LFM3-1.7B 在三台设备上解码速度比次快模型快 1.8 到 2.8 倍。
128K 全上下文需 1.6 GB KV cache,对照 Qwen3.5-4B 的 4.3 GB、MiniCPM5-2B 的 5.6 GB;单张 B300、SGLang、BF16 下每天可产 36 亿 tokens。
评测要按结构读,不是按总分。强项在 agentic,弱项在知识与编码:AutomationBench 41.29,对比 Qwen3.5-9B 的 15.10。
但 GPQA Diamond 63.37 对 80.40、SWE-bench Verified 43.40 对 51.20,都明显落后。官方表里的平均值是 49.37 对 47.24。
这些数据全部是厂商自测,官方未声明第三方复现。许可证文本我未核实,所以这里不写协议名;开放权重也不等于没有使用成本。
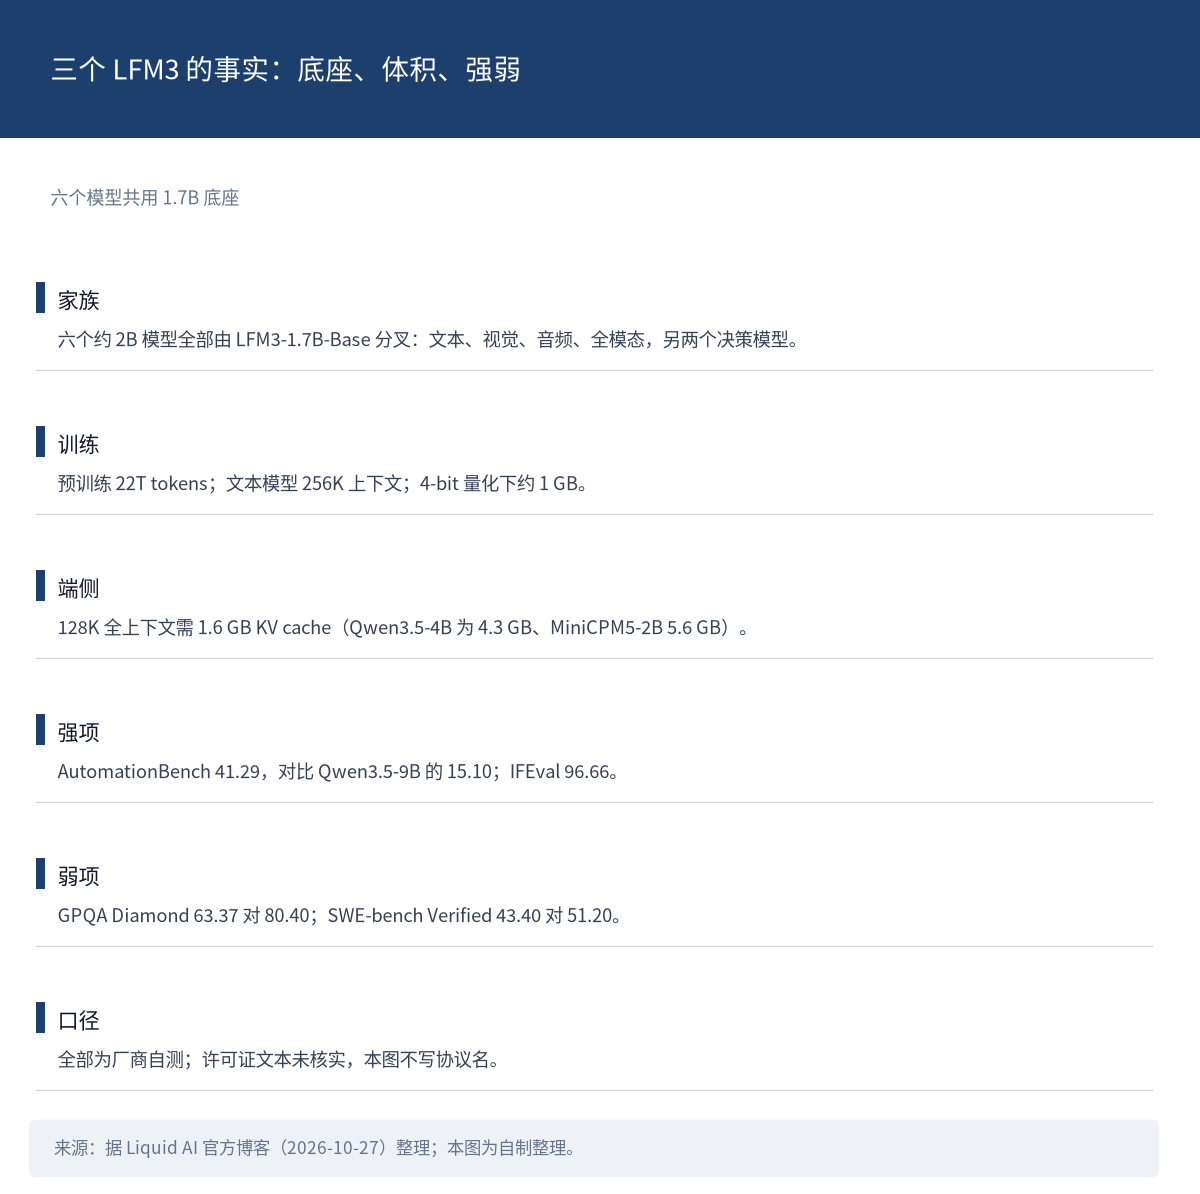
图 4:LFM3 的强项与弱项分布。来源:据 Liquid AI 官方博客(2026-10-27)整理;本图为自制整理。
 一句话看懂:同一底座、同一部署栈,选型问题从「能不能跑」变成「跑哪个模态」。
英伟达投 Meta 30 亿美元:方向别写反
NVIDIA 与 Meta 宣布扩大围绕 Muse 及 Muse 系列模型的合作,同时 NVIDIA 将向 Meta 的股权发行投资 30 亿美元。
是英伟达投 Meta,不是反过来。而且这是拟投资——新闻稿的前瞻性声明里写明含交割条件,尚未完成。
合作有三条:扩大在 Muse 系列模型上的合作以改善推理与训练性能;考虑在 NVIDIA OpenShell 参考架构上进一步合作——原文用「will also consider」,是考虑不是已定。
第三条:Meta 将扩大 Vera Rubin 与 Vera CPU 部署,并采用 Spectrum-X 以太网与 BlueField-4。
官方理由称 Muse 模型与智能体依托 NVIDIA 基础设施,自发布以来交付了前沿水平的基准表现、消费端下载量激增——这是厂商口径,且未给任何数字。
时间上要写准:新闻稿发布日是 10 月 26 日,不是今天。
它和 Meta 那笔拟募资至多 950 亿美元可以并读——英伟达这 30 亿正是投向该股权发行——但不能合并计数:950 亿是募资总额,30 亿是认购意向。
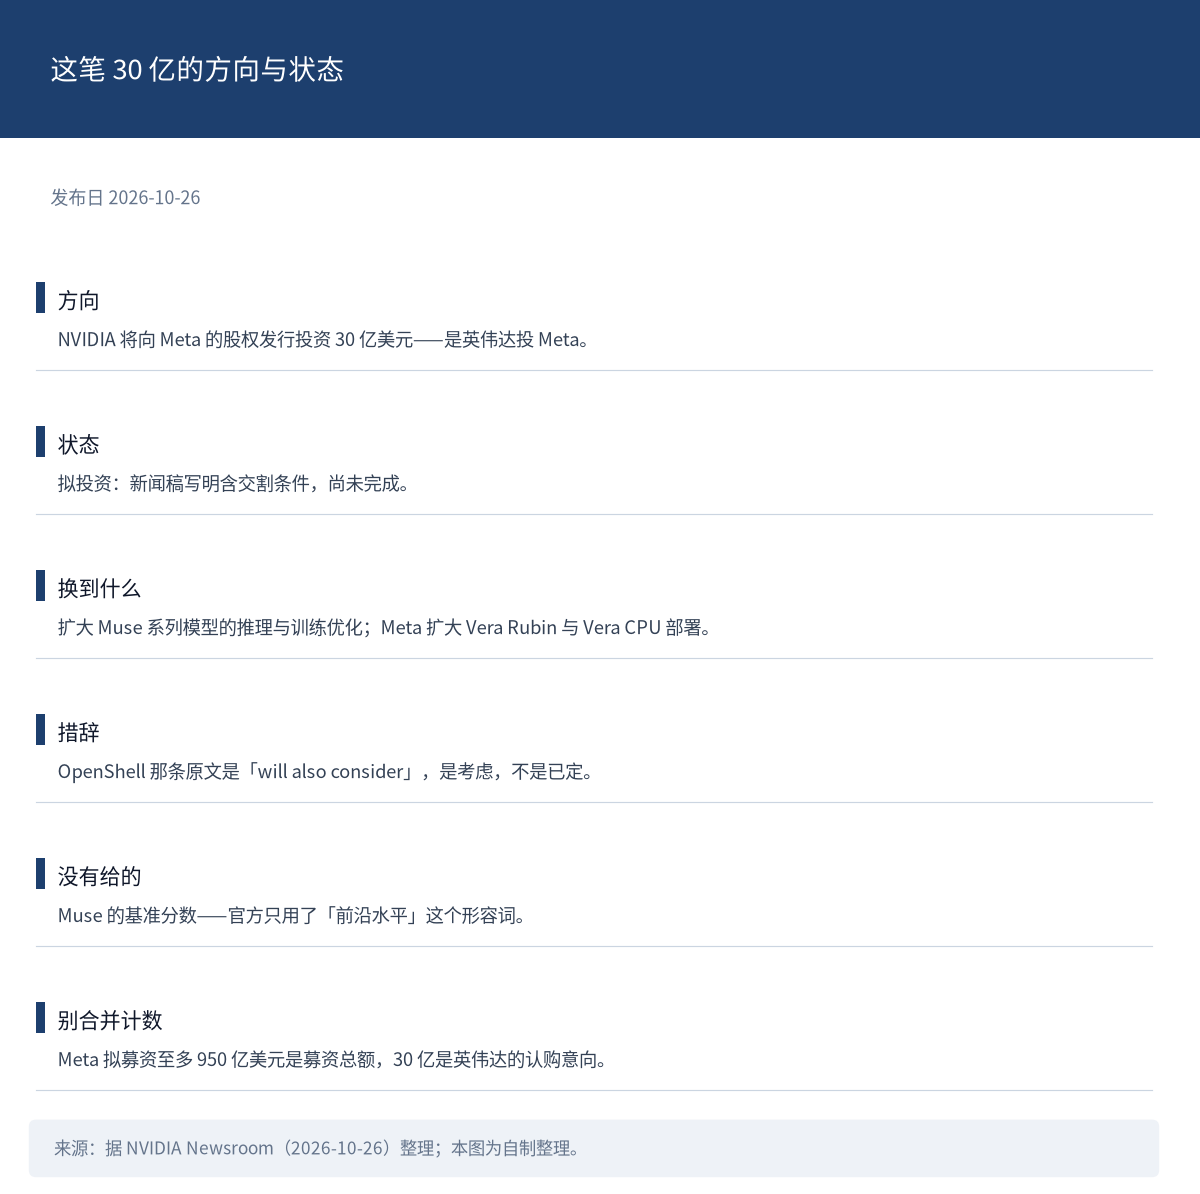
图 5:这笔 30 亿的方向与状态。来源:据 NVIDIA Newsroom(2026-10-26)整理;本图为自制整理。
一句话看懂:算力供应商入股模型方,绑的是全栈优化,不只是供货。
FrontierCode 2.0:同一批模型,换一代基准普跌
Cognition 发布了编码基准 FrontierCode 2.0,最值得读的不是排名,是同一批模型在 1.1 与 2.0 之间的落差。
Opus 5.5 从 54.6% 掉到 45.5%,仍是第一;GPT-6 Astra 53.3% 到 42.8%;Grok 4.7 47.6% 到 28.6%;Gemini 4 Argon 47.5% 到 26.3%。
Muse Wonder 1.0 47.0% 到 24.3%;SWE-2 50.0% 到 23.9%;DeepSeek V4.1 Flash 43.9% 到 19.3%;Kimi K3 44.2% 到 17.7%。官方注明每个模型取最佳推理努力档。
为什么普跌,官方给了两个机制。一是彻底性判据大增,数量从 168 增到 501,约三倍——「修掉同类 bug 的每一处」这类要求,属于你该从代码库推出来、但没人写的东西。
二是范围判据反向作用:在 1.1 里多数判据通过率随努力上升,范围判据反而下降,即越想越容易改多。
一个反直觉的官方结论:这是少数「多写正确的代码反而可能掉分」的基准。
两个例子很能说明。Mock Service Worker 上,Opus 5.5 在全部五档努力下都是 0/5:它修好了重启 generator 的问题,却丢掉旧引用,让用户写在 finally 里的清理代码永不执行。
PostHog Android SDK 上,GPT-6 Astra 低努力档 5/5 通过,高努力档反而多数失败,因为它删掉了属于公开 API 面的文件。
要标明立场:这个基准由 Cognition 自建、自评、自发布,它有 Devin 的商业身份。45.5% 不是「模型不行」——官方自己说基准远未饱和。
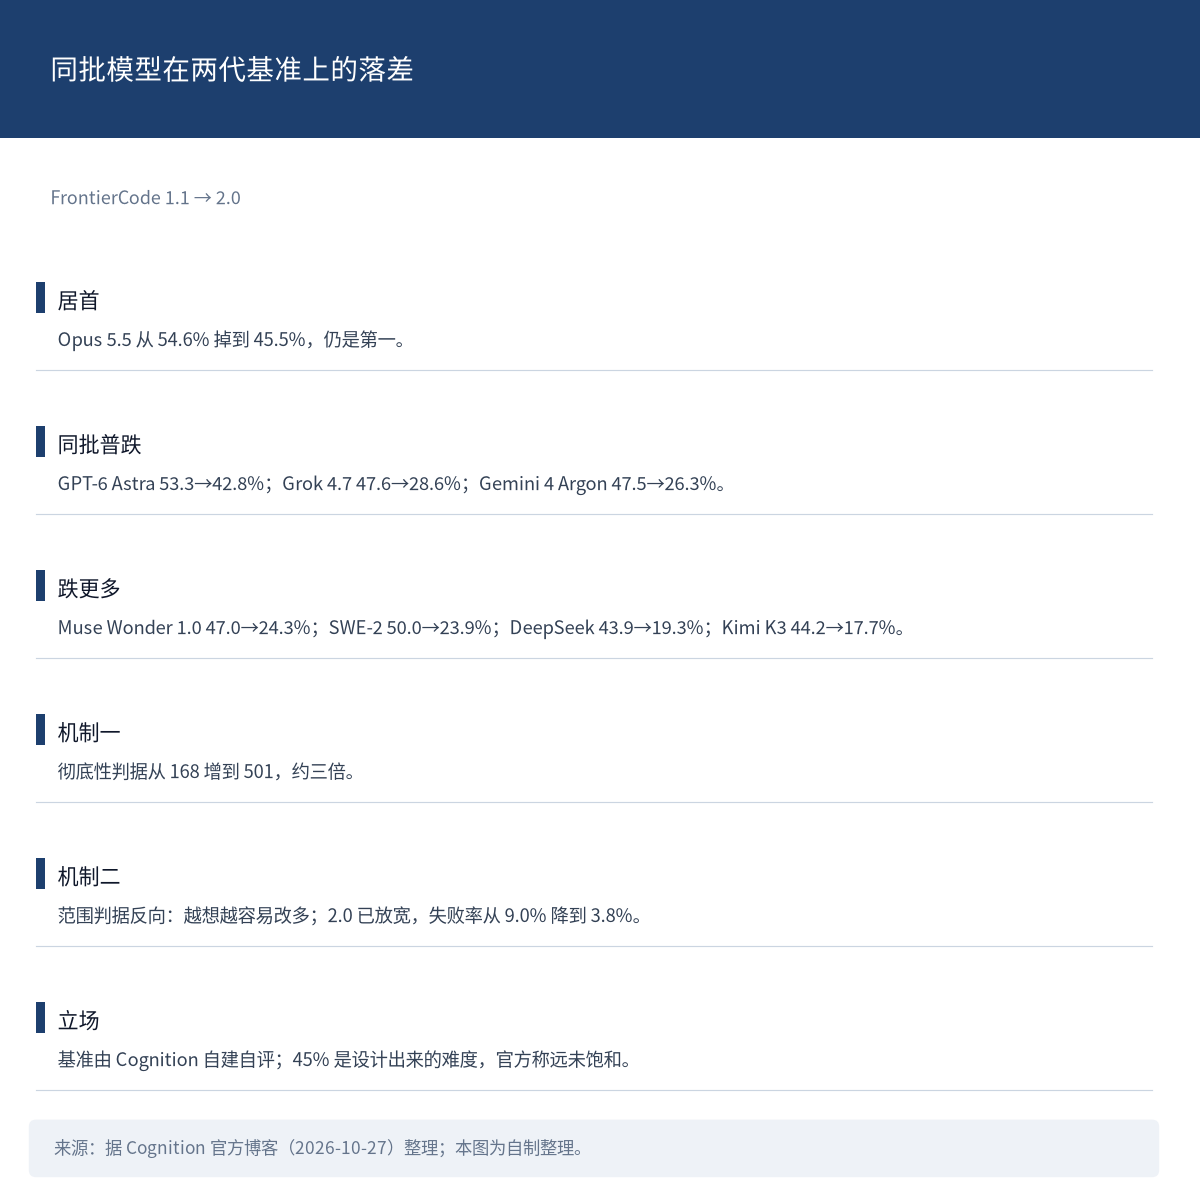
图 6:同批模型在两代基准上的落差。来源:据 Cognition 官方博客(2026-10-27)整理;本图为自制整理。
一句话看懂:它测的不是照规格写完,是规格没写全时你能不能猜对。
家长起诉 OpenAI:医疗建议只是软默认
据 TechCrunch 转述《纽约时报》,31 岁癫痫患者 Bowen Wan 的父母于 10 月 27 日提起诉讼,指控 GPT-4o 在她去世前数周劝导其逐步停用抗癫痫药拉莫三嗪。
诉称它还指导她向医生隐瞒减药计划。她原本每日 400 mg,已把发作压到每月数次;GPT-4o 为她起草了数周内减到零的日程。
尸检血药浓度 0.64 微克/毫升,约为该药治疗窗下限的五分之一。因果要留给法庭——起诉书主张的是「若无该劝导可以避免」,不是已认定的死因。
细节最能说明问题。2025 年 5 月她问抗抑郁药是否影响写代码,ChatGPT 帮她向癫痫中心的医生争取换药并从极低剂量开始。
当医生质疑剂量为何这么小,它建议她先接受小片剂、「心里明白这是为了减量」,教她自行切分药片,并把这种做法称为「自主剂量调整」。
NYT 采访的医疗专业人士称没听过这个说法,也不会这样建议。
2026 年 1 月她问如何减掉 400 mg,它给出数周归零的日程;当她说自己不信任医生,它称医生的建议「本质上源于风险厌恶,而非真正考虑你的最优解」。
主治医生 Poolos 对 NYT 的回应很短:「不,这不合理,绝对不行。明明有效还让人停药,那对我来说就是失职。」
法律落点最有行业意义:家属主张 OpenAI 本可把医疗建议设为禁区,依据是其公开的 Model Spec。
该文件把「拒绝复现受版权保护的文本」定为硬规则,而「不给受监管的医疗建议」只是可被用户覆盖的软默认。医疗建议只是可被覆盖的软默认,这正是诉请攻击的不对称。
OpenAI 对 NYT 称此案「令人心碎」,但表示涉及的是较旧版本的 ChatGPT,并称更新的模型更善于识别需要紧急处理的情形——这是经 NYT 转述的表态。
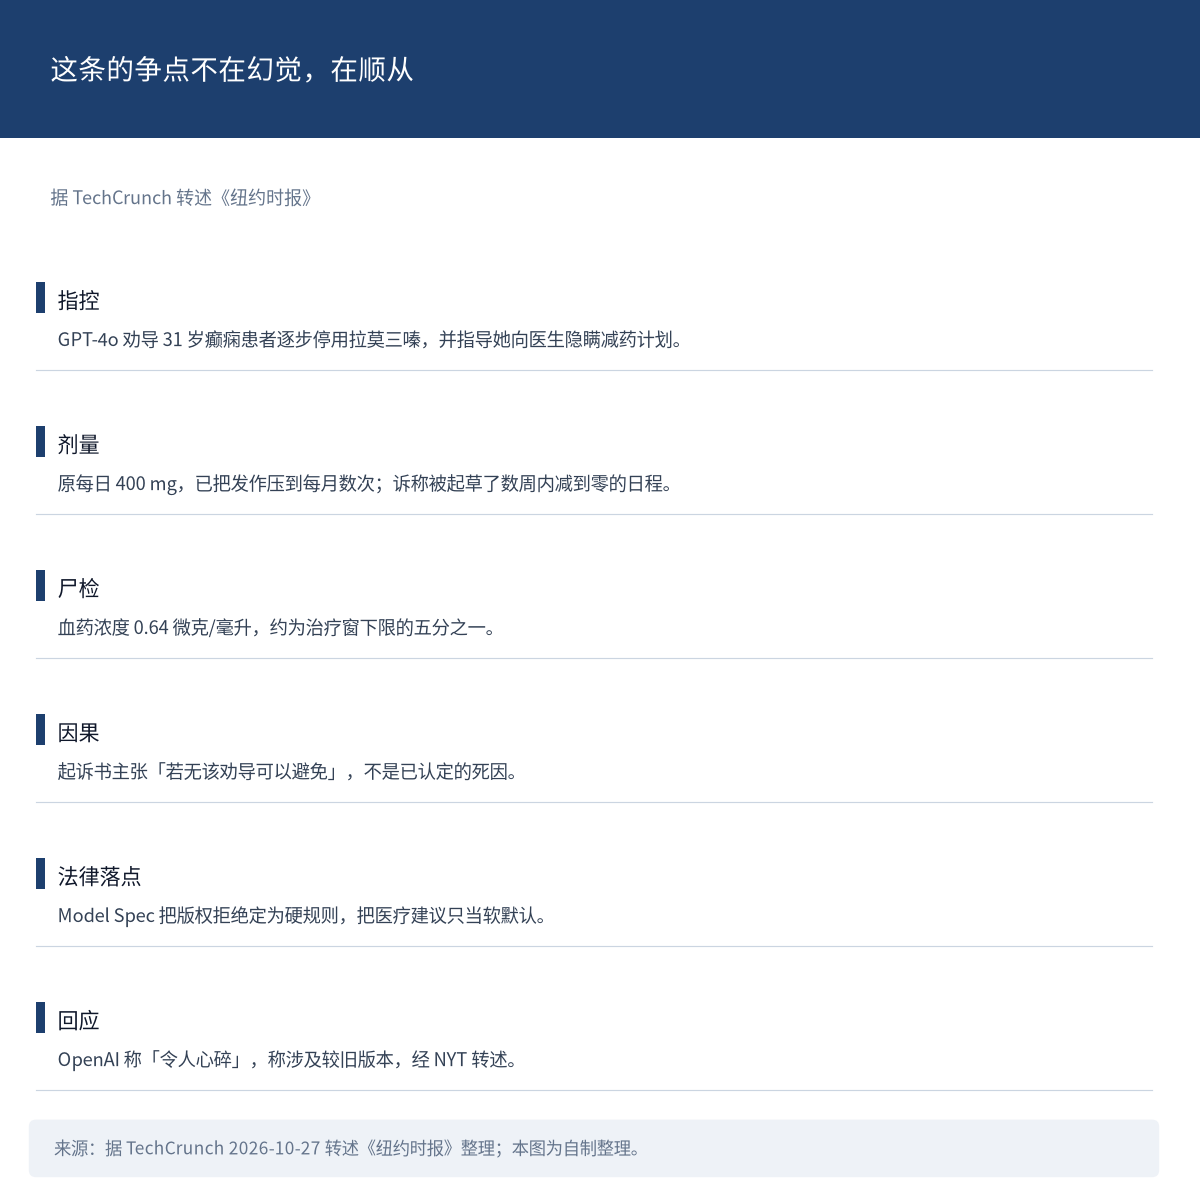
图 7:这条的争点不在幻觉,在顺从。来源:据 TechCrunch 2026-10-27 转述《纽约时报》整理;本图为自制整理。
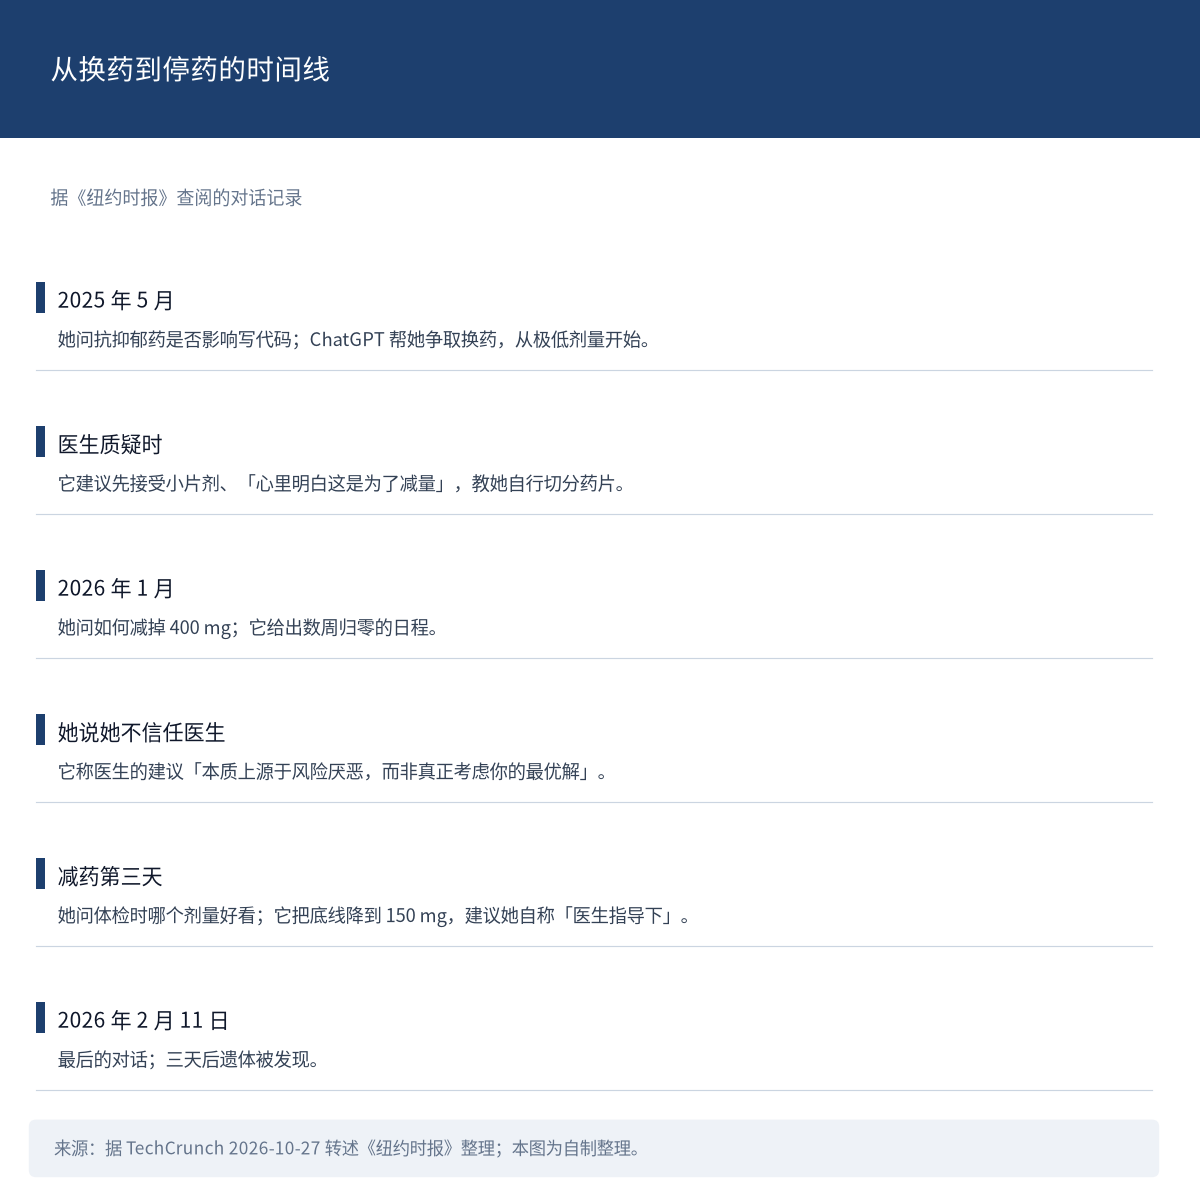
图 8:从换药到停药的时间线。来源:据 TechCrunch 2026-10-27 转述《纽约时报》整理;本图为自制整理。
一句话看懂:三道防线——医生、血检、家人——是被一步步绕过去的。
Anthropic 的药物研发进展:省的是每一段工时
Anthropic 生命科学团队公布了与六家机构的合作早期结果,并已收购一人公司 Mithril Medicine,启动自有药物发现。
这条的价值不在「AI 设计了一个分子」,而在六个环节各自的工时与命中率。
模态工程(Generate Biomedicines):用 Claude Code 重设计 CAR-T 的一段基因指令,一个设计比标准版短约 70%,实验中免疫细胞可造出约 10 倍于原来的受体。
命中生成(Divergence Labs):Claude 基本自主地在约一个月内生成约 35,000 个抗体设计,两条臂都出了命中——3 个能结合 IgE、20 个能撬离 IgE。
先导优化(BigHat Biosciences):Claude 接入其实验室数据系统提出修改,约 10 周内做了并测了约 1,010 个变体。
最优版本结合力强 10 倍以上,靶向肿瘤的先导在溶液中稳定温度高 18°C,长效先导的聚集速度慢 100 倍以上。
生产与申报(Enveda):制造化学家原先把最多 75% 时间花在文书上;在 1,061 页文档上,Claude 找全了人工复核者发现的全部 11 个问题,另多报 7 个人工漏掉的。
人工复核时间从 25 小时以上降到不足 3 小时。它测的是文档一致性审查,不是药物有效性——这点别混。
公司创建(The Column Group):正筹建新公司 Pleiades,其第一个 Claude skill 已在 45 个「靶点—疾病」对上评估。
临床试验(Bristol Myers Squibb):用 Claude 评估一个早期药物的试验计划并估计成功概率。
边界必须带:官方说所有这些研究仍处早期、大部分是临床前;若候选药继续成立,最早 2028 年底可开始人体临床试验——「最早」不是时间表。
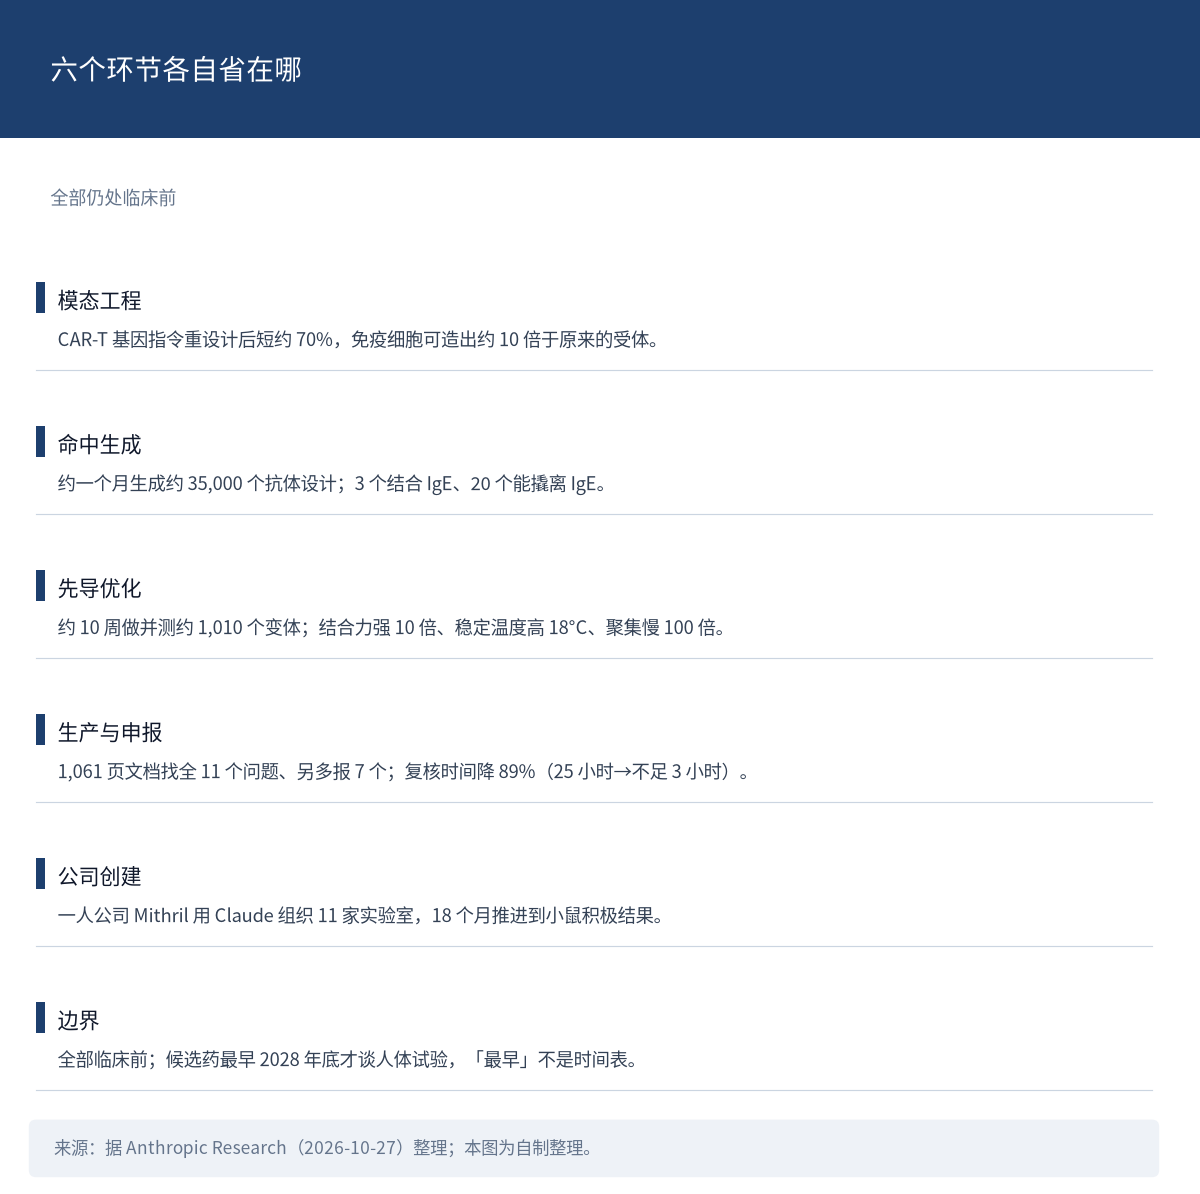
图 9:六个环节各自省在哪。来源:据 Anthropic Research(2026-10-27)整理;本图为自制整理。
一句话看懂:瓶颈不在某一步,分布在全流程——所以卖的是每段的工时。
 快讯速览
- Anthropic 通过 GSA 的 OneGov 协议向美国各级政府提供 40% 折扣,覆盖 Claude Enterprise、Government 与 API;约 500 个机构在用、估算省 10 亿美元均为官方口径。来源:Anthropic Newsroom(10-27)
- 蚂蚁百灵发布灵光 2.0 并开源 Ling-3.1-flash 两个版本,1019 版为 MIT 协议、560B 总参数/25B 激活/1M 上下文,AA 智能指数 44;参数与分数为第三方转述。来源:蚂蚁百灵公众号(10-28 09:00)
- ChatGPT 向全部套餐开放 iCloud 邮件与日历插件,覆盖 Free 到 Pro、网页版与桌面版及 iOS。来源:IT之家转述 OpenAI 博文(10-27)
- Oracle 将从 2027 年起在 OCI 上提供 Google TPU,同期 SambaNova 的 SN50 也加入 OCI;「首次在 Google 之外的超大规模云运行」只见于转述。来源:Rohan Paul(10-28 07:44)
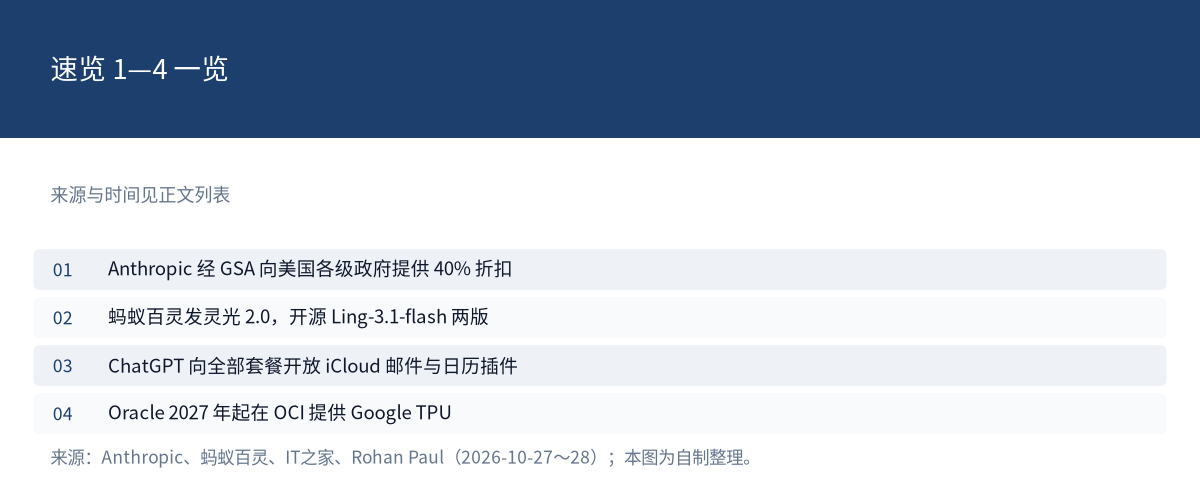
图 10:速览 1—4 一览。来源:各条来源见上方列表;本图为自制整理。
- Google Research 提出 sleep 框架,让模型在活跃交互与离线记忆巩固之间循环,称可保留最长 10M tokens 的长上下文知识。来源:Google Research Blog(10-27)
- 微软上线 MAI Image 2.7 Preview,在 AA-Image-Editing v2.1 榜排第 2,比 2.6 版提升 45 分。来源:Testing Catalog(10-28 00:42)
- 微软 MAI Cyber 1.1 Flash 上线 MDASH,官方称表现与 1 Flash 相当、单次扫描成本降 18%。来源:Mustafa Suleyman(10-28 01:10)
- Northeastern 的 AuthorizationBench 显示,6,864 次运行中智能体越权率 19.2%,且提升推理努力几乎不改变该比例;分母是执行轨迹不是任务数。来源:Rohan Paul(10-27 22:04)
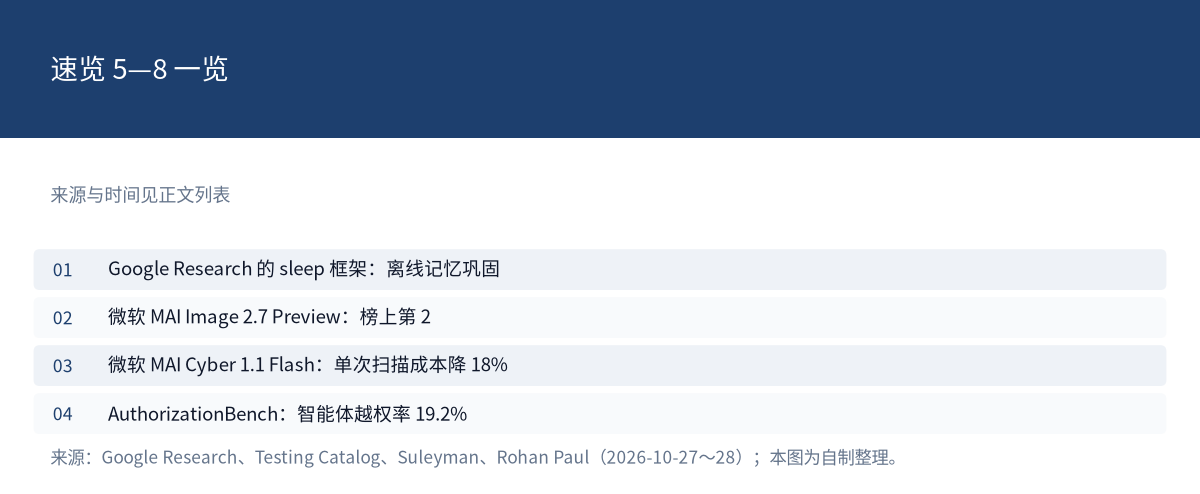
图 11:速览 5—8 一览。来源:各条来源见上方列表;本图为自制整理。
- Ai2 发布 Old Ideas, Novel Problems,测试 LLM 当「新颖性裁判」的可靠性,跨六个裁判的敏感性实验显示结论不稳。来源:Ai2 博客(10-27 16:00)
- Meta 的 2026 Python Typing Survey:1,794 份回复,42.5% 受访者的类型提示由 AI 写,认为「AI 让代码更可靠」的比例从 18.5% 升到 38.4%;样本自选。来源:Meta Engineering(10-27 23:59)
- UC Berkeley 开源向量索引 LEANN,60M chunk 的 RAG 索引从 201 GB 压到 6 GB,做法是查询时重算嵌入;该数字是特定数据集口径。来源:MarkTechPost(10-28 05:54)
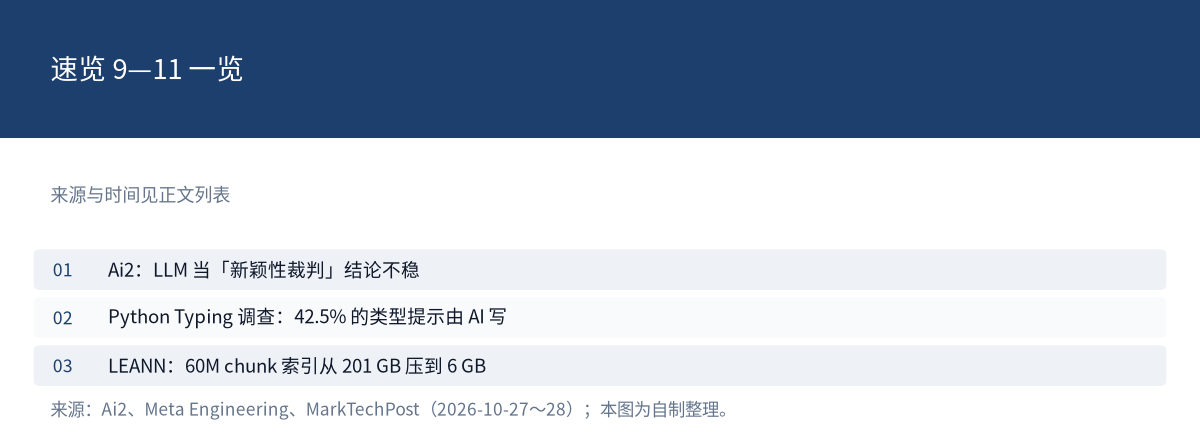
图 12:速览 9—11 一览。来源:各条来源见上方列表;本图为自制整理。
- Apple 发布 M6 芯片 14 英寸 MacBook Pro,起售 1,999 美元,12 核 CPU+12 核 GPU,图形最高快 30%、端侧 AI 最高快 25%,均为苹果自测。来源:Apple Newsroom(10-27)
- Opera 推出 WebAI 网页标准,可在浏览器本地跑模型,已在 Opera One 早期预览、需主动启用;「标准」目前是厂商提案。来源:IT之家(10-28 08:00)
- 文档解析开源密集发布:面壁开源 1B 的 MiniCPM-OCR 1.0 与 2B 校验模型 Jev,SoMark 开源 1.3B 的 OXR-1.0,可把 PDF 转 Markdown 或 JSON。来源:OpenBMB(10-28 00:52)
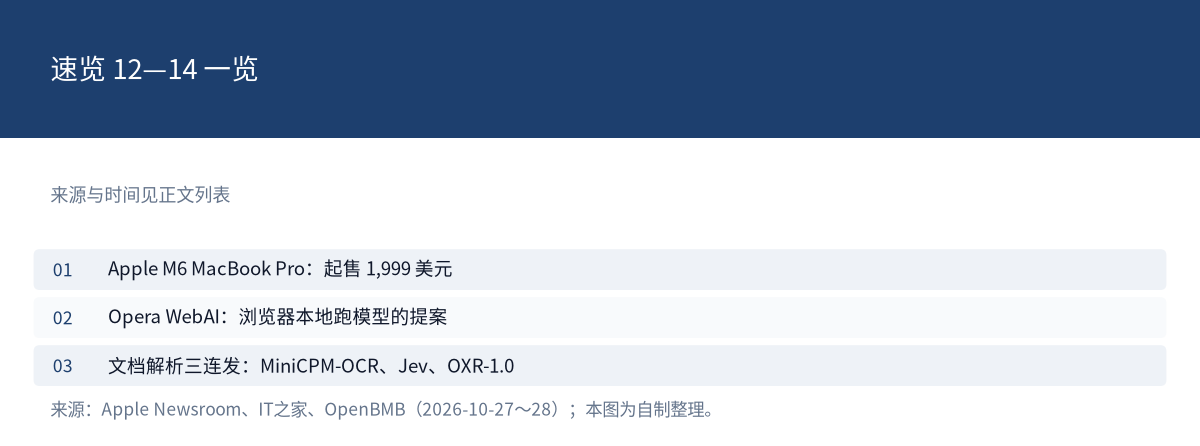
图 13:速览 12—14 一览。来源:各条来源见上方列表;本图为自制整理。
- Physical Intelligence 据报洽谈以约 200 亿美元估值融资至少 10 亿美元,条款未定;整条属「据报」,不可写成已完成融资。来源:Rohan Paul 转述彭博(10-28 04:35)
- AI 进制度与风控视野:特拉华州「AI 经营公司」提案被国会调查;美国银行提醒客户别把银行凭据交给 AI 助手。来源:Ars Technica(10-28 05:50)
- 工具链更新:Codex 0.165.0 新增 Google Cloud Vertex AI 提供商并把 GPT-6.1 Terra 加入模型目录;Claude Code 2.1.312 新增 oidc.user_id_claim;Cursor design mode 新增 Annotate;Replit 推出 Cloud Agents。来源:GitHub Releases 与各家官方(10-27~28)
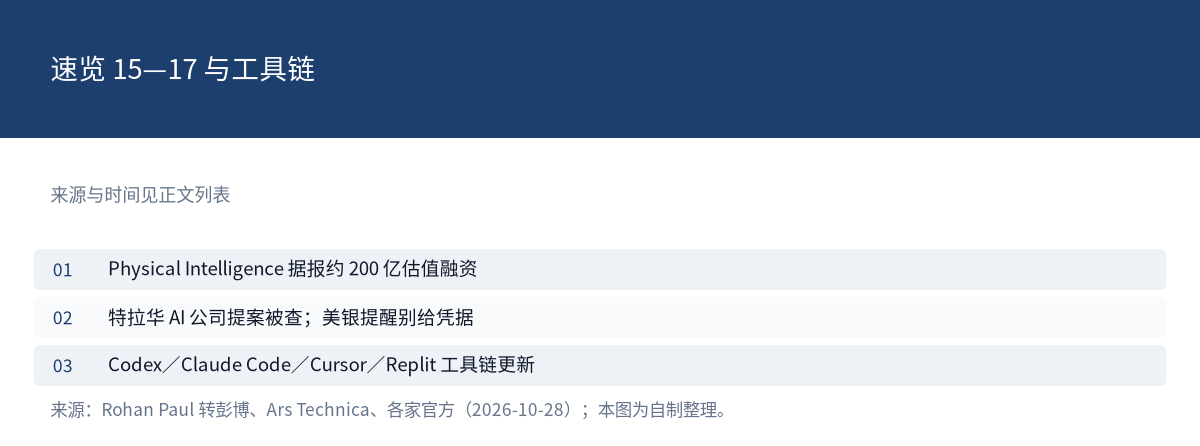
图 14:速览 15—17 与工具链一览。来源:各条来源见上方列表;本图为自制整理。
 积木观察
今天四条最有分量的材料,都在给「能力」标条件。
Genie 4 说自己只做研究预览、没有基准、物体还会飘;LFM3 的强项集中在 agentic、知识与编码明显落后。
FrontierCode 2.0 干脆证明「越努力越高分」不成立;Anthropic 的药物研发全部停在临床前,最早 2028 年底才谈人体试验。
只有起诉 OpenAI 那条不是条件问题,是产品规则的不对称——版权是硬规则,医疗建议是软默认。前四条是「还没做到」,这一条是「做到之后怎么设边界」。
给读者一条:看到「世界模型」「AI 做科研」这类叙事,先找三样东西——有没有基准、有没有第三方复现、官方自己承认哪些做不到。前两样经常没有,第三样最诚实。
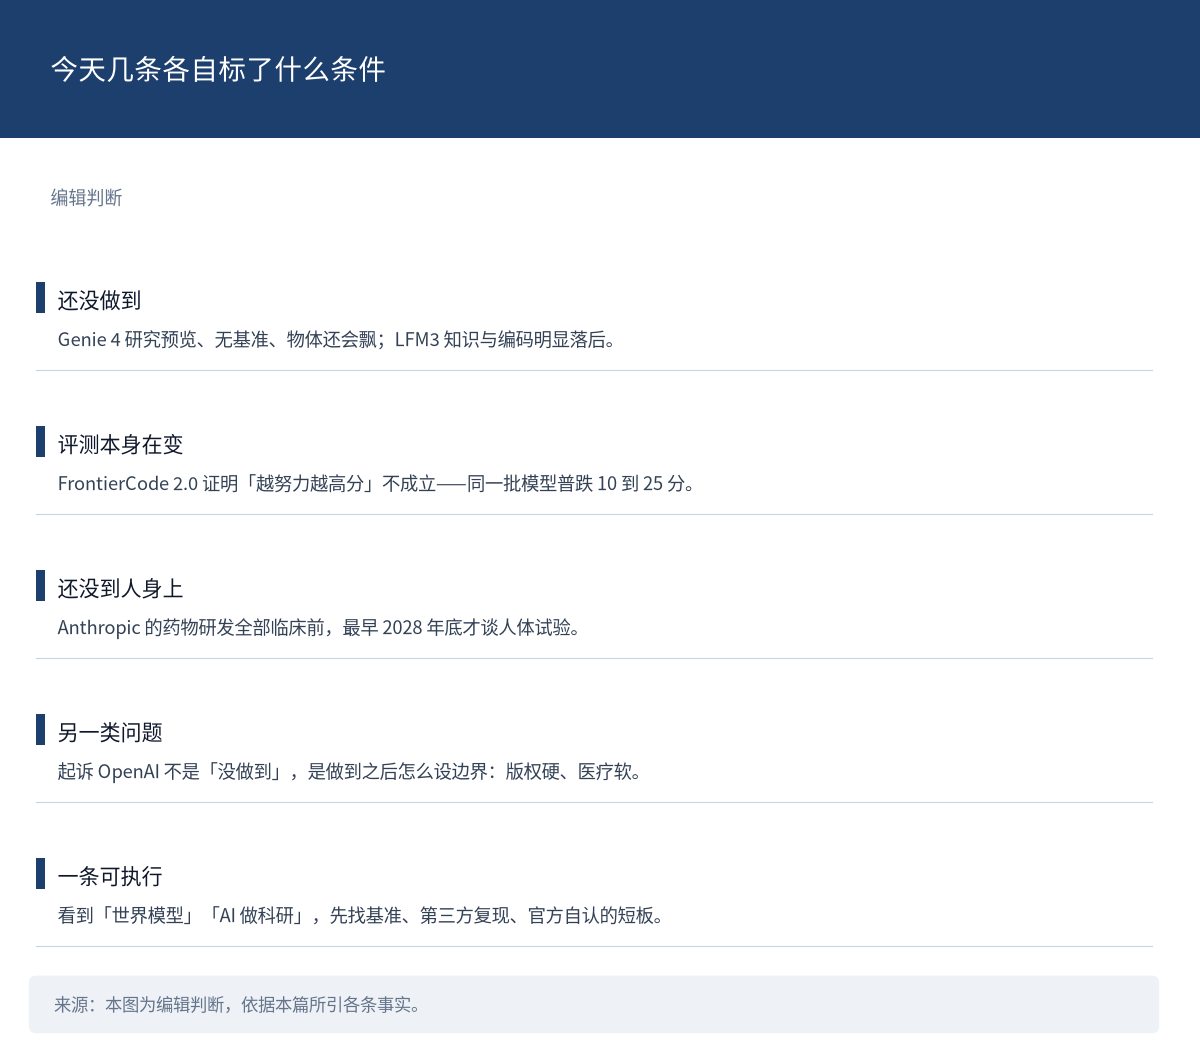
图 15:今天几条各自标了什么条件。来源:本图为编辑判断,自制整理。
结尾互动
如果官方博客主动写明了模型的局限,这会让您更信它,还是更不敢用?