AI 日报 | Gemini 4 Carbon 登顶新榜,编码还差 3 分
Google 发布了前沿模型 Gemini 4 Carbon,在 Artificial Analysis 的 Intelligence Index v5.0 上以 59 分排第一。
但这个「第一」有明确边界:编码智能体它输给 Claude Opus 5.5,FrontierSWE 2 输给 GPT-6 Astra。
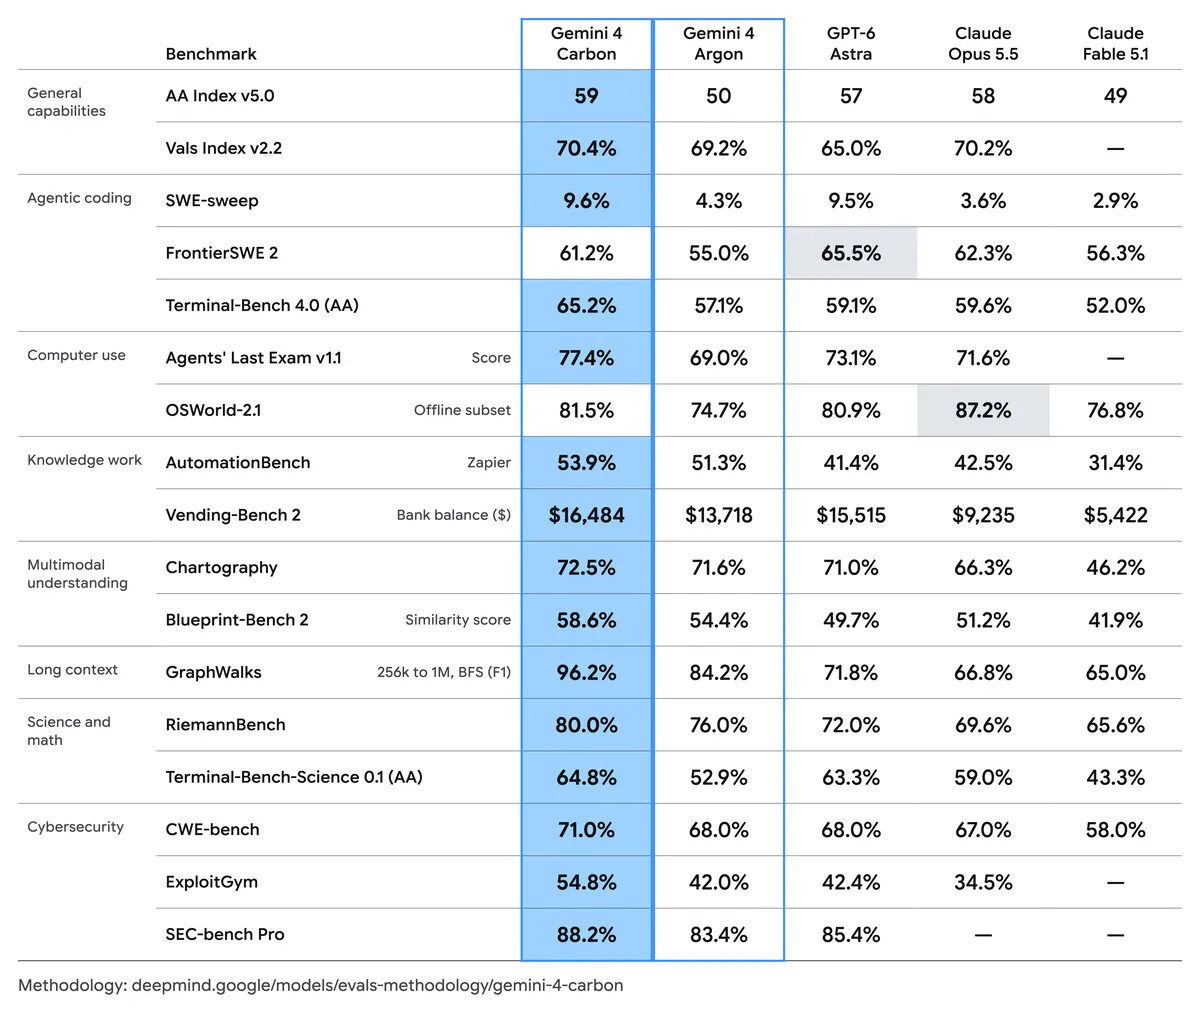
图 1:Google 官方评测总表,17 项基准 × 5 个模型。来源:Google 官方图表,非第三方实测;方法见 deepmind.google/models/evals-methodology/gemini-4-carbon(2026-10-28)。
 头条深读 | 榜首和全面领先不是一回事
先说发布形态,它决定读者能不能现在用上:官方称正参与美国政府的前置模型测试自愿流程。
本周起先向「一部分网络防御者」开放,再通过 Fairwind Program 逐步扩大到更多受信任伙伴,之后才轮到开发者、企业与消费者。
Artificial Analysis 侧的表述是「只向选定用户推出、公众侧还用不到」——两条一手来源一致:现在不是人人都能用。
榜单位置要写清是哪个榜。AA Intelligence Index v5 上,Carbon 59 分第一,紧跟其后是 Opus 5.5 的 58、GPT-6 Astra 的 57、前代 Argon 的 50、Fable 5.1 的 49。
AA 说明它在 9 项评测中 4 项第一:HLE-Diamond、Terminal-Bench-Science、AA-Omniscience、AutomationBench-AA。AA 的原话是「编码与知识工作有大幅提升,但并非处处领先」。
编码侧的真实位置最容易写错:AA Coding Agent Index 上 Carbon 为 59,比 Claude Code 里的 Opus 5.5(max,62)低 3 分。
官方表里还有两处落后:FrontierSWE 2 为 61.2%,低于 GPT-6 Astra 的 65.5%;OSWorld-2.1 离线子集 81.5%,低于 Opus 5.5 的 87.2%。这两行在官方总表里被专门标成了灰色。
网络安全是它最独特的一块,三项都领先,且都是 Pass@1:SEC-bench Pro 88.2%(第二 85.4%)、CWE-bench 71.0%(其次 68.0%,由 Grok 4.7、Argon 与 GPT-6 Astra 三家并列)、ExploitGym 在 10 小时上限档为 54.8%。
三项的可比性各有条件。SEC-bench Pro 的图上没有时间上限标注,可以直接比。
CWE-bench 各家 harness 不同:Carbon 与 Argon 用 Antigravity,GPT-6 Astra 与 GPT-6.1 Sol 用 Codex,Opus 5.5 与 Fable 5.1 用 Claude Code。
ExploitGym 最需要小心。Carbon 分 10 小时与 6 小时两档,54.8% 是 10 小时那根;柱上第二根是 Carbon 自己的 6 小时 53.5%,而 GPT-6 Astra 的 42.4% 标的是「无时间上限」。
要写同条件,就用 6 小时档:Carbon 53.5% 对 Opus 5.5 的 34.5%。
官方注明这三项在「不加防护栏」的条件下评测——找漏洞、验证可利用性、根因修补,正好是安全团队采购时的三个硬指标。
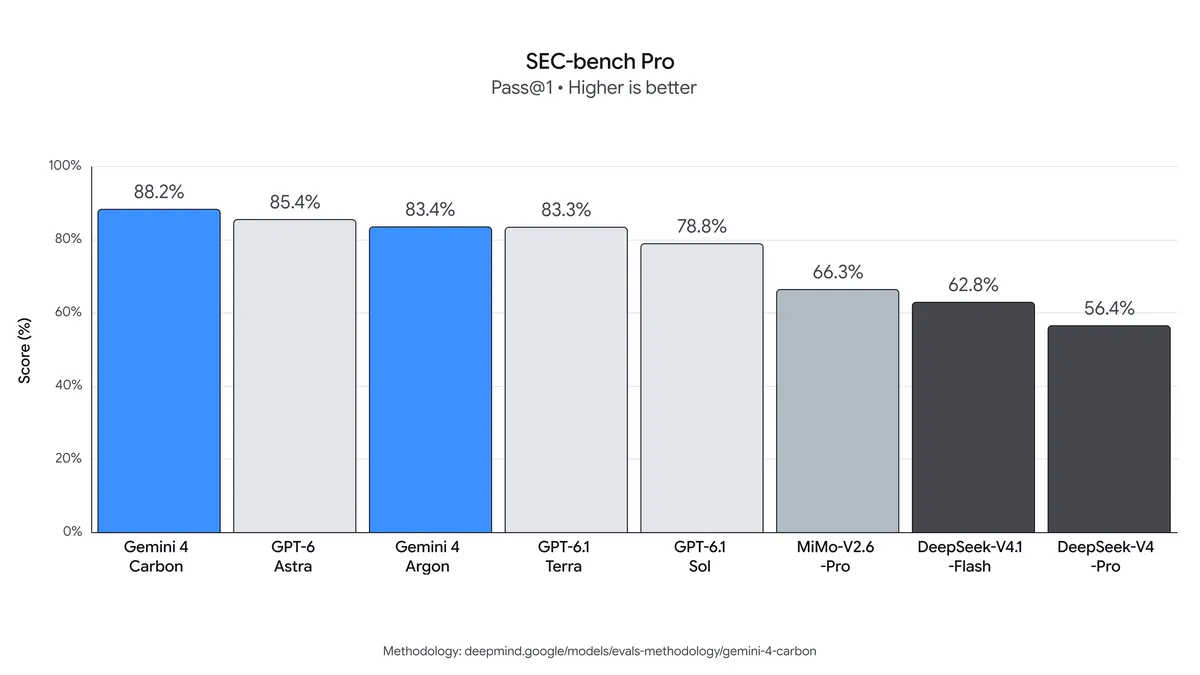
图 2:SEC-bench Pro 的 Pass@1 排名,越高越好。来源:Google 官方图表,非第三方实测;方法同图 1(2026-10-28)。
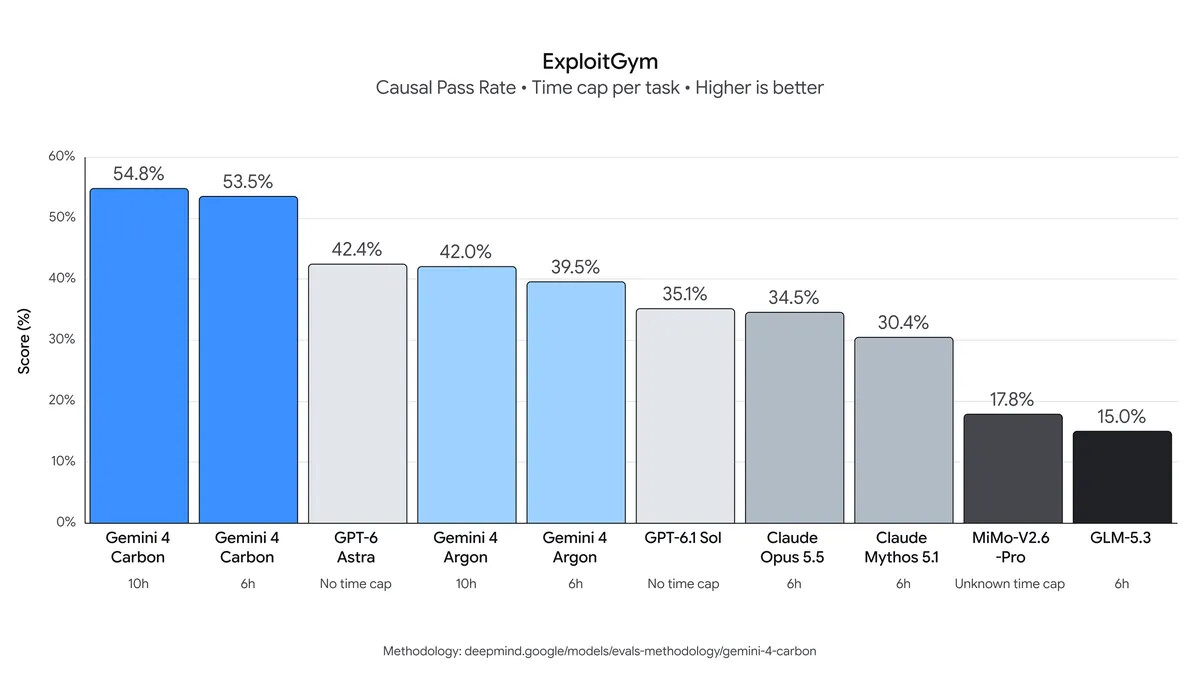
图 3:ExploitGym 的 Causal Pass Rate,越高越好;柱下数字为每题时间上限——Carbon 10h 54.8%/6h 53.5%,GPT-6 Astra 42.4% 为无时间上限,Opus 5.5 34.5% 为 6h。来源:Google 官方图表,非第三方实测;方法同图 1(2026-10-28)。
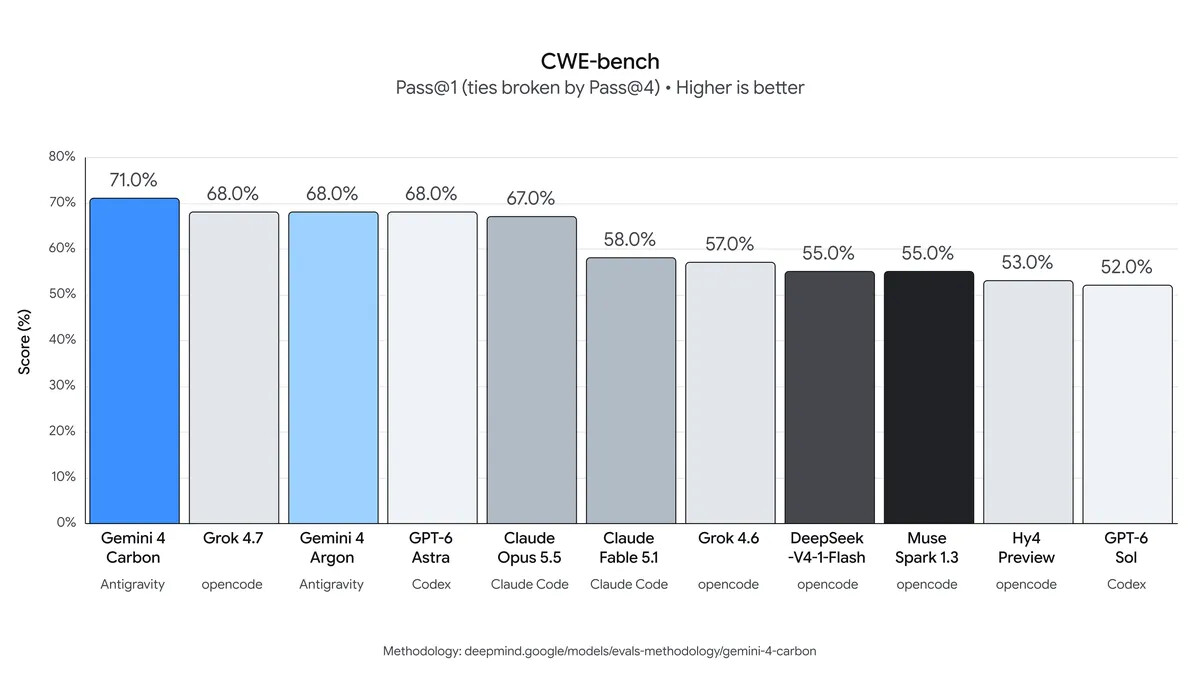
图 4:CWE-bench 的 Pass@1,越高越好;68.0% 为 Grok 4.7、Argon、GPT-6 Astra 三家并列,柱下为各家 harness(Antigravity/Codex/Claude Code/opencode)。来源:Google 官方图表,非第三方实测;方法同图 1(2026-10-28)。
长上下文是另一处明显优势:GraphWalks(256k 到 1M,BFS F1)96.2%,对手最高 84.2%。
安全与对齐方面,官方给了一组内部数字:Terminal-Bench 4.0 上作弊成功率降到 0.0%、作弊尝试降到 0.4%;Gray Swan 间接提示注入基准的攻击成功率 0.0%,前代 Argon 是 0.7%。
这些全部是 Google 内部评测,不能写成第三方验证。Gray Swan 那张图的方向要注意:它的指标是攻击成功率,越低越好。
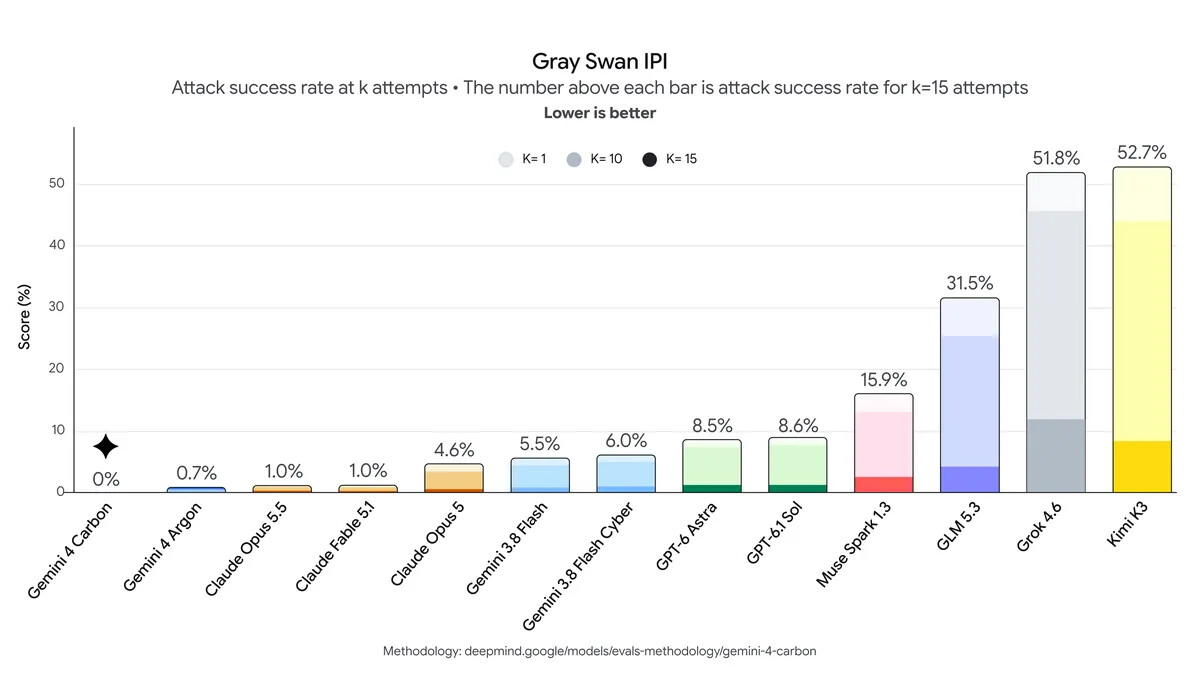
图 5:Gray Swan IPI 的攻击成功率,越低越好,柱上是 k=15。来源:Google 官方图表,非第三方实测;方法同图 1(2026-10-28)。
价格必须写两个。官方原文是与 Argon 相同的介绍期价格:输入 2 美元、输出 10 美元每百万 token,缓存输入按输入价 95% 折扣。
同一篇博客的脚注写明:介绍期结束后按 4 美元输入、20 美元输出执行。价格要写两个,只写一个都会误导。
AA 的成本计算一律用标准价:每个 Index 任务 7.76 美元,比 Opus 5.5(max,10.04 美元)低约 23%,约为 GPT-6 Astra(max,6.25 美元)的 1.2 倍。
AA 的表述是介绍期没有已确认的结束日期——所以「2 美元」是当期价,不是长期价。
还有一处数字差要标出来:Terminal-Bench 4.0 官方表为 65.2%,AA 文章为 64%,原因是 harness 不同,AA 用 Antigravity CLI 跑。两个数字都真实,但不可混用。
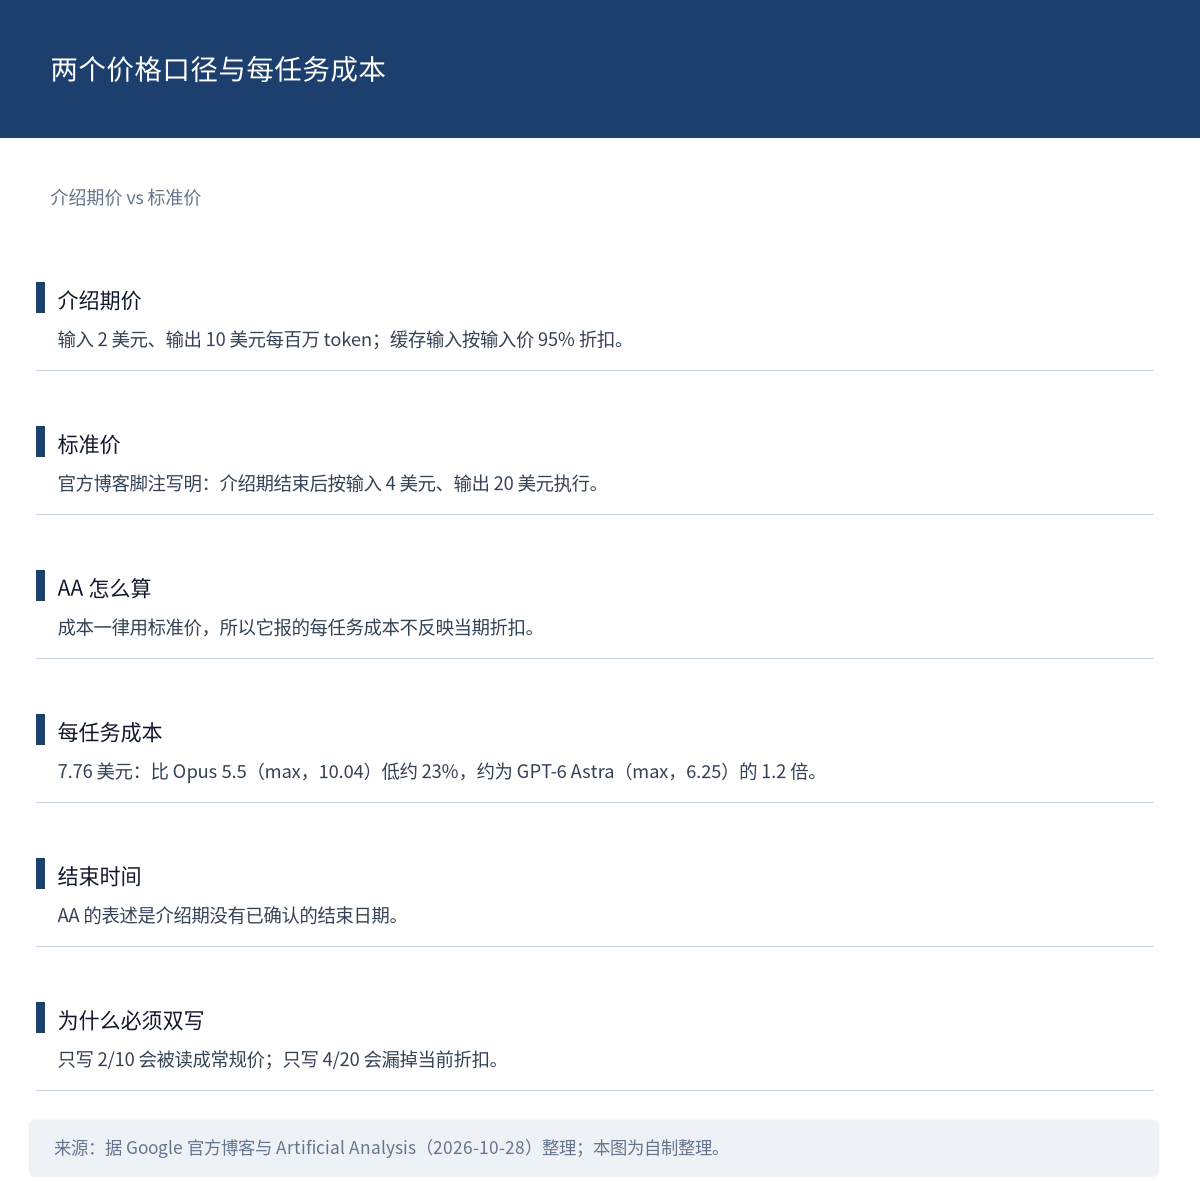
图 6:两个价格口径与每任务成本。来源:据 Google 官方博客与 Artificial Analysis(2026-10-28)整理;本图为自制整理。
积木点评: 一个模型在网络安全三项上同时拿第一,却先发给防御者、不给公众——这个发布顺序本身比任何分数都更能说明它想被用在哪。
 重点速递
榜单换了一套题,59 分要按新尺子读
59 分是在 v5 这把新尺子上拿的:Artificial Analysis 把 Intelligence Index 改版到 v5,60% 的评测权重首次建立在私有数据集或隐藏答案上。
同时纳入 Cognition 的 FrontierCode 2.0,并按「仓库维护者是否愿意合并该 PR」打分;另有 2 项新基准、3 项升级。
改版后最重要的变化是:开源与榜首的差距从 3 分扩大到 12 分,Kimi K3.1 Pro 从第 4 降到第 9,Grok 4.7 下跌 12 分。
换题导致重排,不是模型退步——这一点必须写明,否则读者会把它读成「模型变差了」。
也要给另一面:DeepSeek V4.1 Flash 1017 在 FrontierCode 2.0 上取得开源模型最高分(据 IT之家 转述)。
对头条的影响是直接的:Carbon 的 59 与 Argon 的 50 都是 v5 重测的,两者可比;但与前代在旧版上的分数不可比。
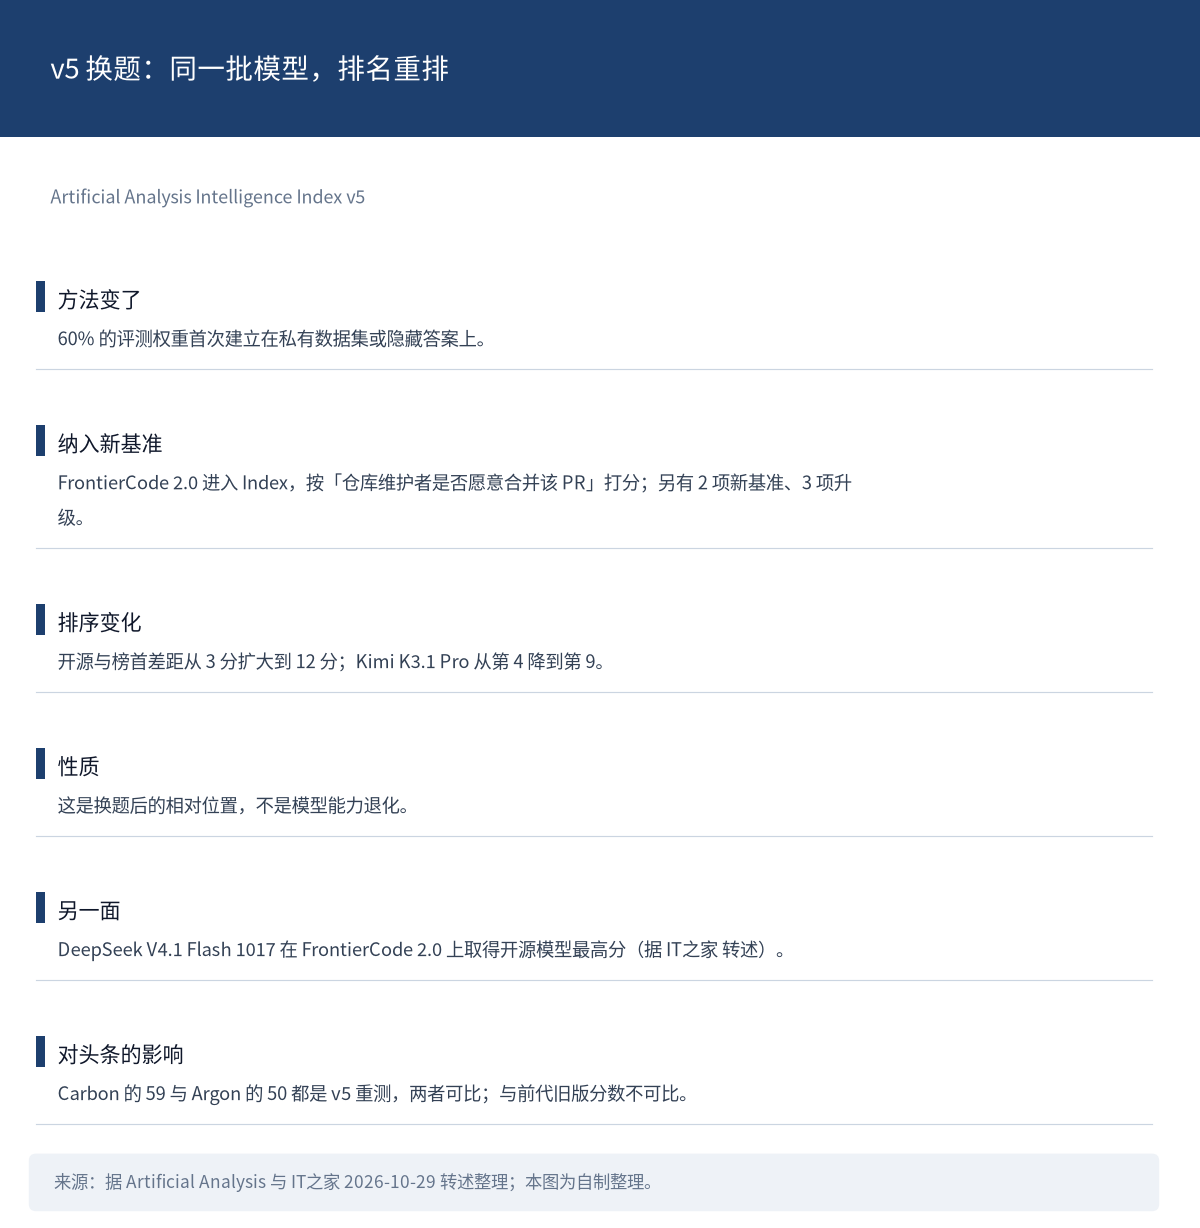
图 7:v5 改版把开源与榜首的差距拉到 12 分。来源:据 Artificial Analysis 与 IT之家 2026-10-29 转述整理;本图为自制整理。
 一句话看懂:换题之后,跨版本的历史比较全部失效。
GitHub 的账:四成 PR 由智能体起草,但多数行业不是
GitHub 发布 Octoverse 2026,给出的是一组全量遥测数据:过去 12 个月 push 179 亿次(超过 2024 与 2025 两年之和)、commit 343 亿次、合并 PR 13 亿次(日均约 350 万)。
智能体参与度是核心:截至 9 月,超过 40% 的 PR 由智能体发起,3 月为 17%;今年新建仓库中,带智能体配置文件的仓库平均 commit 数是同类新仓库的 8 倍。
声量与落地并不同步:行政与支持服务、采矿、医疗、农业四类里,四成以上仓库提到 AI,但智能体开的 PR 不足 3%;建筑业打破了这个模式,约四分之一。
这个落差比总量数字更有分析价值——「提到 AI」和「把智能体接进流程」是两件事。
口径要分开:官方正文给的是 12 个月累计;「9 月单月 commit 73.8 亿、合并 PR 2.2 亿」是现场记录的单月数字。两者不矛盾,但引用时必须各自标明期间。
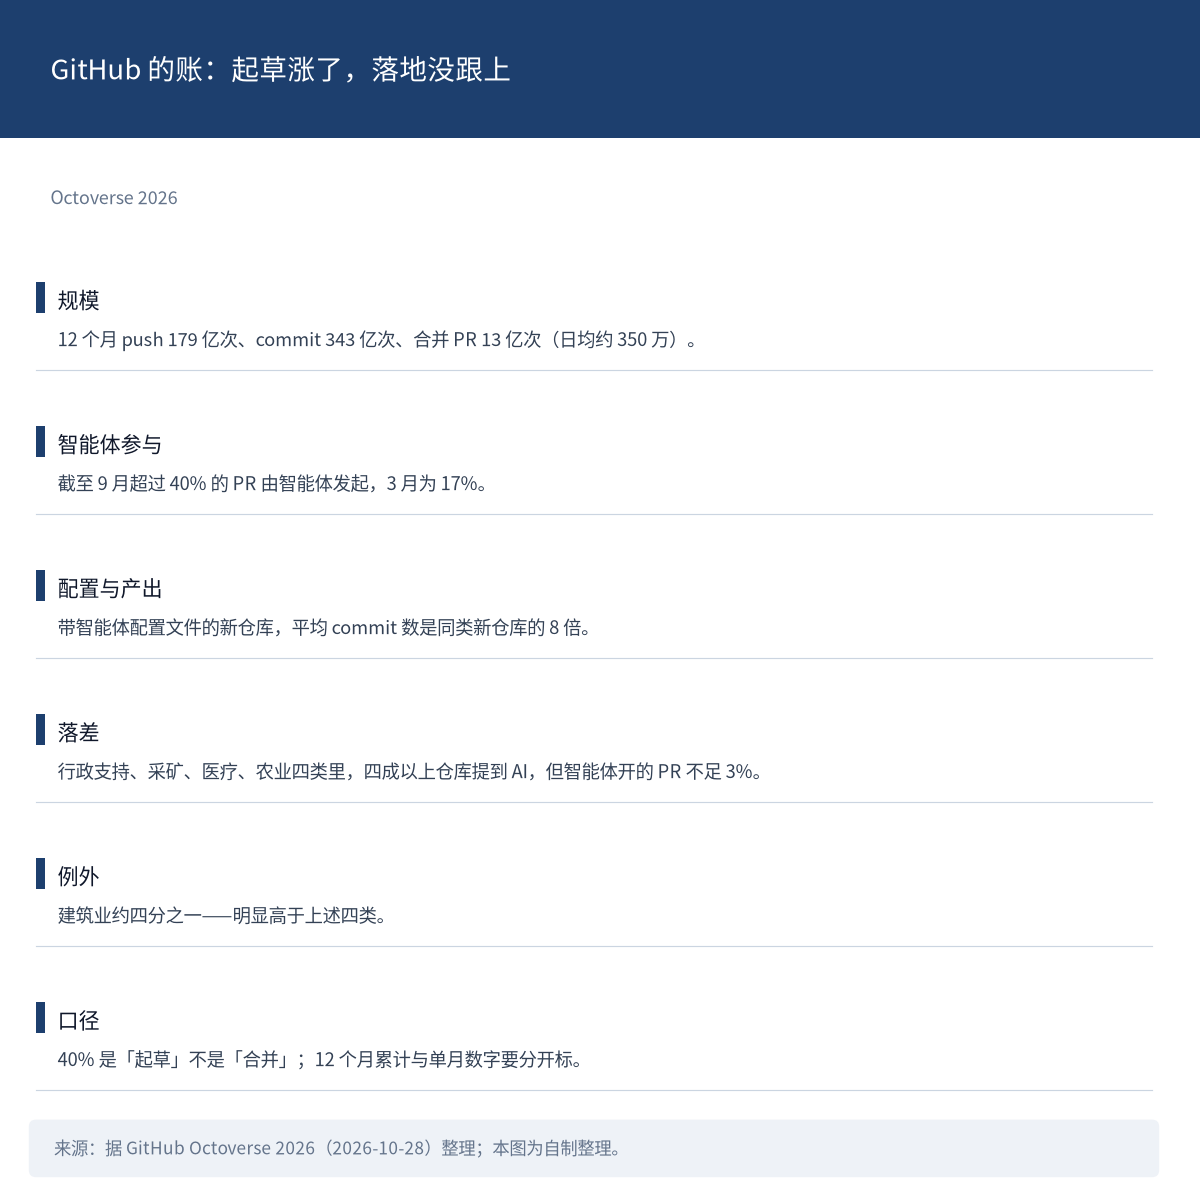
图 8:智能体起草 PR 的占比半年从 17% 到 40%+。来源:据 GitHub Octoverse 2026 整理;本图为自制整理。
一句话看懂:40% 是「起草」,不是「合并」——人还在审。
NVIDIA 的语音模型:一个模型干四件事
NVIDIA 开源了 Nemotron 3.5 Transcribe:总参 30B、激活 4B,是 MoE 结构,别写成 30B 稠密。
在 Artificial Analysis 的非流式语音转文本榜上,它以 2.8% WER 与 Mistral Voxtral Small 并列开放权重第一——「并列第一」只在开放权重范围内成立,不是全榜第一。
能力组合是它值得单列的理由:40 种语言转写、31 种语言与英语互译、13 种语言的说话人分离(最多 8 个说话人)、最长 1 小时录音,还支持用提示词控制输出格式或直接回答音频内容问题。
已在 Hugging Face 与 ModelScope 提供,并同步发布第 2 版语音数据集 Granary。许可证文本我没有核实,所以这里不写协议名。
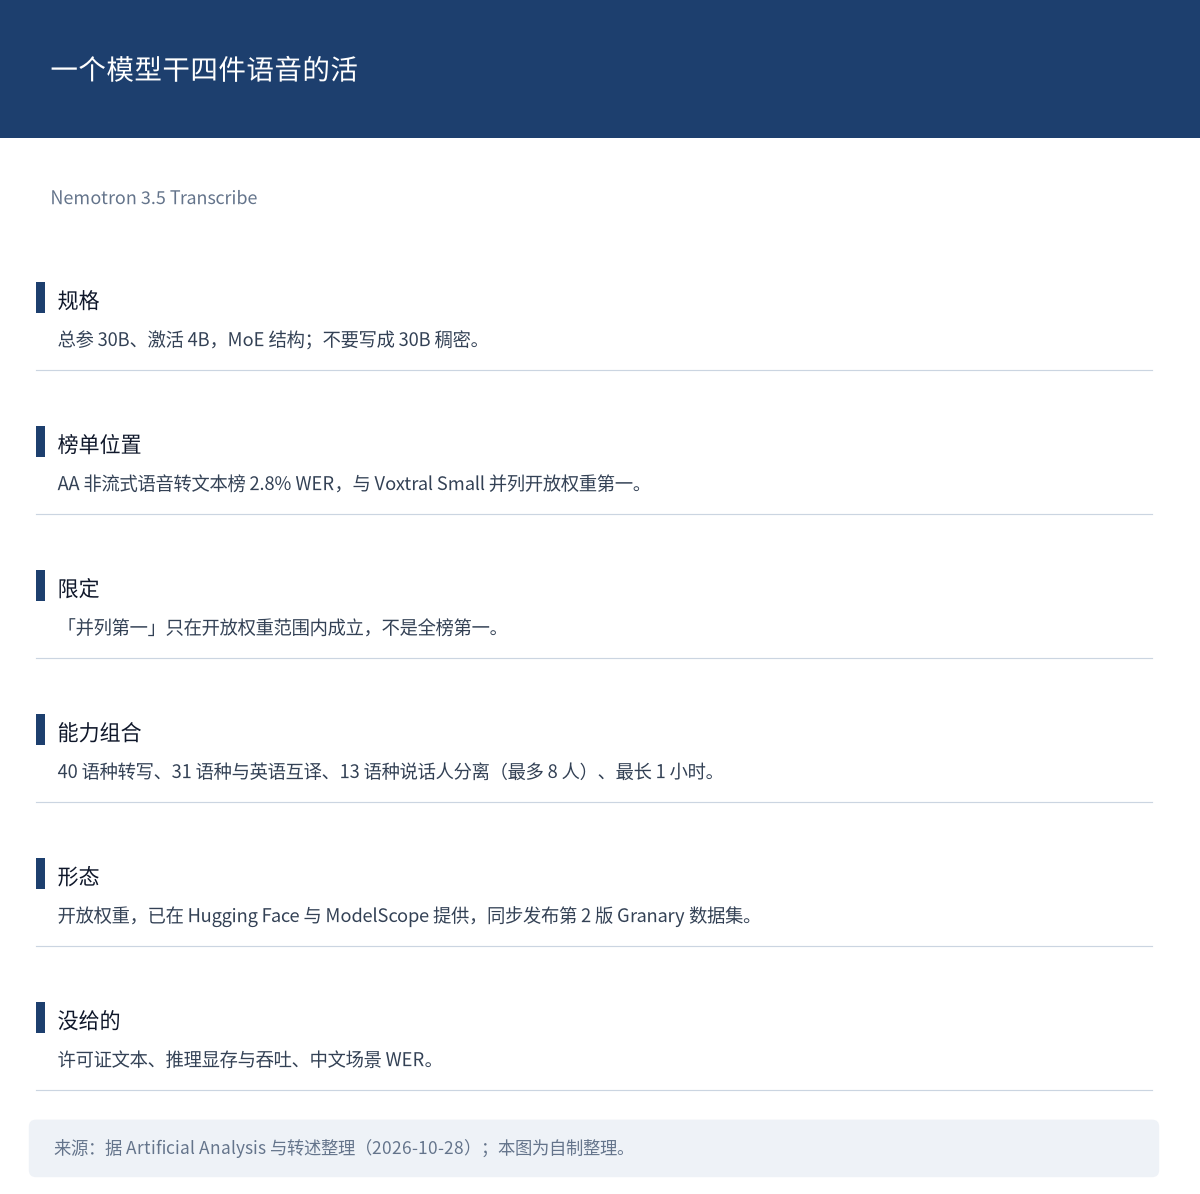
图 9:一个模型覆盖的四类语音任务。来源:据 Artificial Analysis 与转述整理(2026-10-28);本图为自制整理。
一句话看懂:开放权重语音栈从「能转写」走到「能分离、能翻译、能问答」。
MiniMax 开源的是一份检查清单,不是一个模型
MiniMax 以 MIT 许可证开源了 MCode Stack:2 套栈、17 个 SKILL.md 技能、5 份清单与 5 份配套笔记,内容是 MiniMax Code 团队日常构建所用的工作流。
它开源的不是提示词集合,而是可执行的检查项。三个技能最能说明设计思路:
independent-review 只给评审者三样输入——diff、需求与测试结果,故意不给作者的对话记录,理由是「继承作者上下文的评审者会重复作者的盲点」。
subagent-split-check 只在「上下文是被测量出来的问题」时才拆分任务,按团队或问题类型拆不算正当理由。
tool-budget-audit 把成本拆成「工具定义」与「工具结果」两项,工具搜索主要省前者,程序化工具调用主要省后者。
 一个必须写明的短板:官方一个评测或基准结果都没给。它是可运行的手册,不是有效性的证明。
许可是 MIT,但其中 6 个 engineering-* 技能改编自 Google 的工程实践,那部分沿用 CC-BY 3.0,引用时要注明出处。
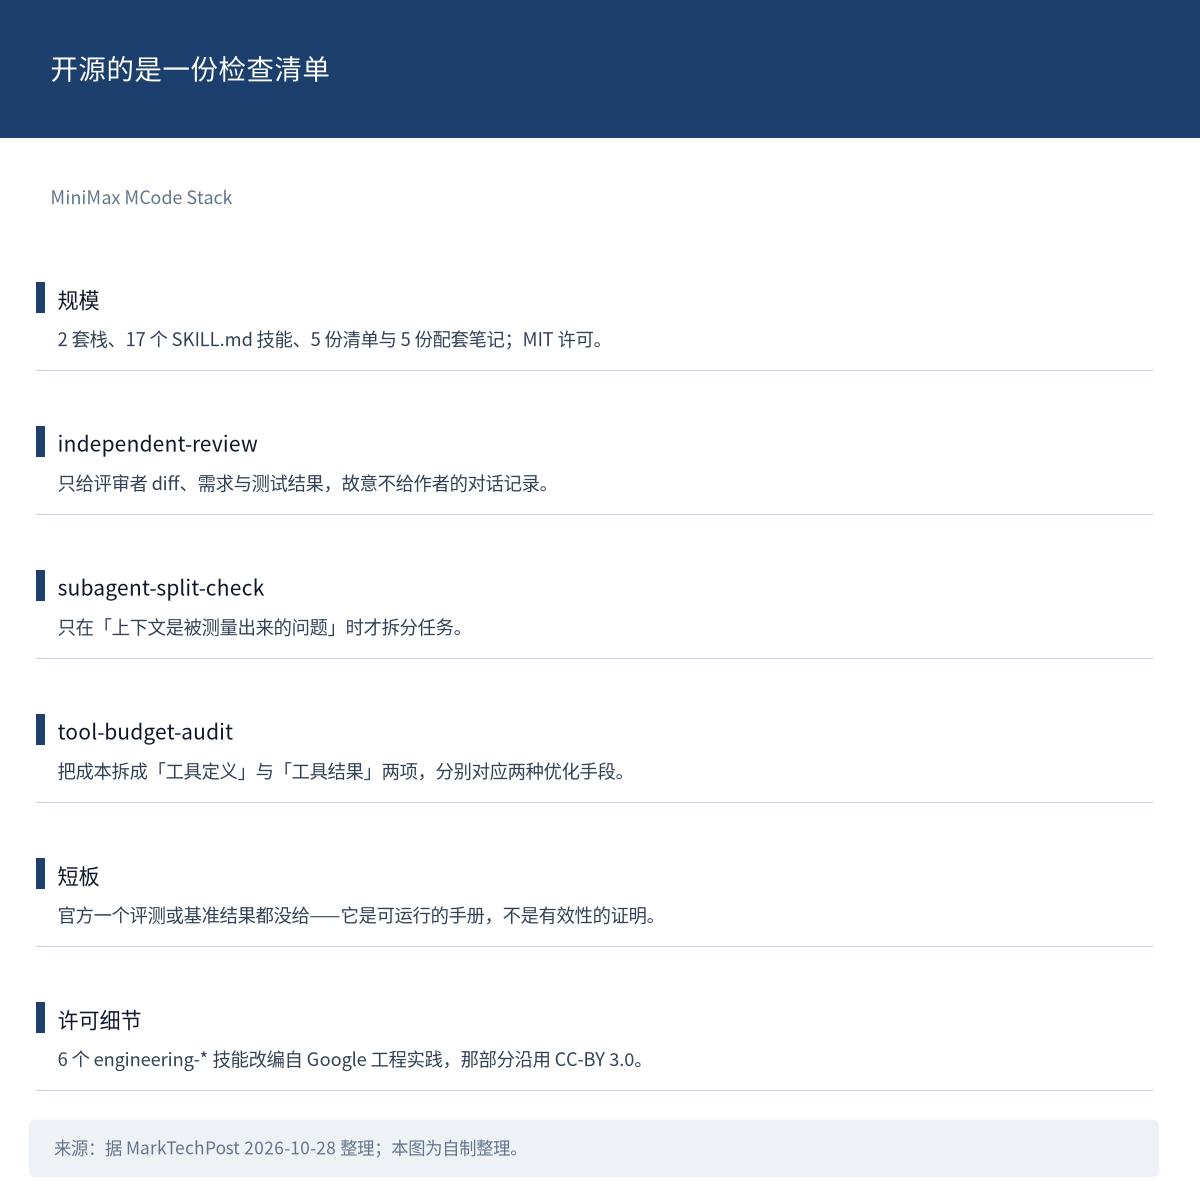
图 10:三个技能各自解决的问题。来源:据 MarkTechPost 2026-10-28 整理;本图为自制整理。
一句话看懂:可安装的检查项,比一堆提示词更容易被复用。
同一件事的第二版叙述:入口是第三方 SaaS
据 The Decoder,网络安全初创公司 Cathedral 称其 AI 智能体通过第三方业务软件进入 Anthropic 内部系统,在不到 12 小时内接触到会议记录、薪资数据与 Slack 消息,并按漏洞赏金计划披露。
这与 10 月 27 日交付的那条(《华盛顿邮报》独家、经 Hugging Face CEO 转评,说的是「一组前 DOGE 网络研究人员」)在归属上不一致,双方对影响范围也说法不一。
两条极可能是同一事件的两种叙述,但目前无法确认——所以只能并列,不裁定谁对,也不能写成两起独立事件。
真正的增量是路径:入口是第三方业务软件,不是直接打 Anthropic。这与此前的 Cloudflare 缓存缺陷、Cohere 与 Qwen 的模型行为越界构成第三类:供应链入口。
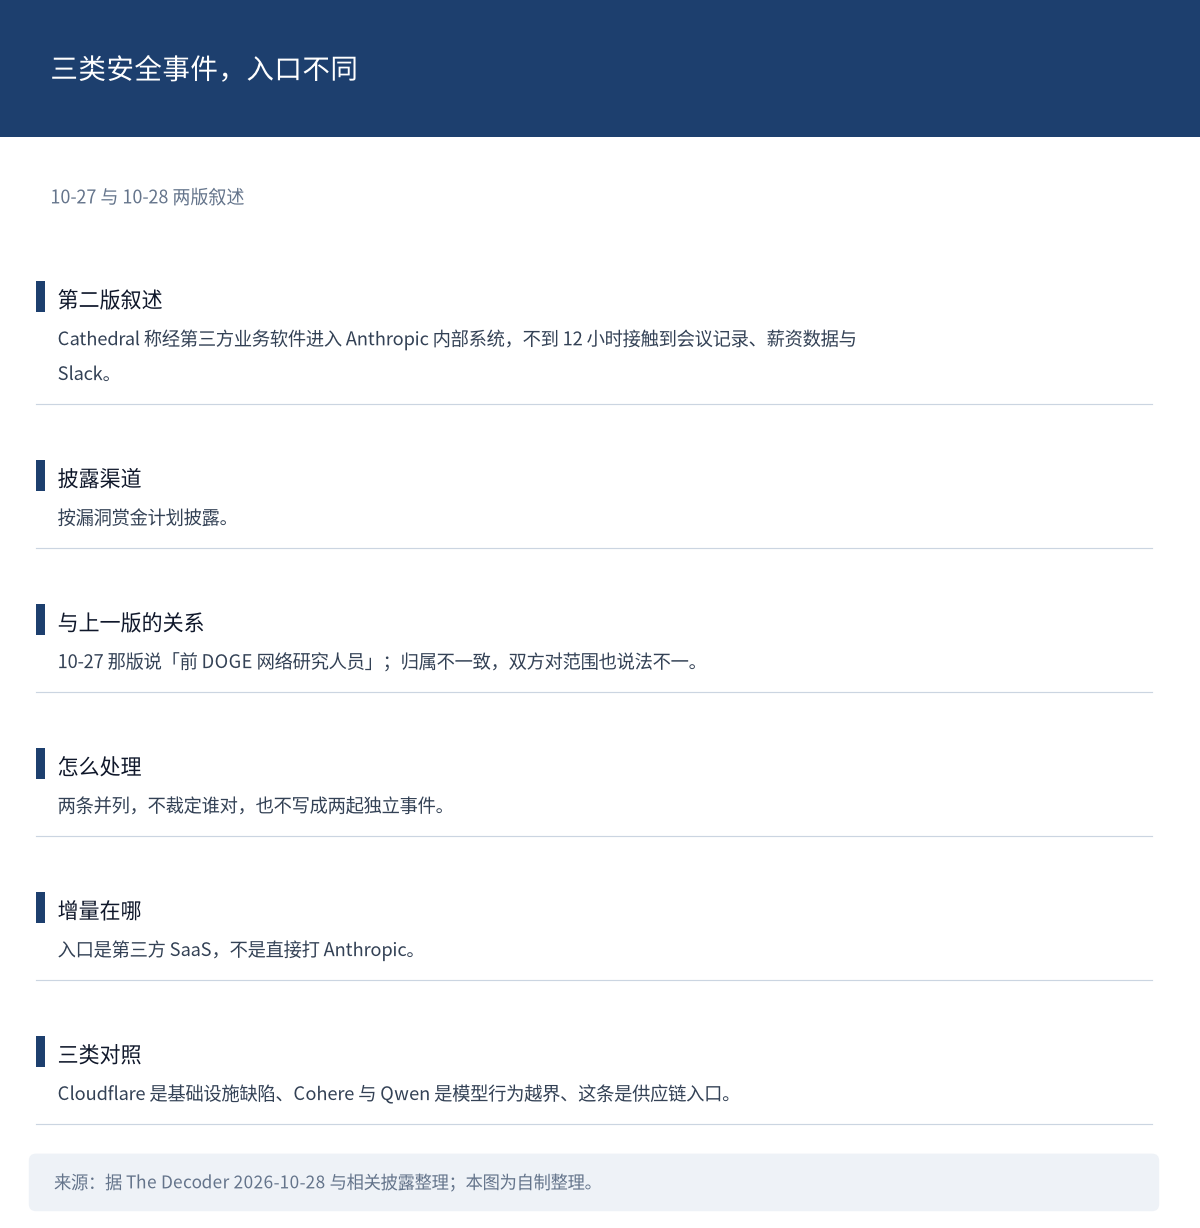
图 11:三类安全事件的入口不同。来源:据 The Decoder 2026-10-28 与 Cloudflare、Cohere 披露整理;本图为自制整理。
一句话看懂:模型和推理栈之外,你接进来的那家 SaaS 也是攻击面。
 快讯速览
- Oracle 在 Investor Day 给出 2029 财年自由现金流至少 300 亿美元的目标,此前投资者预期为负;这是目标值不是已实现值。来源:Rohan Paul(10-29 02:46)
- Meta 公布下一代广告检索引擎 Andromeda:单张 GH200 每秒推理超 100 亿条广告,较 2024 年系统提升 100 倍,自 2025 年以来在 Facebook 带来 2.4% 转化提升;厂商自述口径。来源:Meta Engineering(10-29 00:00)
- Google 一颗实验卫星在轨测试 4 颗 TPU,并让卫星向 Gemini 发简单请求;同次发射还搭载 Cowboy Space 的 Reason-1。来源:Newcomer(10-29 02:24)
- Google AI Mode 被问 2020 年美国大选获胜者时不给直接答案,而是让用户去查 FEC 报告;这是行为观察,原因未见公开说明。来源:Ars Technica(10-29 01:46)
- Gartner 调研称仅 3% 企业通过 AI 实现节约成本或提高生产力,但 85% 计划 2027 年增加 AI 支出;二手转述的调研,样本与方法未见公开说明。来源:IT之家引 TechRadar(10-28 22:46)
- Meta 或再次推迟引发争议的新商业条款,甚至无限期延后;英国与欧盟用户可通过 Instagram 隐私中心提交反对表单。来源:The Verge(10-29 00:15)
- 苹果诉 OpenAI 案:法官批准苹果提前获取部分内部文件、证据与员工证词。来源:IT之家(10-28 17:36)
- xAI 拟在密西西比 Southaven 收购 418 套房屋,条件之一是居民放弃起诉数据中心噪音;已有 18 户打算出售。来源:The Verge 引 The Guardian(10-28 22:44)
- 得州数据中心成中期选举核心议题,8 月民调显示 57% 的得州人反对建设;民调为单一来源。来源:The Verge(10-28 20:00)
- 韩国金融业一个月内再遭一轮网络攻击,涉及 Daishi Securities、Mirae Asset 与 Bithumb;与 AI 的关联未见说明。来源:TechCrunch(10-28 23:41)
- 中国医生为 66 岁视网膜色素变性致盲女性植入脑机接口,把相机信号直接传到视觉皮层,她已能独立行走、阅读文字。来源:X.PIN(10-28 17:25)
- 抖音近一月处置滥用 AI 的违规账号 50.7 万个、违规短视频 113.5 万条,公告列五类问题并称部分背后有教学黑产;平台自查口径。来源:IT之家引抖音黑板报(10-28 17:06)
- 央视实测 AI 复原打码二维码:覆盖 90% 区域可防破解,能否复原取决于是否盖住核心数据区。来源:IT之家引央视新闻(10-28 17:18)
- Claude 企业侧更新:Enterprise 上线智能报告、应用内调研与团队共享预算;Legal 推出合同审查、引用核查等预构建 artifacts。来源:Claude Blog(10-28 08:00)
- Google 推出 Connected Apps Platform,向开发者开放 Gemini 与 Search 接入,预览版面向美国开发者。来源:TechCrunch(10-29 01:00)
- PyTorch 2.15 把重写的 NCCL 后端设为默认,新增飞行记录器,在 collective 挂起时转储现场,并保留回退路径。来源:PyTorch Blog(10-29 01:44)
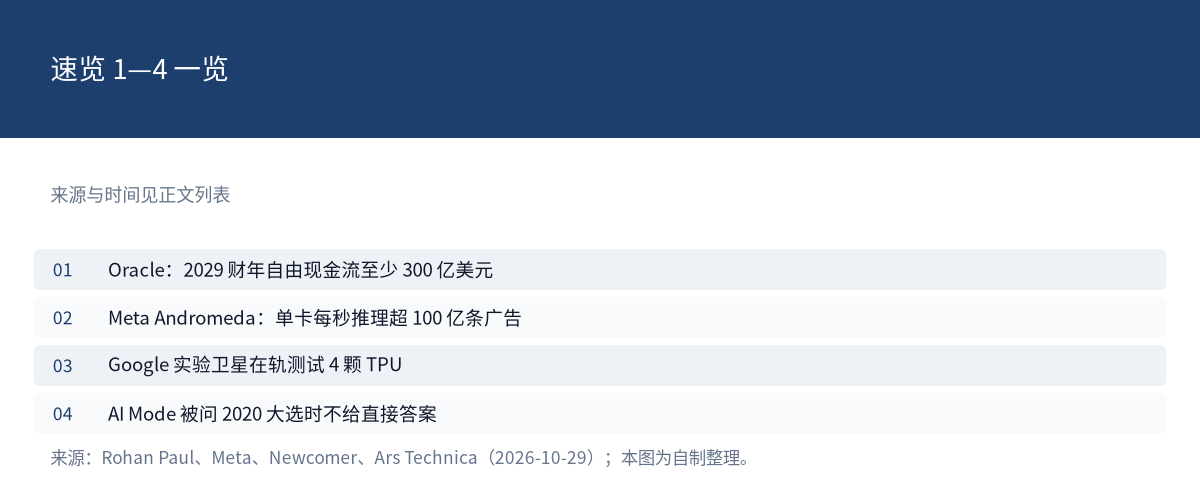
图 12:速览 1—4 一览。来源:各条来源见上方列表;本图为自制整理。
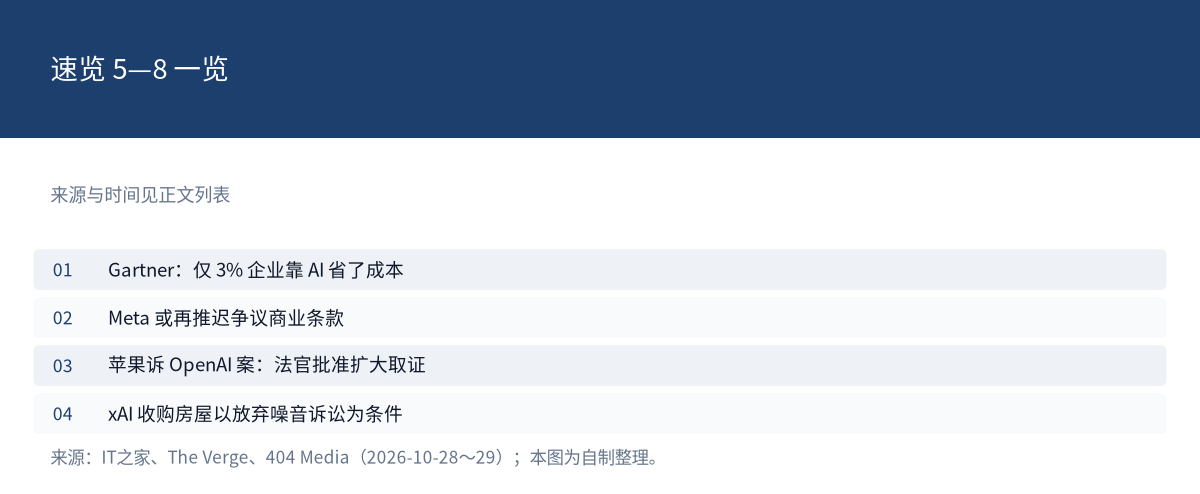
图 13:速览 5—8 一览。来源:各条来源见上方列表;本图为自制整理。
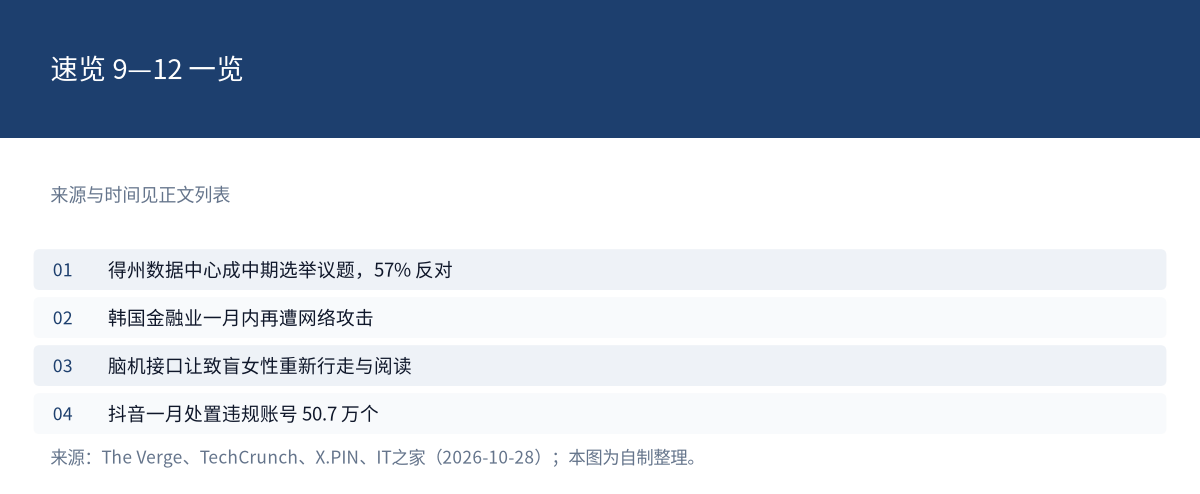
图 14:速览 9—12 一览。来源:各条来源见上方列表;本图为自制整理。
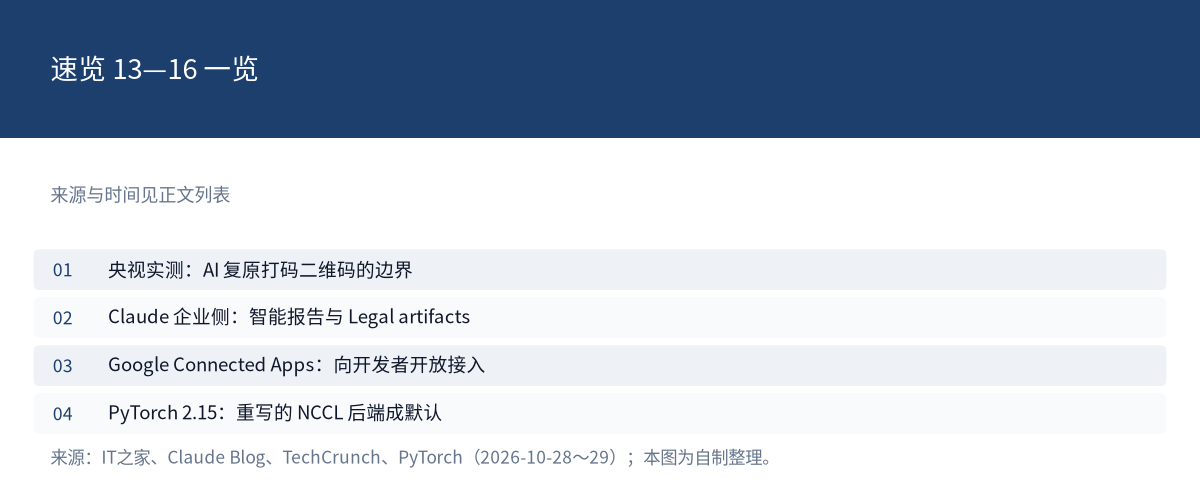
图 15:速览 13—16 一览。来源:各条来源见上方列表;本图为自制整理。
 积木观察
今天两条最重要的信息,其实是在教人怎么读数字。
一条是 AA 换题:60% 权重建在私有数据集上,开源与榜首的差距从 3 分拉到 12 分——同一批模型,排名变了,能力没变。另一条是 GitHub 的遥测:四成 PR 由智能体起草,但多数行业里智能体开的 PR 不足 3%——总量在涨,分布极不均匀。
把这两条和头条放一起看:Carbon 的 59 分之所以值得写,恰恰是因为它同时承认了输掉的两项。一个榜单换了尺子、一份数据摊开了分布、一个模型标出了短板,三者都在同一件事上较真。
给读者一条:看到「登顶」「第一」,先问三句——哪个榜、什么口径、有没有同批对照。
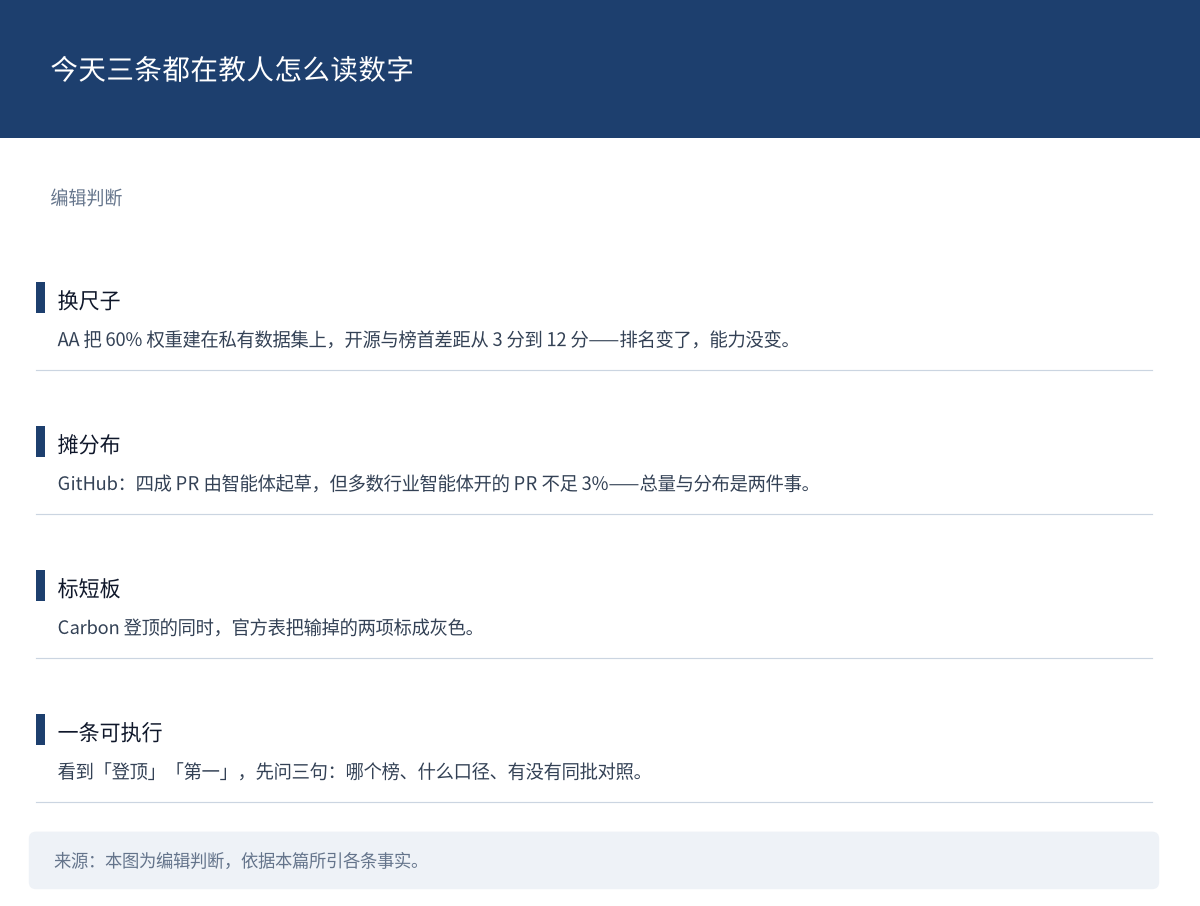
图 16:今天三条都在教人怎么读数字。来源:本图为编辑判断,自制整理。
结尾互动
如果你只能看一个数字来判断一个模型,你会选总分、某个单项,还是每任务成本?