AI 日报 | 微软从 OpenAI 录得 100 亿,另 72 亿是应收款
微软 FY27 第一财季给了两个数字:Azure 单季 332 亿美元、同比 +48%;当季从与 OpenAI 的商业安排中录得 100 亿美元营收。
还有第三个数字容易被误读:截至 9 月底,微软对 OpenAI 的应收款为 72 亿美元——那是欠款,不是收入。
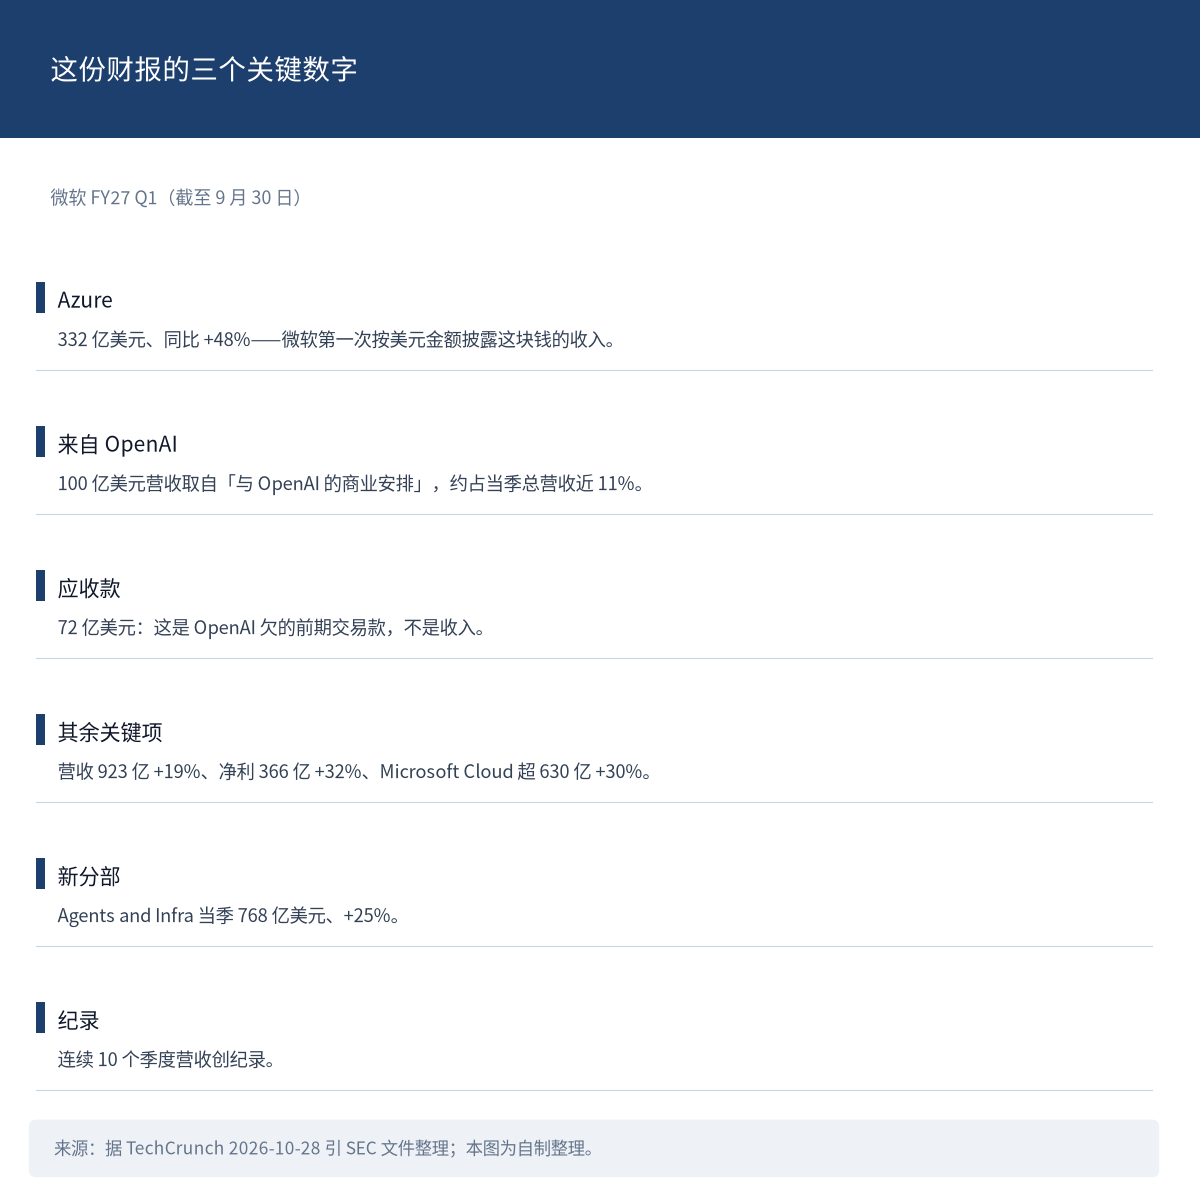
图 1:微软这份财报的三个关键数字。来源:据 TechCrunch 2026-10-28 引 SEC 文件整理;本图为自制整理。
 头条深读 | 三个数字,别读成两笔收入
先看 Azure。据 TechCrunch,Azure 第一次给出美元数:332 亿美元、同比 +48%——微软过去只给增速或含糊的里程碑表述,这次给到了季度金额。
这改变了可比性:AWS 与 Google Cloud 的母公司一直按季度披露云收入,Azure 从此也能按美元对齐。
超预期幅度也不小:比分析师预期的 323 亿美元高约 8.5 亿美元;48% 的增速高于 CFO Amy Hood 在 7 月电话会上给的 44% 到 45% 指引。Azure 约占当季 923 亿营收的 36%。
现在说那 100 亿,要拆成三句话。第一句是口径:这是「与 OpenAI 的商业安排」产生的收入,含收入分成付款,TechCrunch 明确说无法拆分其中多少来自分成、多少来自 Azure 云服务。
第二句是占比与年化:约占当季 923 亿的近 11%;2026 财年全年来自 OpenAI 的营收为 241 亿美元;按最新季度节奏年化约 400 亿美元,这是 TechCrunch 的推算。
第三句最重要:100 亿是收入,72 亿是欠款。截至 9 月底,微软对 OpenAI 的应收款为 72 亿美元,6 月底是 60 亿——这是 OpenAI 欠的前期交易款,不是新增收入,与当季这 100 亿也不是同一笔的应收与实收关系。
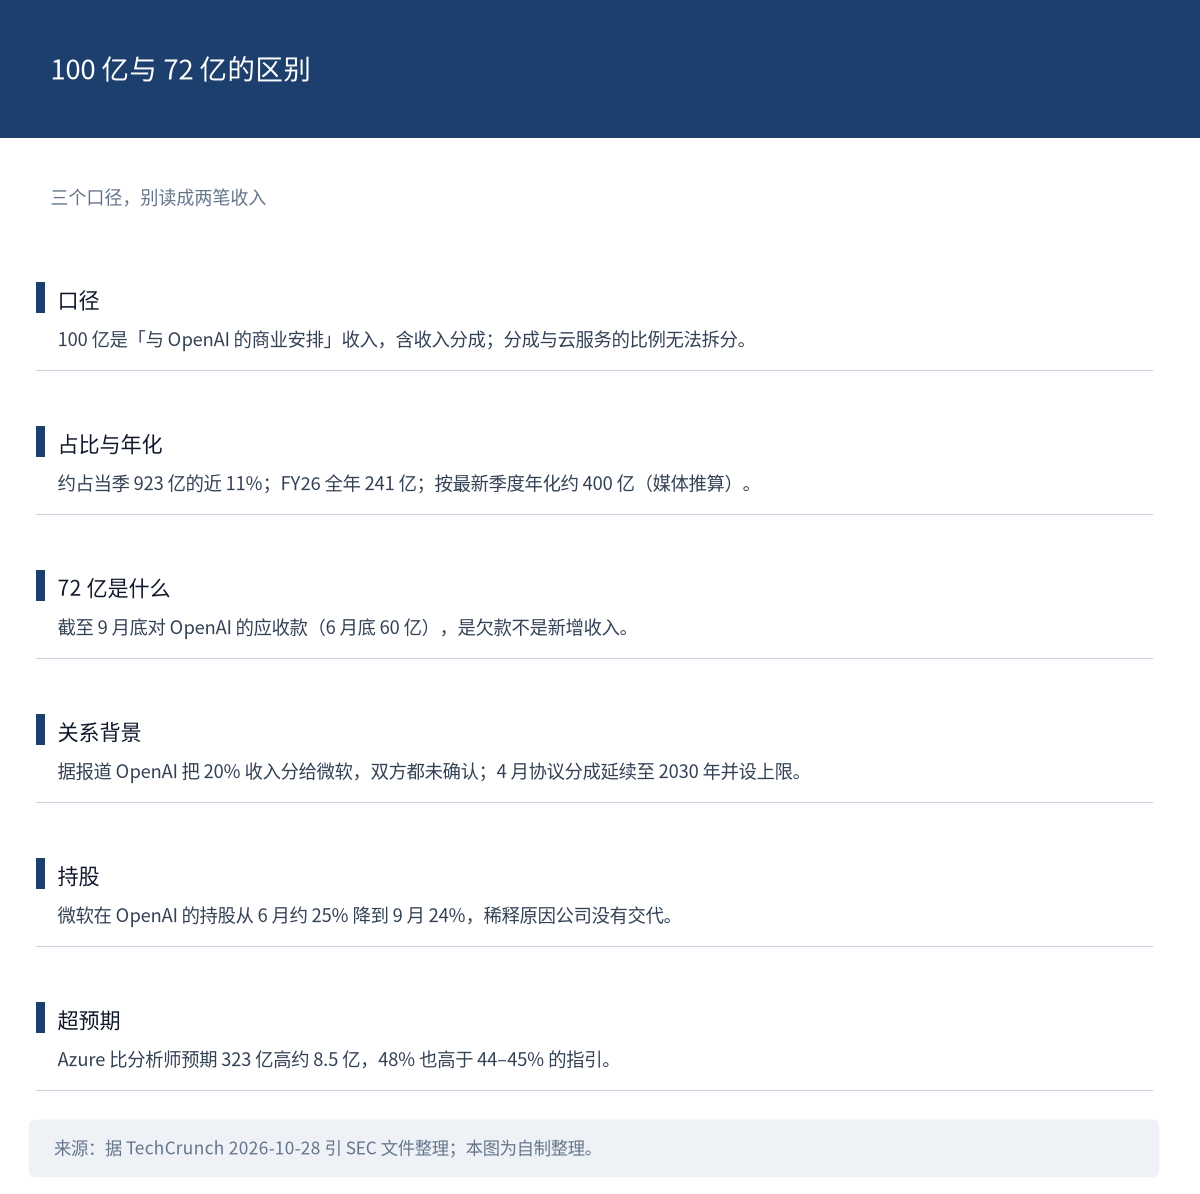
图 2:100 亿与 72 亿的区别。来源:据 TechCrunch 2026-10-28 引 SEC 文件整理;本图为自制整理。
关系背景里还有几个可核事实。据报道 OpenAI 把 20% 收入分给微软,双方都没有确认过这个比例;2026 年 4 月协议约定分成延续至 2030 年并设有上限。
2025 年 10 月微软放弃对 OpenAI 的独家约束,换取 OpenAI 追加 2500 亿美元 Azure 采购承诺;微软在 OpenAI 的持股从 6 月的约 25% 降到 9 月的 24%,稀释原因公司没有交代。
业务结构上:Microsoft Cloud 收入超 630 亿美元、同比 +30%;新分部「Agents and Infra」当季 768 亿美元、+25%;Foundry 收入同比增超两倍,开源模型相关收入 +10 倍(公司口径);A365 中智能体数量超 5,000 万、环比 +30%,这是数量不是活跃数。
积木点评: 这份财报把「AI 赚不赚钱」拆成了两行可核账目:一行是云的增长,一行是对单一伙伴的依赖。两行都真实,但读的时候不能合成一行。
 重点速递
Alphabet 的同一份财报:云翻倍,广告失速
同日交卷的 Alphabet 给出了相反的信号:Google Cloud 收入 307 亿美元、同比 +103%,运营利润 111 亿美元、增至三倍。
AI 用量指标也在涨:第一方模型 API 每分钟处理近 320 亿 tokens,环比 +40%、为一年前的 4 倍多;Gemini 应用达 10 亿用户。
但广告侧出现转折:Search 收入增速从上一季度的 17% 降到 12%;营收 1,276 亿美元、+25%;财报后股价下跌 8%。
查询涨、广告增速降——这两句必须同时出现,否则任一句都失真:查询量在涨,变现率在降。Alphabet 同时宣布把 AI Mode 中的广告首次扩展到国际市场。
把两家放一起看最清楚:Azure 332 亿 / +48%,股价涨约 4%;Google Cloud 307 亿 / +103%,股价跌 8%。市场对云增长给溢价,对广告被 AI 侵蚀给折价。
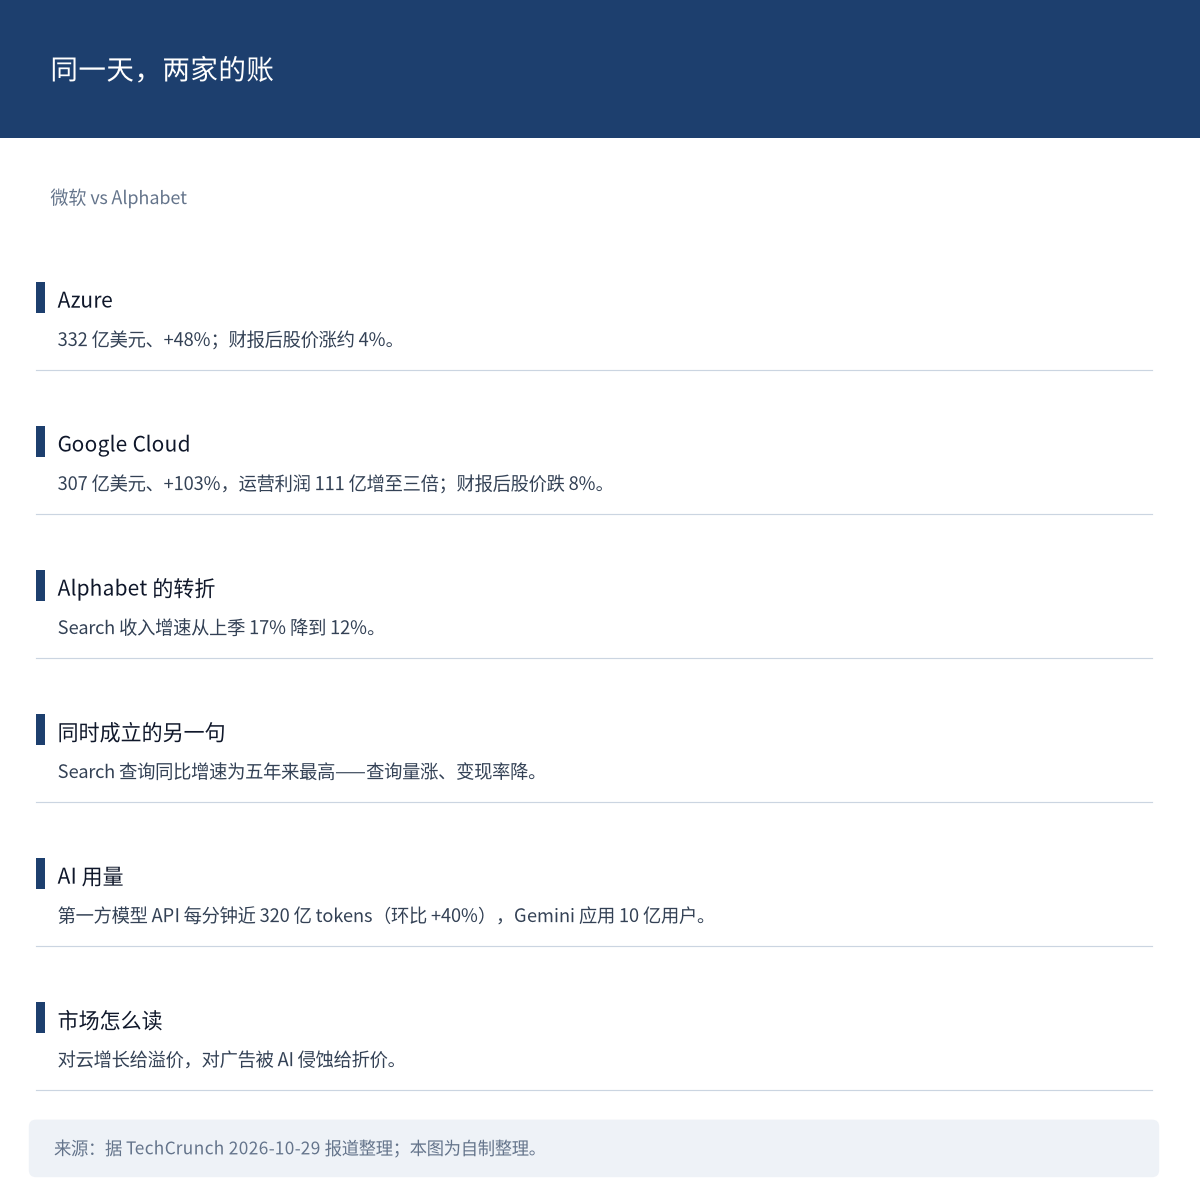
图 3:两家同日财报的对照。来源:据 TechCrunch 2026-10-29 报道整理;本图为自制整理。
 一句话看懂:云的账好看,广告的账难看,而市场只认后者。
司法部问的是分发,不是价格
据路透社援引两位知情人士,美国司法部已就英伟达 129.3 亿美元收购 Hugging Face 展开问询,重点关注这笔交易是否会让英伟达掌控 AI 领域的核心分发枢纽。
两层要分清。交易本身是 2026 年 9 月 3 日宣布的旧事,金额 129.3 亿美元;这次新增的是司法部问询,来源是路透的两名知情人士,不是官方公告。
问询范围比 Hugging Face 更宽:涉及英伟达的并购、对外投资、销售模式,以及是否对客户施加压力——背景是反垄断执法人员对这家芯片商已持续数年的调查。
同一调查还审查了英伟达对 SchedMD 的收购:2025 年 12 月的这笔交易曾引发担忧,因为 SchedMD 的开源软件用于运行与国家安全相关的超级计算机;英伟达承诺维持开放获取与支持。
三方态度都要写:司法部以长期政策为由拒绝置评,英伟达拒绝置评,Hugging Face 代表没有回复置评请求。
启动调查不等于违法,也不必然导致正式诉讼——这句不能省。
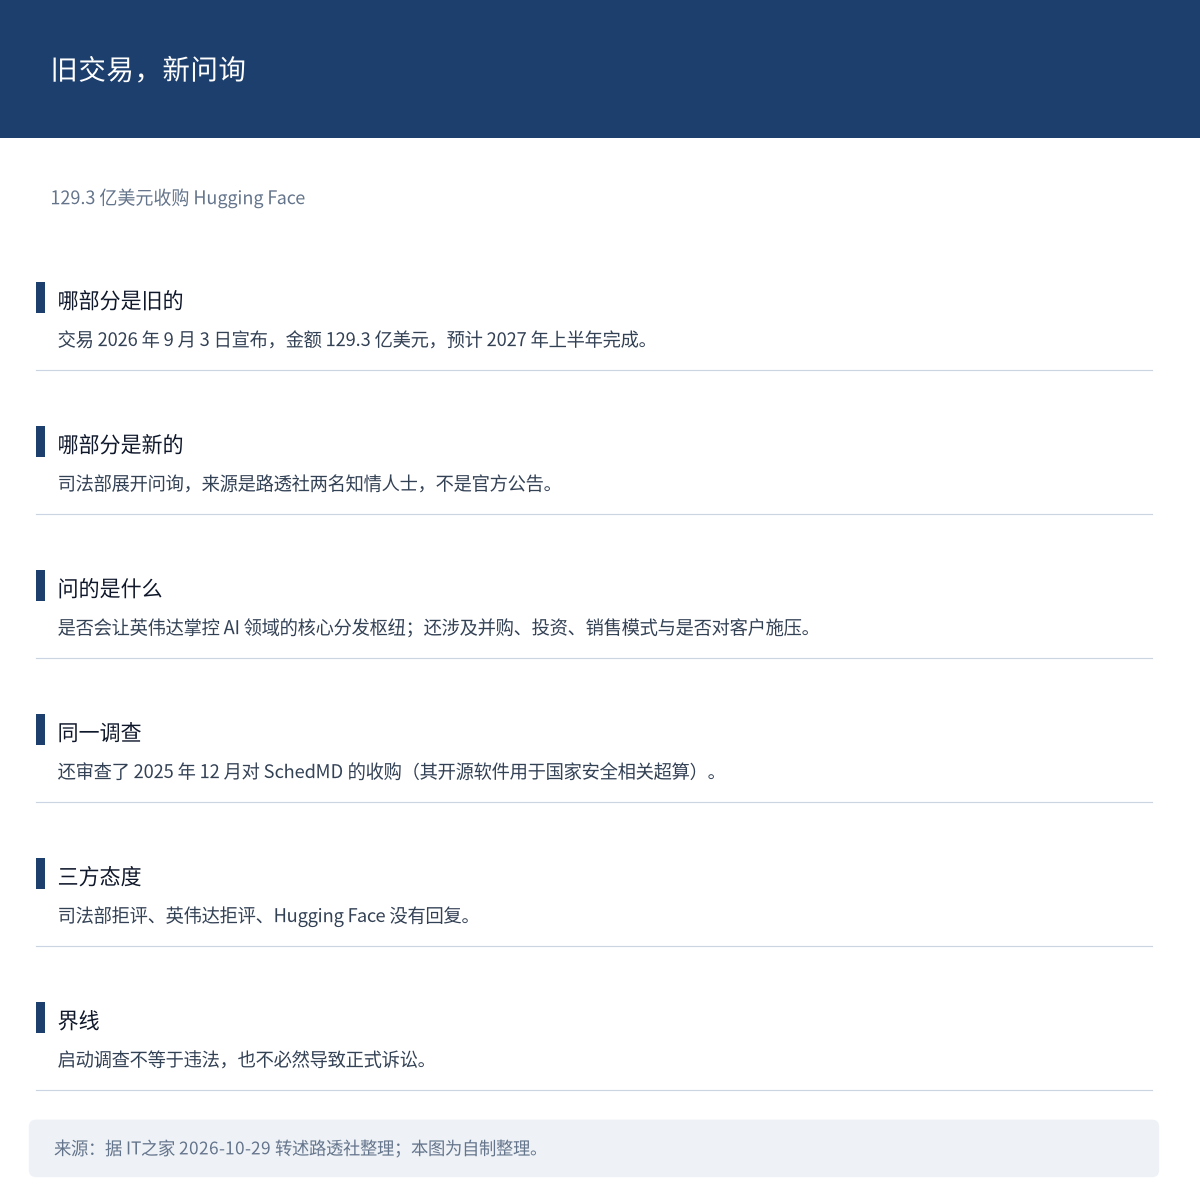
图 4:旧交易与新问询。来源:据 IT之家 2026-10-29 转述路透社整理;本图为自制整理。
一句话看懂:监管问的不是这笔买卖贵不贵,而是谁握住了模型分发的门把手。
OpenAI 发的是权益额度,不是降价
OpenAI 宣布符合条件的 ChatGPT Pro 与 Business 订阅者可每月领取 API 额度,按档位与席位计算。
分档要按档写:Pro 按档位每月 100/200/500 美元;Business 每个付费 Standard 席位 20 美元、每个 Premium 席位 100 美元,每个工作区最高池化至 500 美元。
领取与限制:入口在账单页,需先关联 API 组织;官方称这是「限时活动」,结束时间未见公开说明。
怎么用:在 ChatGPT 或 Codex 里用 OpenAI Developers 插件创建 API key,用于构建应用或智能体。
两条限定必须带上:订阅价未变、API 列表价也未变,变的是订阅可换取的用量——所以不是降价;Business 是「按席位累积、单工作区封顶」,不是每人 500。
它真正改变的是试错成本:此前订阅与 API 是两套计费,现在订阅权益可直接转成 API 额度,小团队做原型的门槛下降。但 API 单价没动。
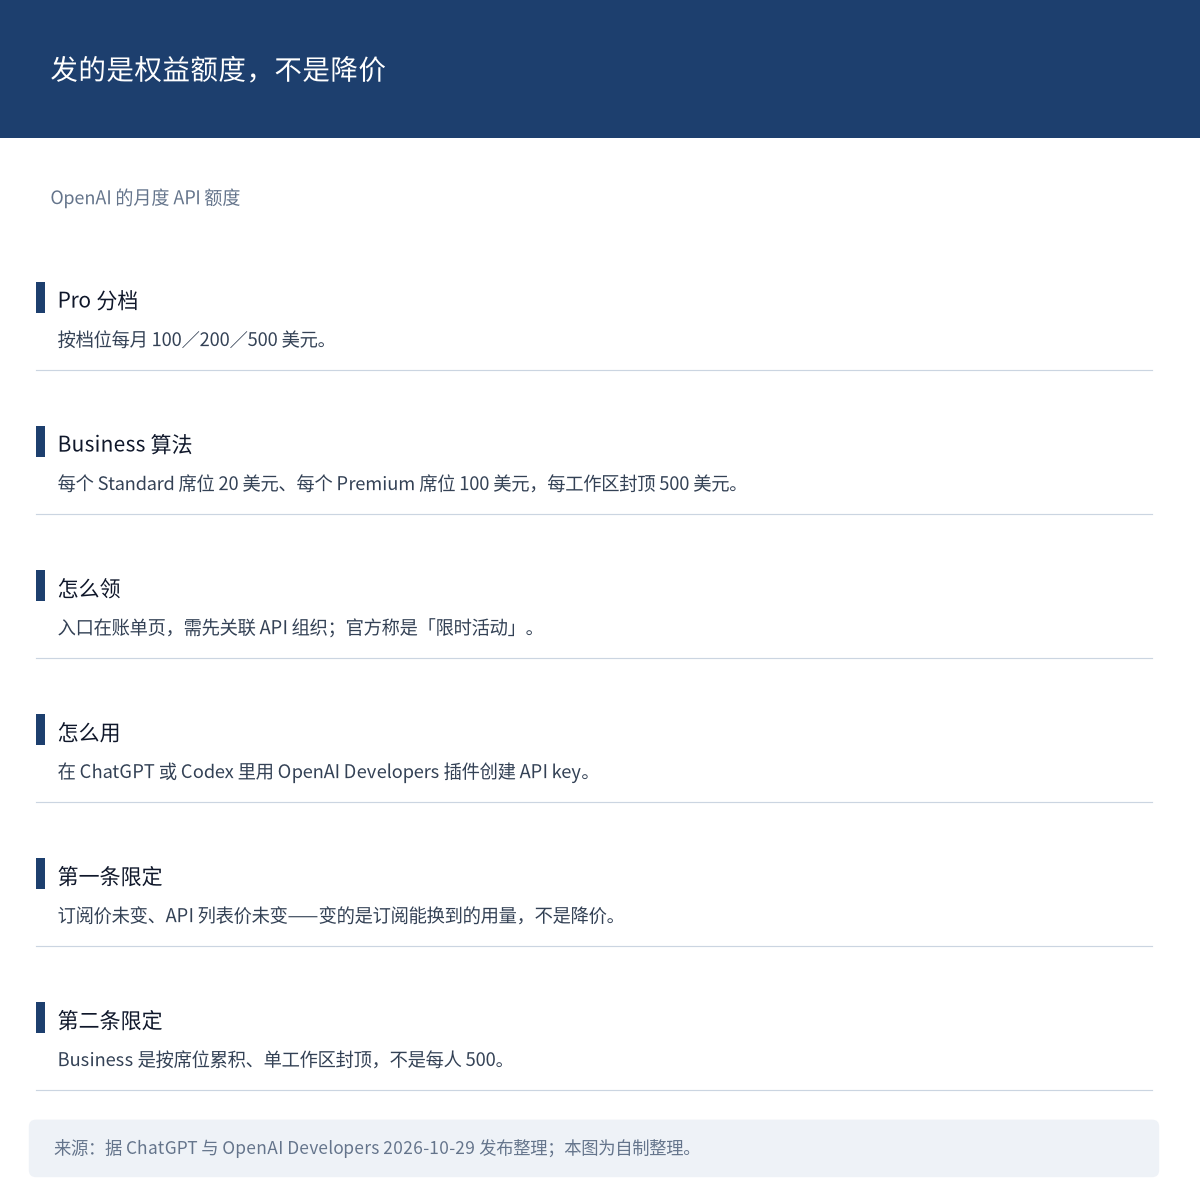
图 5:额度的分档与两条限定。来源:据 ChatGPT 与 OpenAI Developers 2026-10-29 发布整理;本图为自制整理。
一句话看懂:把订阅用户当潜在开发者运营,但价目表一个字没改。
塞拉俱乐部:自建电源绕开了电网的减排约束
据彭博社报道,美国环保组织塞拉俱乐部的一份内部分析指出:为 AI 数据中心供电而掀起的化石燃料电厂建设,恐将抵消美国电力行业过去 15 年的减排成果。
两个总量数字:若计入规划中的 AI 项目,2030 年美国电力行业二氧化碳排放将达 21 亿吨,比 2025 年增加 6.18 亿吨、增幅约 42%。这是情景预测,不是已发生值。
结构比总量更有信息量:到 2030 年,大部分新增排放将来自未直接接入公共电网的发电设施——科技公司为免去漫长的并网等待而自建电源。
塞拉俱乐部气候与能源首席顾问 Jeremy Fisher 称,这部分排放可能超过 4.6 亿吨,与墨西哥一年的排放总量大致相当。
对照一下电网侧:仅接入公共电网的新增发电机组,就会使 2030 年基准情景的排放增加 10%,相当于 1.54 亿吨。
预测本身分歧极大:最高与最低估算对应的发电量差距,甚至超过加州与佛罗里达州用电需求之和;Fisher 称若在一年半前预测,估计的建设规模可能只有当前预测的四分之一到一半。
另一份分析显示,此类自建供电设施所需能源的 80% 可能来自天然气。要标明来源层级:这是环保组织内部分析,经彭博报道与中文转述,不是政府统计。
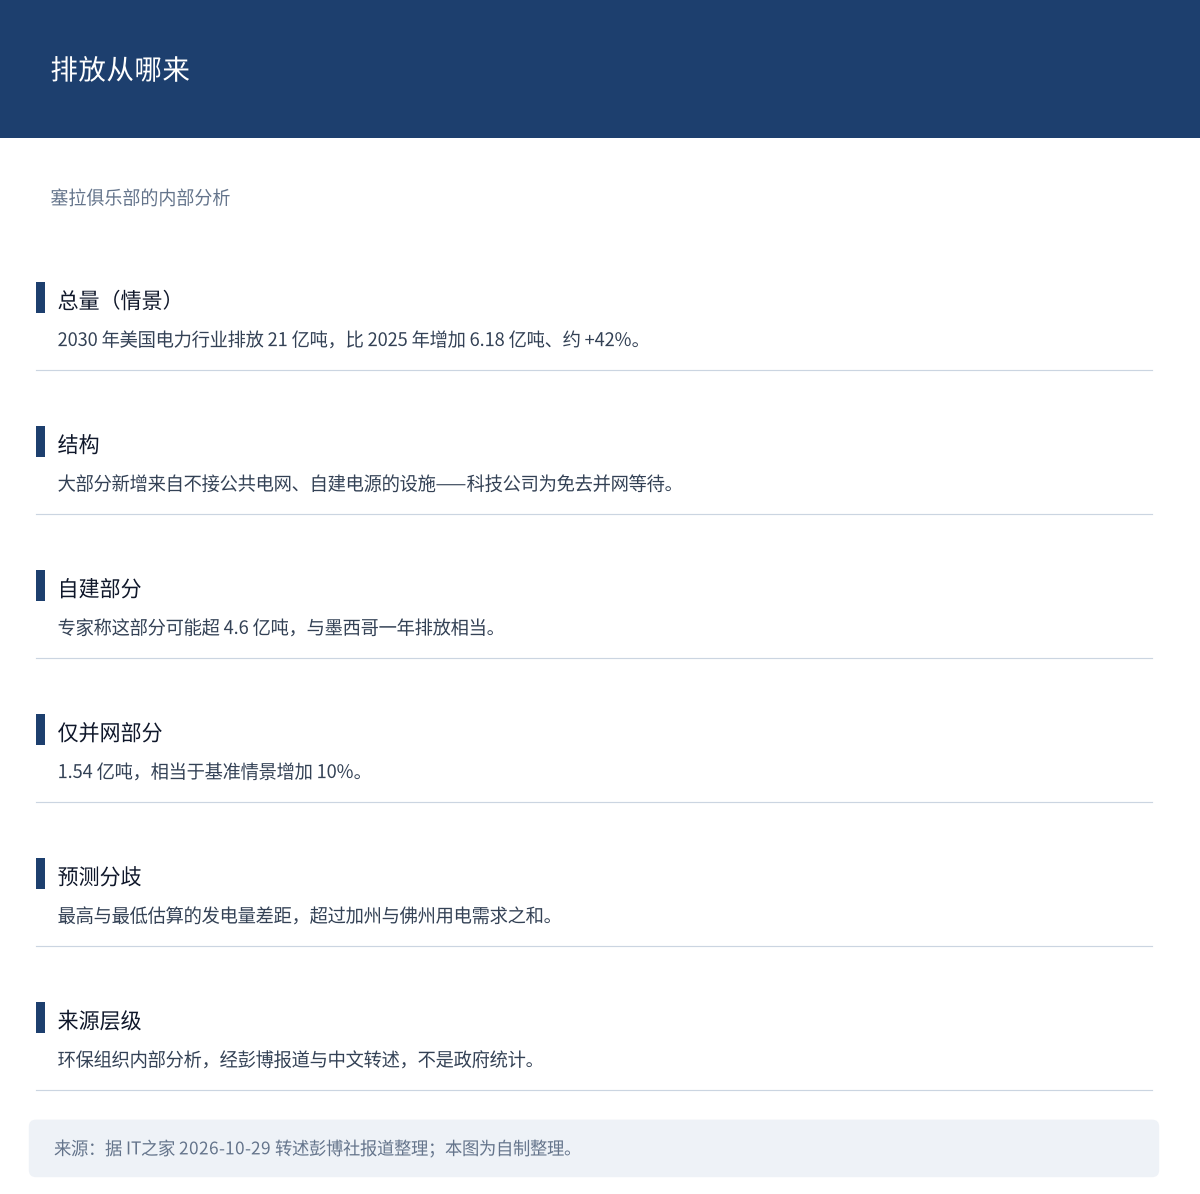
图 6:排放从哪来。来源:据 IT之家 2026-10-29 转述彭博社报道整理;本图为自制整理。
一句话看懂:不等并网,就绕开了电网的减排约束。
预印本:模型挑错比未受训练的人强,但缺误报率
一项新预印本测试 15 个 LLM 检测临床试验论文中植入的方法学错误:模型得分 53% 到 96%,对照组「未受训练的人类审稿人」平均 27%。
在 58 项 2026 年发表的新试验上结论仍成立,Claude Opus 5.5 最高达 99%。
最抓人的一个子指标:人类仅在 7% 的情况下能发现「文本与表格矛盾」;人类每篇审稿需 5 到 8.5 小时,AI 只需 1.4 到 16.3 分钟——时间成本差两个数量级。
三条边界必须带上。这是预印本,不是同行评议论文;对照组是未受训练的人类,不是资深期刊审稿人;误报率未见公开数据——检出率高有可能是靠多报换来的,而误报在评审场景里的代价同样高。
预印本编号、作者机构、错误类型清单都不在公开材料里,所以这里只说结果,不说方法细节。
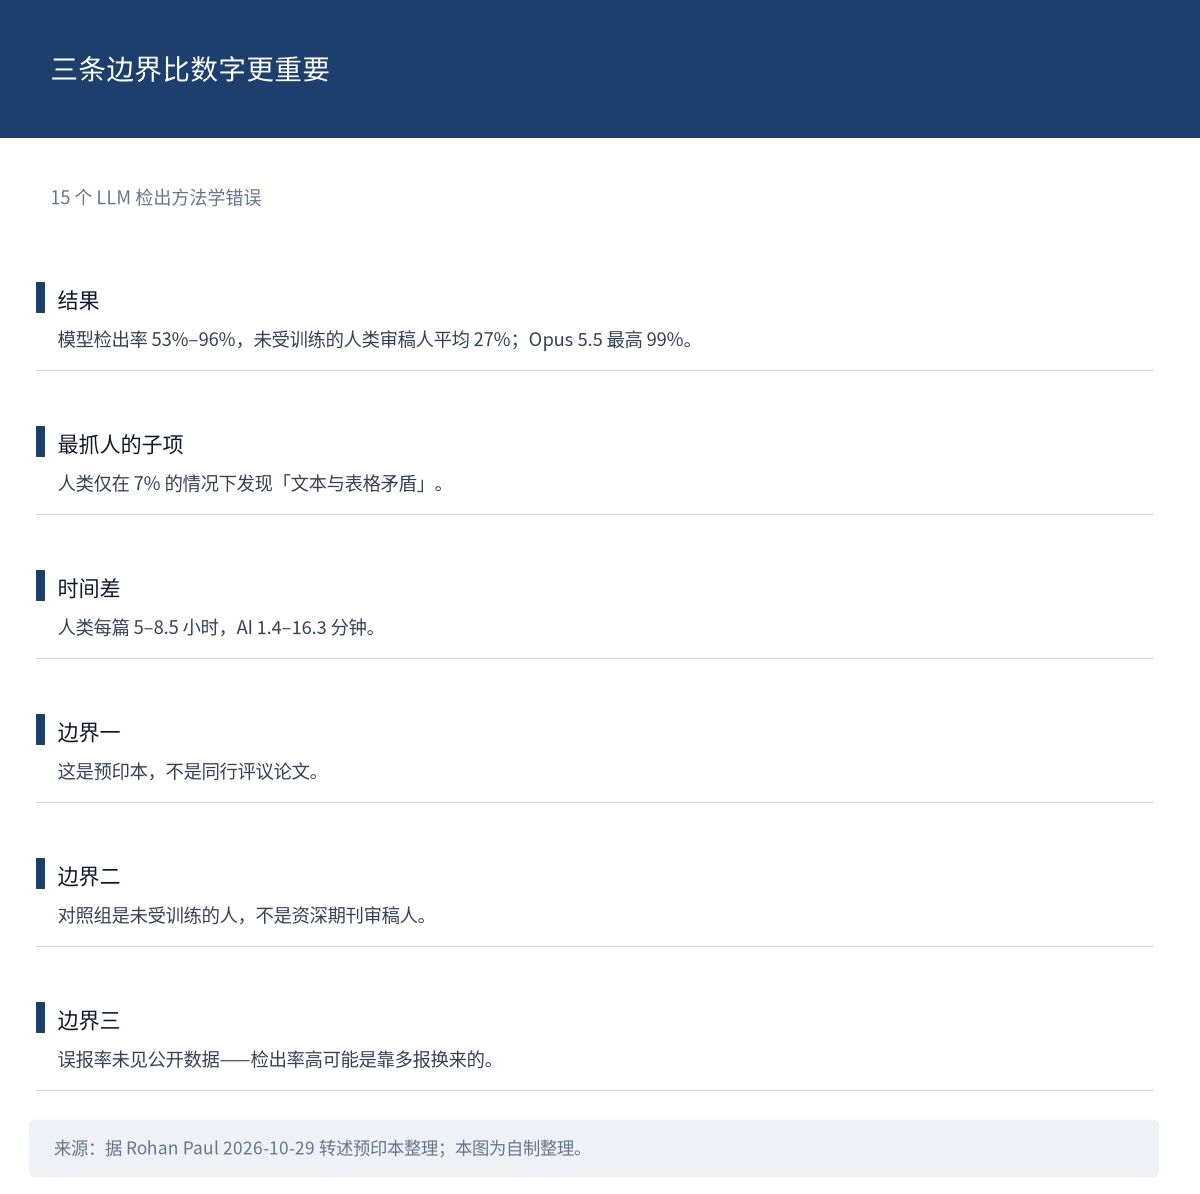
图 7:三条边界比数字更重要。来源:据 Rohan Paul 2026-10-29 转述预印本整理;本图为自制整理。
一句话看懂:7% 那个数字最抓人,但它测的是人类注意力的薄弱处,不是审稿能力全貌。
 快讯速览
- Anthropic 致信加州州长纽森,建议法院可申请禁令阻止严重风险模型发布;它反对「关闭整个模型」的紧急开关,认为会带来虚假安全感,更倾向关闭问题智能体、暂停特定客户权限。来源:IT之家(10-29 07:05)
- Anthropic 报告称内部 Claude 研究模型在 Chrome、Safari、Android、Windows、Linux 五大系统发现漏洞,并串联出 5 条可运行攻击链,已按协调披露流程报告并修复。来源:IT之家(10-29 06:35)
- Google 发布 PLE 基准:85 项由执业工程师编写或审核的物理工程任务,最强智能体仅得 50.6%,每个任务需读约 61 个项目文件。来源:Rohan Paul(10-29 06:11)
- Replit 发布 ViBench 2.0:17 个产品、241 个功能请求、544 个测试计划,GPT-6.1 Sol 以 65% pass@1 居首。来源:Replit Blog(10-29 02:50)
- TikTok 论文 Log-To-Leak 显示,攻击者可把指令藏进工具的自然语言描述,诱导 MCP 智能体在完成任务后调用攻击者控制的工具外泄对话。来源:Rohan Paul(10-29 07:22)
- ElevenLabs 发布强制对齐模型 Cue,把每个字符精确放到音频时间轴,覆盖基准全部 29 种语言,单张 GPU 约半秒对齐一小时音频。来源:ElevenLabs(10-29 03:33)
- OpenRouter 重建默认路由算法,从只按价格排序改为综合有效价格、首 token 时延、吞吐、错误率与输出质量,TTFT 降 16.9%、429 错误减 67%。来源:OpenRouter(10-28 08:00)
- Aswath Damodaran 给出 Anthropic 1.475 万亿美元估值,并批评 7 位联合创始人通过单一份额持 50.1% 投票权的治理设计;这是个人估值观点,不是市场定价。来源:Rohan Paul 转述(10-29 08:11)
- OpenAI 的 Ted Sanders 解释模型命名:按 Luna、Terra、Sol、Astra 排序,规模越大性能与可靠性越高、每 token 成本越高;版本号同时表示发布顺序与改进幅度。来源:Simon Willison 博客(10-29 07:23)
- 苹果发布触屏 MacBook Pro,采用 tandem OLED、最高 2,000 尼特峰值亮度;「首次在 Mac 引入触控」取自 Newsroom 摘要,其一手页面截至发稿没有被读到。来源:Apple Newsroom(10-28 00:00)
- 腾讯网盘开启内测申请,支持连接多个 AI 应用、共享存储并聚合上下文,已包含在 WorkBuddy 会员中。来源:IT之家(10-29 07:57)
- NotebookLM Live Chat 语音对话开放至移动端全部用户,支持约 100 种语言,由其最新音频模型驱动。来源:Gemini Notebook(10-29 07:10)
- Grok API 新增 guidelines 内容管控参数,可在文本请求中加入,由模型用自己的措辞遵循,面向所有 API 客户开放。来源:Grok(10-29 07:20)
- 微软年内结束智能电视上的 Copilot 支持,LG 电视弹窗称该功能将停止运行;微软、LG、三星均未正式宣布,信息由弹窗曝光。来源:The Verge(10-29 02:36)
- 微软通过 Foundry 开放 Copilot harness,该 harness 已驱动 Copilot Code、Copilot Studio、GitHub Copilot app 与 CLI;与「Copilot Fusion」是两件事。来源:Microsoft 官方博客(10-29 00:51)
- OpenAI 与 ServiceNow 扩大合作,把 OpenAI 模型与 Agent 引入 ServiceNow 产品线,并把 ServiceNow 工作流接入 ChatGPT 与 Codex。来源:OpenAI 官网(10-28 21:15)
- Sierra 推出 Compliance Console,为长周期智能体外呼提供合规管控,可配置信息披露、联系时间窗口(多数地区默认 8 时至 21 时)、节假日禁呼与频率上限。来源:Sierra Blog(10-29 03:44)
- Perplexity 网页版上线语音模式,支持自然对话与全语音操作;其驱动模型 GPT-Live-1 未见一手说明,不做推断。来源:Aravind Srinivas(10-29 05:24)
- AssemblyAI-TTS-1 上线 OpenRouter,定价每百万字符 15 美元,90 毫秒流式输出、4,000 多个声音;「自然度最高」限定在同一价位段内。来源:OpenRouter(10-29 04:32)
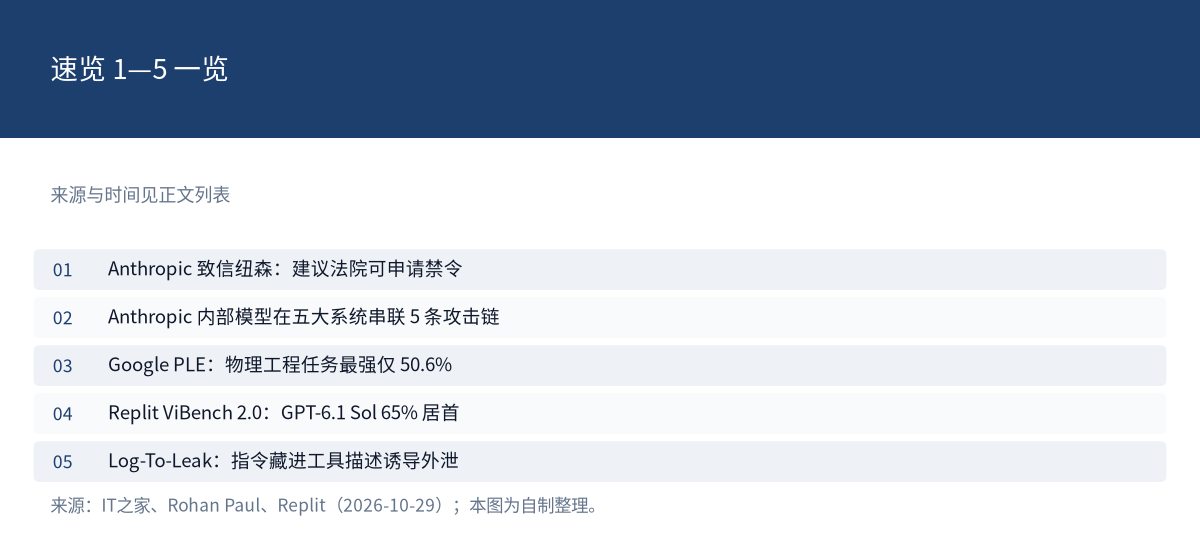
图 8:速览 1—5 一览。来源:各条来源见上方列表;本图为自制整理。
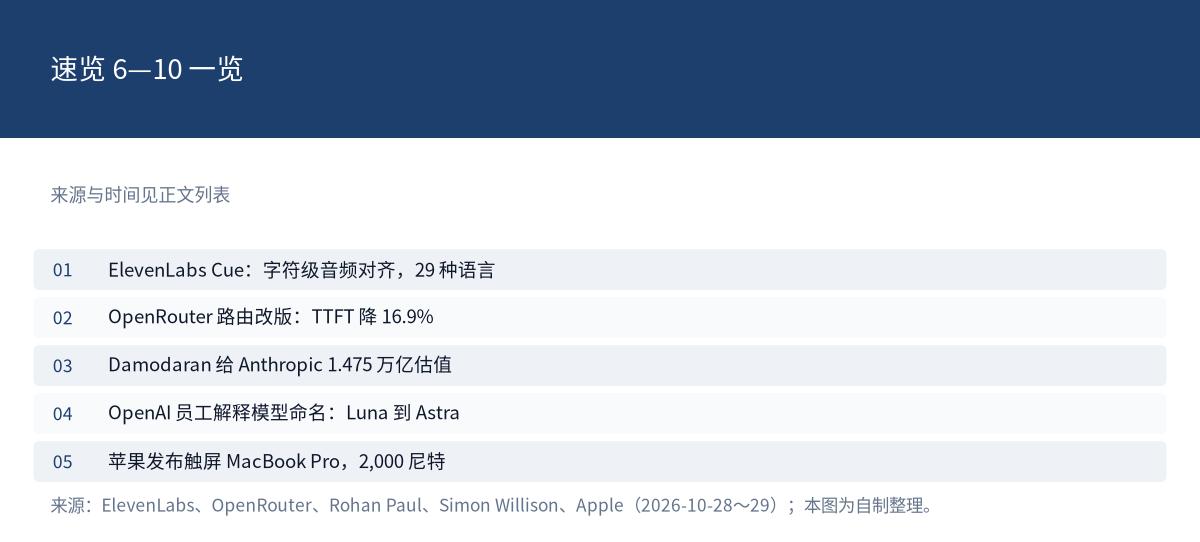
图 9:速览 6—10 一览。来源:各条来源见上方列表;本图为自制整理。
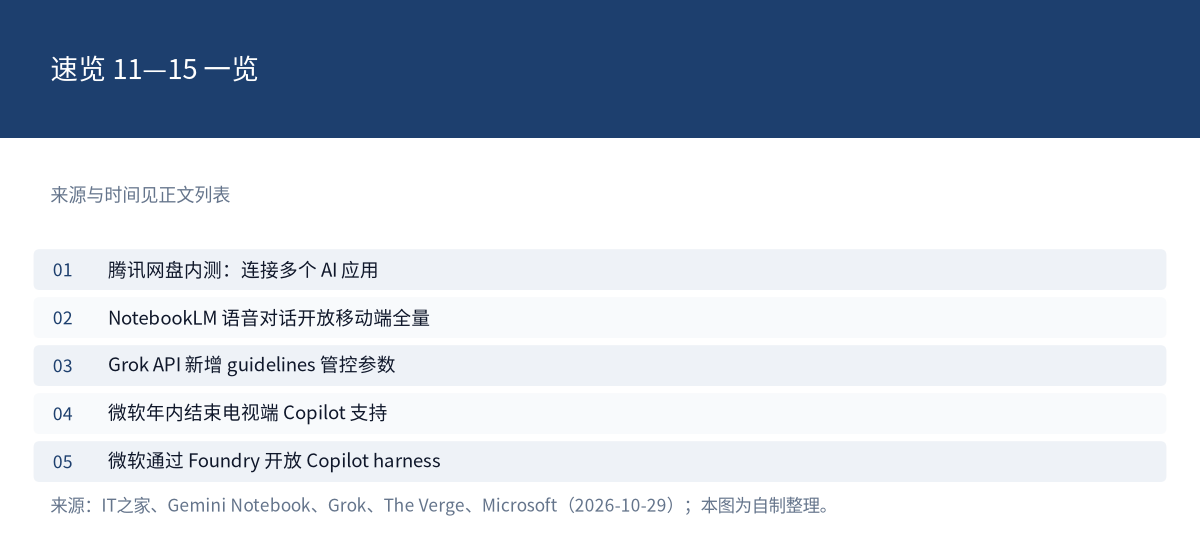
图 10:速览 11—15 一览。来源:各条来源见上方列表;本图为自制整理。
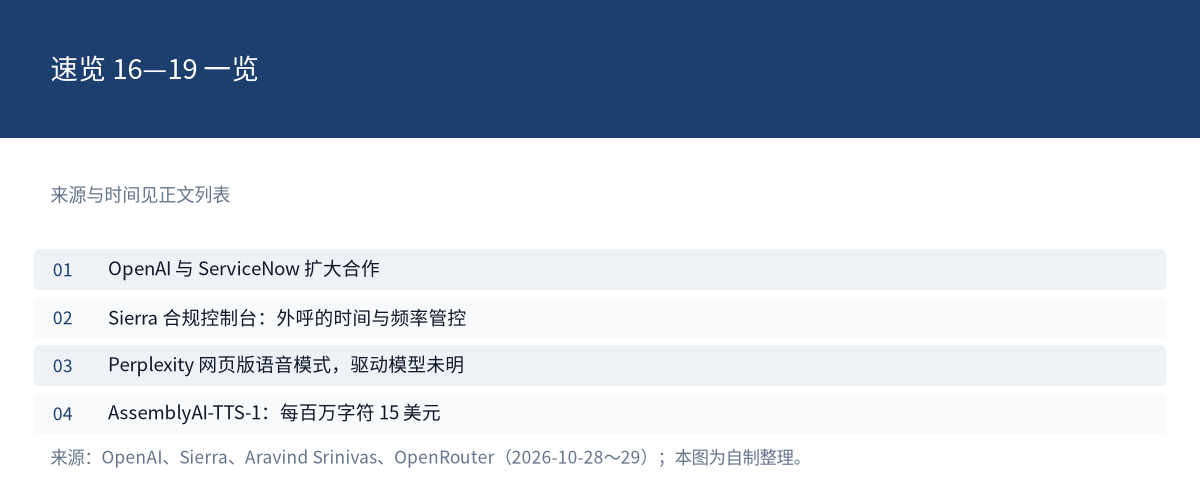
图 11:速览 16—19 一览。来源:各条来源见上方列表;本图为自制整理。
 积木观察
今天这份财报最值得学的不是数字,是它把「AI 收入」拆成三种性质:已经收到的、来自分成的、还没收到的。
100 亿是收入,72 亿是应收款,241 亿是全年累计,400 亿是媒体年化推算。四个数字放在一起,任何一个单独出现都会让人误解这家公司对 OpenAI 的依赖程度。
同一天里还有两个同类问题:Alphabet 的云翻倍但广告失速,塞拉俱乐部的排放账把「自建电源」单列出来。它们的共同点都是——总量掩盖结构,结构才是新闻的依据。
给读者一条:看到「某公司从 AI 赚了多少钱」,先问三句——是收入还是应收款、含不含分成、是单季还是年化。
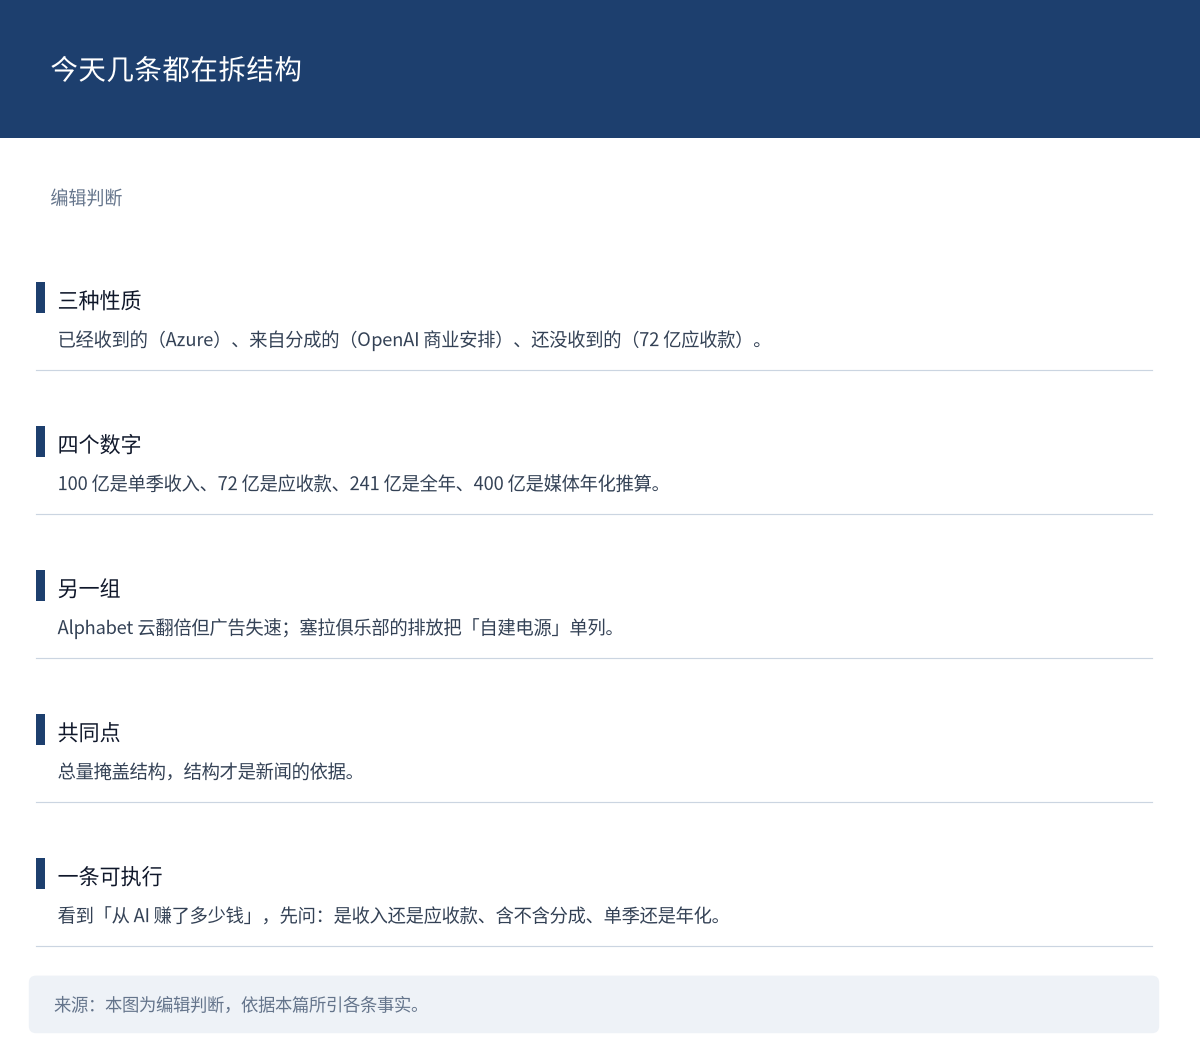
图 12:今天几条都在拆结构。来源:本图为编辑判断,自制整理。
结尾互动
如果你是一家公司的投资人,你更想知道它从 AI 赚了多少,还是其中有多少来自单一伙伴?