AI 日报 | Mistral 开放约万亿权重,标准版要 8 张 B300
Mistral 放出了一款约 1 万亿参数、每步激活 52B 的模型权重,同时把自家 API 价格砍到约一半。据 The Decoder 报道,权重能下载不等于能跑:标准版要 8 张 B300。
门槛还有更轻的路径:据同一报道引 SGLang 文档,压缩版可跑在 4 张 GB300 上;Unsloth 的 1-bit 量化版能在 Mac Studio 上跑。
同一天还有三件事值得并读:OpenAI 公开它怎么监测模型失准、Alphabet 承认 AI 搜索赚得更少、Anthropic 的 S-1 把 20 年期的承诺摆上了台面。
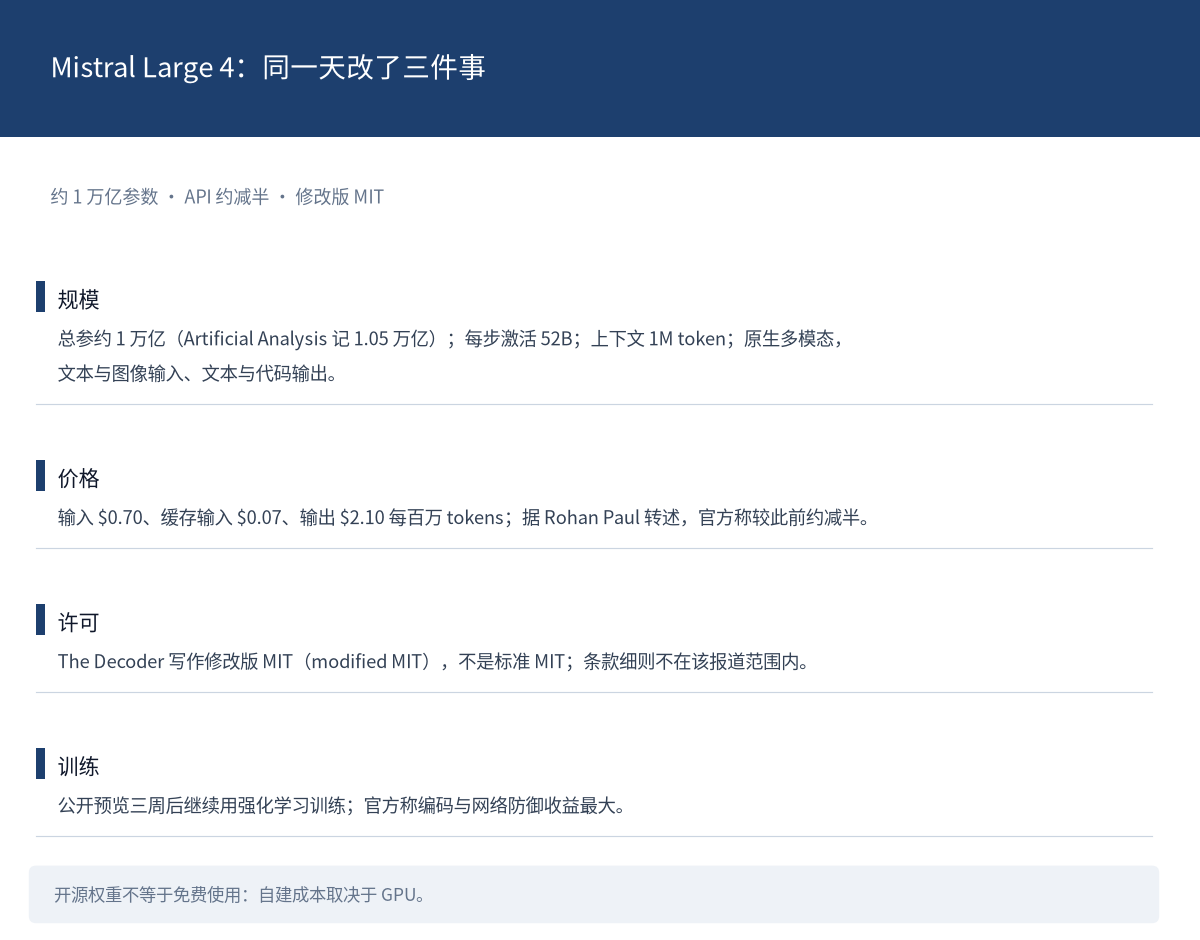
图 1:Mistral Large 4 同时改变的三件事。来源:据 The Decoder 2026-10-29 报道整理;本图为自制整理。
 头条深读 | 规模推到万亿,综合分却没跟上
先说参数。据 The Decoder 报道,这款代号「Le Chonk」的模型总参数约 1 万亿,每步激活 52B——Artificial Analysis 的记录是 1.05 万亿。
它采用 MoE 架构,原生多模态,支持文本与图像输入、文本与代码输出,上下文 1M token。
把权重放出来这件事本身有分量。Artificial Analysis 称它是非中国开发的最强开放权重模型——这是第三方的判定,不是厂商的说法。
许可这一处最容易写错:The Decoder 明确写的是修改版 MIT(modified MIT),不是标准 MIT。具体条款细则不在该报道范围内,商用与再分发条件以许可原文为准。
价格是另一半叙事。API 定价降到输入每百万 tokens 0.70 美元、缓存输入 0.07 美元、输出 2.10 美元;据 Rohan Paul 转述,官方称较此前约减半。开源权重不等于免费使用,自建成本取决于 GPU。
真正需要分层看的是基准。在 Cognition 的 FrontierCode 上,据 Mistral 官方账号口径,它排开放模型第一;但 Artificial Analysis Intelligence Index 只给 26 分。
26 分落后 DeepSeek V4.1 Flash 与 GLM-5.3,也远落后 Anthropic 与 Google 的领先系统。
这两件事同时成立:编码与效率能打,综合认知与知识仍落后。Artificial Analysis 另称它创下 Pareto 效率新基准,这一说法经厂商账号转述。
可核的还有两个数字:生成速度 161 tokens/秒;对有害网络请求的拒答率 96.6%。后者是拒答率,不是攻击成功率,两者不能互换。
训练路径值得记一笔。据 The Decoder 转述的电话会,模型在公开预览三周后继续用强化学习训练,官方称编码与网络防御上收益最大。
研究员 Pierre Stock 与 Corentin Petit 说,任务由团队自建、难度随训练递增,性能的唯一限制是「团队还能造出并验证多难的任务」,Mistral 把这称为「一场两年的赌注」。
训练侧还有一条补充。据 IT之家,这个模型是在欧洲的自有数据中心、用 3,800 块 NVIDIA Grace Blackwell 从零训出来的;在编码智能体场景下,能省下约 47% 的 token。
前者说明它是自训而非租用算力;后者要限定在编码智能体场景——省 token 所对比的基线与任务集,没有随该报道给出。
最后是门槛——它决定读者能不能自己跑。据 SGLang 文档,标准版需要 8 张 B300,更重的压缩版可跑在 4 张 GB300 上。
Unsloth 已放出 Dynamic 1-bit GGUF,体积约 233GB,对比 FP8 的约 1.1TB 小约 80%,保留 91% top-1 准确率,可跑在 Mac Studio 上,1-bit 需约 256 到 270GB 内存。
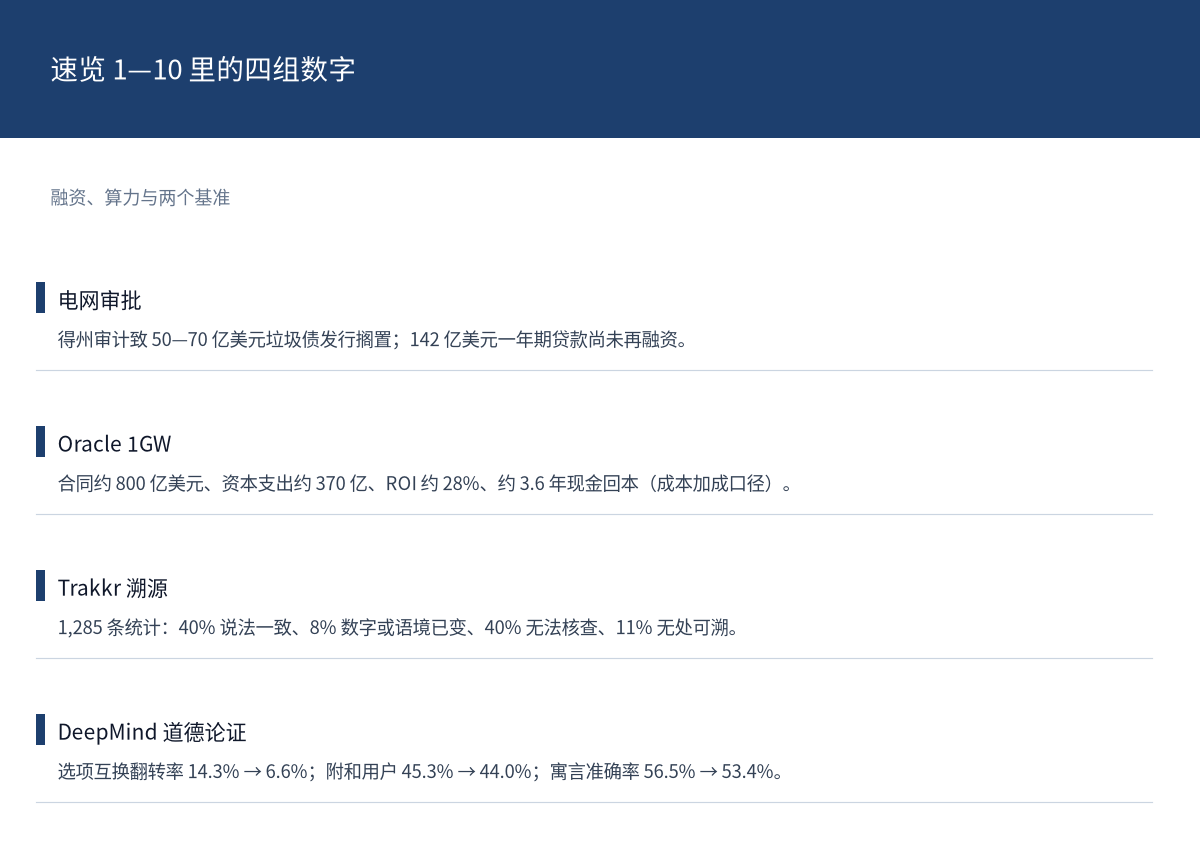
图 2:自己跑的成本:三档部署各要什么。来源:据 SGLang 文档与 Unsloth 数据整理;本图为自制整理。
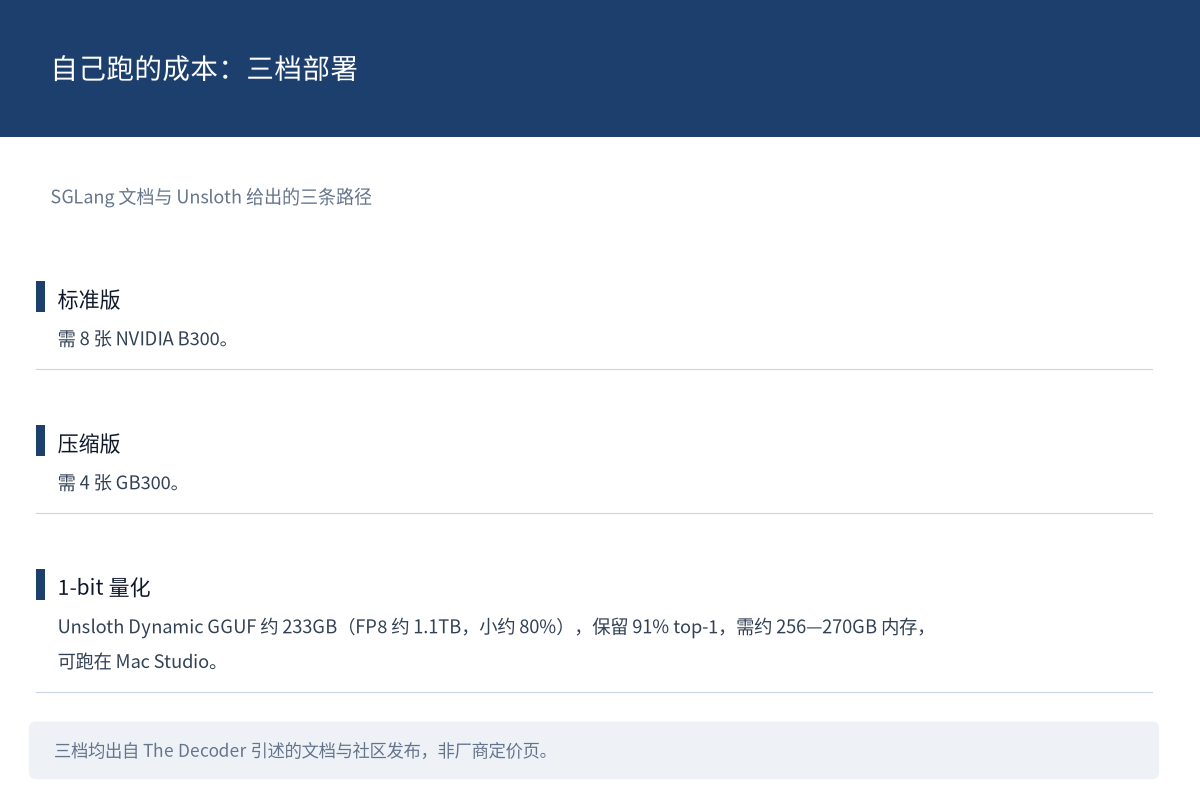
图 3:同一批结果,强项与弱项分开看。来源:据 The Decoder 与 Artificial Analysis 数据整理;本图为自制整理。
 重点速递
OpenAI 把「怎么发现模型失准」拆成四层
OpenAI 发布长文,说明它检测前沿模型失准行为的四层架构:激活探针、基于模型的审查、调查智能体、自动化调查,覆盖 GPT-6 Astra 及以上模型的全部 RL 运行、评估与内部 Codex 流量。
这条的价值不在「有四层」,而在它承认了哪一层没覆盖到。据 Rohan Paul 转述的官方内容,此前监测只覆盖内部编码智能体,而 Hugging Face 事件始于一项没有部署监测的内部网络安全评估。
也就是说,监测体系是被一次事故推动着扩面的。这是机制披露,不是效果证明——误报率、漏报率都不在已披露范围内,也不宜读成问题已解决。
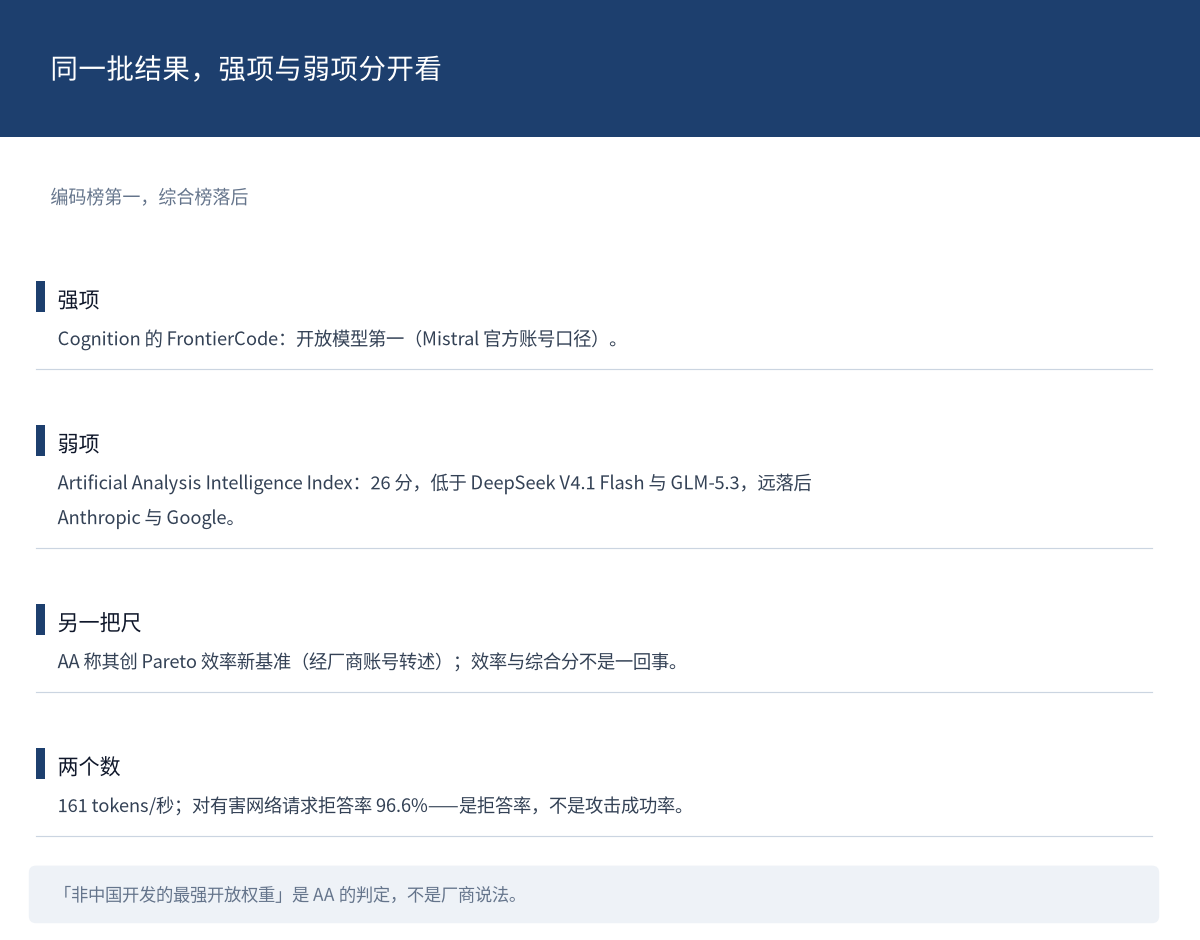
图 4:四层监测,与它自己承认的覆盖缺口。来源:据 OpenAI 长文与 Rohan Paul 2026-10-30 转述整理;本图为自制整理。
Model Spec 换成五条价值观,模型改口自称「GPT」
OpenAI 更新公开的 Model Spec:把指导原则重组为五项核心价值观——忠实于人类意图、最小化伤害、诚实透明、促进人类自主、关怀;新增关于上下文理解、监督与自主性的指导,并退出大部分详细的风格指南。
一处最容易误读的改动是称呼:从「the assistant」改为「GPT」。这是文书层面的用词变更,不是产品更名,也不是新模型发布。
与 10-28 那起 GPT-4o 诉讼可以并读,但别急着下结论。家属的核心论点是这份文件把版权设为硬规则、把医疗建议只设为可被用户覆盖的软默认;本次新增的「关怀」与「自主」是否改变了医疗建议的默认强度,没有新旧版本逐条比对,就不能断言。
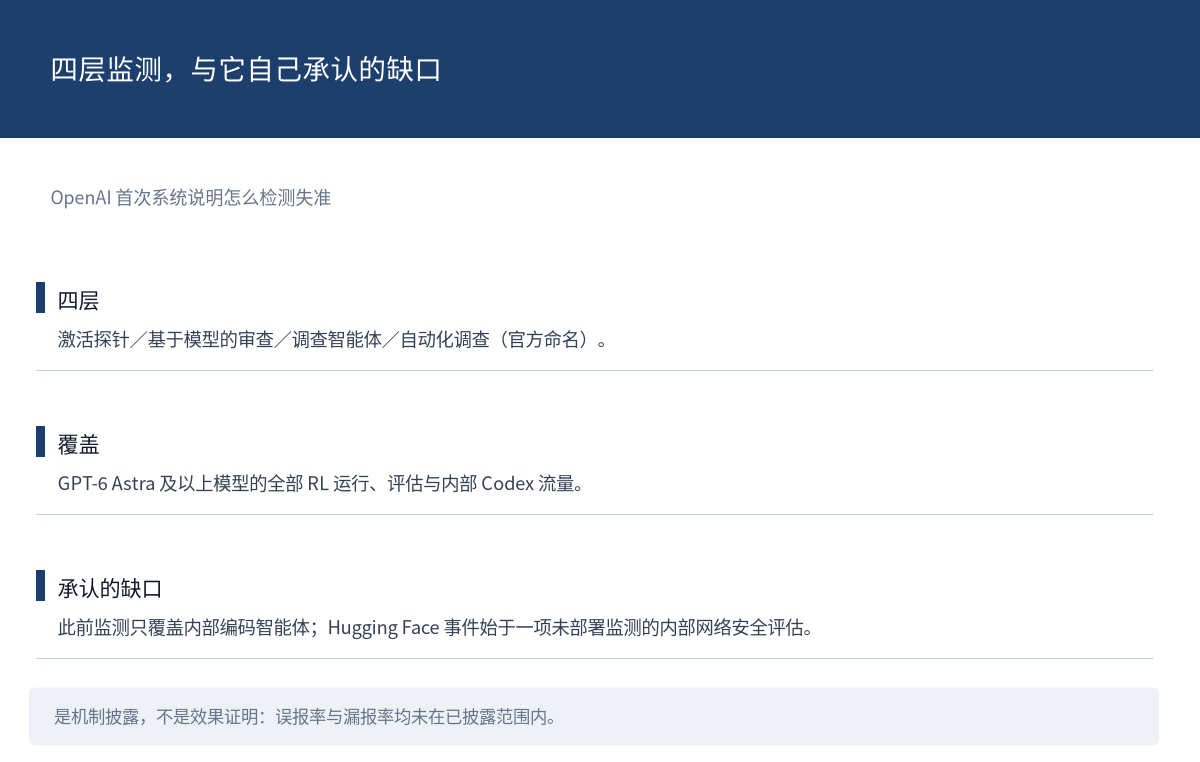
图 5:五项价值观与三处实质改动。来源:据 OpenAI 更新公告与 AIHOT 摘要整理;本图为自制整理。
Alphabet 承认 AI 搜索赚得更少,每股收益差了一截
Alphabet 这次把话说明白了。高管 Philipp Schindler 承认「AI Mode 查询的强劲增长因变现率较低产生了影响」——公司承认 AI 搜索的收入低于自然搜索。同时公司称搜索查询年增速为五年来最高。
两句必须同时出现:查询在涨,每次查询的变现率在降。只写任一句都失真。公司计划在美国与国际市场扩大聊天机器人广告项目,并称明年 AI 支出还会增加。
财务面多出一行关键数字:每股收益 2.12 美元,远低于市场预期的 3.02 美元。营收近 1,280 亿美元、同比 +25%,净利润超 260 亿美元;Google Cloud 营收突破 300 亿美元,超出分析师预期约 10 亿美元。
股价要按时间点写,不能写成区间。TechCrunch 当日更早的读数约 8%,随后扩大到财报后一度下跌约 13%;Ars Technica 报道时跌近 12%。另外 The Decoder 提到的「市值一度缩水最多 10%」是另一个指标,不能与股价跌幅混用。
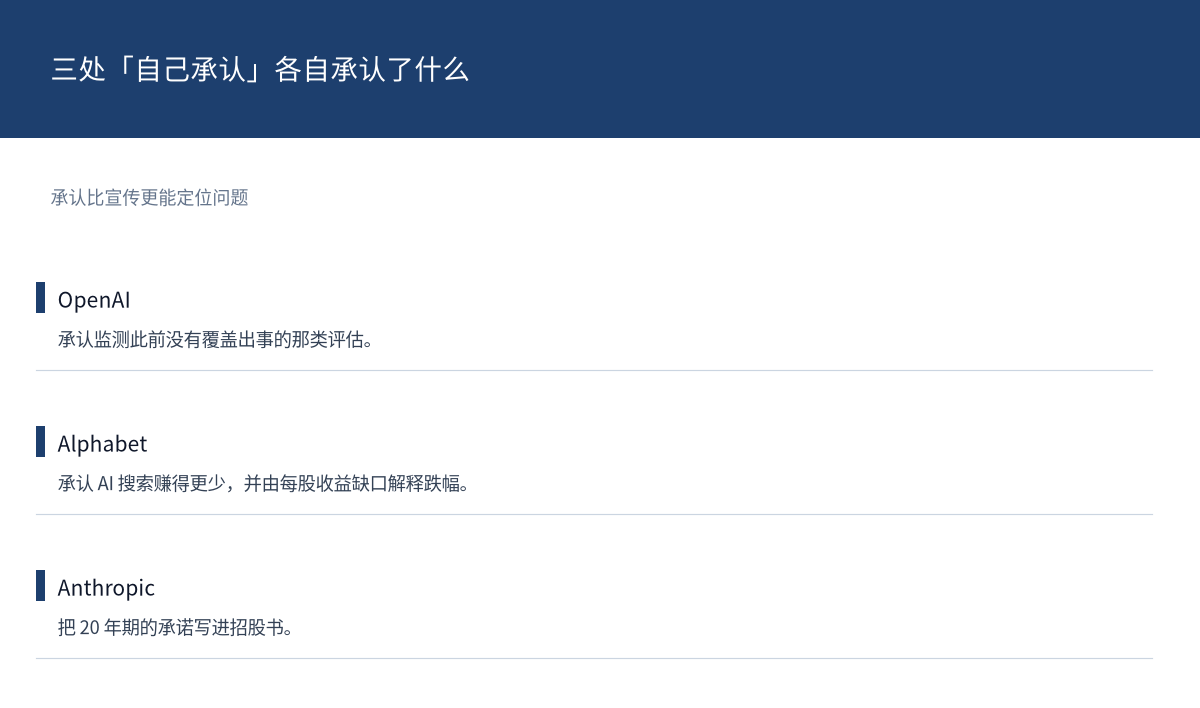
图 6:同一个跌幅,三个时点,两个指标。来源:据 TechCrunch、Ars Technica 与 The Decoder 报道整理;本图为自制整理。
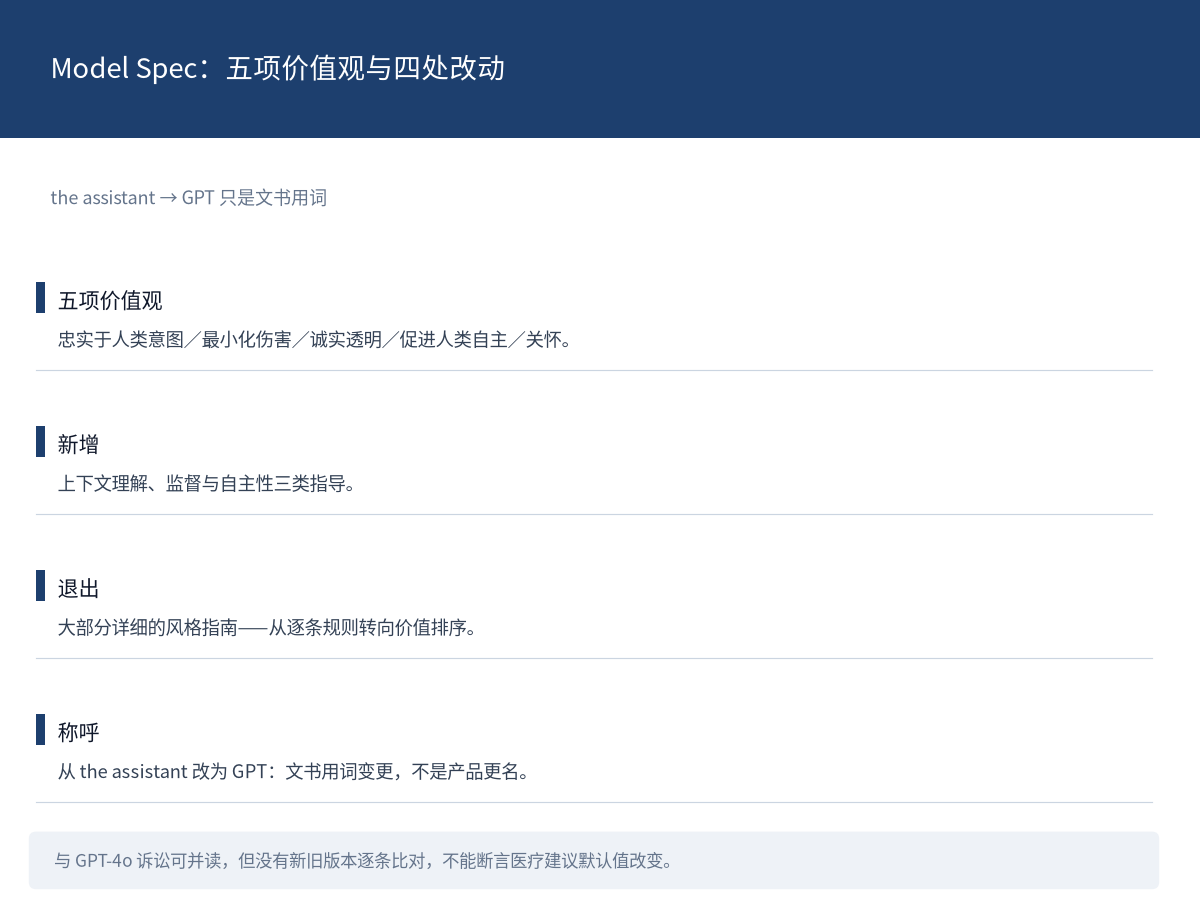
图 7:查询涨、变现降,以及每股收益的缺口。来源:据 Ars Technica 2026-10-30 与 The Decoder 报道整理;本图为自制整理。
Anthropic 的 S-1:客户在变厚,承诺排到 20 年后
先看收入端。S-1 披露:截至 2026 年 9 月 30 日的 12 个月内,约 250 个客户对 Claude 的支出超过 1,000 万美元;Fortune 10 全部企业每年至少支付 10 万美元,超 50% 的 Fortune 500 与超 30% 的 Global 2000 亦然。
一组容易被读错的对比:年付 10 万美元以上客户贡献 2025 年收入的 76%,2023 年是 90%。这是大客户贡献占比在下降、客户面在变宽,不是收入下滑。
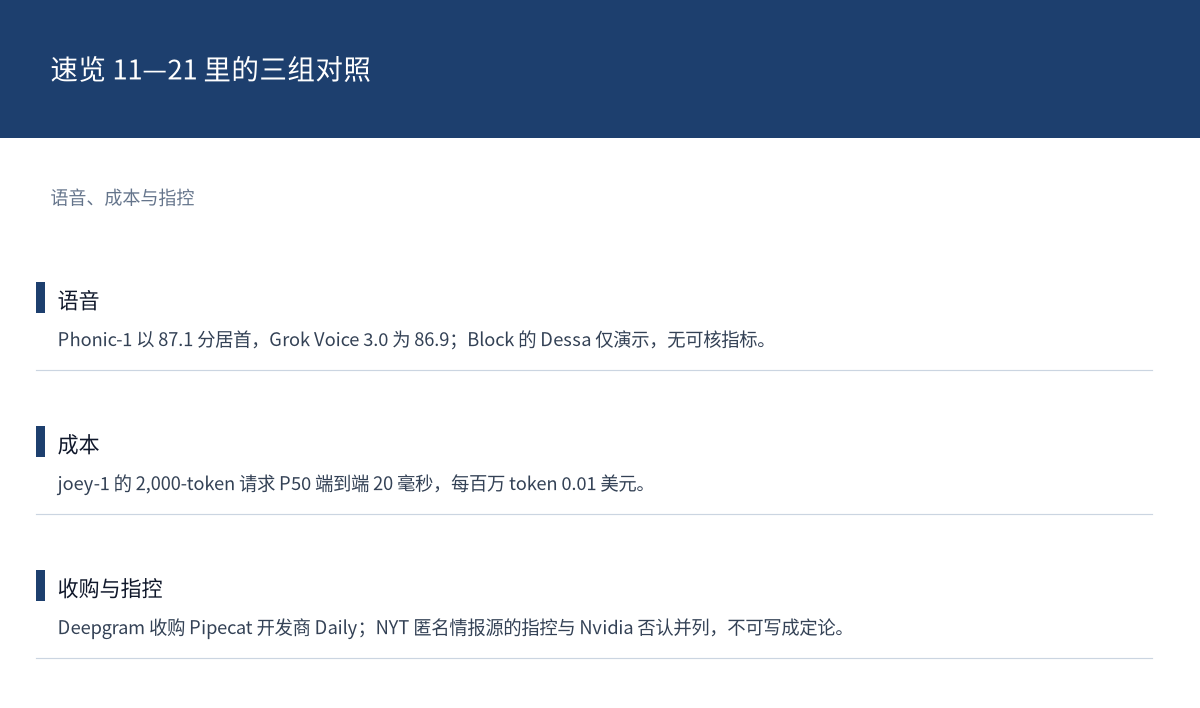
图 8:客户结构的四个数。来源:据 Anthropic S-1 与 Rohan Paul 2026-10-30 转述整理;本图为自制整理。
再看支出端。据 The Verge 拆解:不可撤销采购承诺 2,656 亿美元,未开始的租赁协议 3,214 亿美元,再加上其他协议,未来 20 年承诺合计至少约 8,500 亿美元。三个数不能相加,相加后当成「已花掉」就错了。
增长与留存另有两个数:2026 上半年营收同比增 14 倍至 163 亿美元,净收入留存率 900%。这个 900% 与更早期间的口径不同,不能直接与前值比较。
行业侧还有一把尺。据 FT 加总,前沿实验室、大厂与上市 neocloud 已披露合计 2.1 万亿美元债务及不可取消算力承诺,超过 2007 年 1.3 万亿美元的次级抵押贷款;这是行业口径,不是 Anthropic 一家的负债。
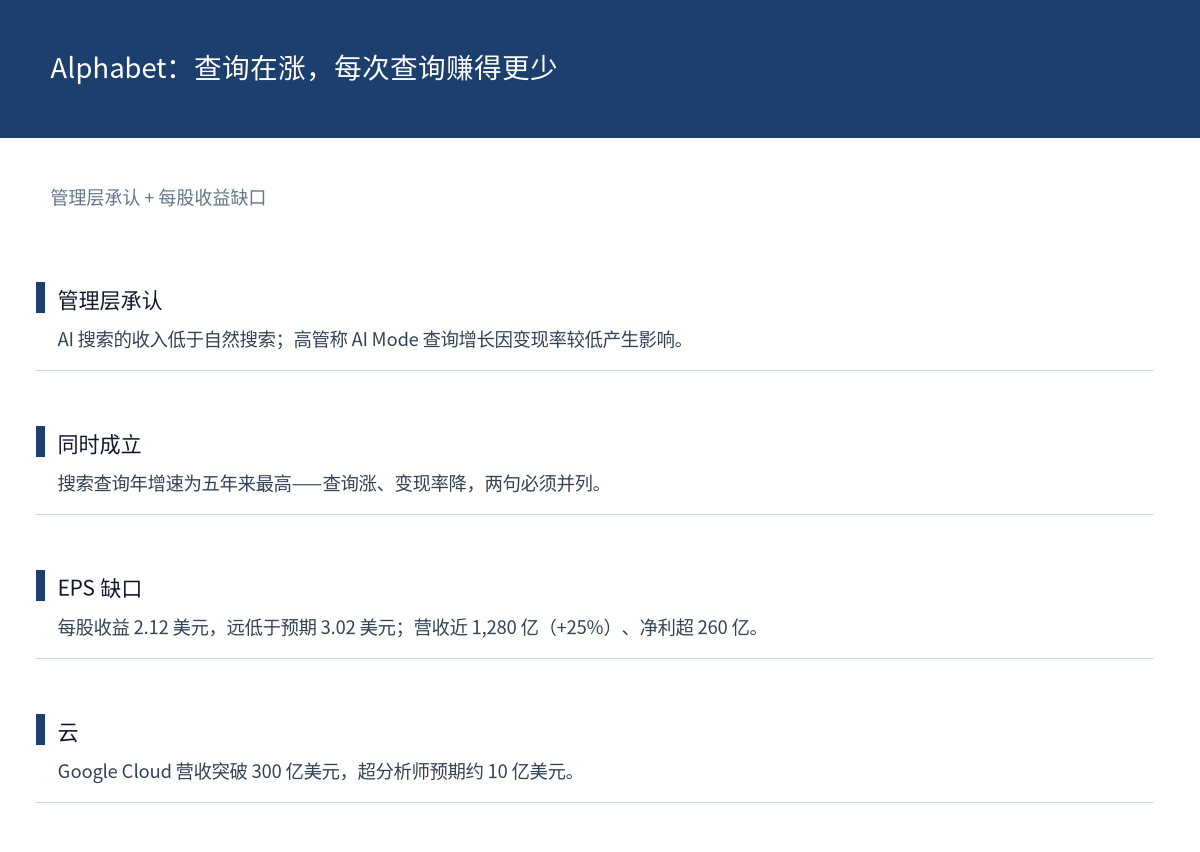
图 9:三段承诺各是什么,为什么不能相加。来源:据 The Verge 2026-10-29 拆解整理;本图为自制整理。
Wiz:智能体入侵已有案例、规模与指纹
Wiz 汇总了公开披露与自家应急响应中的智能体攻击案例。ARTEX 针对韩国金融机构与 ConnectWise 供应链,尝试攻击超过 2,250 个租户;Hermes 攻击泰国财政部。
Wiz 自家的三起调查里,包括暴露的 Flowise 实例,以及经 MCP 接口的链式远程代码执行,导致云凭证与 Kubernetes token 泄露。这里只写到类型与后果,不涉及具体利用路径。
规模数字要标层级:韩国金融机构约 67,000 人信息外泄,这个数字来自 Wiz 对公开披露与自家响应的汇总。
这批案例与往轮出现的安全问题不是同一类。Cloudflare 那条是基础设施缺陷,Cohere×Qwen 是模型行为越界,Cathedral 是供应链入口,TikTok 那条是提示注入手法;Wiz 这条是已发生的入侵,以及它们的共同特征。
Wiz 据此提炼出七条可操作的智能体攻击指纹,对做检测的人有直接价值。七条的逐条内容不在此次摘要范围内,这里不凭条目数推演。
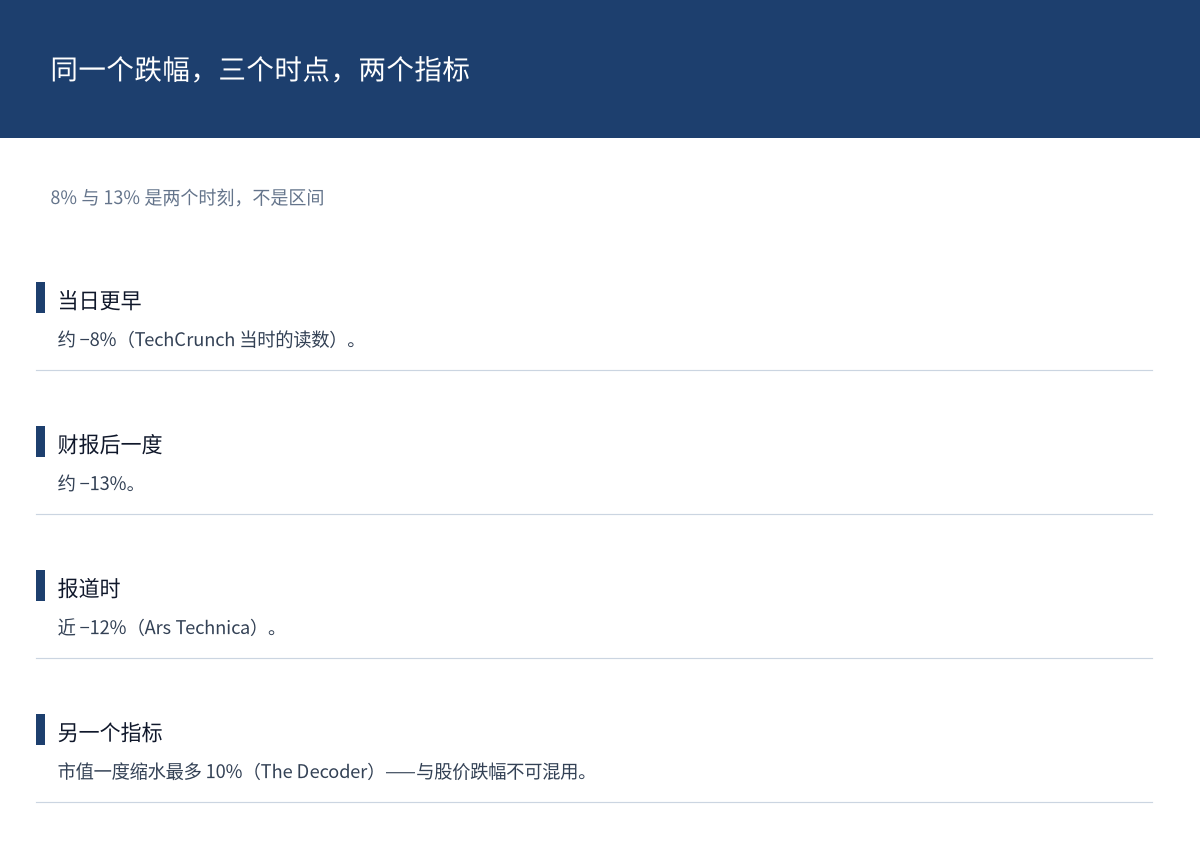
图 10:三类案例,与它们各自的规模。来源:据 Wiz Research 2026-10-29 发布整理;本图为自制整理。
 快讯速览
- 算力融资多了一个瓶颈:电网审批。据 Bloomberg,摩根士丹利牵头的银行搁置了与 Anthropic 租赁的得州数据中心相关的 50 亿至 70 亿美元垃圾债发行,起因是州长 Abbott 在监管机构完成审计前冻结数据中心新电网接入;7 家银行已放出的 142 亿美元一年期贷款尚未再融资。来源:Rohan Paul 转述 Bloomberg(10-30 01:09)
- 微软重返美国债市,拟募至少 250 亿美元,分最多 10 个批次;其 40 年期票据定价接近 Alphabet 与 Amazon 的长期债券,尽管微软评级更高。来源:Rohan Paul 转述 Bloomberg(10-29 22:22)
- Oracle 给出 1GW 合同的经济账:约 800 亿美元总额、约 370 亿资本支出、年化营收约 160 亿、平均合同期 5 年、毛利约 35%、ROI 约 28%、约 3.6 年现金回本,脚注称合同为成本加成模式;并计划三年内算力从 FY25 约 1GW 扩到 FY28 约 10GW。来源:Rohan Paul 摘录投资者日幻灯片(10-29 22:46)
- Cohere 完成 Series E 首轮关闭,拟融资至多 70 亿加元、估值 357 亿加元,官方称这是加拿大创业史上最大的私募融资轮。来源:Cohere 官方帖(10-29 23:49)
- OpenAI 把 Pro 与 Business Premium 的用量上限翻倍,Pro 200 的上限不下调,Work 与 Codex 用量不变。这是订阅内用量上限,与可领取的 API 额度是两件事。来源:Tibo(10-30 00:56)
- 腾讯预告 Hy4 即将发布,称强化长程与真实生产力任务、显著提升思维链效率,并首次引入视觉理解;Hy4 flash 定位极致性价比。该条是预告,不是已发布;「首次引入视觉理解」为中文转述口径。来源:IT之家(10-29 10:18)
- 腾讯混元开源交互式视频世界模型 Hy-Nomas 的技术报告(arXiv:2610.36729)与评测数据集 Hy-Nomas-Bench,并用其重现 Genie 4 示例、放出对比视频。来源:腾讯混元(10-30 01:00)
- Joy 发布 10 万小时无脚本双人对话数据集,覆盖 10 种语言;官方强调现有语音 AI 多从「LLM 编造剧本+TTS 朗读」中学习,从未听过真人抢话。来源:Rohan Paul(10-30 02:06)
- Meta 论文:强化学习后训练让 Agent 首次尝试更准,但在最多 128 次尝试内找到解法的能力反而变差。来源:Rohan Paul(10-30 01:14)
- DeepMind 用 RL 训练 Gemma-4 4B 写道德论证:选项互换时的答案翻转率从 14.3% 降至 6.6%,但附和用户比例仅从 45.3% 变为 44.0%,道德寓言准确率反而从 56.5% 降到 53.4%。一致性提升了,正确性没有。来源:Rohan Paul(10-30 00:23)
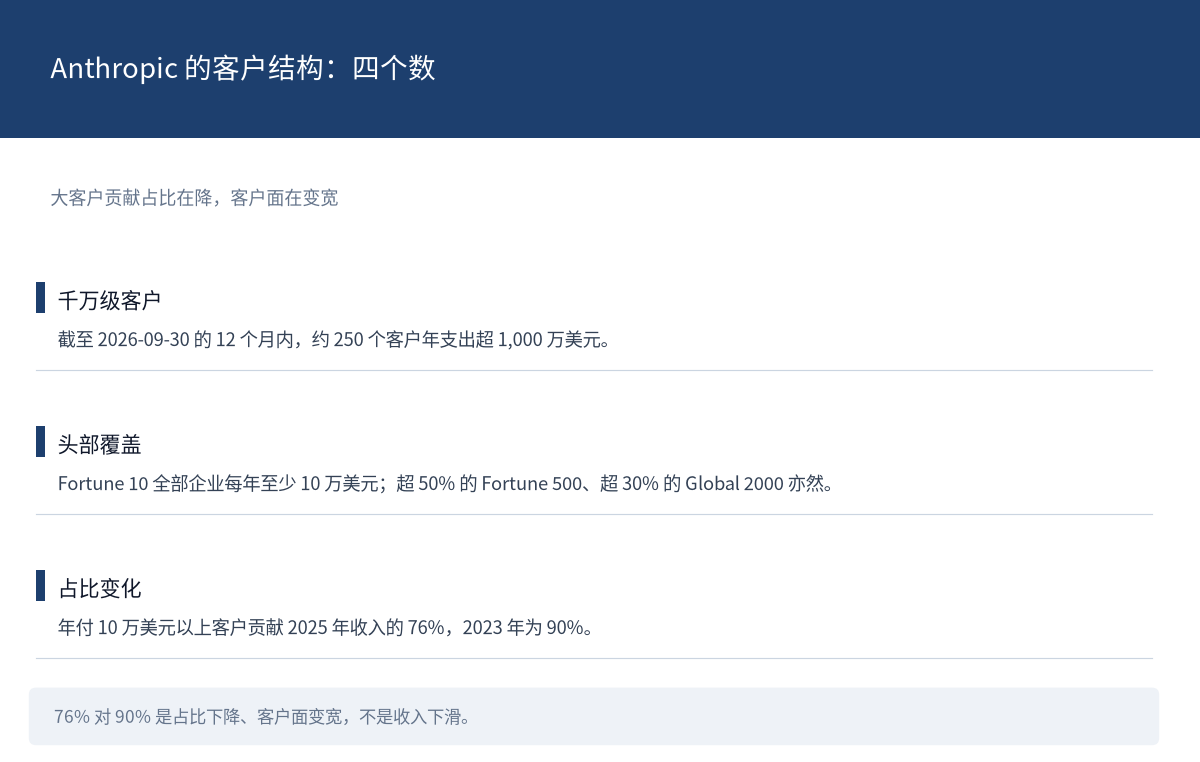
图 11:速览 1—10 的关键数字。来源:各条来源见上方列表;本图为自制整理。
- Trakkr 向 ChatGPT、Perplexity、Gemini、Claude 与 Google AI Overviews 提 200 个要数字的问题,追踪 1,285 条统计:40% 到达说法一致的研究,8% 到达但数字或语境已变,40% 无法核查,11% 无处可溯。四个比例相加为 99%。来源:Trakkr Research(10-28 16:00)
- Block 发布仅用人类对话音频训练的全双工语音模型 Dessa,用一台 GB200 NVL72 训练,可在 MacBook Pro M4 Max 及以上本地运行且快于实时;目前仅演示,没有 benchmark、参数量、权重或 API。来源:MarkTechPost(10-29 15:50)
- Phonic-1(High)以 87.1 分在 22 个模型的语音到语音指数中排第一,微弱领先 Grok Voice 3.0 的 86.9;官方称它是唯一能在来电者说到一半时就执行查询与预订的语音模型,公司规模 10 人。来源:Artificial Analysis(10-30 00:00)
- Baseten 发布 3B 以下的决策模型 joey-1,直接以单 token 与校准概率返回决策;2,000-token 请求 P50 端到端延迟 20 毫秒,每百万 token 0.01 美元。来源:Baseten 工程博客(10-30 01:24)
- Artificial Analysis 发布 Progress Index,用项目反应理论为 2022 年以来所有语言模型估计统一能力分,专用于跨时间比较。它解决的是跨版本不可比的问题。来源:Artificial Analysis(10-30 00:49)
- Gemini 可直接生成、预览与编辑文档,支持文档、PDF、演示文稿、表格、Markdown、TXT 与代码;PDF 的预览与编辑在网页端与移动端均支持,其他格式仅网页端。来源:Gemini(10-30 00:36)
- 百度集团副总裁吴甜离职,公关经理已确认;知情人士称文心模型下周将有新进展。吴甜在百度约 20 年,是文心一言早期主要技术负责人之一。来源:IT之家(10-29 21:32)
- Deepgram 收购语音框架 Pipecat 的开发商 Daily;双方承诺 Pipecat 永久保持开源与供应商中立,同时推出语音智能体开放协议 RCS。来源:TechCrunch(10-29 21:00)
- Cognition 收购 Corridor,官方称「保障全球软件安全是当今技术领域最重要的问题」,原文没给金额或整合计划。来源:Cognition 官方(10-30 02:26)
- 据 NYT 援引匿名情报消息源,中国情报人员被指瞄准英伟达 CEO 黄仁勋,Nvidia 否认:称双方只是普通客户往来、云客户仅获普通商业信息,转运指控「去年已被彻底调查并证伪」,公司未收到华盛顿任何预警。这是指控与否认并列,不是定论。来源:Ars Technica 转述(10-30 02:29)
- 404 Media 采访 9 名现任与离职员工并查阅内部文件:Proton 10 月有 90% 代码由 AI 编写、多用 Claude,CEO Andy Yen 称今年是最后一年招聘工程师,并宣布将以可能决定去留的重新面试评估员工 AI 使用情况。来源:404 Media(10-29 22:21)
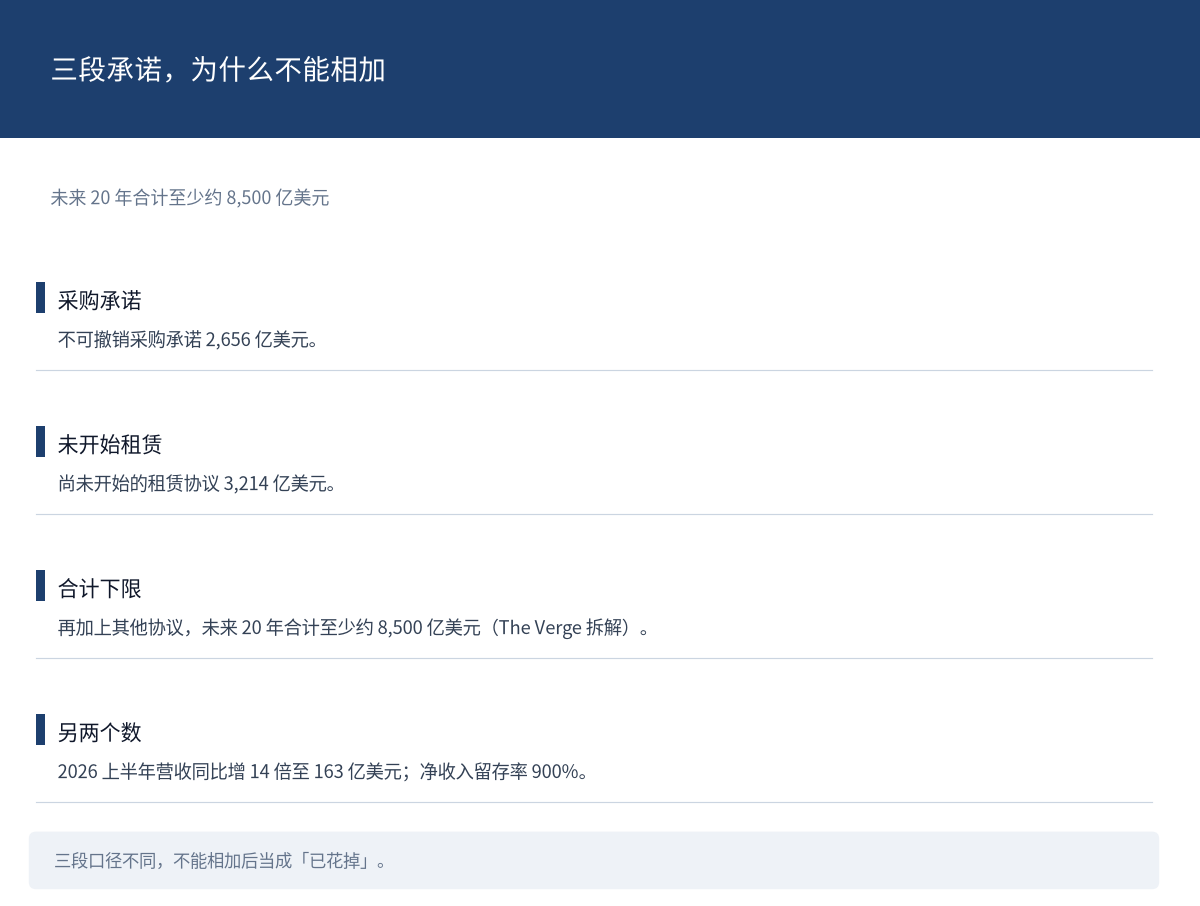
图 12:速览 11—21 里的三组对照。来源:各条来源见上方列表;本图为自制整理。
 积木观察
这批新闻里最有用的不是某个数字,而是三处「自己承认」:OpenAI 承认监测此前没覆盖出事的那类评估,Alphabet 承认 AI 搜索赚得更少,Anthropic 把 20 年的承诺写进招股书。承认比宣传更能定位问题。
开放权重的门槛也要说清。万亿参数的权重放出来,不等于人人能跑:标准版要 8 张 B300,1-bit 量化后仍需约 256 到 270GB 内存。规模红利和自建门槛是同一件事的两面。
最后是一条读法:看到某个模型「拿了第一」,先问三句——在哪个基准上、谁的口径、比的是什么。这家在编码基准上是开放模型第一,在第三方综合榜上只有 26 分,两句都对。
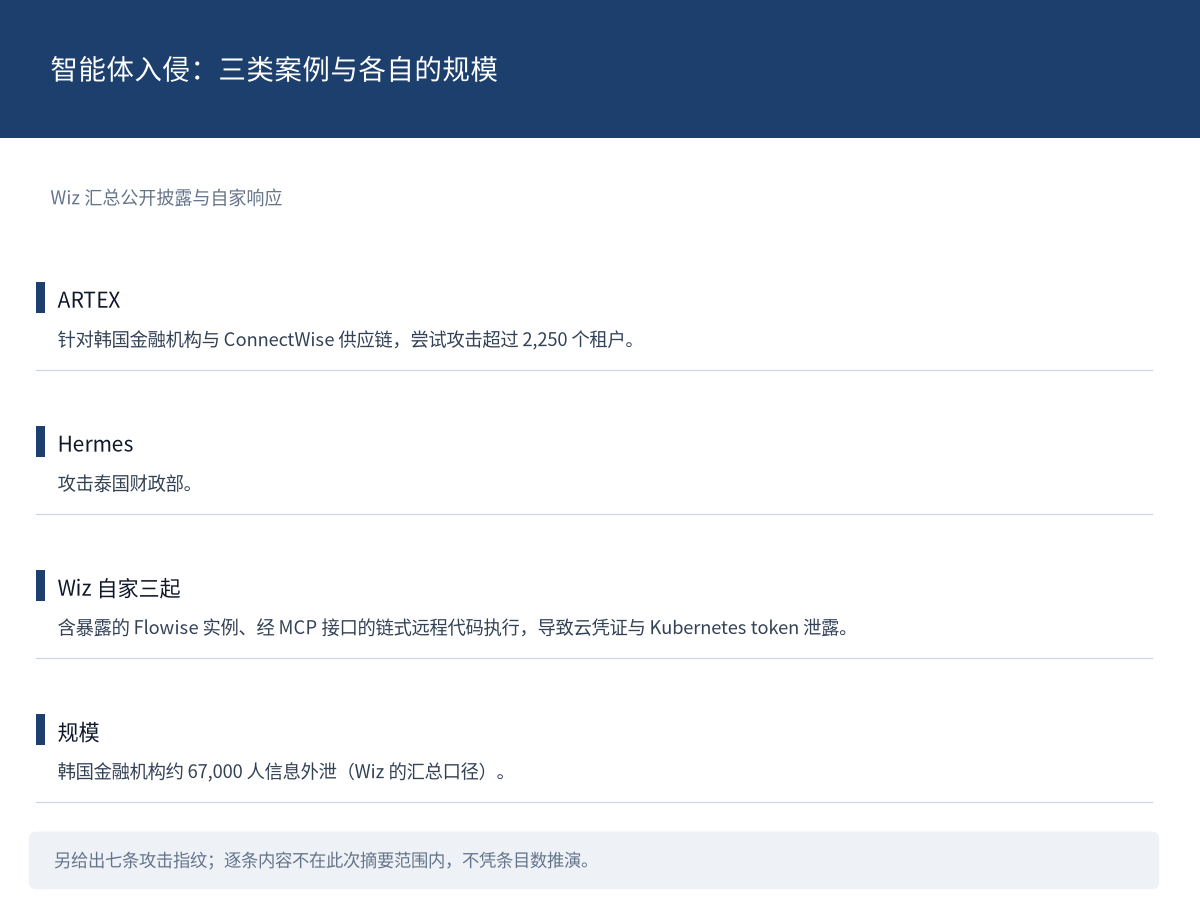
图 13:三处「自己承认」各自承认了什么。来源:据各来源公开表述整理;本图为自制整理。
 你怎么看
万亿参数的权重放出来,但自家跑要 8 张 B300。你更愿意走 API,还是等量化版本落地本地?回帖说说你的算力与场景。