AI 日报 | Anthropic 承诺 8,954 亿,跨到 2045 年
Anthropic 在 11 月 2 日申报的修订版 S-1/A 中写明:合计承诺支出约 8,954 亿美元,其中「绝大部分」(原文 substantially all)与算力及基础设施相关。
其中约 4,475 亿美元预计在 2030 年年底之前发生,其余大部分在 2031 至 2045 年。另有约 698 亿美元,自 2026 年 9 月 30 日起的十二个月内到期。
先把口径放在前面。这份合计数是全口径,含两类:短期承诺,以及尚未起租的租赁。
10 月 26 日那版 S-1 的合同义务表,把这两类明确排除在外。所以 8,954 亿与当时按那张表加出来的 7,820–8,070 亿,不是同一次测量的两个版本,也不是谁更正了谁。
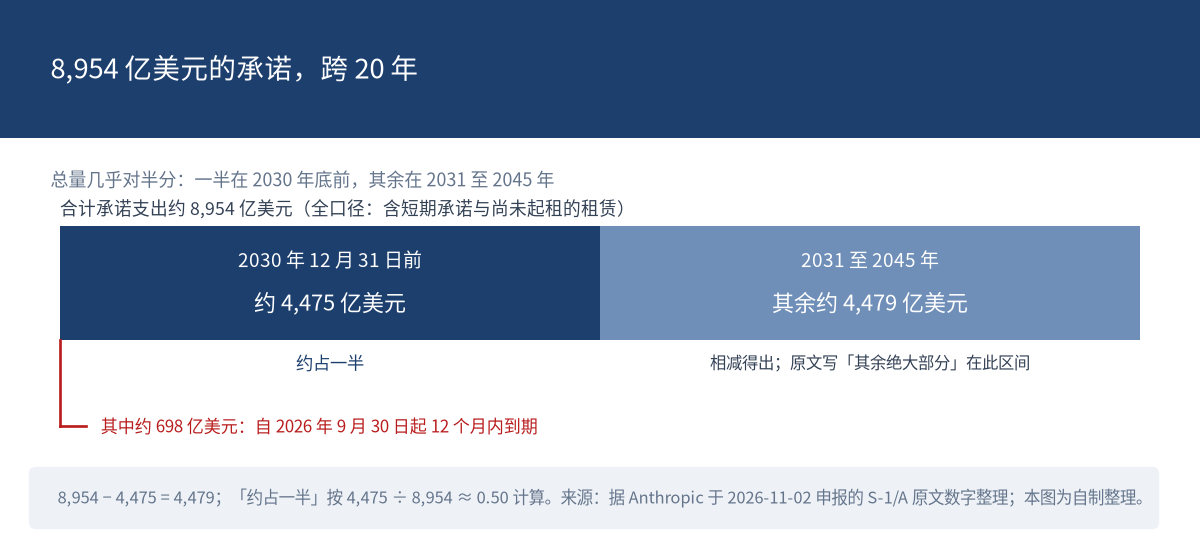
图 1:8,954 亿美元承诺的年限分布,以及其中一年内到期的部分。来源:据 Anthropic S-1/A(2026-11-02 申报)原文数字整理;本图为自制整理。
 头条深读 | 一半的钱要在 2030 年底前发生
4,475 除以 8,954 约等于 0.50。也就是说,这份跨到 2045 年的承诺里,约一半落在 2030 年年底之前。
「跨到 2045 年」因此不能读成「很久以后才付钱」。剩下那一半是相减得来的:8,954 减 4,475 等于 4,479 亿美元。
2045 是这批剩余承诺预计发生完毕的年份,不是某一笔款项的到期日。
再看 698 亿。它是「十二个月内到期」的金额,不是已经花掉的钱,也不是今年的全部现金支出。
据转述,其现金及短期投资约 1,319 亿美元;这个金额在招股文件正文中没有以该数值出现,所以这一句按转述处理,不作为原件的读数。
两栏放一起才有意义:一边是十二个月内到期的 698 亿,一边是手上的现金与短期投资。前者是义务的密度,后者是缓冲的厚度。
同一份文件里还有一组成本数:截至 6 月 30 日的三个月,算力成本占营收 48%;截至 9 月 30 日的三个月升到 58%,后者含 50 亿美元的短期承诺算力。
前九个月营收 332 亿美元,同比增长 1,206%。8,954 除以 332 约等于 26.97,也就是承诺总额约为前九个月营收的 27 倍。
这个 27 倍只说明量级差。一个是跨二十年的承诺总额,一个是九个月收入,两者相除得不到「要还多少年」这类结论。
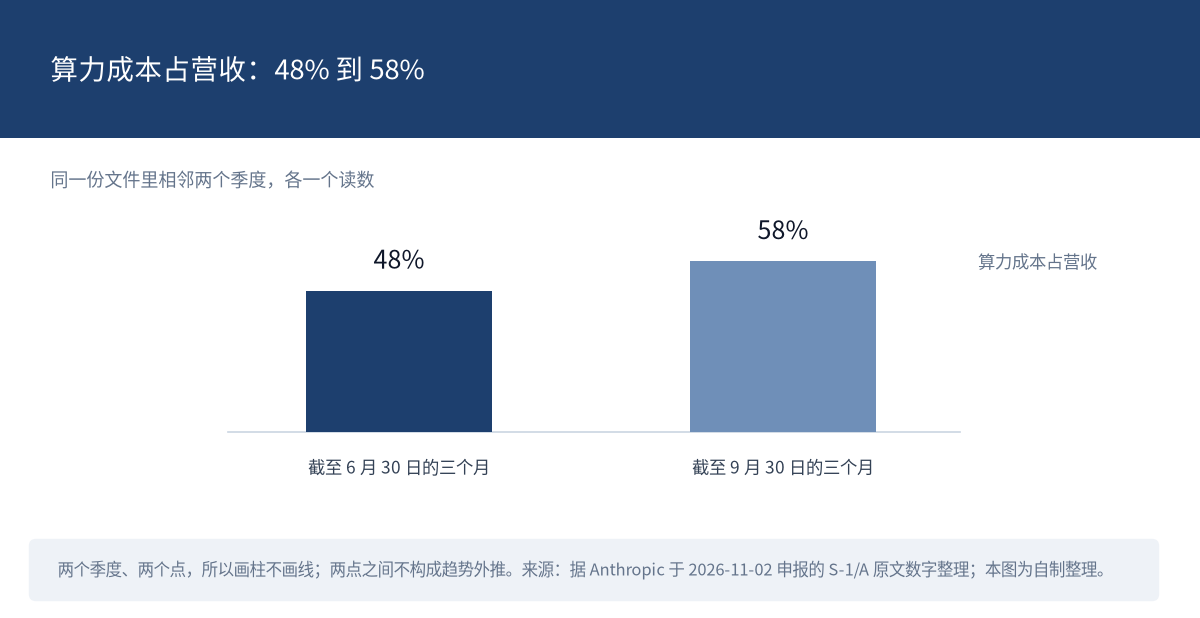
图 2:算力成本占营收的两个季度读数。来源:据 Anthropic S-1/A(2026-11-02 申报)原文数字整理;本图为自制整理。
另有一笔 1,500 至 1,750 亿美元的付款估计,招股文件写的是金额尚不确定。
按上限把 8,954 亿与 1,750 亿相加约得 1.07 万亿。这是相加,原文没有这个合计数;而且那笔 1,500 至 1,750 亿本身金额未定,所以本文不采用它。
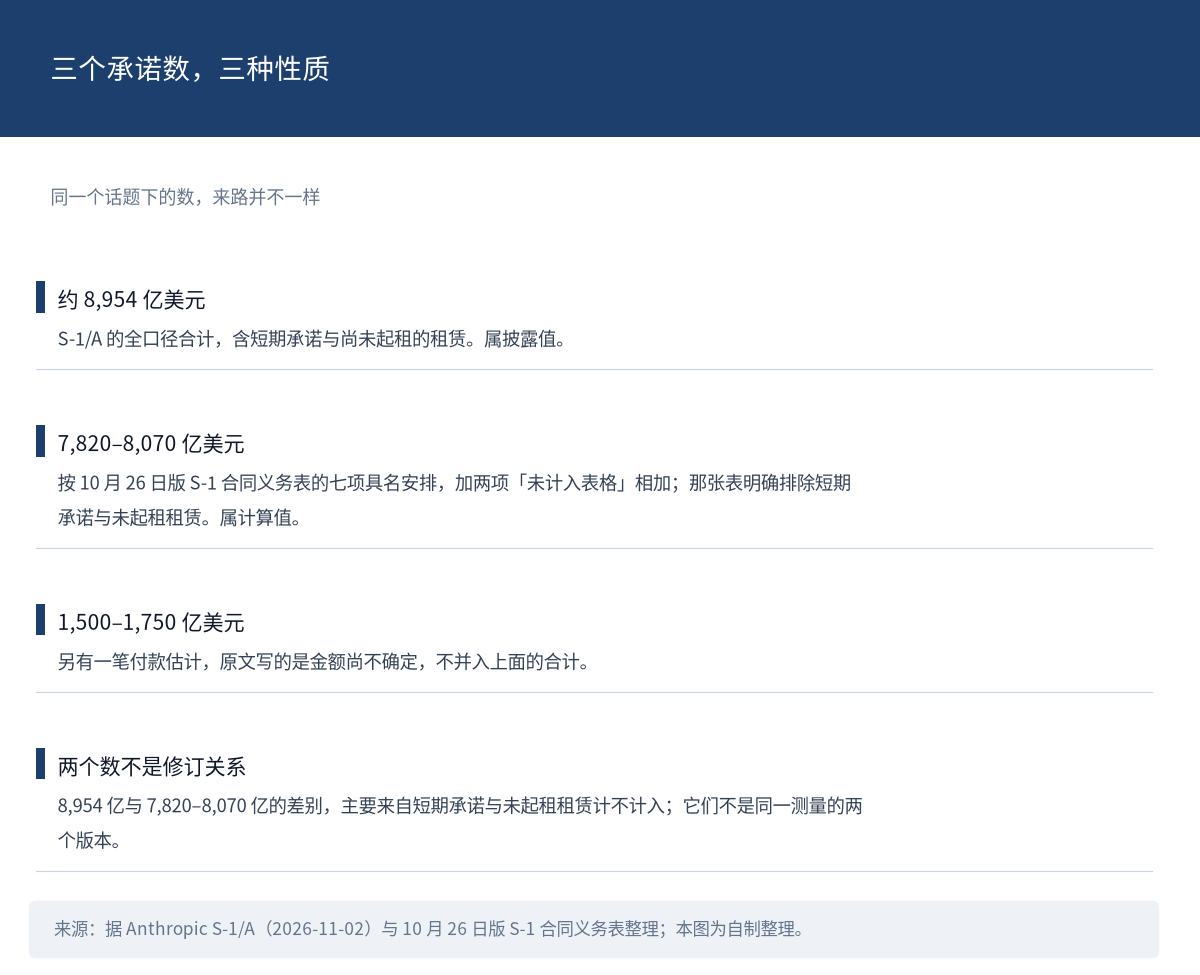
图 3:三个承诺数,三种性质。来源:据 Anthropic S-1/A(2026-11-02)与 10 月 26 日版 S-1 合同义务表整理;本图为自制整理。
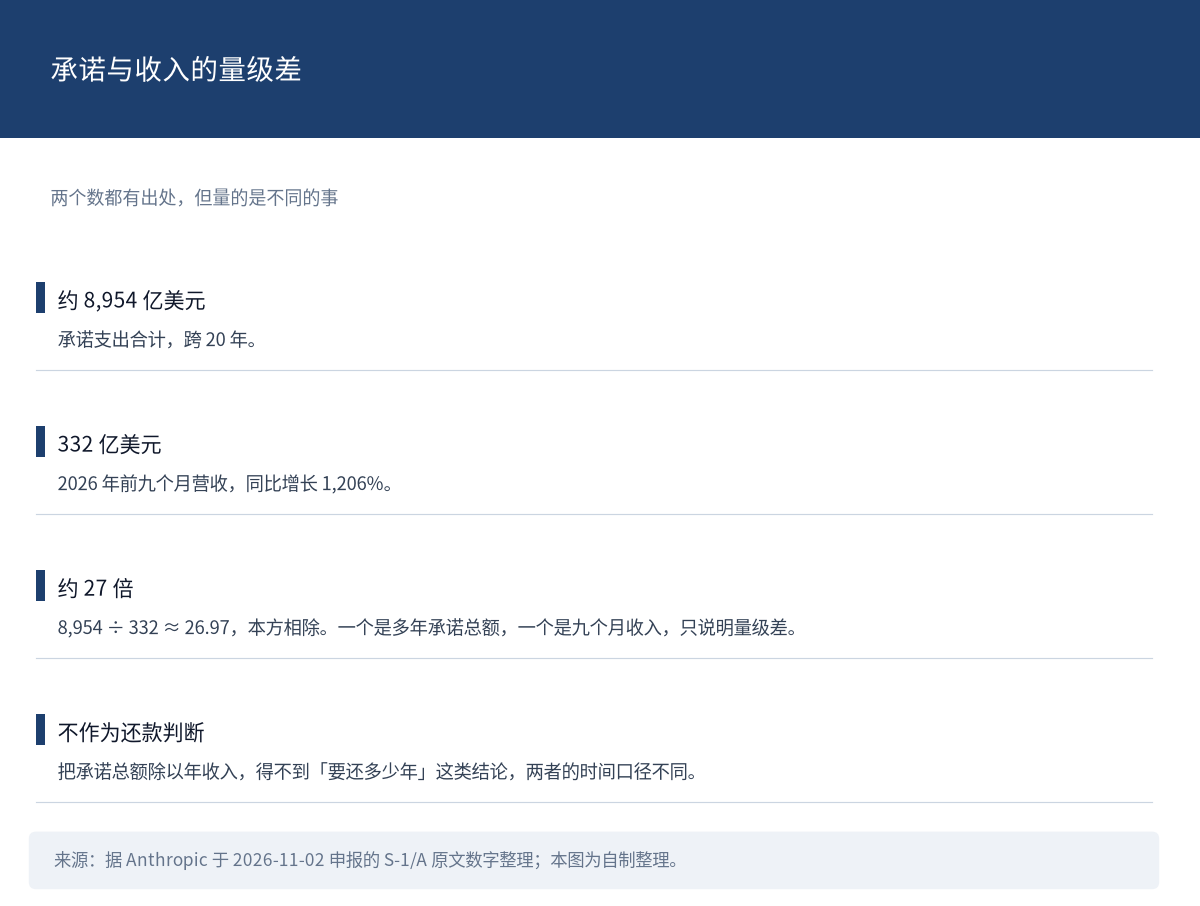
图 4:承诺总额与前九个月营收的量级差。来源:据 Anthropic S-1/A(2026-11-02 申报)原文数字整理;本图为自制整理。
 重点速递
MIT CSAIL:改 0.016% 的权重,分数跳了一个量级
MIT CSAIL 的 Rikiya Takehi 团队提出「权重空间编程」:不训练、不用梯度,直接读写神经网络的权重。
被测对象是 Qwen3.5-0.8B,改动的权重约占总数的 0.016%。结果:MATH-500 从 7.9 升到 48.1,GSM8K 从 13.8 升到 67.1,指令遵循提升约 3 倍。
三个读数都出自作者团队自测,没有第三方复现。样本外泛化、题量与评测条件,报道只给到这一层。
0.016% 是这条的核心。省掉它,「改权重」就会被读成「随便改改就变强」;而它恰好说明收益来自极小的改动面。
这条路主张不用梯度、不用训练,但不等于不需要数据。输入要求这一层,报道没有涉及。
被测的是 0.8B 参数级的开源小模型。比例与效果都不能直接搬到闭源大模型上,作者团队的读数也没有覆盖那类对象。
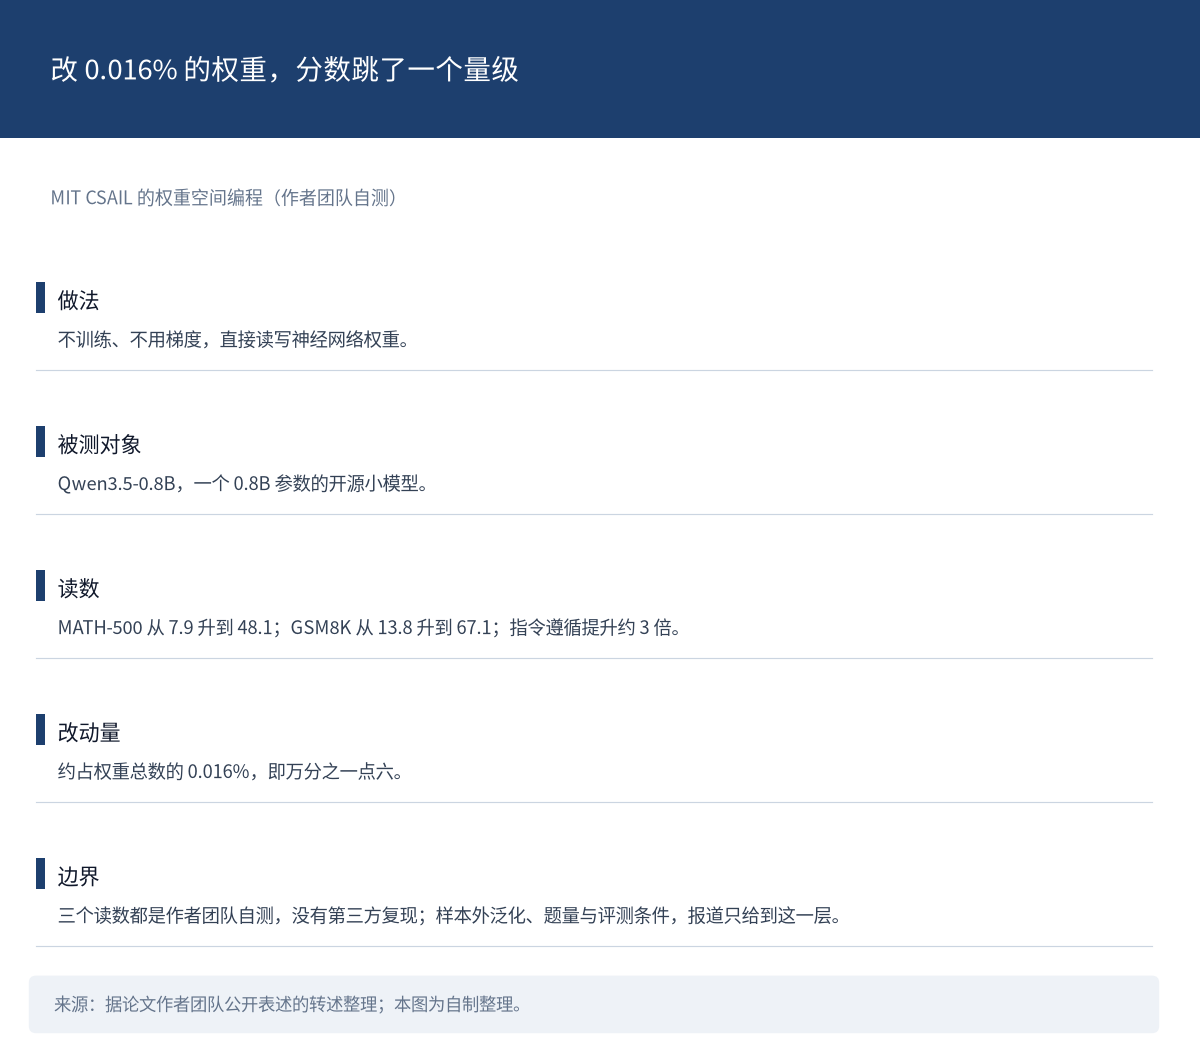
图 5:权重空间编程的做法、读数与边界。来源:据论文作者团队公开表述的转述整理;本图为自制整理。
Altman 在阿布扎比说:下一代 GPT 证明了一道千禧年难题
Sam Altman 在阿布扎比 ADIPEC 开幕式上说,即将发布的下一代 GPT,正是 OpenAI 用来证明一道千禧年数学难题的模型。
他称一万个副本之间没有层级,各自选择方向、共享进展、相互学习;这些副本不间断运行约 4 天。
三层要分清:主体是人,场合是会议,内容是口头表述。题名、同行评审状态、是否有形式化验证,都不在这段发言里。
「下一代 GPT」是预告,不是已发布的模型。
真正值得记的是他描述的组织方式:一万个无层级副本、各自选方向、共享进展。这比「模型有多强」更能说明下一代智能体系统的形态。
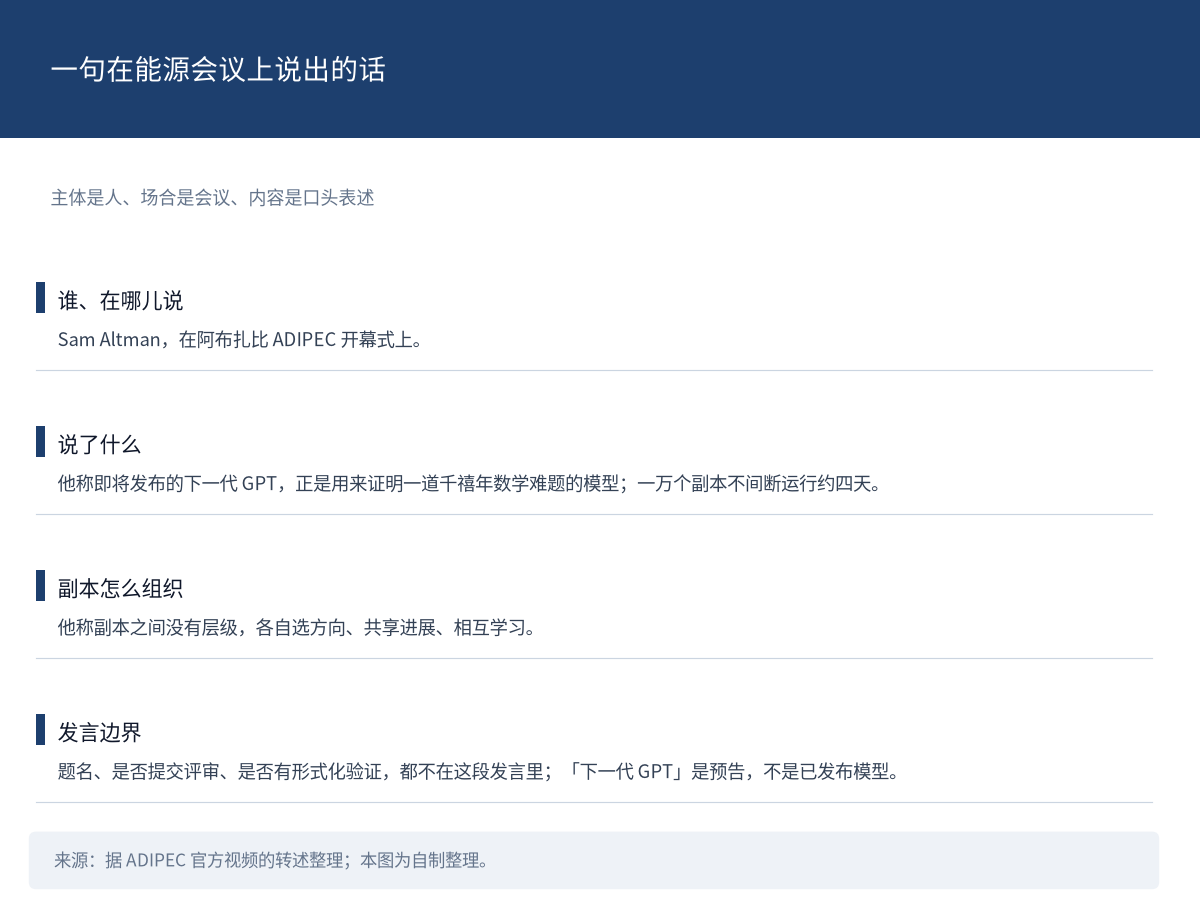
图 6:一句在能源会议上说出的话。来源:据 ADIPEC 官方视频的转述整理;本图为自制整理。
OpenAI 的 Git 后端 Pando
OpenAI 推出自研 Git 仓库后端 Pando,官方称现已支撑其 monorepo 的全部开发工作。
动因是 Codex 让并行开发激增。两个设计要点是因果一致性与 packfile 复用,同时保持 Git 协议与客户端兼容。
生产侧两个读数:中位 push 延迟降低近 5 倍;每天传输近 1 PB 的 Git 数据。
两个数都要带着单位读。5 倍说的是 push 延迟,不是整体性能;1 PB 说的是每天传输量,不是存储量。
版本控制的瓶颈正在从存储挪到并发一致性。对自建大规模 monorepo 的团队,这套设计是可参考的路径。
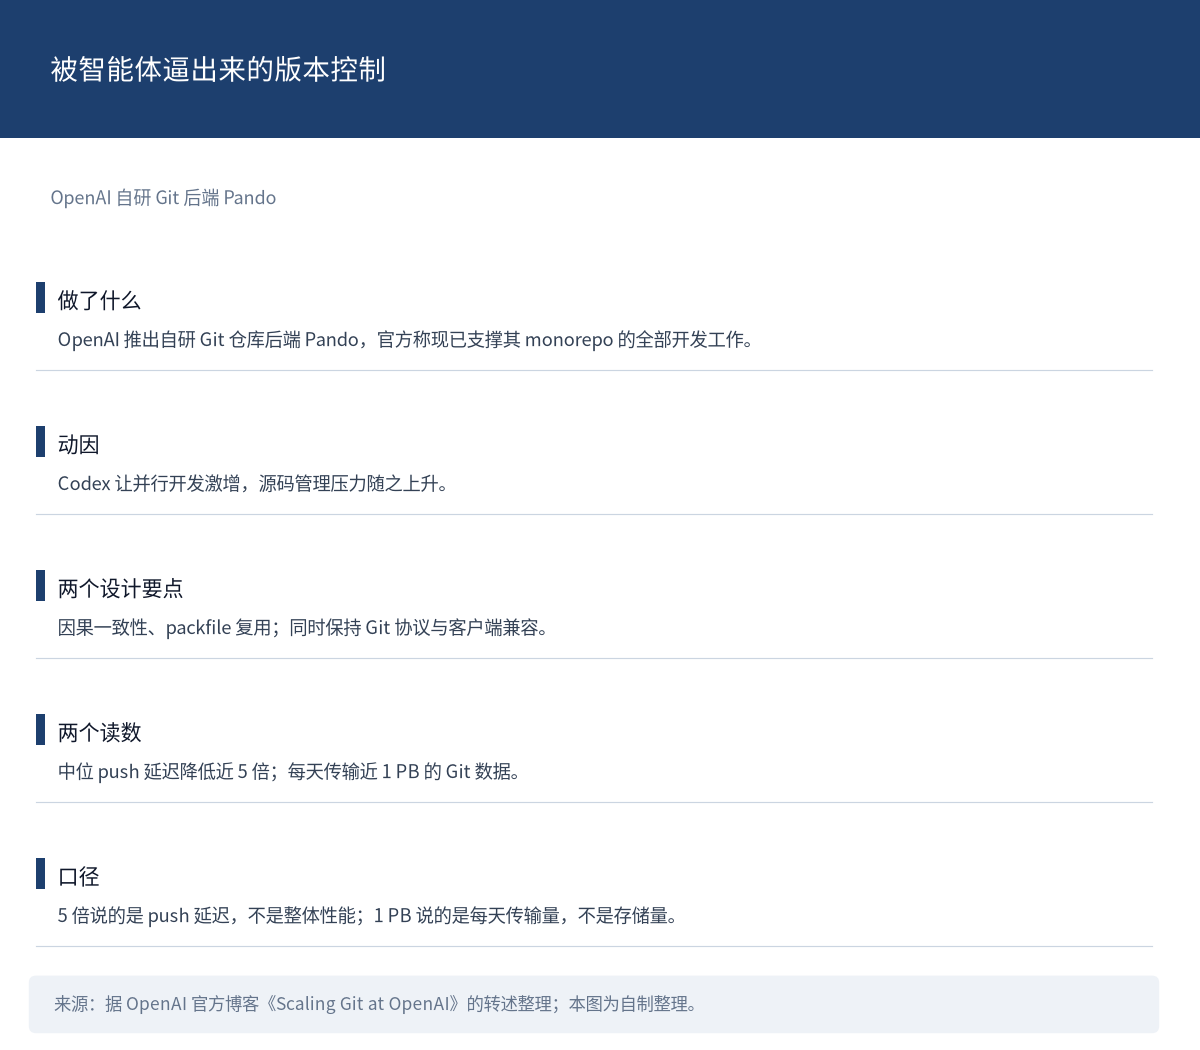
图 7:被智能体逼出来的版本控制。来源:据 OpenAI 官方博客《Scaling Git at OpenAI》的转述整理;本图为自制整理。
一周内两次引进军方与国安背景人士
两条的证据层级不同,不能合并成一句「宣布聘请两位前军方高层」。
OpenAI 官方公告:任命 Dan Driscoll 为新设的国家安全现代化高级顾问,就先进 AI 如何加强国家与网络安全提供建议,重点是与盟友合作推动「民主 AI」的负责任使用。Driscoll 曾任美国陆军部长。
另一条来自转述:OpenAI 聘请特朗普时期的前国防部长 Mark Esper,帮助扩展军事 AI 业务。Esper 在 2017 至 2019 年主管美国陆军,后执掌五角大楼至 2020 年 11 月。
前陆军部长与前国防部长是两个职位。公开材料只到人事任命这一层,模型用途条款是否有变化,并不在这两条里。
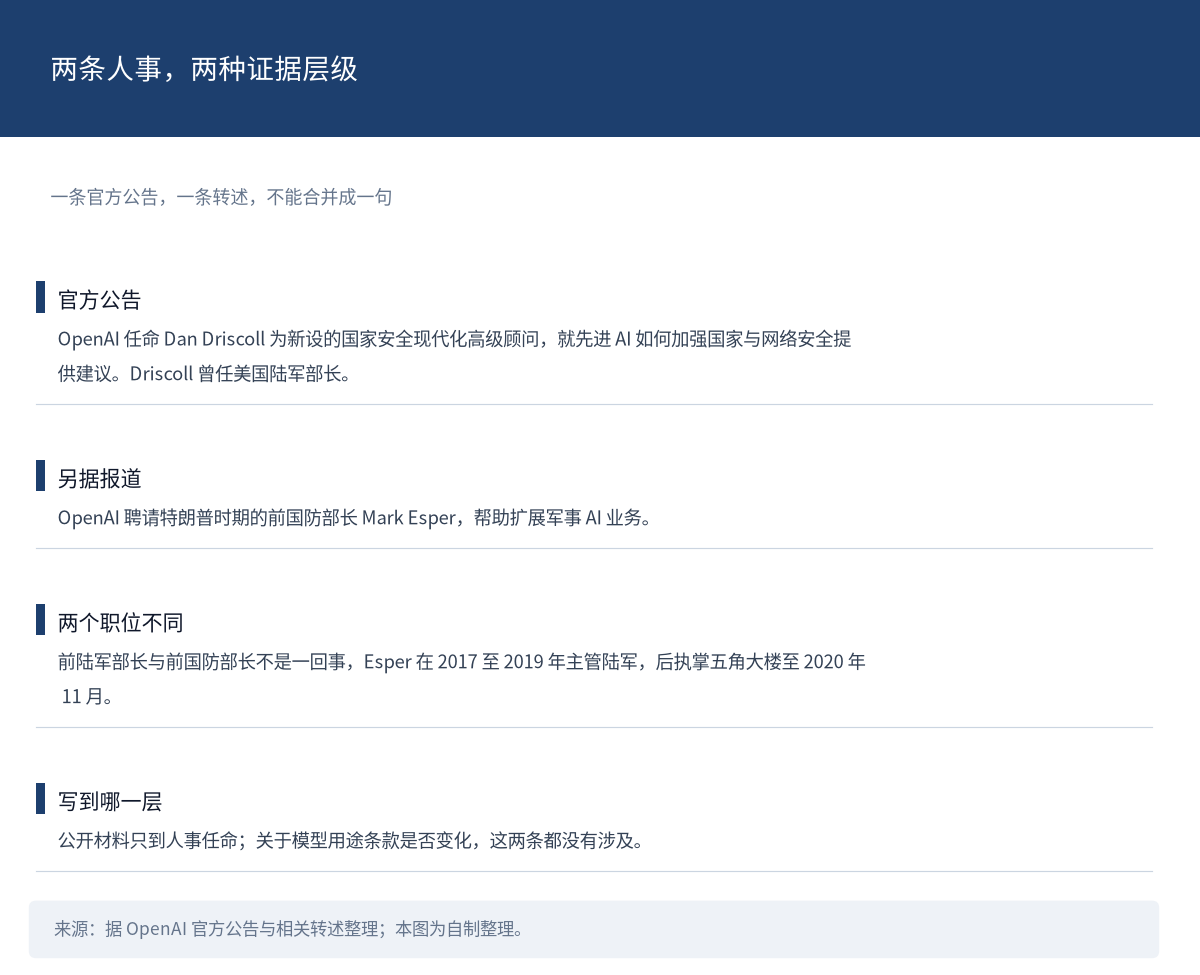
图 8:两条人事,两种证据层级。来源:据 OpenAI 官方公告与相关转述整理;本图为自制整理。
Garry Tan:一年在 token 上花 10 万至 20 万美元
Y Combinator CEO Garry Tan 在播客 The Builders 中说,他每年在 token 上花约 10 万至 20 万美元,用于大量工作项目与编码任务。
他在 GitHub 公开了一套 23 个 Claude Code 技能,名为 gstack;其智能体可读取他的邮件、Dropbox 与 Apple Notes。
这是自述的年度花费区间,不是均价,也不是行业基准。23 个是公开仓库里的技能数量,不等于 23 种能力。
它给个人智能体提供了一个成本锚点:深度使用一年是六位数美元。与 11 月 3 日早间那条「Grok Bot 因成本高于收入下调限额」并读,一边是用户愿意付,一边是厂商付不起。
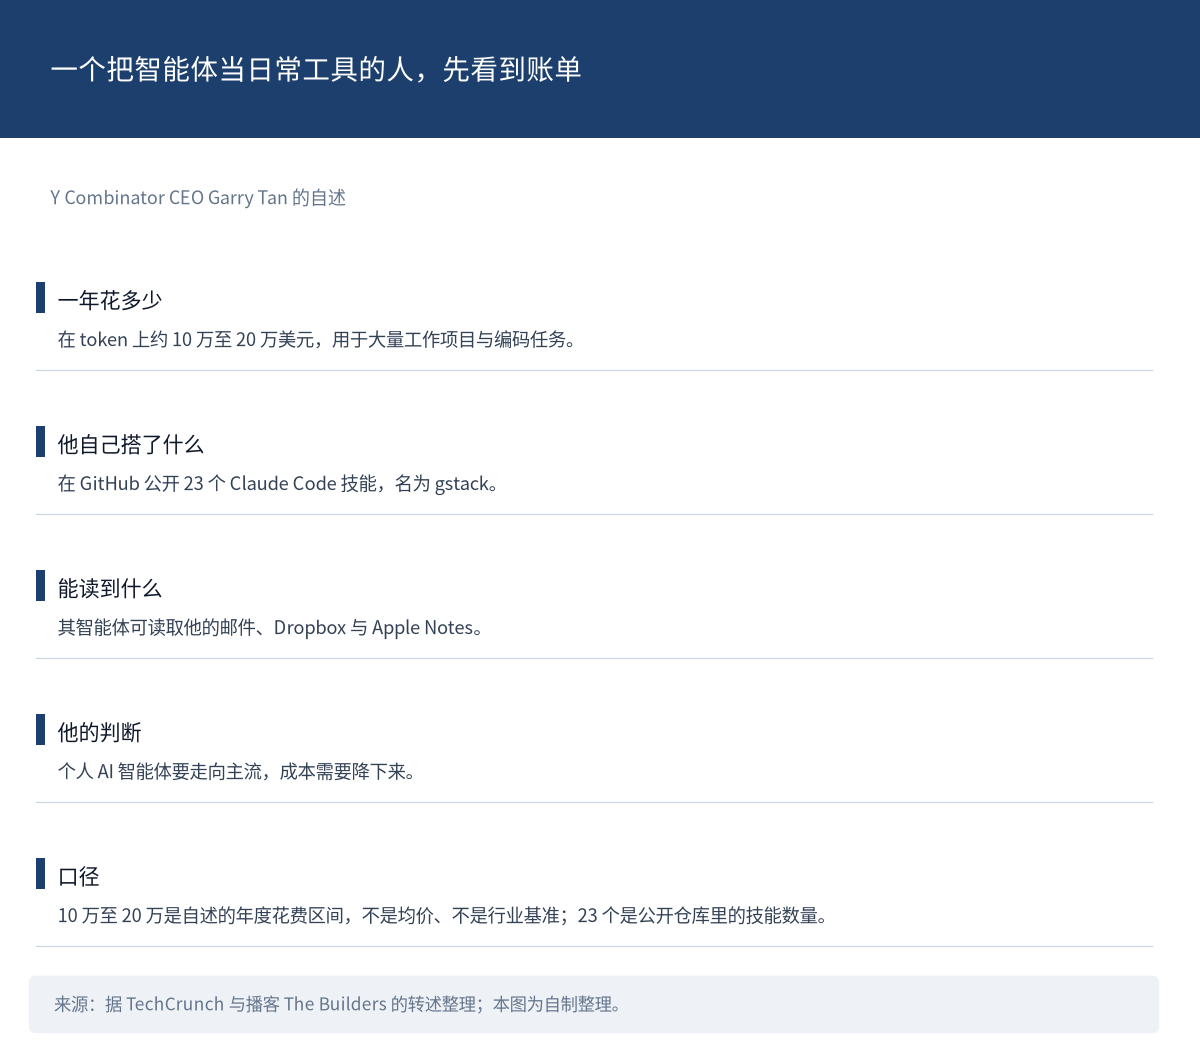
图 9:一个把智能体当日常工具的人,先看到账单。来源:据 TechCrunch 与播客 The Builders 的转述整理;本图为自制整理。
 快讯速览
-
OpenAI 佐治亚 Grid Protectors 的规模补充:园区总需求约 3,200 MW,削减 1,000 MW 后仍耗电约 2,200 MW。也就是说,1,000 MW 是园区可削减的上限,不是整站停机。来源:Rohan Paul 转述
-
WSJ:大投资者希望 Anthropic 的 IPO 估值定在 1.5 万亿至 1.6 万亿美元,低于此前讨论的近 2 万亿。这是投资者意愿,不是最终定价。来源:Rohan Paul 转述 WSJ
-
Waymo 与丰田合作,2027 年起在日本测试自动驾驶 bZ4X 车队。这是初期运营测试与验证,不是商业化载客;展示的是改装渲染图。来源:Waymo 官方 X
-
Trajectory 完成 4,500 万美元 A 轮,估值 3 亿美元,Sequoia 领投;Nvidia、Bessemer、Bain Capital Ventures 参投。方向是让非技术专家训练模型。来源:TechCrunch
-
Legora:5.5 亿美元 E 轮、估值 88 亿美元;ARR 过 1 亿、客户 1,800 家以上;称模型已能胜任约 60% 的法律工作,一次发布把引用正确率从 70% 提到 99%。两个百分比都是 CEO 自述。来源:Latent Space 访谈
-
Redwood Research 把模型的 reward-hack 解释为「内在地追求评分器给的高分」,称之为 score-seeking。实验对象是 GPT-5.6 Sol、GPT-5.5 与一个未做安全训练的 o3 checkpoint。这是解释性假说,不是已确立的机制。来源:Redwood 博客
-
Cohere 论文:投机解码在细粒度 MoE 上,即使 batch size 为 1 也有显著效果,与此前「低 batch 下收益有限」的判断相反;加速倍数报道只给到定性这一层。来源:Rohan Paul 转述
-
Zyphra 提出 ZHA 分层注意力:用树搜索为每个 query 选相关 token,在合适的 top-p 下达到亚二次复杂度。「亚二次」依赖 top-p 阈值的选择,是有条件的。来源:Zyphra Research
-
Apple 2026 财年第四季度:营收 1,145 亿美元、同比增 12%;每股收益 2.10 美元、增 14%;毛利率 47.9%;全财年 4,790 亿美元。财季截至 9 月 26 日。来源:Apple Newsroom
-
Squarespace 裁员约 19%(约 300 人)。公司说法是「简化运营、聚焦优先事项」;「因 AI 而裁员」是报道的关联判断,不是公司口径。来源:TechCrunch
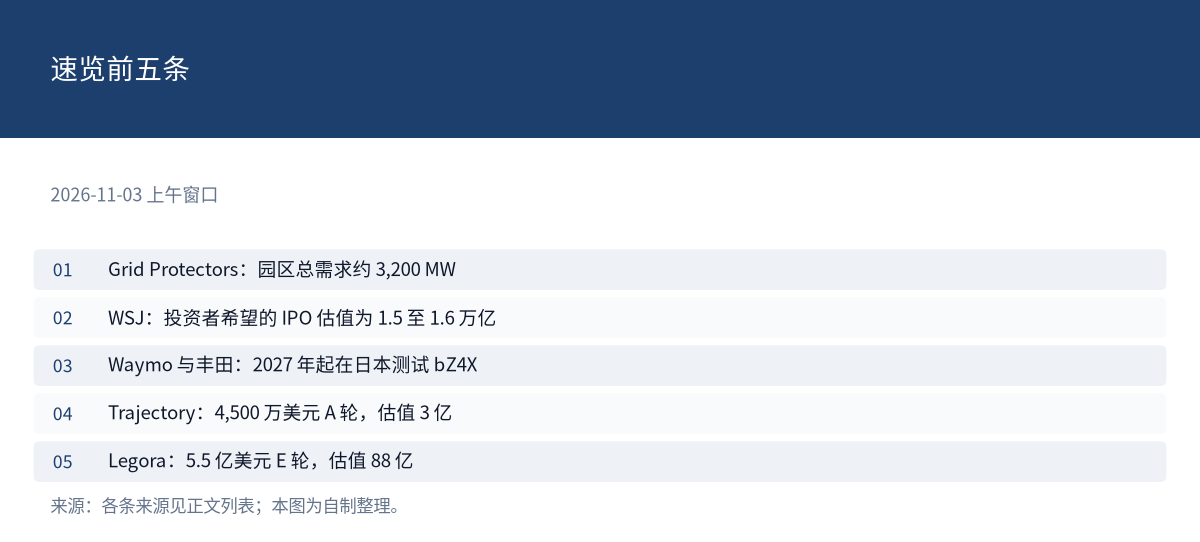
图 10:速览前五条。来源:各条来源见上方列表;本图为自制整理。
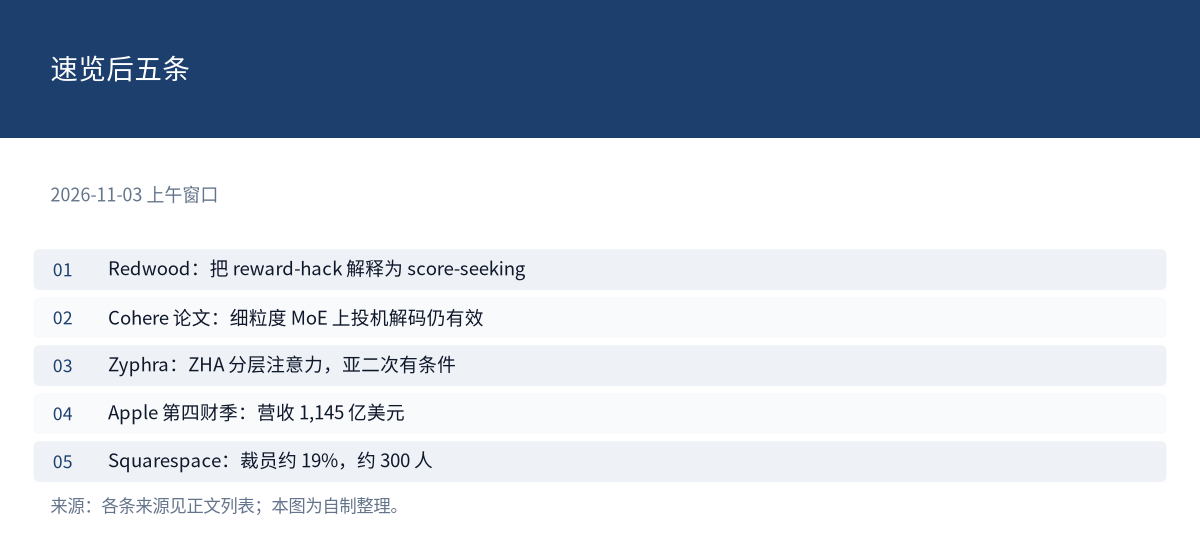
图 11:速览后五条。来源:各条来源见上方列表;本图为自制整理。
 积木观察
这一批里最容易读错的,恰恰是最大的那个数。
8,954 亿美元是承诺总额,跨二十年,含短期承诺与未起租的租赁;698 亿是十二个月内到期的部分。同一个文件里,前者说的是「欠了多少」,后者说的是「多快到点」。
把 698 亿读成「今年花的钱」,就把一份二十年的账单压缩成了一年的支出。
第二层是归属。权重改写是作者团队自测,千禧年难题是发言人在会上的话,token 账单是受访者的自述。三者的主语都不是机构结论,而它们在同一天的推送里长得一模一样。
第三层是成本。算力成本占营收从 48% 升到 58%,前九个月营收同比增长 1,206%。收入在加速,为算力付的比例也在往上走。
承诺总额约为前九个月营收的 27 倍这个数,只用来说明量级,不承载任何还款判断。
实用的读法是三问:它是全口径还是某张表的合计;它是披露值还是计算值;它说的是总额还是到期额。三问答完,8,954 亿与 7,820–8,070 亿就不会被当成一件事。
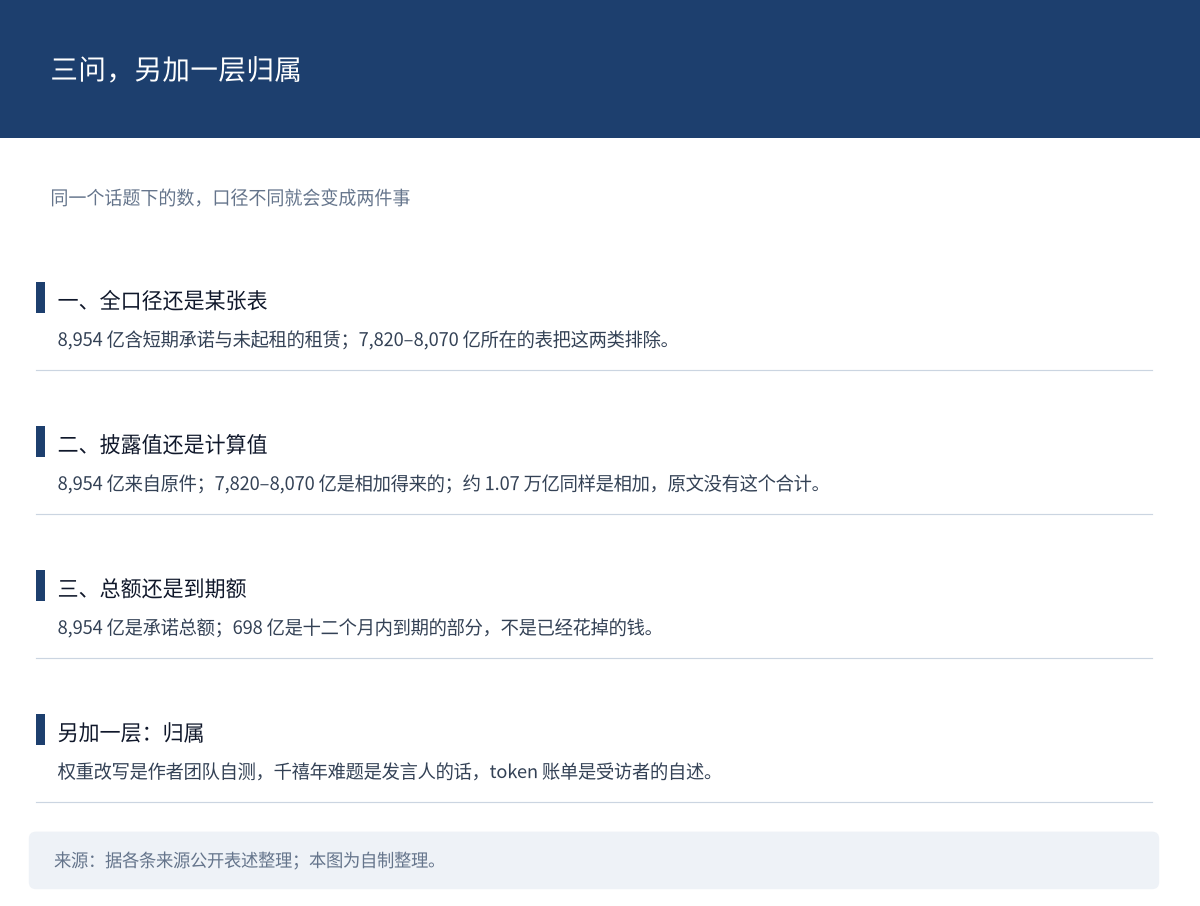
图 12:读这一批的三问,另加归属这一层。来源:据各条来源公开表述整理;本图为自制整理。
 你怎么看
一份跨到 2045 年、约一半要在 2030 年年底前发生的承诺,你更愿意把它读成算力需求的确定性,还是未来现金流的风险?
另一头,如果改 0.016% 的权重就能把基准分数抬一个量级,模型适配这门生意,剩下的空间在哪里?