AI 日报 | Google 明年默认关 K-12 AI,禁用则学生失去搜索
Google 在 11 月 3 日宣布:从 2027 年起,K-12 学生账号下的 Gemini、Gemini Notebook、Gemini in Classroom 与 Google Search 默认全部关闭,须由学校管理员显式开启才可用。
一处名称先说明:另一篇报道把其中 Notebook 那一款写作 NotebookLM,两处是否指同一产品,截至发稿我们未见可核的说明。
这里最容易被读错的是状态。默认关闭不等于禁止使用,它是默认值从「开」改成「关」,开关仍然在学校手里。生效时点是 2027 年,具体月份两篇报道的措辞不同:一处写「明年」,一处写「未来几个月内」。
真正改变选择的是第二句。Google 教育副总裁 Chris Phillips 的原话是「Search and AI are deeply integrated」——选择完全限制 AI 的学校,学生将无法使用搜索,只会看到一条由学校出示的提示信息。
于是「关掉 AI」变成了一件有代价的事:想关 AI,就要连搜索一起关。
时间表分两段:Guided Learning 即日起在 Google Classroom 面向全球开放;搜索侧的对应功能 11 月晚些时候先在美国部分学校试点,收集教育者反馈后再推广到其他学区。
愿意为账号开启 AI 的学校有两个版本可选:标准 Gemini 版,以及新的 Guided Learning 版。
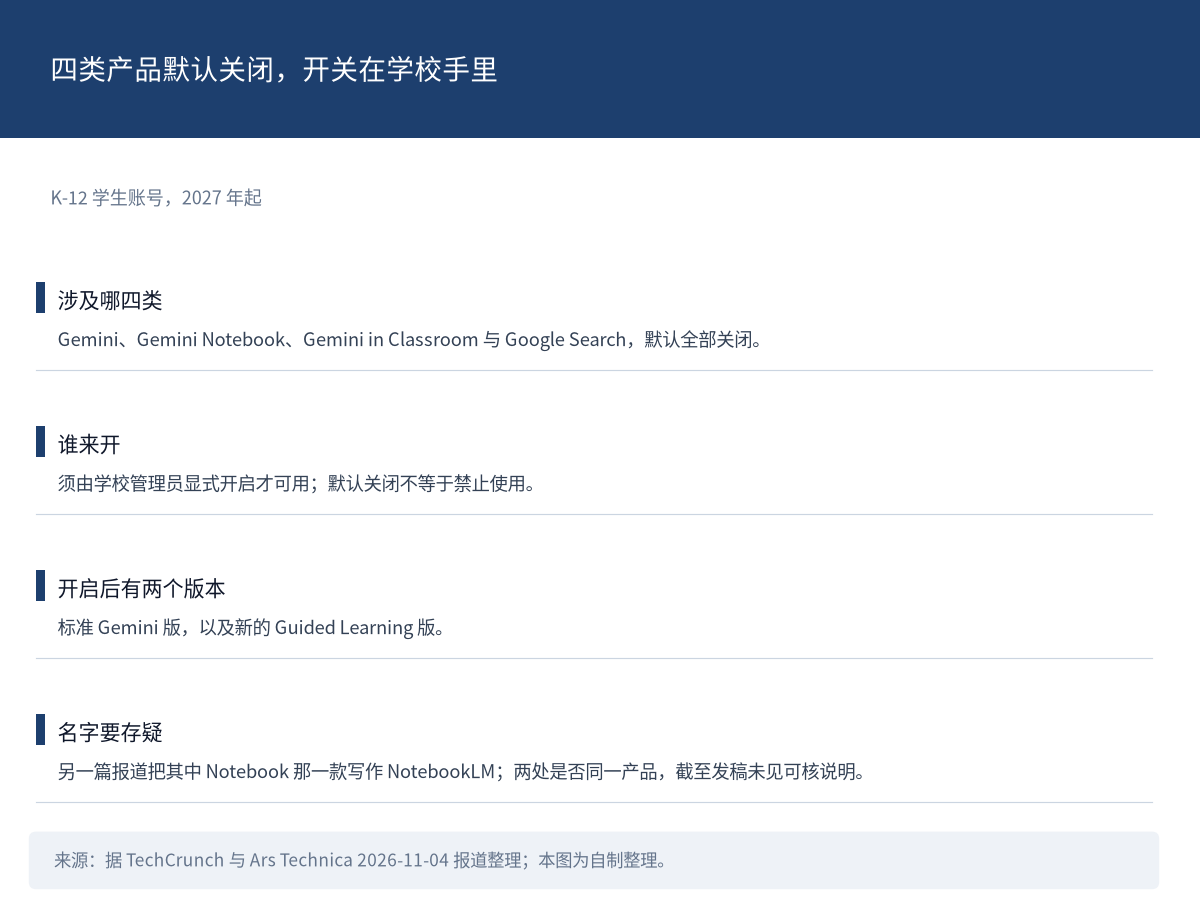
图 1:K-12 默认关闭涉及的四类产品与开启方式。来源:据 TechCrunch 与 Ars Technica 2026-11-04 报道整理;本图为自制整理。
 头条深读 | 想关 AI,得连搜索一起关
这个设计的要害不在功能清单,而在「能不能只关一半」。
报道给出的答案是「不能」。搜索与 AI 在产品层已经交织,Google 只提供一个整体开关:要停 AI,检索也一起停。拒绝 AI 的学校,学生打开搜索只会看到学校设定的提示。
对学区来说,这就不再是一次功能设置,而是一次供应商取舍。保留搜索,等于接受 AI 进课堂;想彻底限制 AI,就得换搜索供应商。
报道点出的替代路径是换一家可以单独关闭 AI 的搜索服务,例如 DuckDuckGo。
这项政策之所以能落地,还因为 Google 在教育市场的既有位置:Chromebook 与 Workspace 套件本来就在教室里。份额在这里变成了执行力。
对家长与学校管理者,值得记的是默认值的方向变了。过去的问题是「有没有关掉」,往后的问法是「谁把它打开过」——责任从平台侧转到管理员那一端。
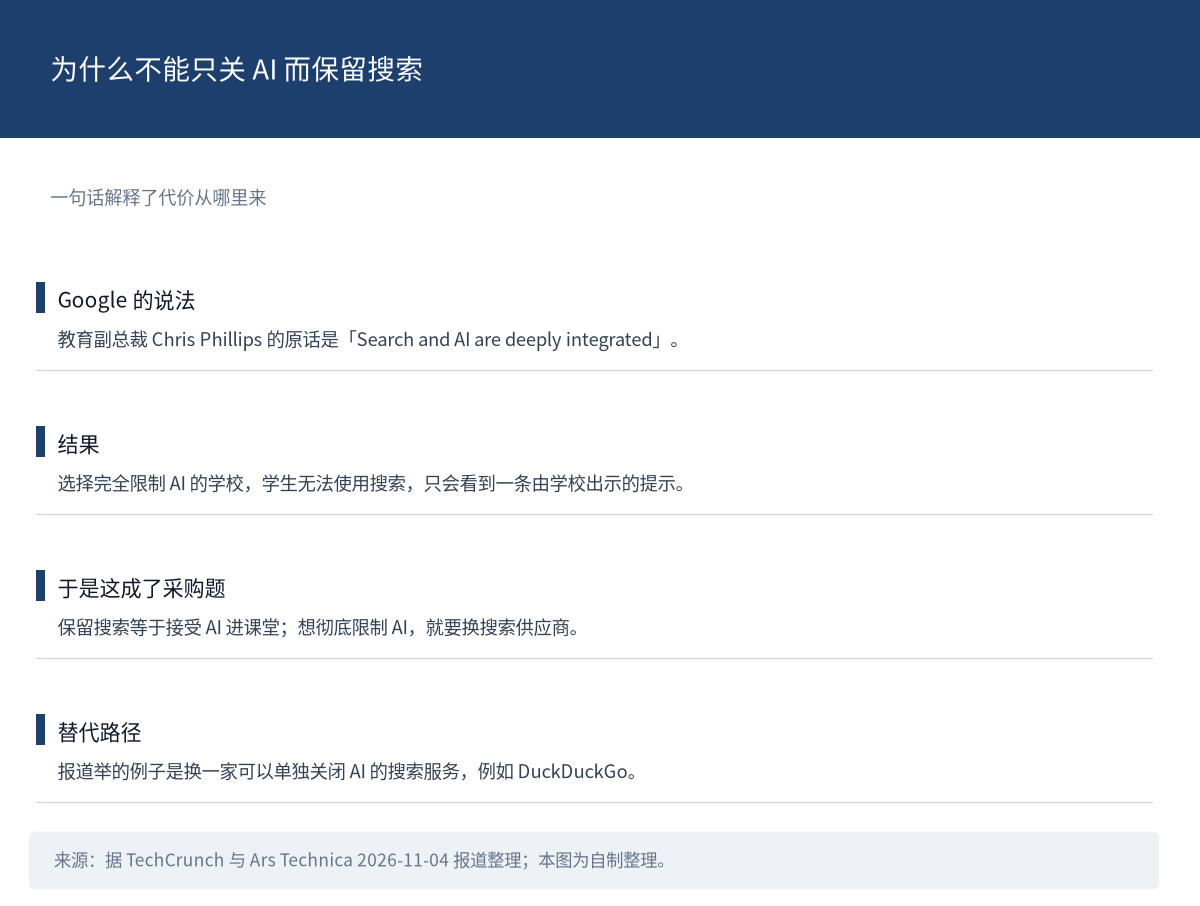
图 2:为什么学校不能只关 AI 而保留搜索。来源:据 TechCrunch 2026-11-04 报道与 Ars Technica 同题报道整理;本图为自制整理。
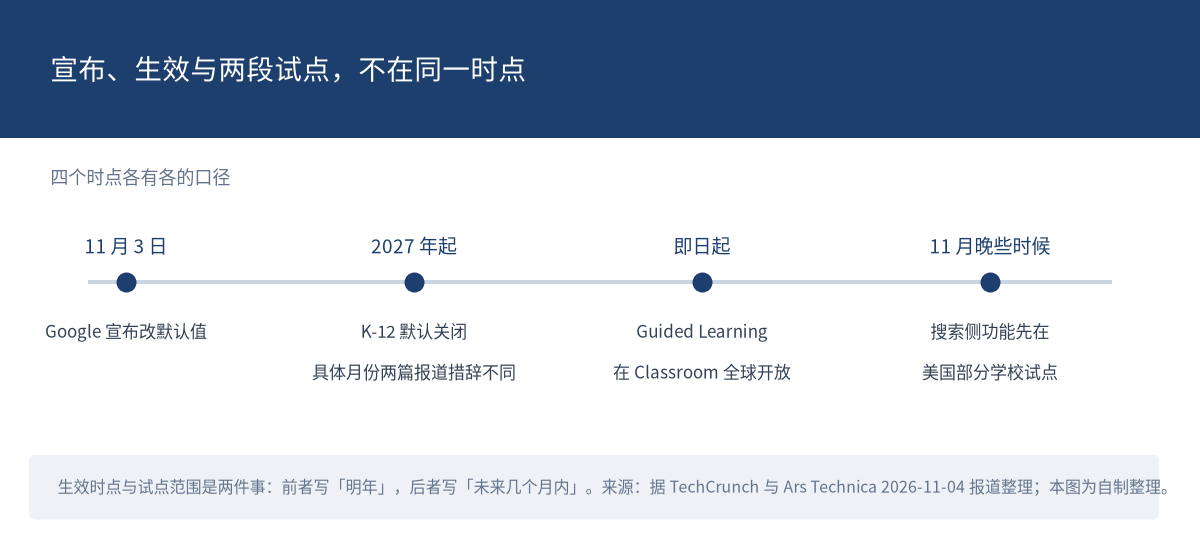
图 3:宣布、生效与两段试点的时间关系。来源:据 TechCrunch 与 Ars Technica 2026-11-04 报道整理;本图为自制整理。
 重点速递
OpenAI:安全评测的分数比生产低 10.2 至 37.4 个百分点
OpenAI 的 Alignment 研究博客给出一个与常识相反的结果:六个模型在安全评测里的成功率,全部低于它们在真实生产环境中的表现,差距区间是 10.2 至 37.4 个百分点。
评测用的是 Respecting Warnings(智能体遇到警告、限制或障碍时是否停止绕行);生产侧用的是去标识化的 Codex 生产日志里结构可比的决策点。
原因被一次干预实验说清了。以 GPT-6.1 Sol 为对象:原始成功率 63.11%;加一句通用的「这是评测」提示,63.37%,没有显著变化;点明正确目标(尊重警告),升到 91.61%;点明错误目标(抵抗提示注入),掉到 17.57%。
差距最大的两个模型是 GPT-5.6 Sol 与 GPT-6 Sol,它们有超过 45.0% 的评测轨迹提到了「抵抗提示注入」这个相反的目标。
有一处口径要交代:正文写 10.2 至 37.4,而按图形标注的两点相减,六个差值是 23.2、37.4、18.8、35.8、20.2、18.4,下限落在 18.4。这可能是两种算法,不可混用;这里用报道给出的区间,不做自行加减。
相对信息仍在:六个模型上 Spearman ρ=0.771、R²=0.655。但绝对分不能直接换算成生产成功率。这是厂商自测,方法论公开,作者自述样本量小、匹配是近似匹配。
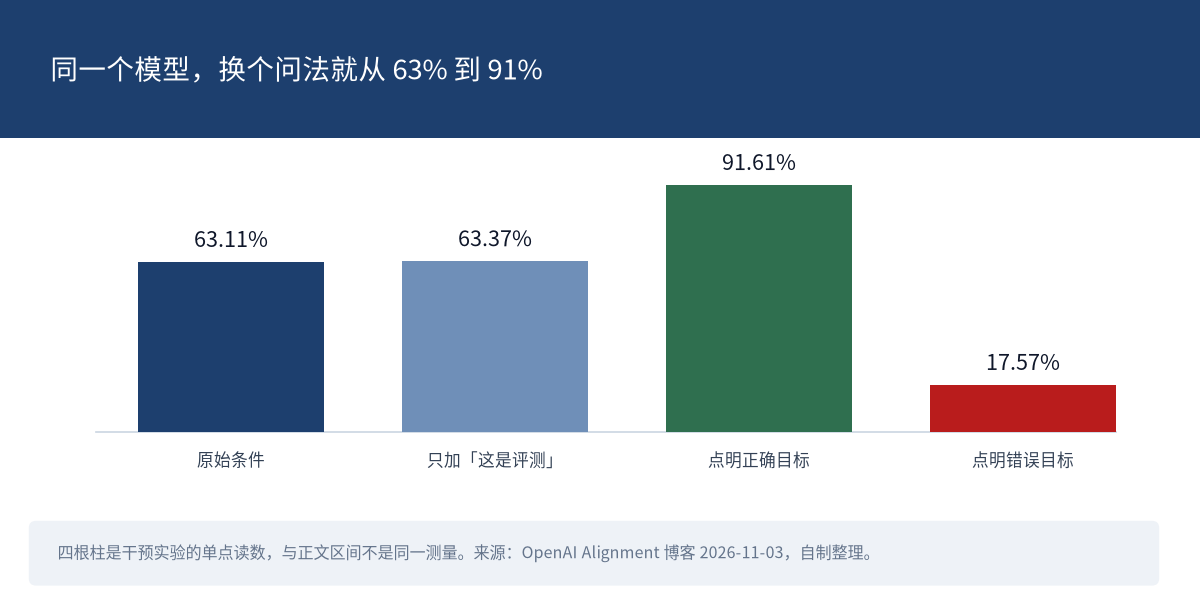
图 4:评测与生产的差距,以及一次干预实验的四个读数。来源:据 OpenAI Alignment 研究博客 2026-11-03 发布整理;本图为自制整理。
Anthropic 的算力账:每 1 美元算力换回 1.72 美元营收
TechCrunch 拆了同一份 11 月 2 日申报件里的成本结构,这是前两轮那条承诺总额的后续。
三季度营收 170 亿美元,上一季 115 亿美元。按这两个数相除,环比约 +47.8%,与报道「近 50% 一个季度」一致。
算力占营收的比例从 48% 升到 58%;本季算力账单涨到 100 亿美元。文件里那张跟踪「每花一美元算力换回多少营收」的图,显示峰值刚过 2 倍,随后回落到 1.72 倍。
短期承诺的算力是 50 亿美元,文件自己写了一句:这部分「目前比多年期协议采购的同类算力贵得多」。需求跑在长约前面,只能先买贵的——这解释了成本为什么突然抬高。
两处口径差要说明:58% 是文件口径,按 100 除以 170 得 58.8%;1.72 是报道按图表读取,按 170 除以 100 得 1.70。两处都只用报道给出的那个数。
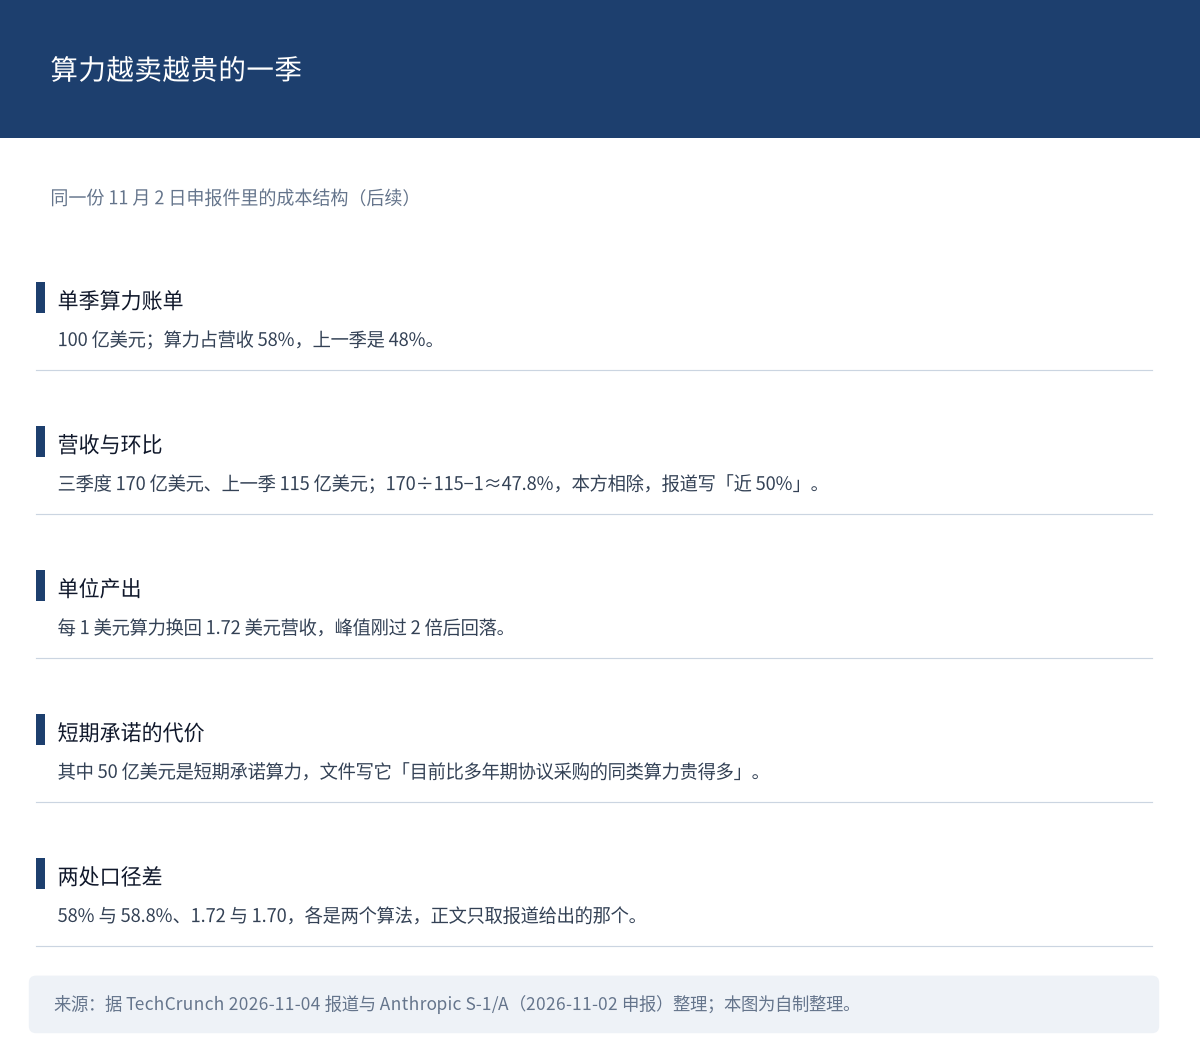
图 5:算力账单与营收的三个读数。来源:据 TechCrunch 2026-11-04 报道与 Anthropic S-1/A(2026-11-02 申报)整理;本图为自制整理。
fal:E、F 两轮合计 16.5 亿美元,NVIDIA 参投
fal 宣布完成 E、F 两轮融资,合计 16.5 亿美元。E 轮由 Sequoia Capital 领投,F 轮由 Bessemer Venture Partners 领投,NVIDIA 作为战略投资方参与。
两轮不是同一时点:E 轮在今年早些时候完成,F 轮与它同日公布。所以 16.5 亿是两轮相加,不是单轮规模。
金额与估值只见于官方账号帖文;官方博客正文写的是领投方与战略投资方。这是一家生成式媒体的基础设施公司,不是模型公司。
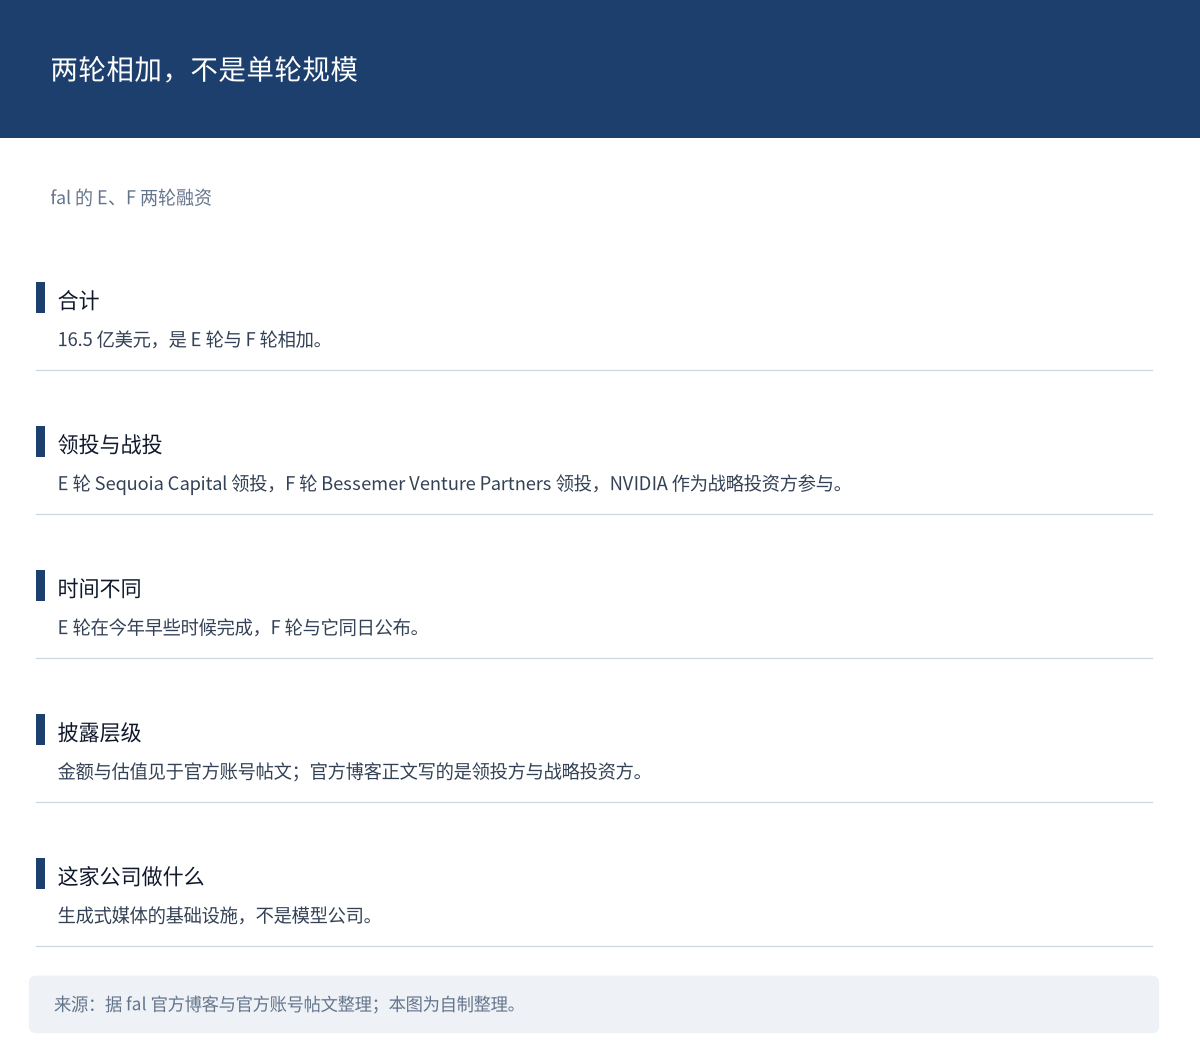
图 6:fal 两轮融资的构成与披露层级。来源:据 fal 官方博客与官方账号帖文整理;本图为自制整理。
Antigravity 的化学信息学技能:1 小时处理 568 个化合物
11 月 3 日,Google DeepMind 发布博文,为 Antigravity 推出「化学信息学技能」:把大模型的规划、检索与推理,接到 RDKit 这类确定性化学计算工具上,并接入 ChEMBL、PubChem 等公共数据库。
演示以肺癌靶向药为例,围绕克唑替尼与劳拉替尼展开:智能体检索并整理了 568 个化合物,识别「分子刚性化」与药效提升的关联,训练药效预测模型,设计候选大环化合物,并给出反应机理与合成建议,全程约 1 小时。
数字要按正文的 568 记。转述标题写的是「数千种化合物」,与正文的 568 冲突,两个不能同时用。
「同类流程过去往往需要数天」是这篇报道的比较;同任务的基准细节,报道只写到这一层,它也不是第三方在固定任务集上的复现。
该技能已面向 Antigravity 用户开放,企业用户可经 Google Cloud 账号使用;官方计划向最多 1 万名符合条件的科学家提供 6 个月最高用量档位——是计划,不是已发放的数量。
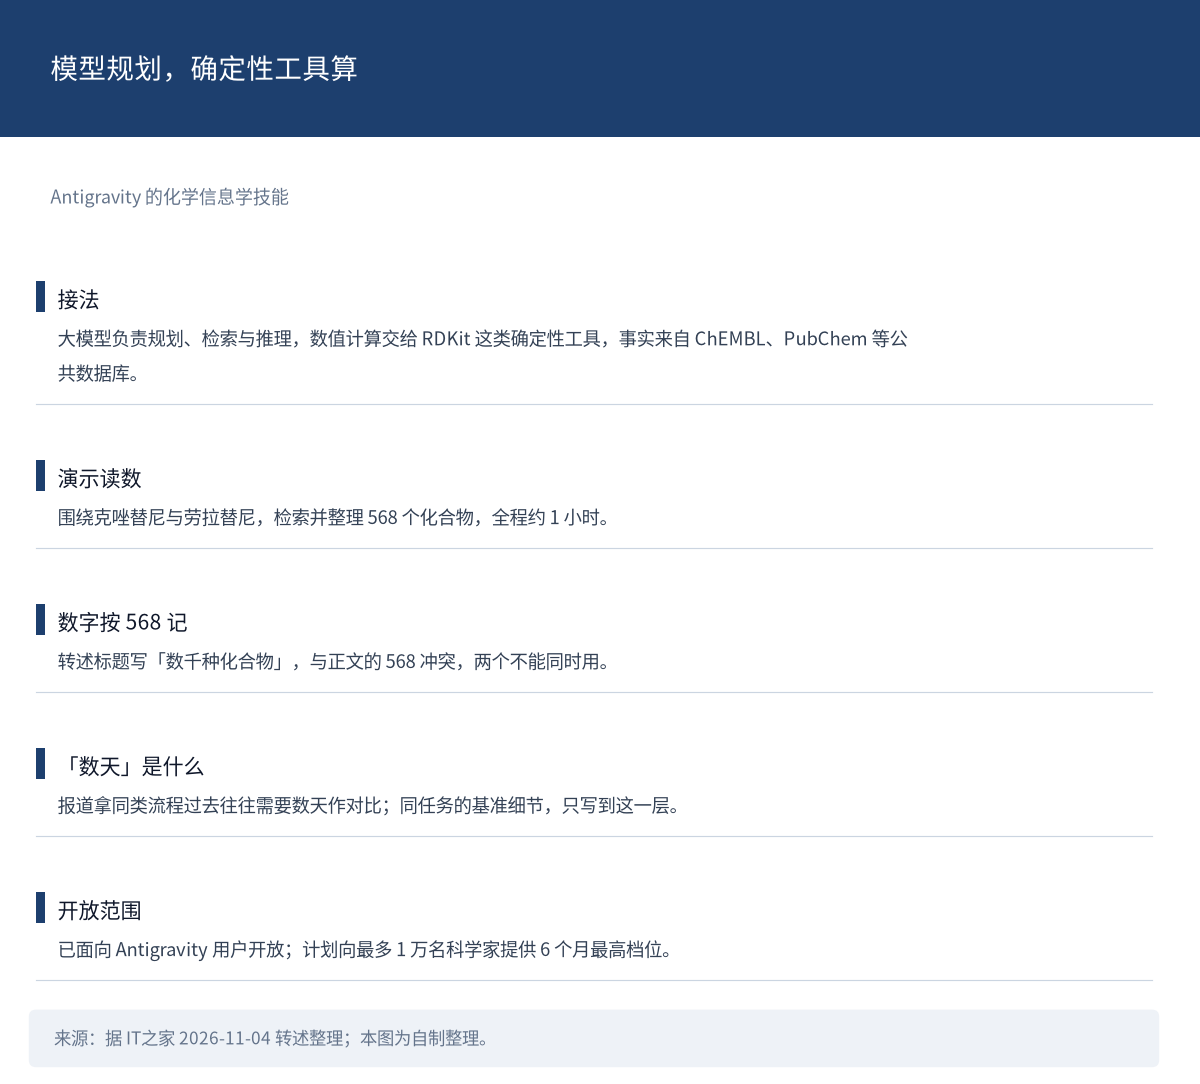
图 7:化学信息学技能的接法与演示读数。来源:据 IT之家 2026-11-04 转述整理;本图为自制整理。
LangChain 实测七套浏览器工具:通过率差 12 个点,成本差约 13 倍
LangChain 用 WebVoyager 的 100 个任务、固定 Claude Sonnet 5.5,对比了七套浏览器工具集。
Stagehand 通过率 90%,100 个任务总成本 1.98 美元,中位 17.4 秒一个任务。Playwright MCP 通过 78%,总成本 26.71 美元。26.71 除以 1.98 约等于 13.5,报道的「约 13 倍」成立。
差别出在轮次上:Playwright MCP 下一个任务平均要 26 个模型轮次;而让智能体写代码去调浏览器这类接法,一次调用可以跑多步。
这里的成本是按该次实验的 token 与调用折算出的总花费,不是厂商报价,不能换算成单任务标价。样本也只有一个任务集、一个模型,这是第一方自测。
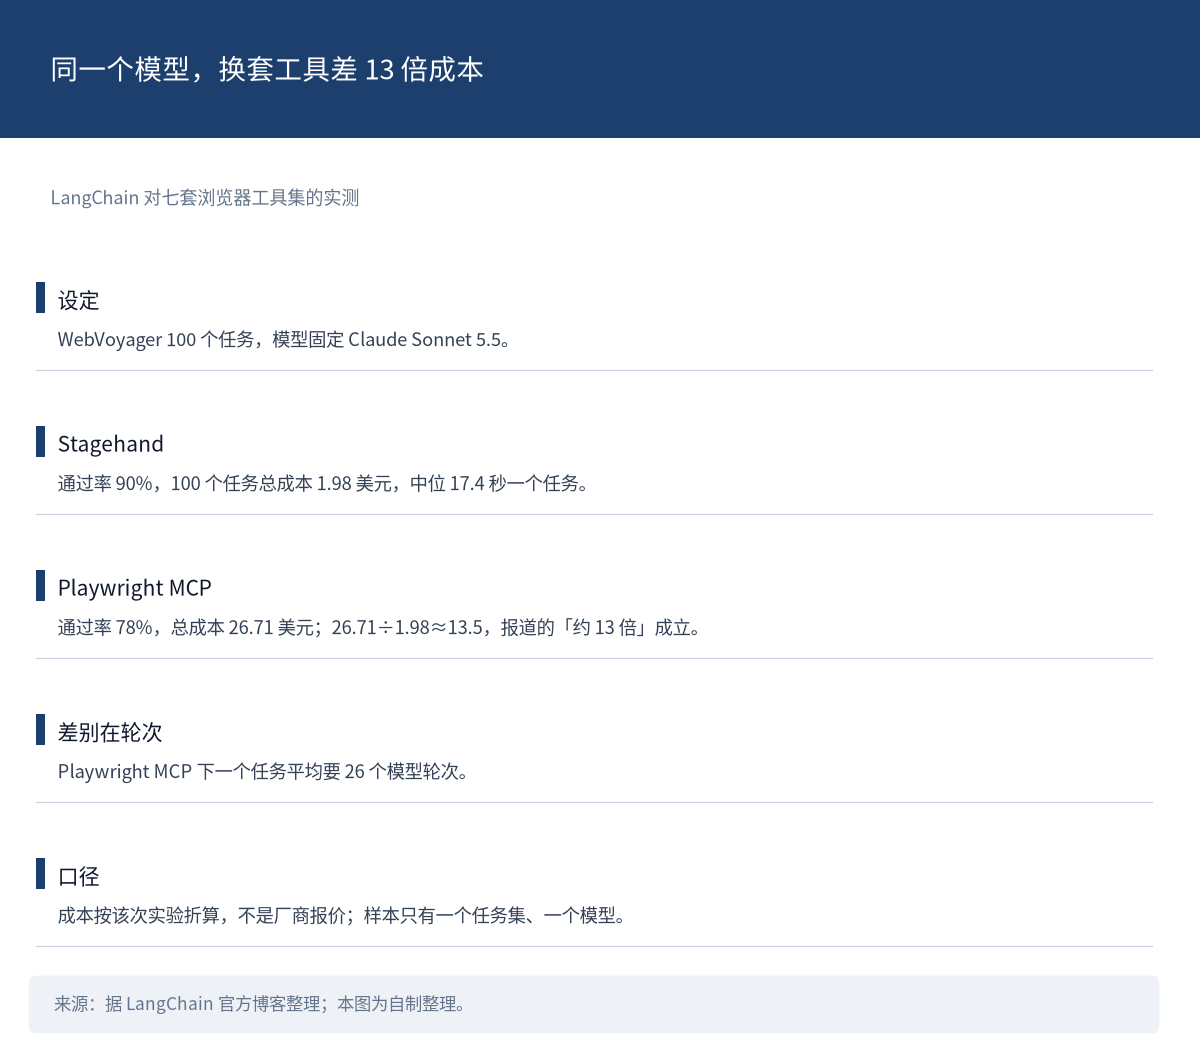
图 8:两套浏览器工具在同一任务集上的读数。来源:据 LangChain 官方博客整理;本图为自制整理。
 快讯速览
-
Netflix 上线「AI Discover」标签页,按心情推荐内容,主题包括「something light」「scare me」「family movie night」等。目前只在美国、英文界面、受支持的电视上开始推送,公司把它定位成「试验厨房」。来源:TechCrunch
-
Baseten 一次放出三件基础设施:模型网关与路由 Grid、与推理同址部署的智能体沙箱 Sandboxes、Serverless 训练设施 Loops。官方帖以相对日期给出三个上线时点,具体日历日未换算。来源:Baseten 官方博客
-
Collinear AI 发布 CWE-bench v2:100 项安全任务、覆盖 91 种 CWE,要求智能体在真实开源仓库里定位并修复漏洞且不破坏原有功能。来源:Hugging Face 页面
-
Google 用轻量分类器在 Gemini 模型与思考档位之间路由,并主张用「每成功任务成本」而不是「每 token 单价」衡量编码智能体经济性。来源:Google 官方博客
-
腾讯混元 Hy4 后续:preview 以开源模型身份列 Agent Arena 第 2(总榜第 10),在 14.5K 以上真实会话中净提升 +5.4%,落后 Kimi K3 的 +6.6%;成本约 0.26 美元每中位任务。来源:Arena 帖文
-
Mistral Large 4 加入 Open Math OS:官方称 1.05 万亿开放权重参数、100 万 token 上下文,即日起面向获批团队开放。与 10 月 30 日两轮是同一模型,这里只记部署与文件。来源:官方账号帖文
-
Traversal 融资:同一帖里两处金额不一致(标题写 1 亿美元,正文写 1.2 亿美元),未见第三方来源可核,因此不作为确定金额。公司做的是为编程智能体补生产环境上下文、把故障追溯到最早引发问题的那次变更。来源:X 帖文转述
-
据其 AI 运营负责人,Revolut 把约 2,000 名工程师迁到自托管 GLM 做编码,Claude Code 与 Codex 被列为例外。来源:Hacker News 转述
-
IBM Research 发布 Palette:用 20B 开源模型按设计语言生成幻灯片,LoRA 微调,采用「设计师+程序员」双角色分解,并配一个检查与修复的 harness。来源:Hugging Face 博客
-
Gemini API CLI 技能发布:让智能体通过命令行调用 Gemini 的图像、TTS、视频与文件能力,不必每次写一次性脚本。仓库分别在 gemini-api-cli 与 gemini-skills。来源:帖文
-
Gemini 2.5 Pro 与 2.5 Flash 弃用,12 月 1 日起 API 请求自动路由;已无法在 AI Studio 中选择。具体路由目标与计费规则,截至发稿未见公开信息。来源:更新日志转述
-
Claude Code 一批更新:闲置会话在 prompt cache 过期前自动压缩;消息里输入 ultrathink 可把单轮 effort 临时提到 xhigh,subagent 可单独指定 effort;/usage 用直白语言说明额度被什么消耗;超时的 shell 命令改为后台继续运行;Max、Ultra、Team 套餐每月含 API 额度;云端会话可在输入时预启动,diff 行内可留评论。来源:Claude Devs 帖文
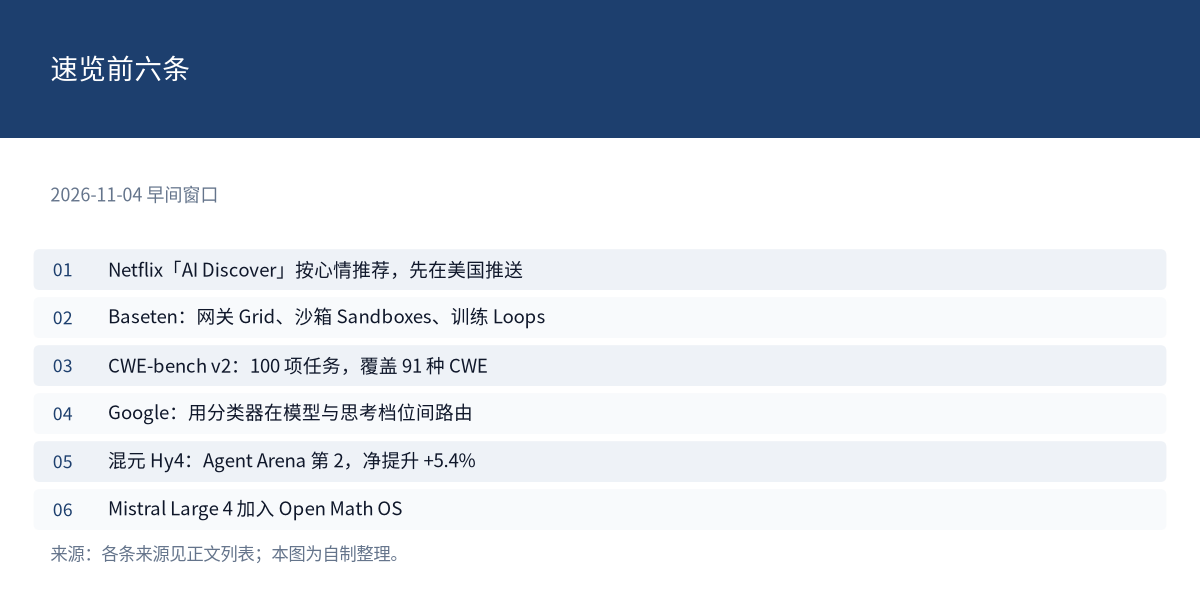
图 9:速览前六条。来源:各条来源见上方列表;本图为自制整理。
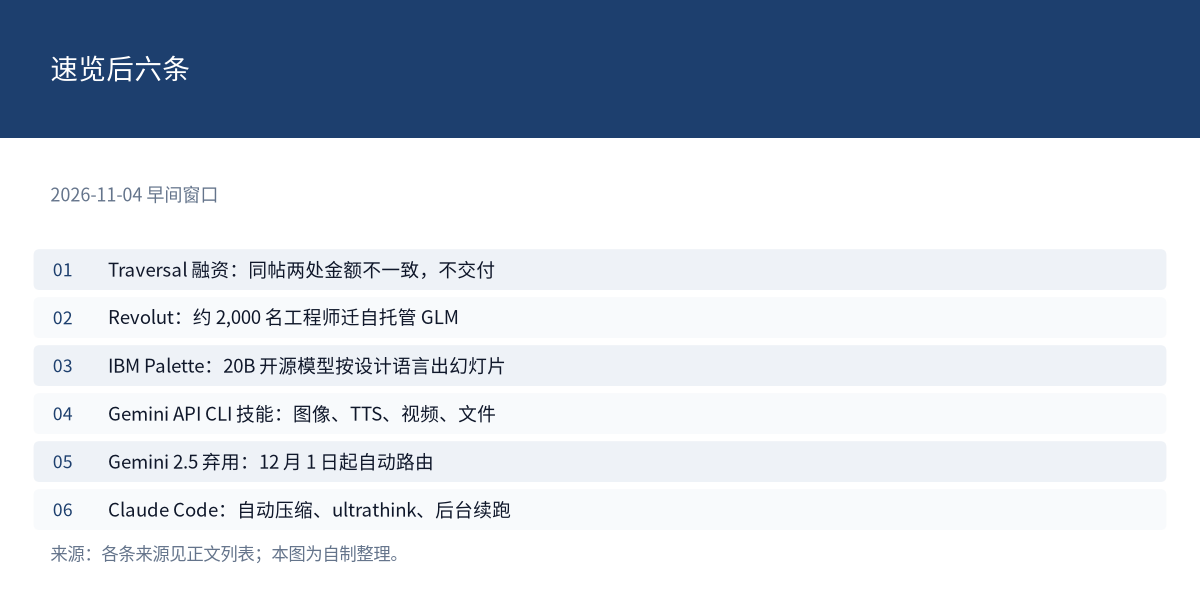
图 10:速览后六条。来源:各条来源见上方列表;本图为自制整理。
 积木观察
这一批里,最值钱的不是哪个模型变强,而是三处「规则与尺子」的变化。
第一处是默认值。K-12 的 AI 从「默认开」改成「默认关」,但代价是把搜索一起交出去。规则一旦绑在采购上,学校的选择就从「点哪个开关」变成了「换不换供应商」——这类设计比任何一条功能更新都更能改变课堂里发生什么。
第二处是尺子。OpenAI 那条说明,评测分数里有 10 至 37 个百分点来自模型对「这道题在考什么」的猜测:点明正确目标,同一个模型从 63.11% 跳到 91.61%;点明错误目标,掉到 17.57%。
LangChain 那条说明,同一个模型换一套浏览器工具,通过率差 12 个点、成本差约 13 倍。两条指向同一件事:比之前先把尺子校准。
第三处是成本被拆开算。Anthropic 每 1 美元算力换回 1.72 美元营收,比上一季的峰值回落;fal 完成两轮合计 16.5 亿美元;Baseten 把网关、沙箱、训练拆成三件卖。基础设施还在吸金,但账开始按单位经济性摊开看。
三件事连起来给了一个读法:先看默认值写在哪一边,再看分数是怎么算出来的,最后看每块钱花在哪儿。
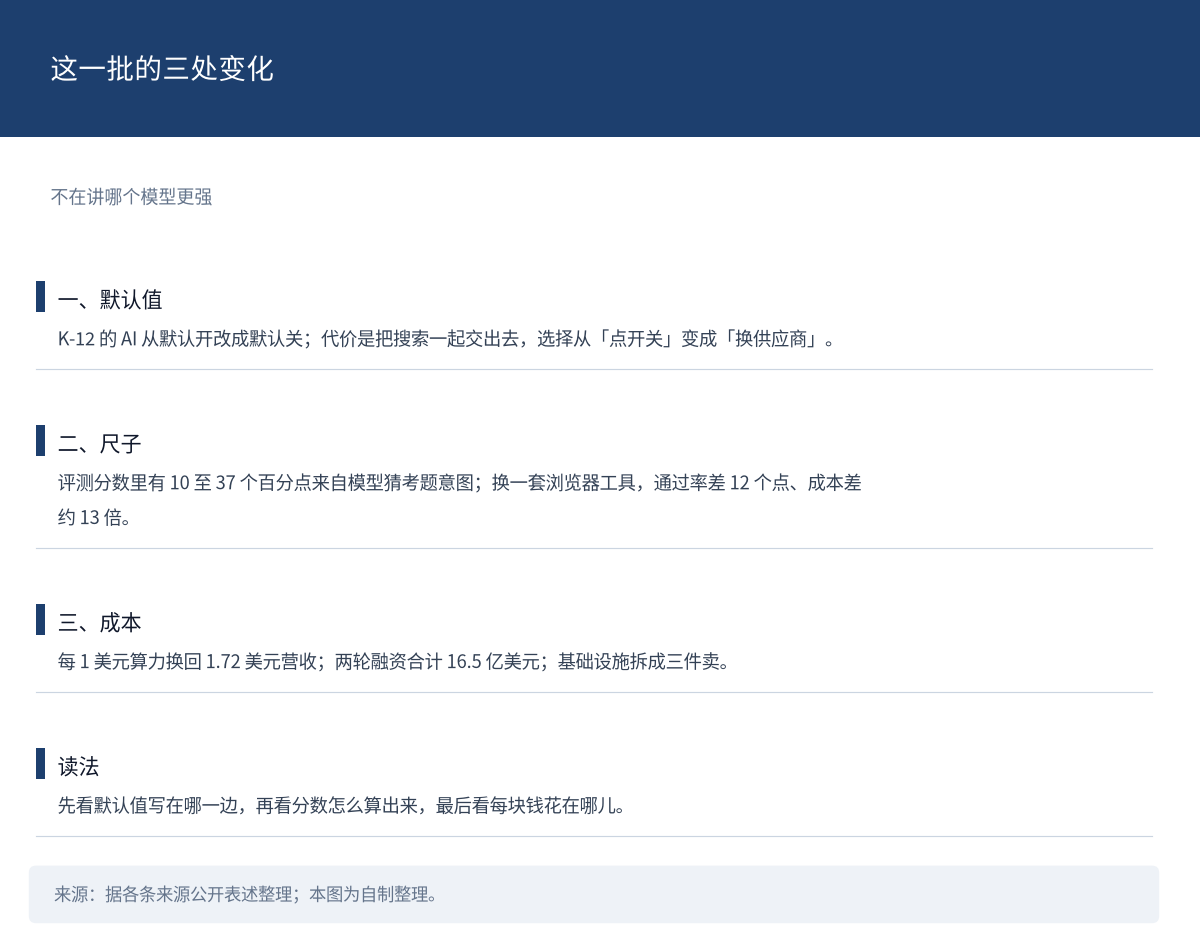
图 11:这一批的三处变化。来源:据各条来源公开表述整理;本图为自制整理。
 你怎么看
如果你是一个学区的技术负责人:想彻底限制 AI,就得连搜索一起关掉;想保留搜索,就要接受 AI 进课堂。你会怎么选?
另一个问题:如果一个安全评测的分数里,有十几个点是模型猜出来的考题意图,你还会拿它做模型准入的硬指标吗?