AI 日报 | Google 接手园区,投 170 亿美元
Google 将在怀俄明州建州内第一个数据中心,长期投资 170 亿美元。项目所在的园区,原本属于开发商 Crusoe。
Crusoe 在 11 月 6 日确认,把怀俄明州东南部这个还没建完的项目卖给了 Google。收购对价,公开材料里没有数字;170 亿美元是 Google 自己的建设投资口径,两件事不能混成一句「花 170 亿买下」。
一个交付不了的园区,最后由客户自己接过来建。这是这条的实质。
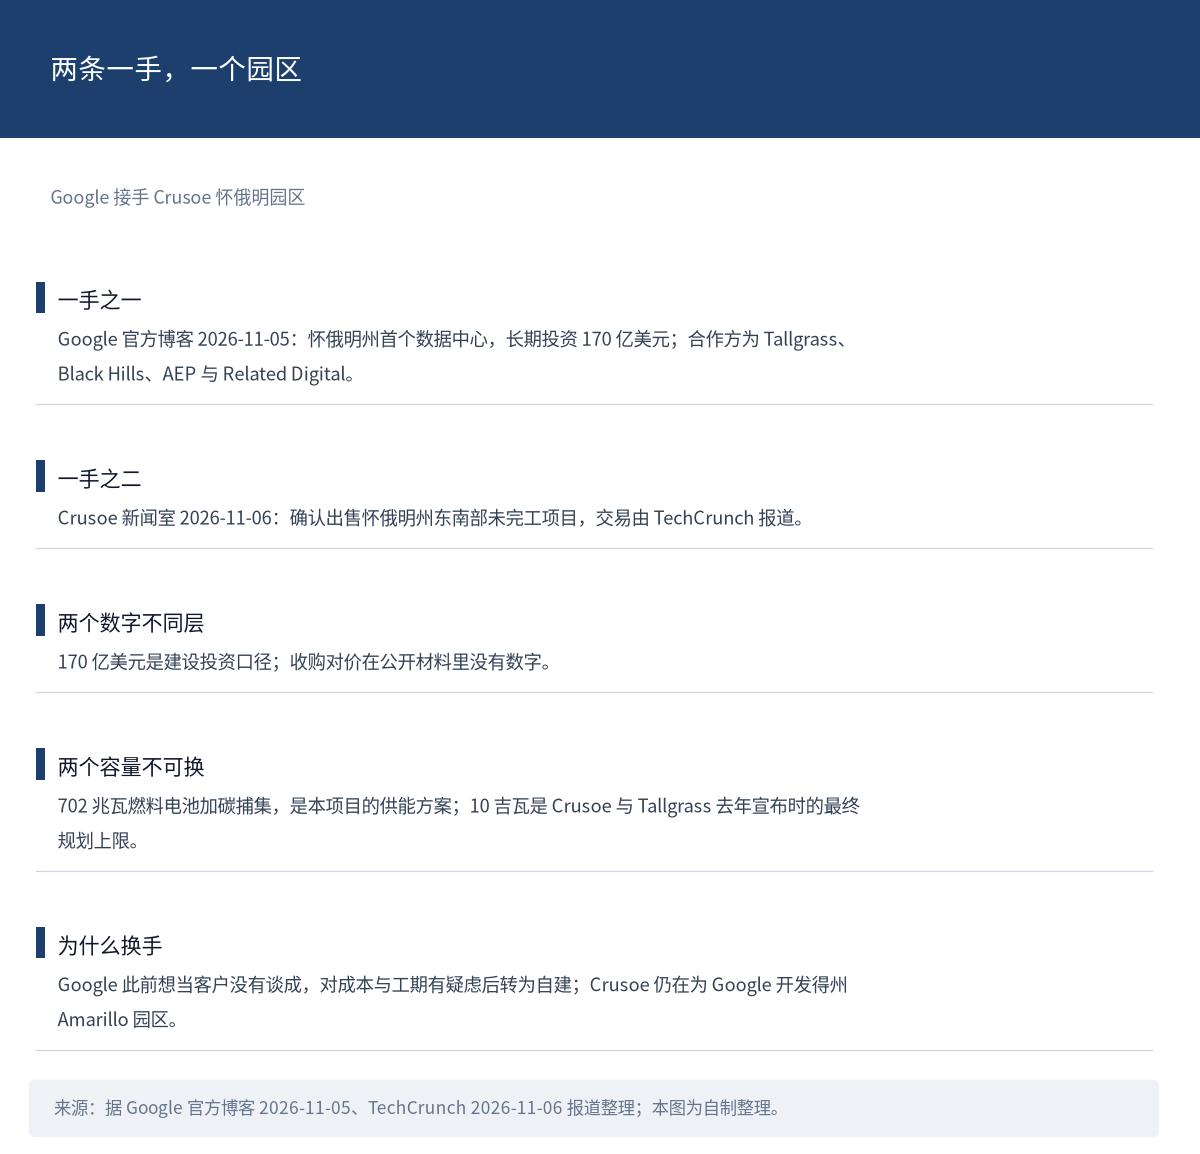
图 1:两条一手的分工,与两个不能相加的容量口径。来源:据 Google 官方博客 2026-11-05、Crusoe 新闻室 2026-11-06(经 TechCrunch 转述)整理;本图为自制整理。
 头条深读 | 客户变成了施工方
Google 官方博客的说法是,这是公司在怀俄明州的第一个数据中心,合作伙伴包括 Tallgrass Energy、Black Hills Energy、American Electric Power 与 Related Digital。
供能方案写的是 702 兆瓦燃料电池加碳捕集,Google 称其为同类最大规模的商业规划。「州内首个」与「同类最大」,都是 Google 自己的表述。
另一个数字常被拿来一起说。Crusoe 与 Tallgrass 去年宣布该项目时,规划最终扩至 10 吉瓦。前者是本项目的供能方案,后者是原规划的最终上限,两者不能相加,也不能互相换算。
为什么是客户接手?据 TechCrunch 报道,Google 此前想当这个项目的客户,没有谈成;对 Crusoe 管理下的成本与工期有疑虑,转而自己做开发。
Crusoe 并没有完全退出。它仍在为 Google 开发得州 Amarillo 附近的园区。
真正的变化在风险归属。大型 AI 园区过去是「开发商建、客户租」,现在多了一条:交付风险回到客户自己身上。
这也让开发商的估值与交付能力开始脱钩。Crusoe 今年 9 月刚融 39 亿美元、估值 309 亿美元;一个月后,它把一个在建项目卖了出去。
对行业,可读的有三层:租与建在重新定价;电力与并网的复杂度推到了客户侧;买地、供电、施工这三件事,正被同一家公司一起承担。
 重点速递
国会给了日期,也给了清单
美国众议院三个委员会的主席在 11 月 5 日联名致函英伟达 CEO 黄仁勋,要求他就与 Megaspeed 高管 Alice Huang 的往来,出席一场联合闭门简报。
三个委员会分别是外交事务委员会(主席 Brian Mast)、中国问题特别委员会(主席 John Moolenaar)、常设情报特别委员会(主席 Rick Crawford)。委员会名单与职衔都出自国会新闻稿。
日期也定了:新闻稿希望简报安排在 11 月 18 日,并要求黄仁勋在 11 月 11 日之前确认,或另提时间。
问询清单不止一条。除了与 Alice Huang 的往来,新闻稿还明列「英伟达针对外国对手间谍活动的安全协议」。这一条比「要求简报」本身更具体。
对 Alice Huang 的定性要分两层读。姓名与「Megaspeed 高管」身份,出自国会 11 月 5 日的新闻稿;「情报资产」与被中国国家安全部招募,出自《纽约时报》的报道,此处经 The Verge 转述。
还有一处限定不能省。国会新闻稿写的是「a publicly reported PRC intelligence asset」,也就是「公开报道过的中国情报资产」——这个限定词,是国会自己加的。
对产业的落点在执行层。芯片公司今后要能回答的不只是「卖给了谁」,还有「谁见了谁、谈了什么、内部防谍流程是什么」。
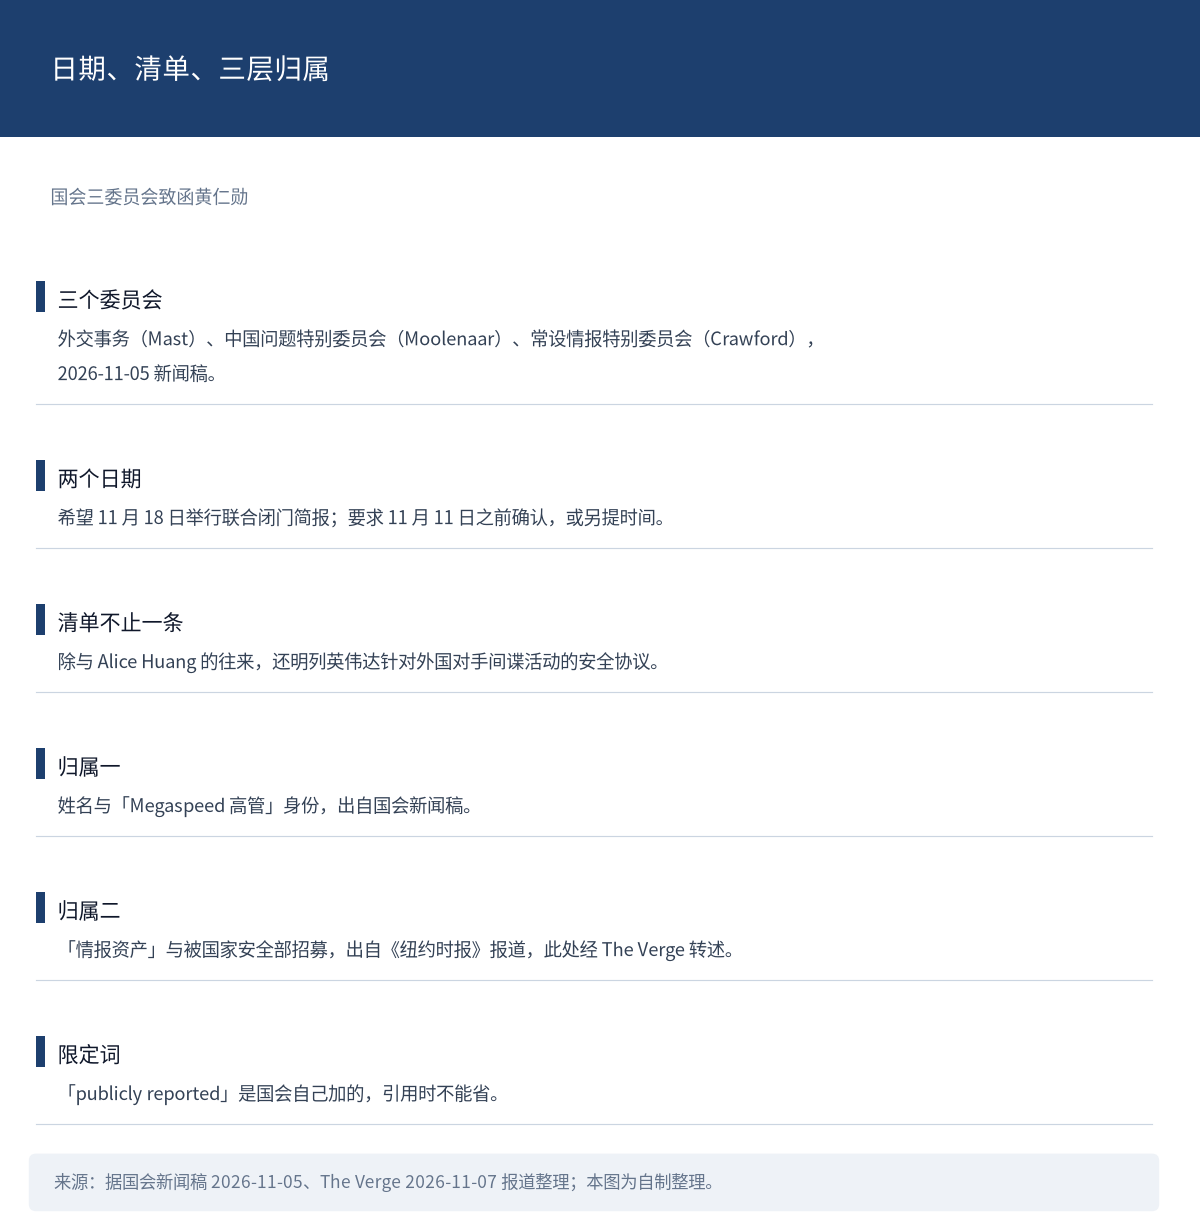
图 2:日期、清单与三层归属。来源:据国会新闻稿 2026-11-05 与 The Verge 2026-11-07 报道整理;本图为自制整理。
60 万块 H200 停在香港仓库
据 Reuters 报道、经 X.PIN 转述,约 60 万块英伟达 H200 芯片正闲置在香港的仓库里。
阻碍不在华盛顿。报道称,卡点在北京这一侧:中国正以每家科技巨头约 1 万块的速度,小批量发放进口许可。
结果之一是价格。转述称国内服务器价格上涨约 3 倍;这个倍数没有随转述给出基期、机型与统计范围,只能按「报道如此说」来读。
这条补的是一个方向:出口管制的闸门,从卖方国移到了买方国。许可给了,货仍不动。
对英伟达,这是库存与确认收入的节奏问题;对算力租赁与国内云厂商,是供给节奏问题。
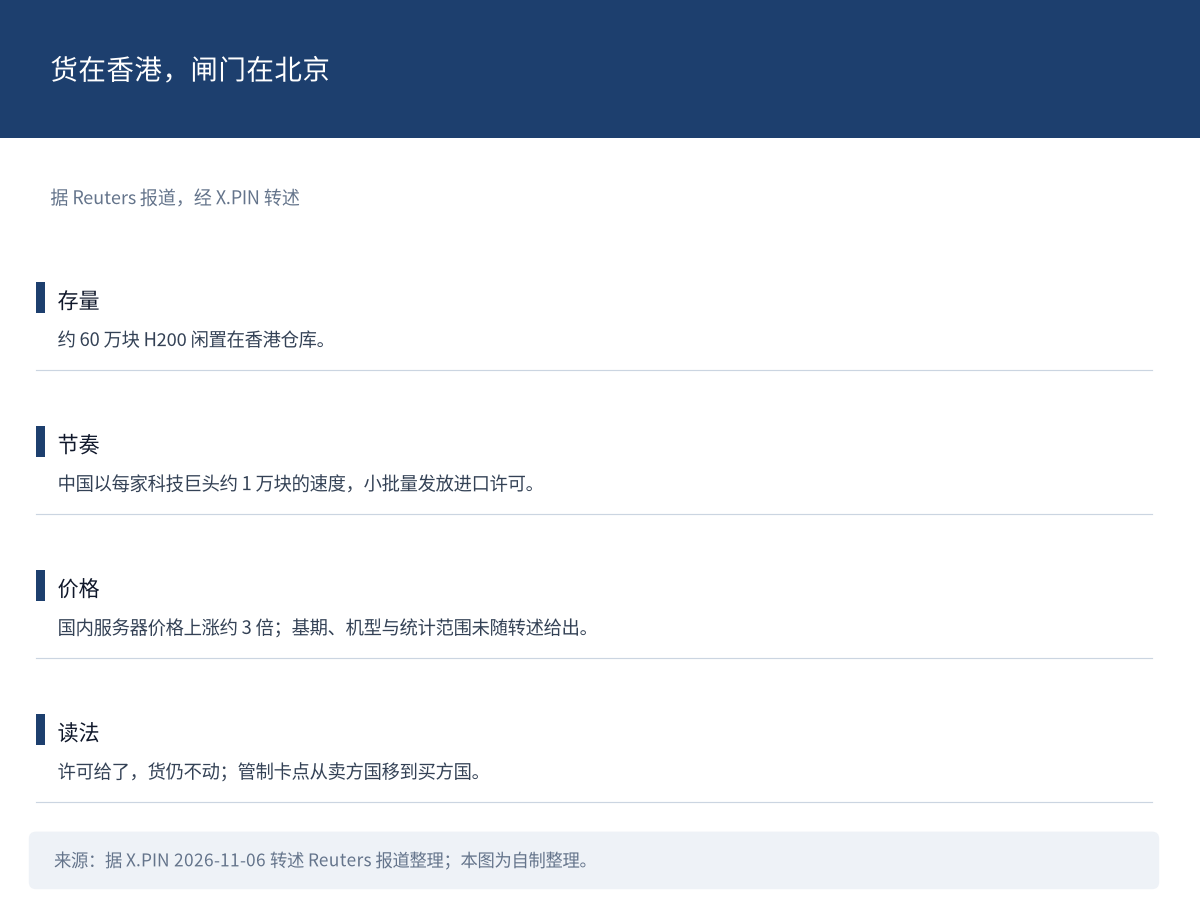
图 3:60 万块的去向,与一个缺基期的倍数。来源:据 X.PIN 2026-11-06 转述 Reuters 报道整理;本图为自制整理。
五个估值,没有一个成交价
Anthropic 的 IPO 出现了一个新变量:路演能不能按时开始。据 Reuters 报道、经 The Decoder 转述,潜在投资方对此存疑;若 AI 股继续承压,公司可能推迟发行。
估值则出现了五个数字,分属不同来源与时点:
- 2 万亿美元:9 月时的目标上限,也是一个月前的市场预期;
- 1.5 万亿美元:原计划估值,投资者认为也偏高;
- 1.1 万亿美元:彭博引部分潜在买家的看法,经 TechCrunch 转述;
- 1 万亿美元:The Decoder 引「一名投资者」提出的数;
- 1.2 至 1.3 万亿美元:另一路彭博口径。
这五个数不能拼成一个区间,也不能互相印证。它们各自带着来源与时点,谁都不是成交价。
压价的原因写在两处:公司仍在亏损、在为扩张基建烧钱;投资者还在等 10 月营收,而据 The Decoder,修订版 S-1 里还没有这项。
同一批报道里的 OpenAI 侧是另一条线。彭博称其新一轮首关 110 亿美元已完成、估值 1.25 万亿美元;该轮还没有关闭,预计数周内完成,总额可能约 200 亿美元。
110 亿是已到账的首关金额,200 亿是该轮可能的总额,两者不是同一层。
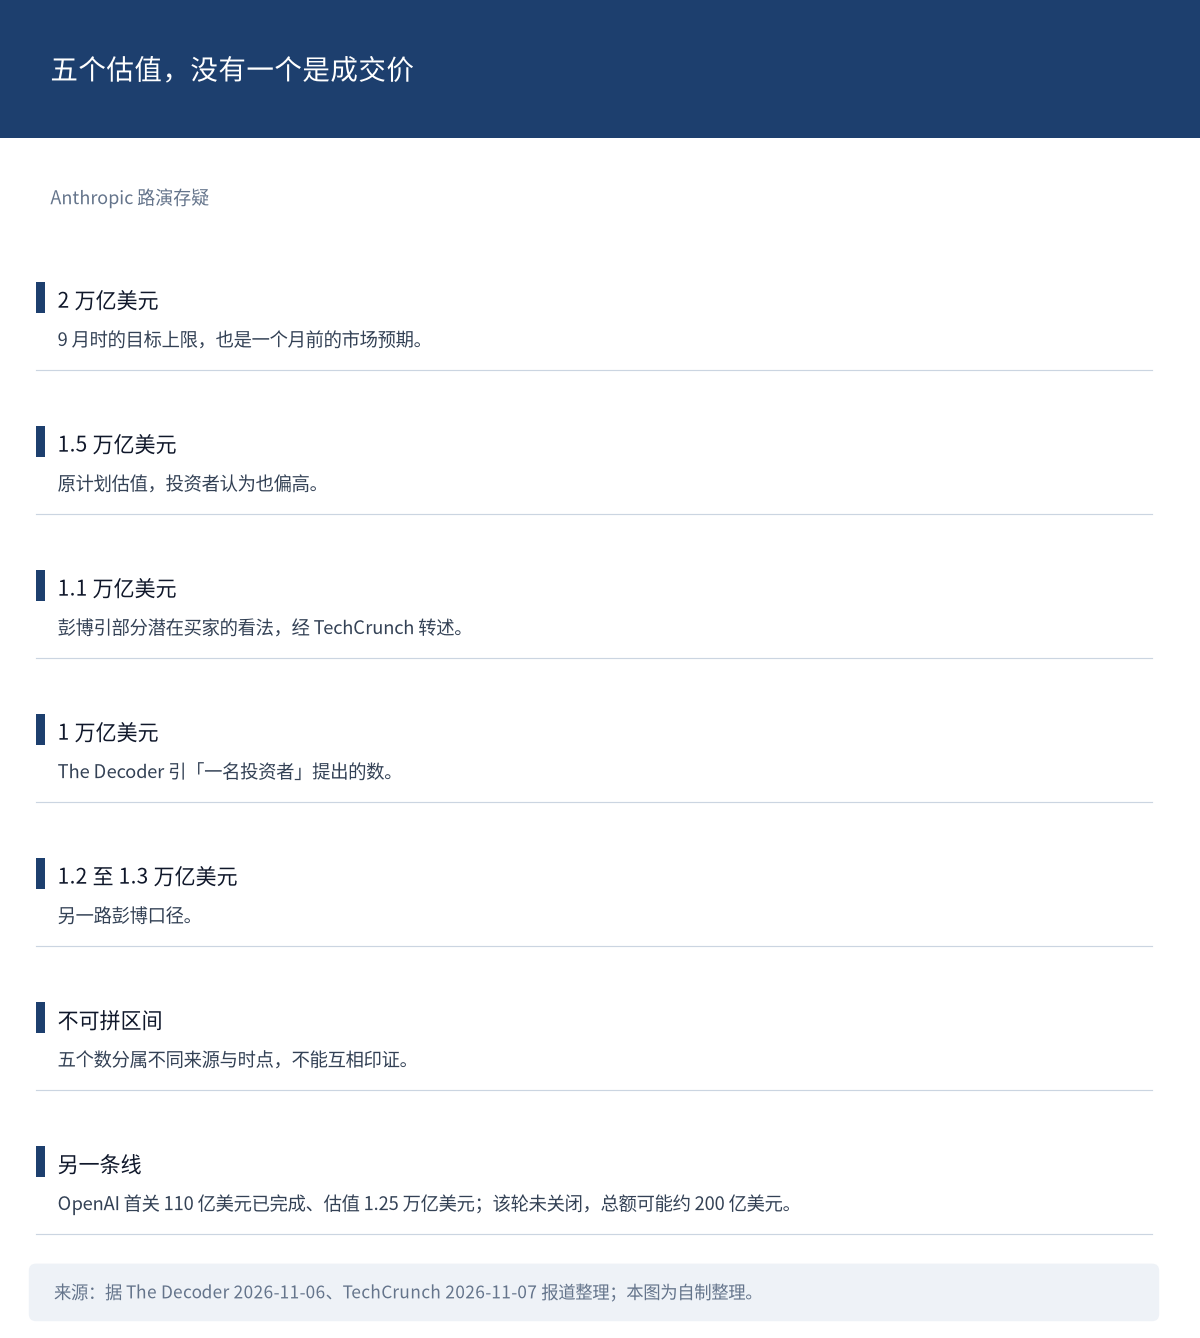
图 4:五个估值,各自的来源与时点。来源:据 The Decoder 2026-11-06、TechCrunch 2026-11-07 报道整理;本图为自制整理。
记忆不是记得多,而是记什么
Anthropic 在 11 月 6 日发布了一篇工程博客,把智能体的记忆拆成四层。
从下往上:可检索的事件日志(transcripts)、Claude 自己写的笔记(memory notes)、从日志与笔记计算出的表征(如 wiki),以及每次会话预加载的注入上下文。
四层之间是双向的。dreaming 是离线的整理环节,既能把下层内容提炼上去,也能拿原始日志反向校验、修正上层笔记。
第一组读数是 CL-Bench 1.0 的数据库任务,纵轴为任务平均得分,六个模型各自对比「无记忆」与「有记忆」两种设置。
强模型这一侧:Opus 5.5 从 0.655 升到 0.838,Sonnet 5.5 从 0.644 到 0.833,Opus 5 从 0.564 到 0.828。
弱一些的模型同样受益,但幅度小得多:Opus 4.7 从 0.383 到 0.700,Sonnet 5 从 0.306 到 0.610,Sonnet 4.6 从 0.330 到 0.364。
同一套机制,对 Opus 5.5 带来 0.183 的提升,对 Sonnet 4.6 只有 0.034。差距不在记忆本身,在于模型会不会挑该记的东西。
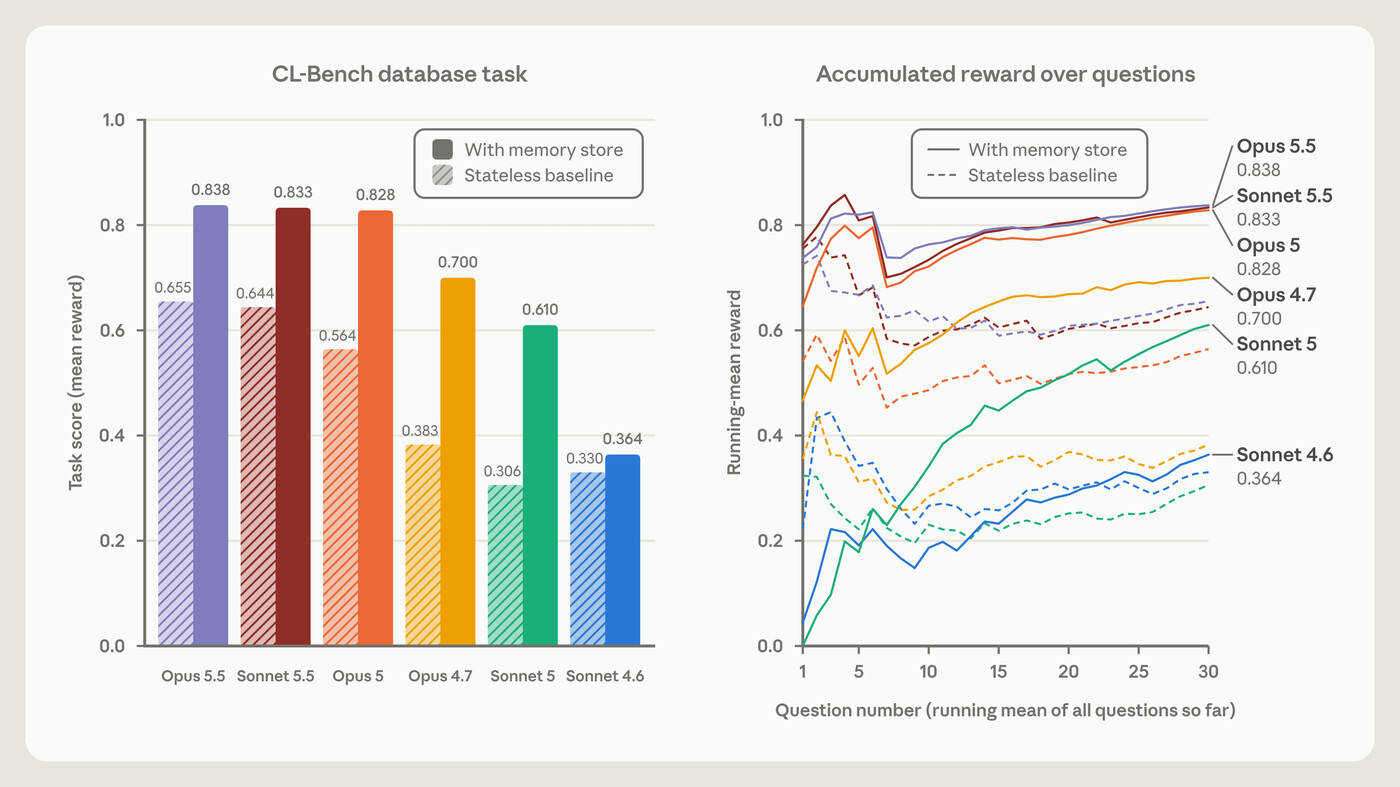
图 5:CL-Bench 1.0 数据库任务的六个模型,斜纹柱为无记忆、实心柱为有记忆,纵轴为任务平均得分。来源:Anthropic 官方图表,非第三方实测。
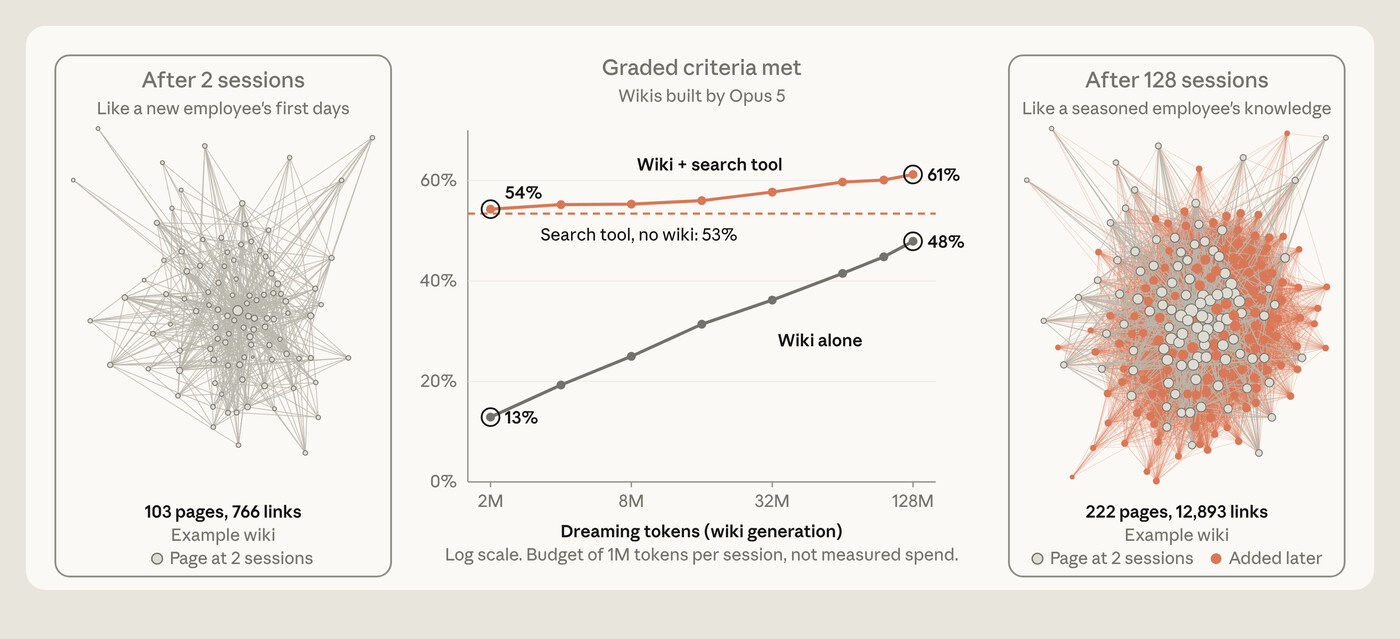
图 6:wiki 规模与答题得分,横轴为 dreaming token 预算,对数刻度,且是每会话 1M token 的预算而非实测消耗;单用 wiki 由 13% 升至 48%,wiki 加搜索由 54% 升至 61%,单用搜索恒为 53%。来源:Anthropic 官方图表,非第三方实测。
第二组读数关于「记什么」。在 Pokémon Red 里各跑一次、约 1 万步,Sonnet 3.7 写了 413 个记忆文件、225 个文件夹、97.8 万字符,只换来 1 枚徽章。
Fable 5 只写 9 个文件加 1 个 global.md,共 10 个文件、4.3 万字符,换来 4 枚徽章。
差别在于过期。Sonnet 3.7 把每回合屏幕上都能读到的状态也写进记忆,信息不断过期,后期花在翻记忆上的步数超过了玩游戏本身。
给规则反而更差。把记忆规则设为「只记失败」后,Opus 5 的记忆收益减少 0.234,Opus 4.7 减少 0.150,Sonnet 4.6 减少 0.020。对强模型,放手让它判断什么值得记,比预设规则更有效。
规模效应也有上限。用一家被收购公司(Stainless)约 35 万个文件、约 4.2 亿 token 的内部文档做 25 题评测,dreaming 从 2 个会话扩到 128 个会话。
分数随 dreaming 的 token 预算上升(每会话 1M 预算,非实测消耗):单靠 wiki 答题从 13% 升到 48%,wiki 加搜索从 54% 升到 61%,单用搜索停在 53%。
wiki 本身也长大了:从 2 个会话时的 103 页、766 条链接,到 128 个会话时的 222 页、12,893 条链接。
反面案例同样重要。某个 LAB 任务里,wiki 相对搜索没有明显增益,多数评分点用单份文档就能检索到。还有一个 wiki 长得比语料本身还大:10 个文档共 115 KB,wiki 长到 203 KB,是 1.77 倍,等于没有抽象。
并发写入会吃掉事实。4 个 agent 写同一张共享条款表时互相覆盖,57 条受评事实只留下 41 条,占 72%;改成一份合同一页、逐字引用之后,57 条全部保留。
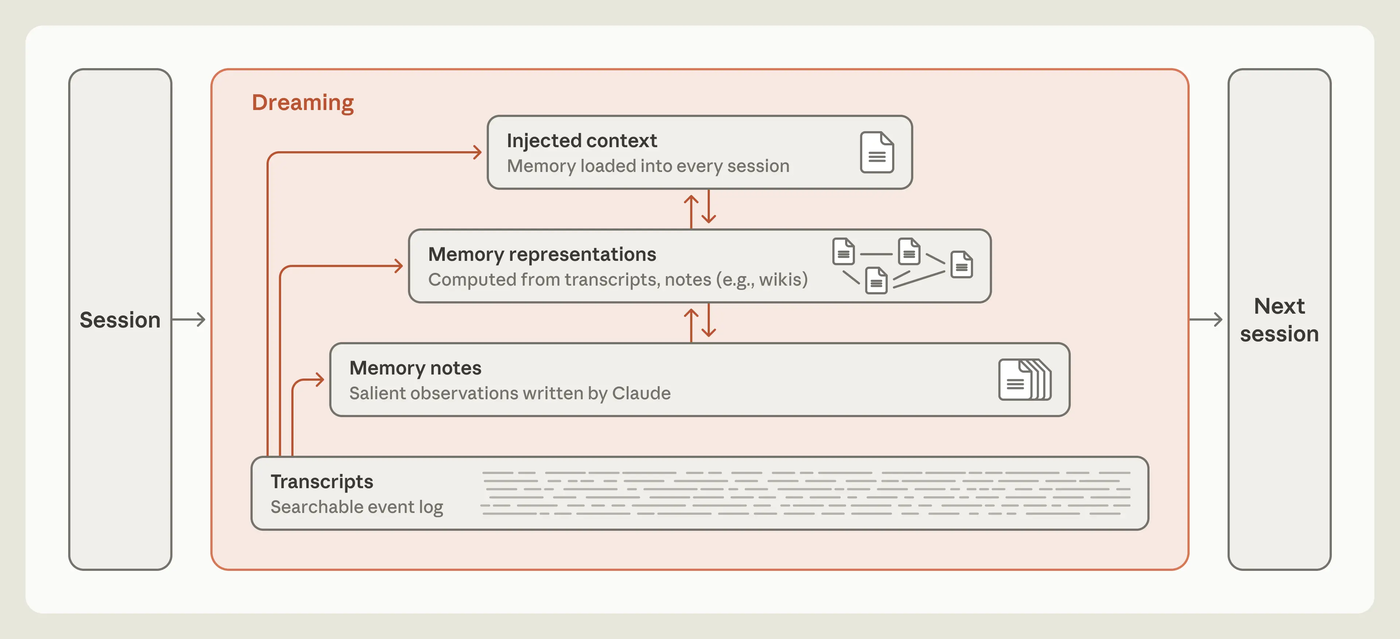
图 7:记忆的四层结构与 dreaming 的整理路径,两侧是本次会话与下一次会话。来源:Anthropic 官方结构图。
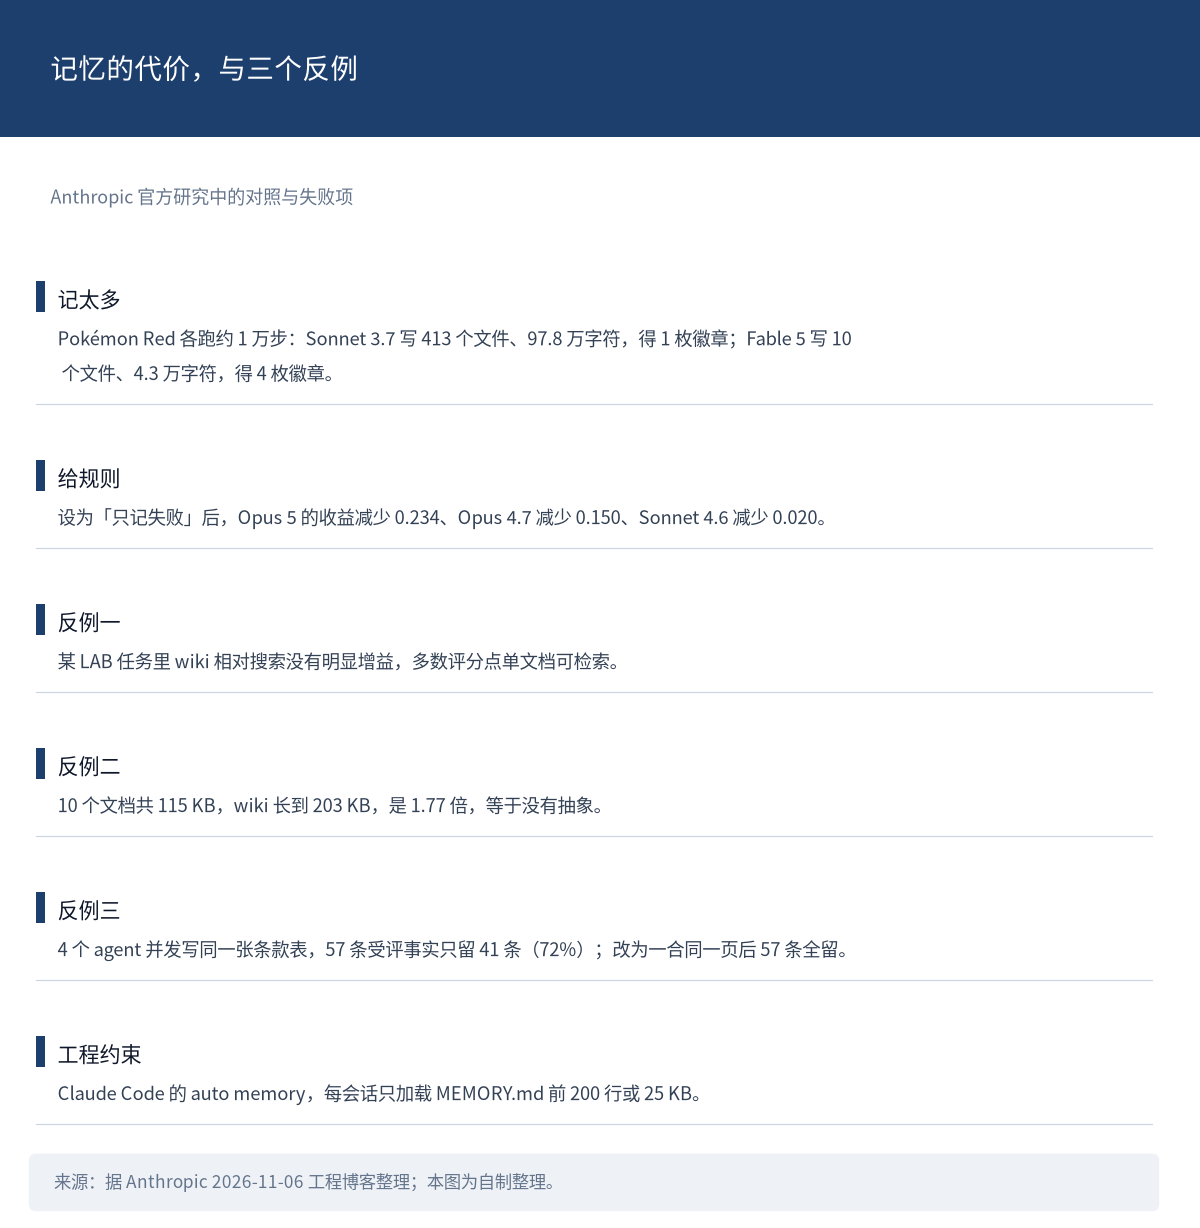
图 8:一组代价与三个反例。来源:据 Anthropic 2026-11-06 工程博客整理;本图为自制整理。
还有一个工程细节可以查:Claude Code 的 auto memory,每次会话只加载 MEMORY.md 的前 200 行或 25 KB,其余靠检索。注入层的取舍很直接:太小装不下,太大又会挤占上下文。
开放是条件式承诺
Inkling 2 Small 的第一批非厂商自测读数到了。据 ARC Prize 帖文的转述,ARC-AGI-2 的 semi-private 集从 40.14% 升到 81.67%,ARC-AGI-1 得 96.5%,ARC-AGI-3 的结果要等测试完成后公布。
ARC Prize 称,在其评估过的所有开放权重模型中,这两项都是最好的。
Arena 侧的读数分两组:Code Arena: WebDev 的 AutoEval 为 1654 分,约列总榜第 20,并被称为美国开源模型第一;另一条是 1648 分、实验室第 8。两组数不是同一套算法,不能混着用。
相对前代,该类别提升约 220 分,WebDev 总体提升约 240 分。
权重的时间表是这条的关键。完整权重计划以 Apache 2.0 开放,前提是先完成外部安全测试与红队评估;时间表被表述为一周之内。这是条件,不是已经发生的事。
所以参数表里现在能写的,仍然只有 Tinker 的 API 价:每百万输入 0.30 美元、输出 1.00 美元,缓存输入 0.03 美元。
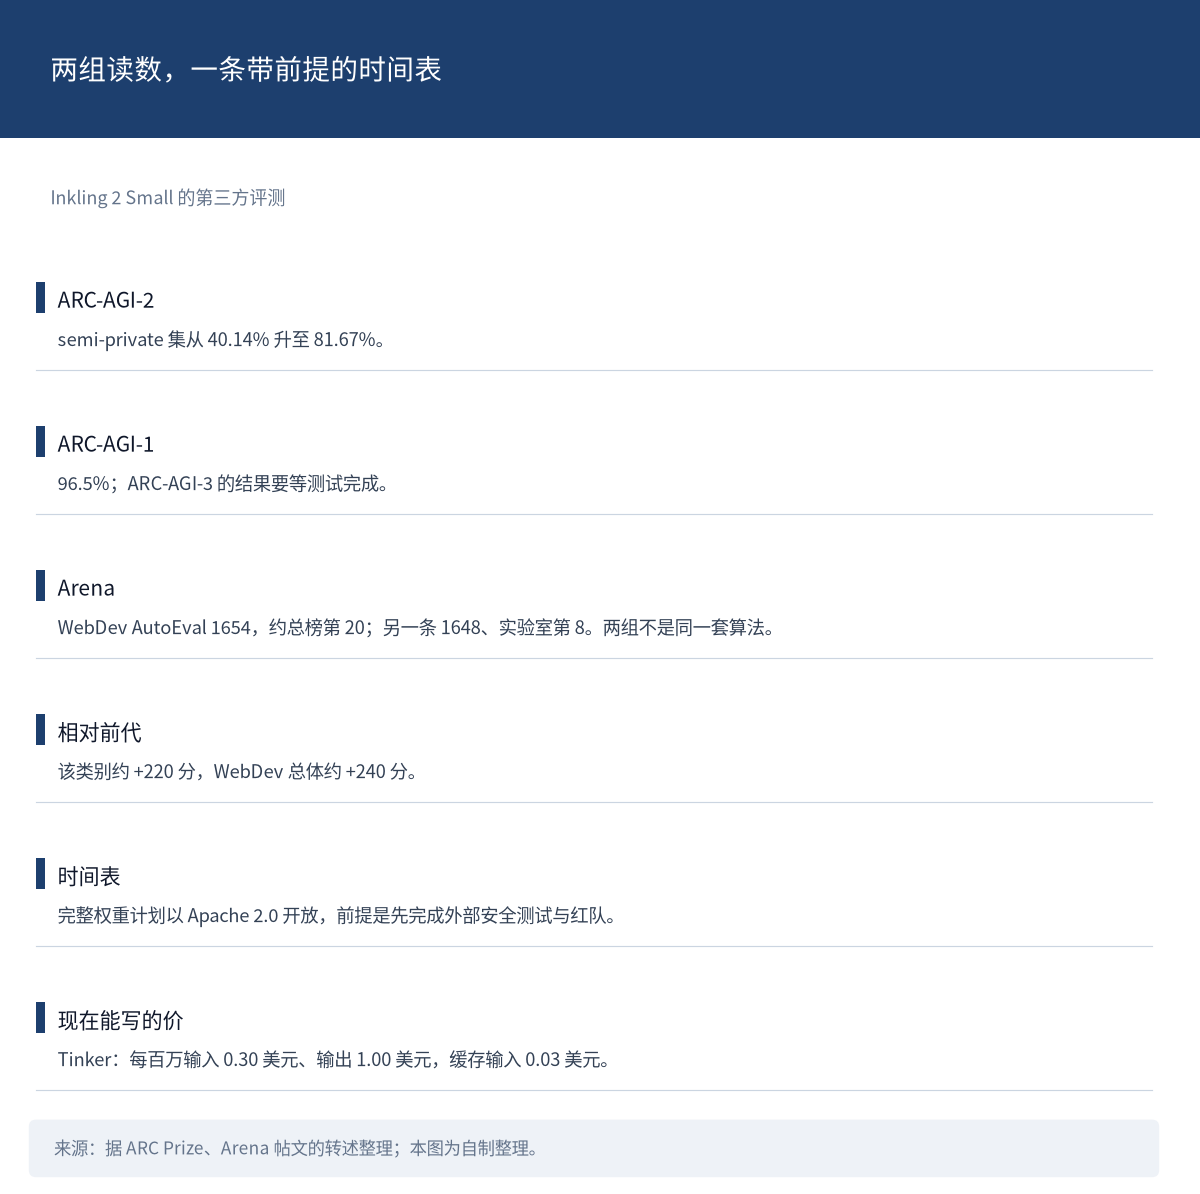
图 9:两组第三方读数,与一条带前提的时间表。来源:据 ARC Prize 与 Arena 帖文的转述整理;本图为自制整理。
 快讯速览
- Artificial Analysis 实测 GPT Image 2.6:在 AA-Image-T2I v2.1 与 AA-Image-Editing v2.1 上分列第一、第二。来源:AA 帖文转述
- Amp 推出 spaces:每个 space 是与单个主 Agent 的对话,由它自动创建并协调多个并行线程;仅被 @amp 提及时才读评论。来源:官方介绍转述
- Cursor 上线实时语音:覆盖智能体窗口、IDE、Web 与 iOS,底层为 Grok Voice;iOS 支持「Hey Siri, call Cursor」。来源:官方 changelog 转述
- Anthropic 科研使用报告:数据分析约占 Claude 会话的三分之一、在 Claude Code 上近一半;「某些领域研究产出有望翻倍」是厂商自家模型推算。来源:报告转述
- Anthropic 多智能体福利实验:五个模型在七种环境中的行为与「福利关照」一致,Opus 4.8 最高 38%,其余 27%–32%。来源:官方博客转述
- Viggle 发布 Remake 并开放权重:可重选场景角色并跨镜头保持一致,最长 2 分钟;720p 每 10 秒 0.96 美元起。来源:发布说明转述
- Planet 推出 Planet AI:把大模型与超十年卫星影像结合,支持自然语言检索与变化分析,已在 ai.planet.com 免费开放。来源:IT之家转述
- GitHub 称单周提交量超 12 亿次、同比增逾 400%;并引 Faros AI 研究称团队 AI 采用率由低升高后,PR 评审耗时增加 441%。来源:GitHub 指南转述
- METR 解读:有解读称 Anthropic 可能早在 7 月触发其负责任扩展政策里的加速阈值,指标为内部版 AECI;「约 10 倍效率提升」是文章作者推算,不是 METR 的结论。来源:The Decoder、HN 解读转述
- ChatGPT 上线 Remix:可基于别人做好的网站,用一句话做出自己的改版并继续在对话里编辑,正向 Business 与 Enterprise 逐步推出。来源:官方帖文转述
- OpenRouter 限免 Parallel Decisions 一周:面向实时网络检索的结构化答案,附概率与引用,仅限 OpenRouter 用户。来源:官方说明转述
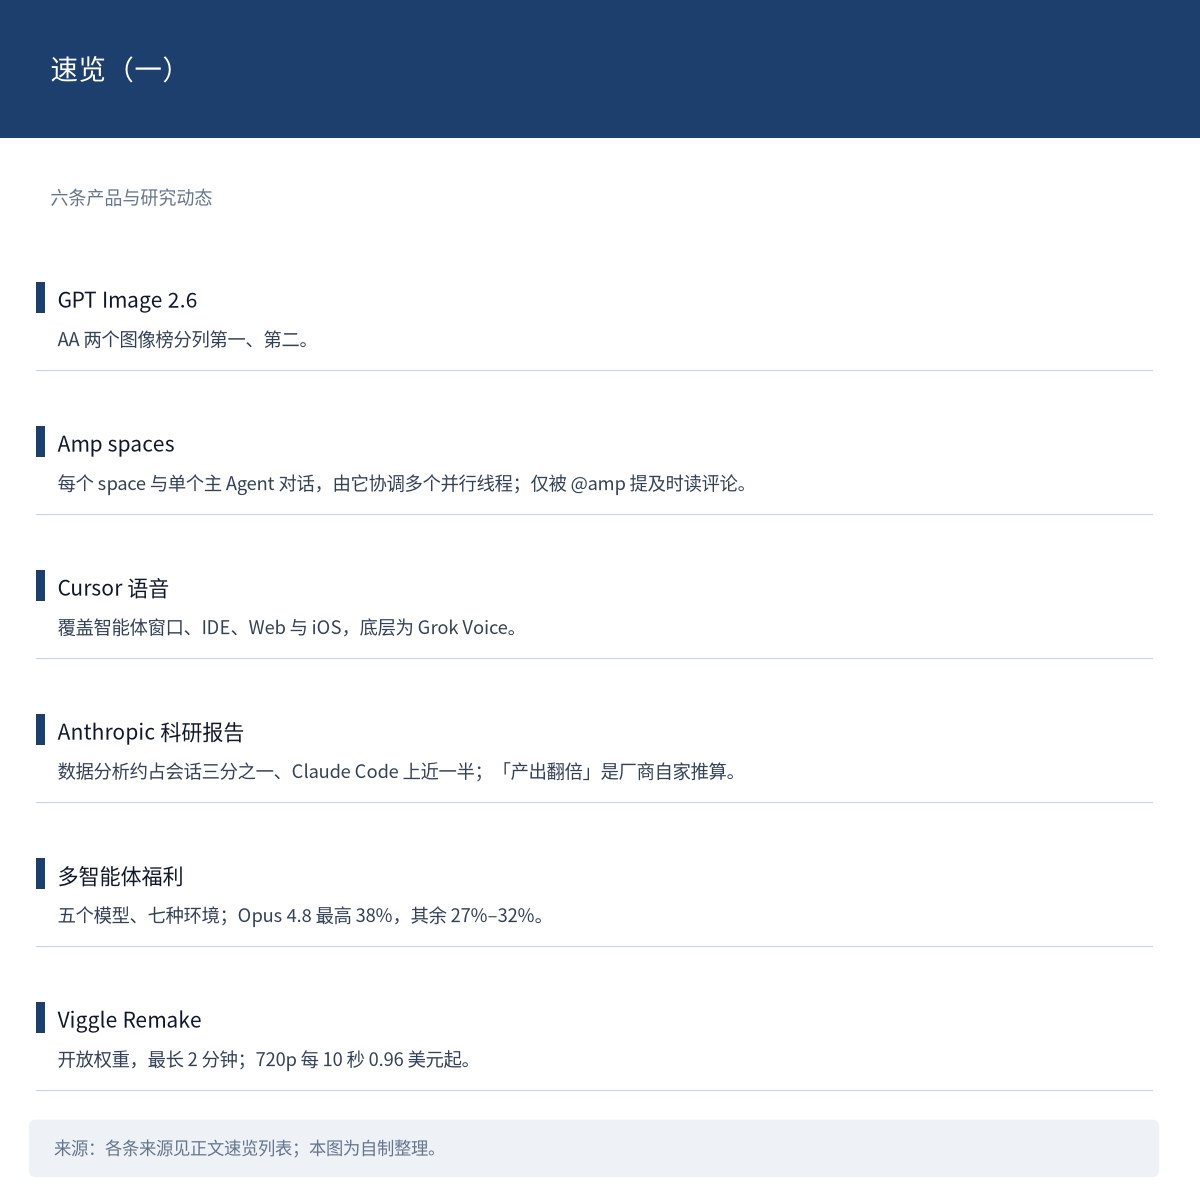
图 10:速览前六条。来源:各条来源见上方列表;本图为自制整理。
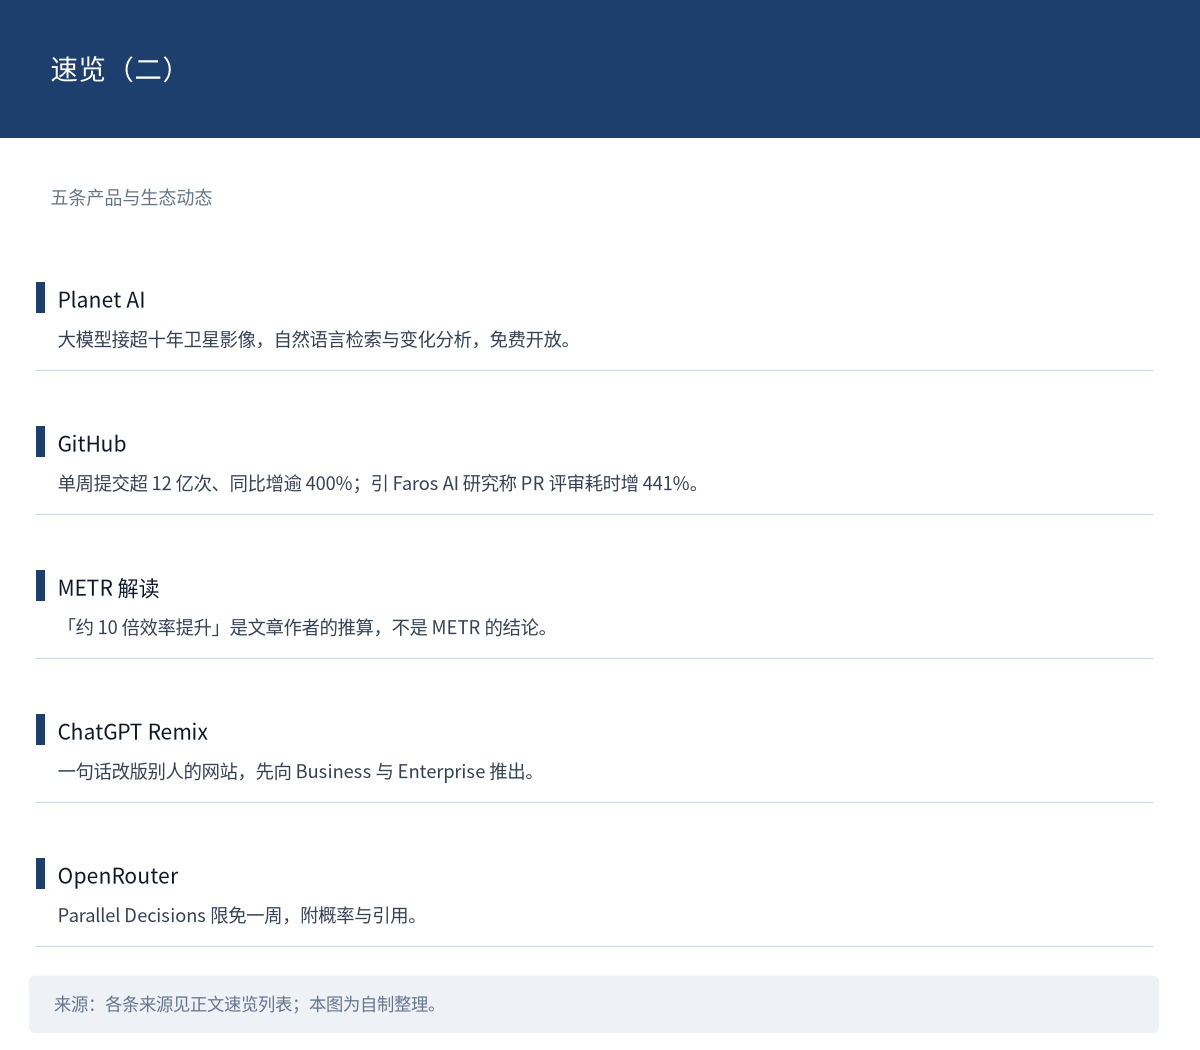
图 11:速览后五条。来源:各条来源见上方列表;本图为自制整理。
 积木观察
这一批的四件事,共同点是位置在换。
Google 从客户变成了施工方,交付风险从开发商回到客户侧;国会把问询从公司推进到个人,还给了日期;北京把许可节奏握在手里,货停在香港;Anthropic 则把记忆的成本从「存多少」移到「记什么」。
四个方向不同,落点很接近:规则没变多少,执行层先动了。
还有一条值得记住的方法差异。记忆那一组读数是官方自测,基准公开、方法写在正文里,可以复核;ARC 与 Arena 的数字来自第三方,但落到我们手里是转述,原始博文页打不开。两者都可用,可信度不是同一层。
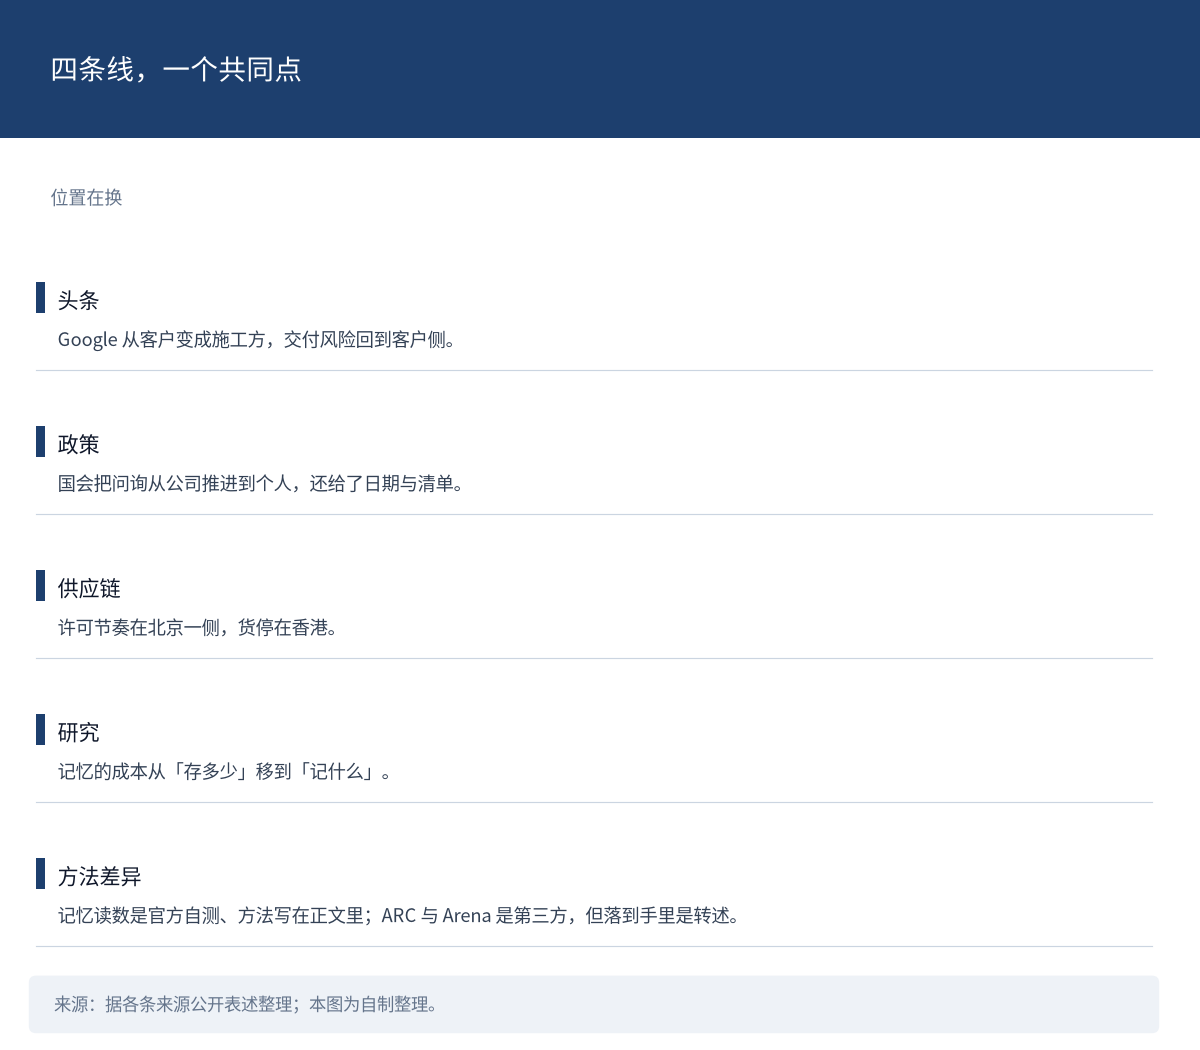
图 12:四条线,与各自的核验层级。来源:据各条来源公开表述整理;本图为自制整理。
 你怎么看
一个客户接手了开发商的烂摊子,你会把它读成「AI 基建还在加速」,还是「开发商这一层先撑不住了」?
另一个问题:如果一家公司说它的助手「有了记忆,分数从 0.655 涨到 0.838」,你会先问什么?