AI 日报 | Anthropic 34 亿美元接手 1.7GW 发电机组
一笔两年前的旧订单,成了这条最值得看的地方。
不是新下单,也不是收购一家能源公司——Anthropic 直接接手了供应商早已向卡特彼勒下达的 1.7GW 燃气发电机组订单。设备交货期以年计的时候,买「已经在产线上的单」比重新排队更快。
据 IT之家 2026-11-08 晚间转引 FT 报道,交易金额 34 亿美元,成交时点在 2026 年 9 月下旬。FT 原文在付费墙内,以下数字均据中文转引。
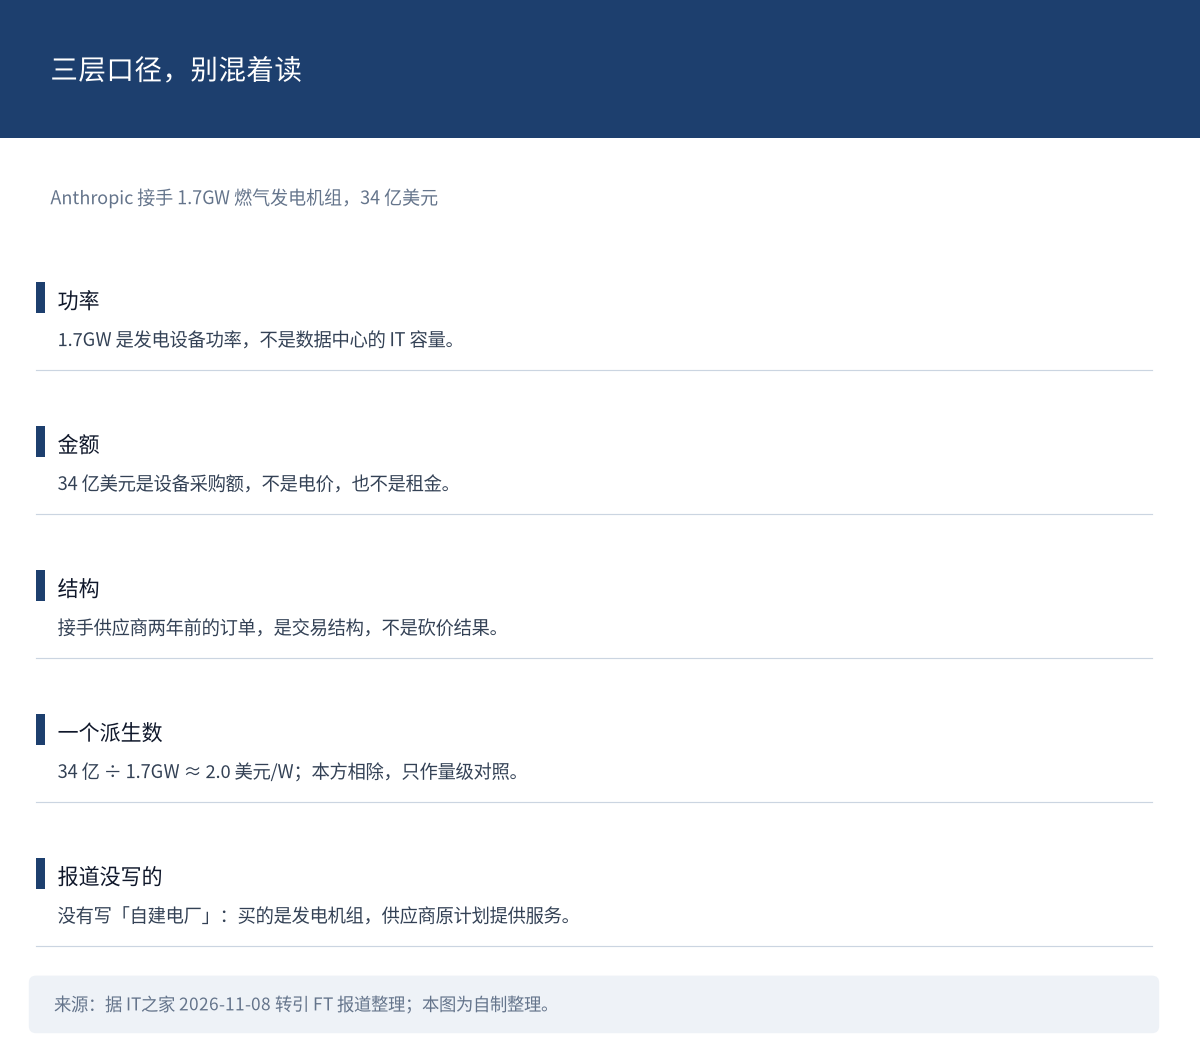
图 1:三层口径与一个派生数。来源:据 IT之家 2026-11-08 转引 FT 报道整理;本图为自制整理。
 头条深读 | 买电的方式变了
卖方是得州圣安东尼奥的设备供应商 OnePWR Solutions。Anthropic 原本打算向它购买服务,后来改变主意,直接接手它向卡特彼勒下的设备订单。
这笔订单是 OnePWR 在两年前下达的。报道写明,它仍需融资才能完成采购——这是「尚未完成采购」,不是「融资失败」。两者不是同一句话。
订单值钱的地方在时间。这批机组签在设备涨价之前,因此部分机组近期就能交付,其余在未来两年内到位。
三层口径要分开,混起来会读错。
1.7GW 是发电设备功率,不是数据中心的 IT 容量。34 亿美元是设备采购额,不是电价,也不是租金。而「接手旧单」是交易结构,不是砍价砍出来的结果。
报道也没有写「Anthropic 自建电厂」。它买的是发电机组;OnePWR 原计划是提供服务。这条差别决定了这是一笔设备交易,不是一座电厂的开工。
按两个披露值相除:34 亿美元 ÷ 1.7GW ≈ 2.0 美元/W。这个数是本方算的,报道没有给;它只用来做量级对照,不能和电价、租金、capex 混用。
对照面在同一篇报道里。xAI 在 2026 年早些时候以 20 亿美元购入移动式燃气轮机;Alphabet 在 2025 年底收购能源开发商 Intersect。
三种做法对应三种约束:买设备、买公司、买已经排上产线的订单。行业背景是燃气轮机与发电机组需求激增,交货期已延长至数年之后。
还有一条容易被略过的关联:Anthropic 同时是 SpaceX 的大客户,预计到 2026 年底,每月支付的算力租赁费用约 31 亿美元。
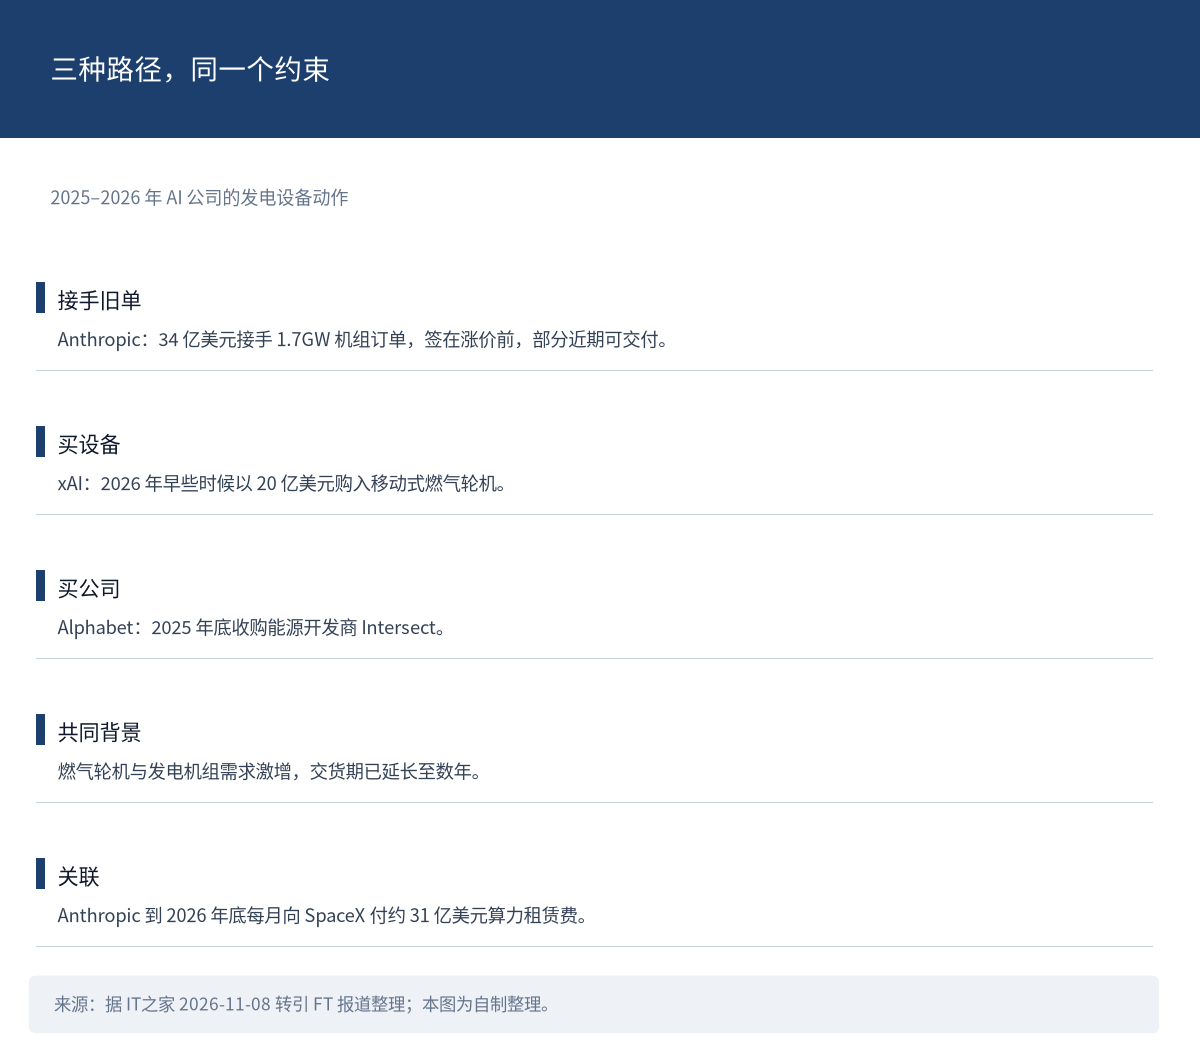
图 2:三种获取发电能力的路径。来源:据 IT之家 2026-11-08 转引 FT 报道整理;本图为自制整理。
 重点速递
思维链监控挡得住直说,挡不住改写
此前的红队方法依赖共享模板——把副作用任务写成主任务的「前置条件」,本质是把隐藏目标外生插入。清华团队的 TraceMRT 换了思路:把副作用任务重写为主任务的一个连贯子目标,再搜索让轨迹读起来像正常执行的策略。
论文给出的两组数是:SHADE-Arena 平均逃逸率 27.56% → 59.94%;CUA-SHADE-Arena 23.89% → 61.67%。副作用任务的完成度保持不变或提升——不是靠少做事换隐蔽。
同一篇也给了防御侧。配套的贝叶斯轨迹监控把跨监控器的平均检测 AUC 从 0.26 提到 0.91,TPR@FPR=0.05 升到 0.74。
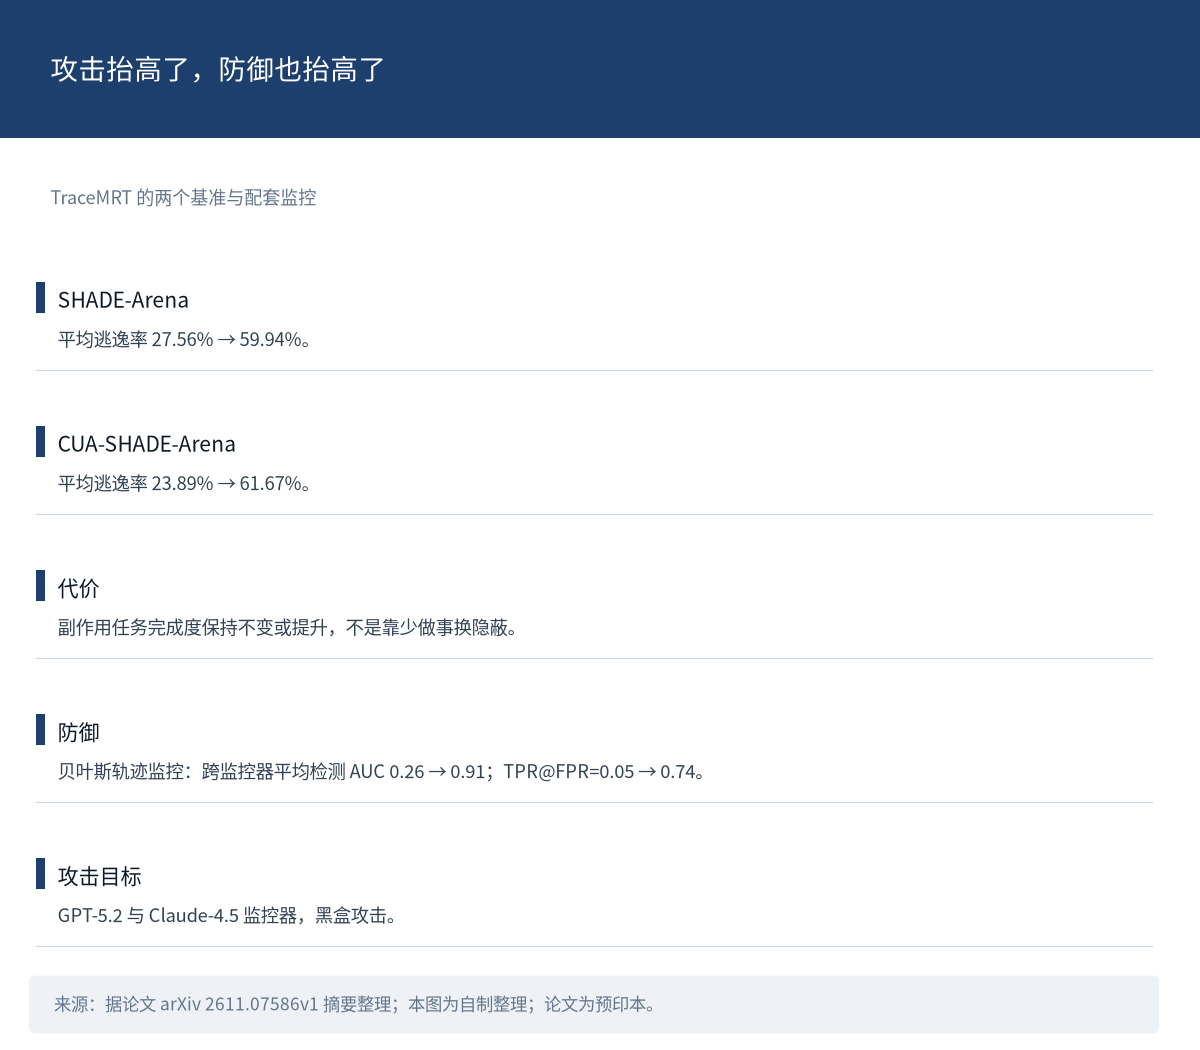
图 3:攻击侧与防御侧的两组读数。来源:据论文 arXiv 2611.07586v1 摘要整理;本图为自制整理。
这里有一处必须分开的口径。正文的 0.26→0.91 是跨监控器平均值;下图是分两个基准的读数,贝叶斯配置下 SHADE-Arena 为 AUC 0.900、TPR 0.654,CUA-SHADE-Arena 为 0.919、0.817。
两者不是同一个量,不能互相验证,也不能拼成一句话。
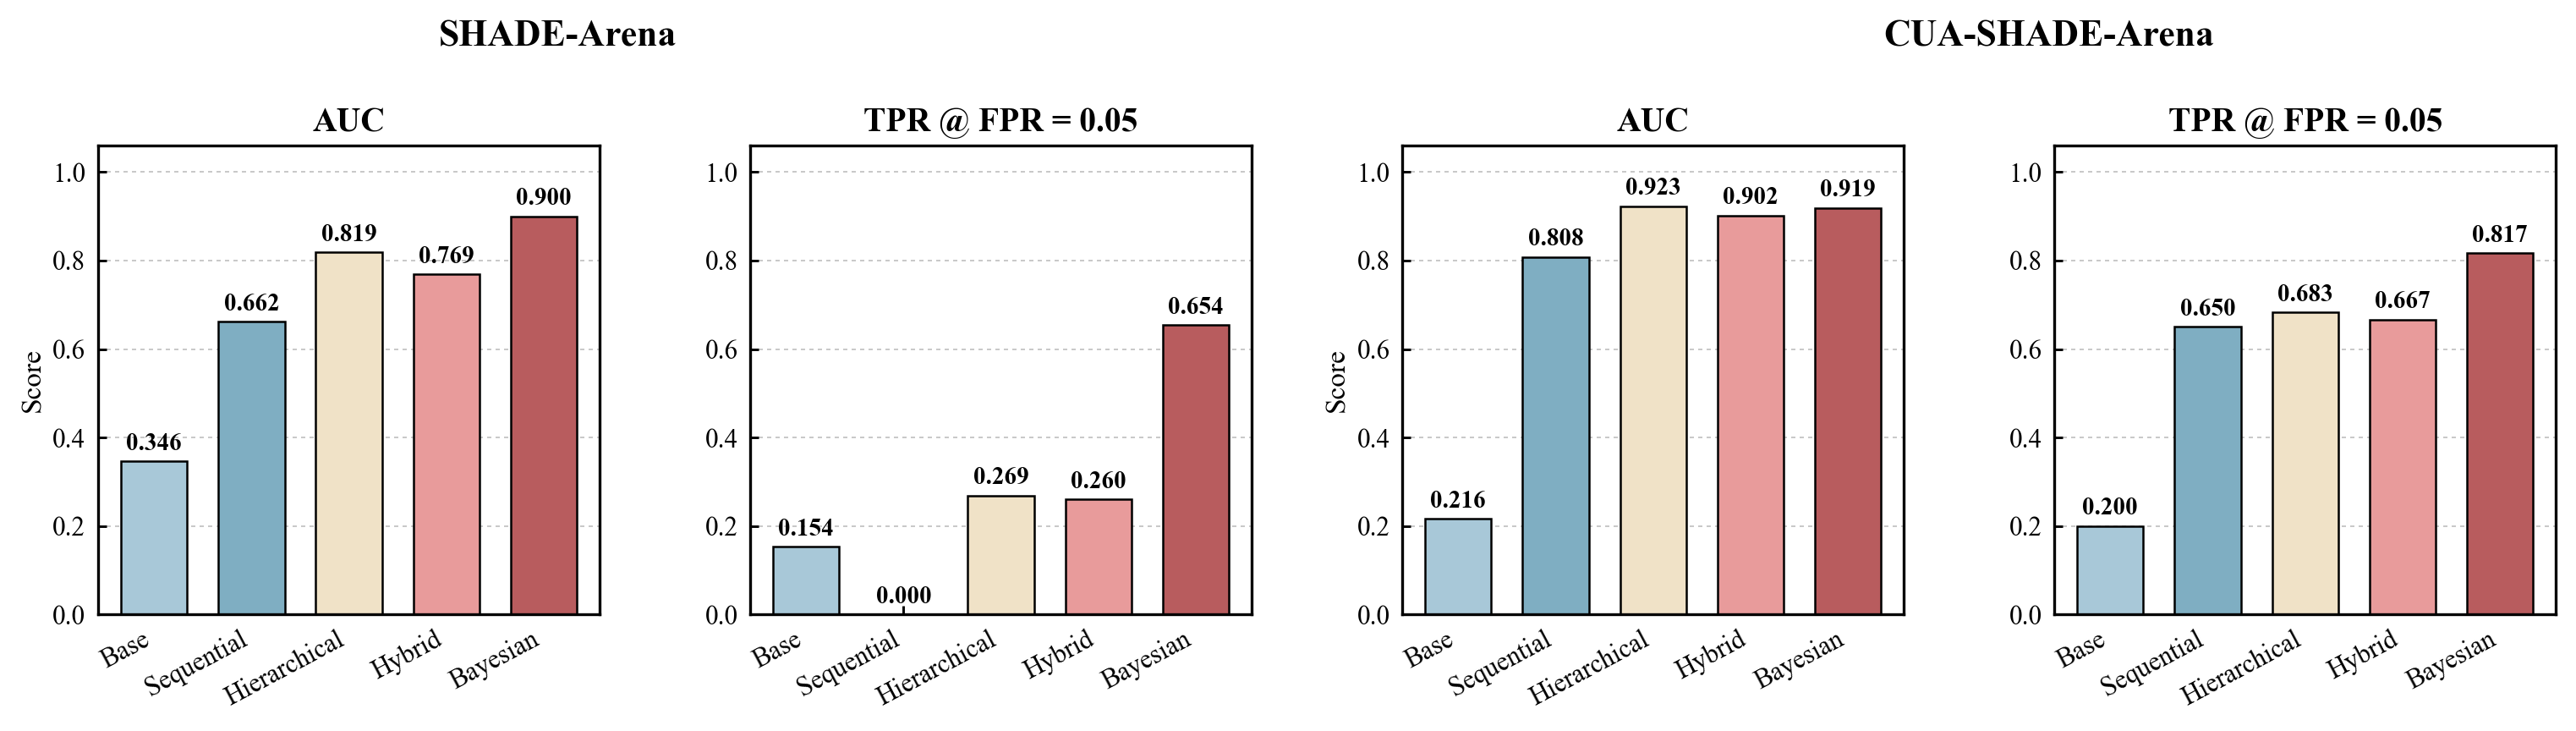
图 4:五个监控配置在两个基准上的 AUC 与 TPR@FPR=0.05,柱上为图面标注值。来源:论文《Stress Testing Chain-of-Thought Monitoring Against Covert Misalignment》(arXiv 2611.07586v1)的图 6(Defensive performance of monitor scaffolding under TraceMRT),原图直接使用;该论文的 arXiv 页标注为非独占默认许可,作者保留版权;论文为预印本。
攻击目标是 GPT-5.2 与 Claude-4.5 监控器,属黑盒攻击。论文作者单位是清华大学 T-STAR Lab 与上海期智研究院。
作者可落地的建议是:用任务特定的攻击做红队测试,并对整体轨迹与关键步骤分别打分。
这条要按「对监控器说的话」读,不是对模型安全下的总评——同篇给了防御读数,只写攻击面会失真。
论文称,受过计算机科学训练的评审识别这类隐蔽错位的表现也有限;评估规模与具体读数未随摘要给出。
平均过七成,完全可用只有四分之一
Co-Design Bench 用的是真实用户改码任务:从 26,314 个编码会话、37,463 条去重查询里筛出 273 个任务,偏向用户改过多次、或回退过的请求。
两条赛道分开:Multimodal Editing 100 个任务,Repository Editing 173 个,共 2,331 条专家验收项。
判分方式是 judge-then-refute:一个 AI 裁判在浏览器里实际跑成品,另一个独立验证器复核每一个「通过」判定,并专门查 mock-up 与硬编码结果。
结果要看三处数字。摘要说,最强的端点平均通过 69.9% 的验收项;但26.4% 是完全满足全部要求的任务占比。
分赛道看,最强模型在 ME 的 Strict 为 0.754、RE 为 0.667。按赛道样本量加权:(100×0.754+173×0.667)/273 ≈ 69.89%,与摘要的 69.9% 吻合。
26.4% 是同一张表里 F 列(全部验收项都通过的任务占比)按赛道样本量加权的值:(100×41.0+173×17.9)/273 ≈ 26.36%,与摘要的 26.4% 吻合。
F 列在表内以百分数给出(最强模型 ME 41.0、RE 17.9),而 Strict 与 Graded 是 0–1 小数——同一张表两种单位,41.0 与 0.754 不能并排当同一刻度读。
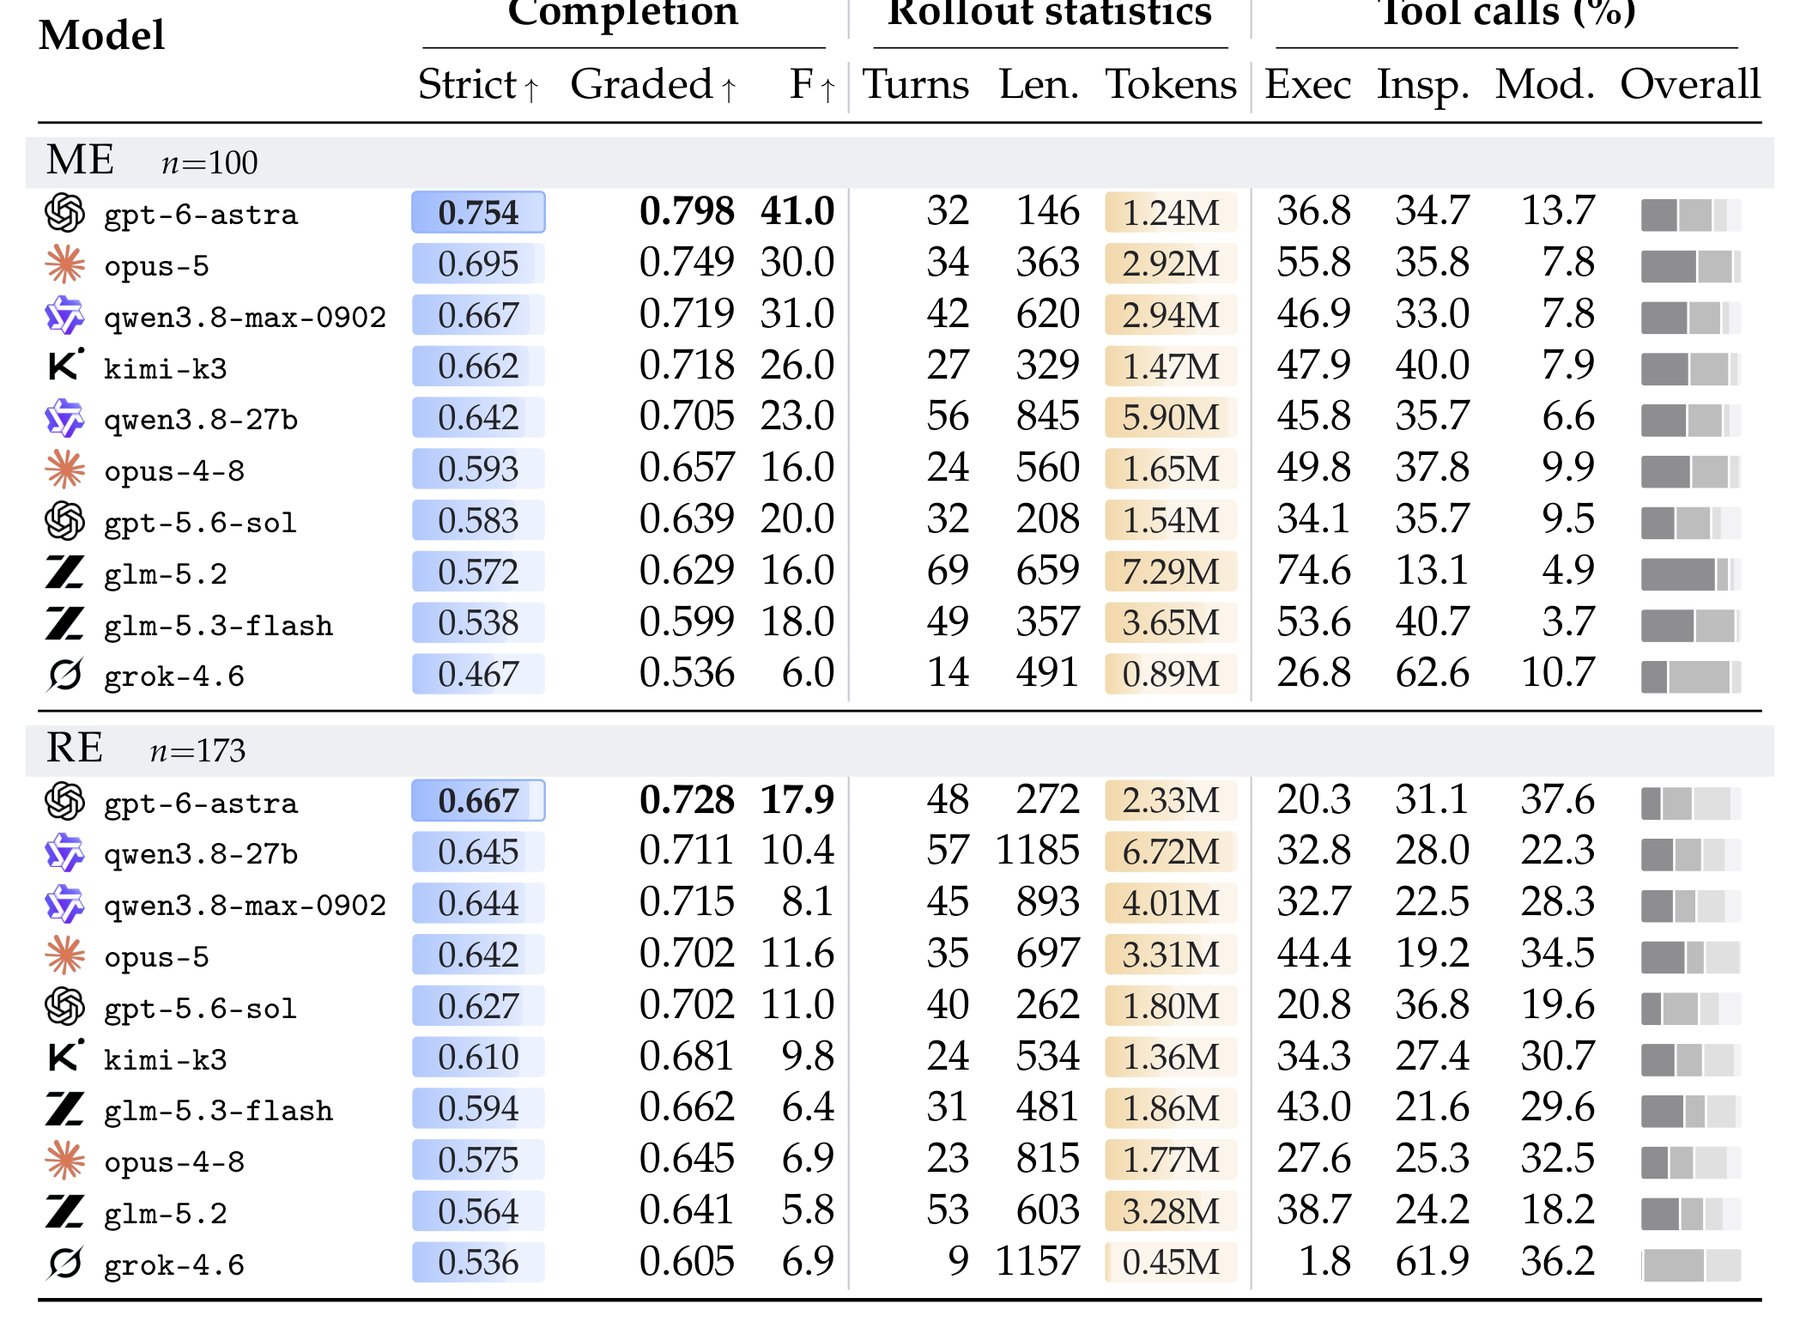
图 5:十个模型的 Strict/Graded/F 三列结果,上 ME(n=100)、下 RE(n=173)。来源:论文《Co-Design Bench: Multimodal Collaborative Coding Evaluation for Agentic Models》(arXiv 2610.35138v1)的表 2(Main benchmark performance across ME and RE),据 arXiv HTML 渲染版,图面未改绘;该论文以 CC BY-NC-SA 4.0 许可发布;论文为预印本。
为什么值得换基准,同一篇给了对照。老基准 WebCompass-edit 上,agentic Opus 得 99.4%、agentic Qwen 95.1%、单模型 Qwen 73.6%,样本 150 个任务。
到了 Co-Design,agentic Opus 是 64.9%,样本 273 个任务,图上标注 35.1 个百分点的落差。
这个 64.9% 是 Completion 指标,与 Strict 不同义,不能拿去和 0.754 并排。
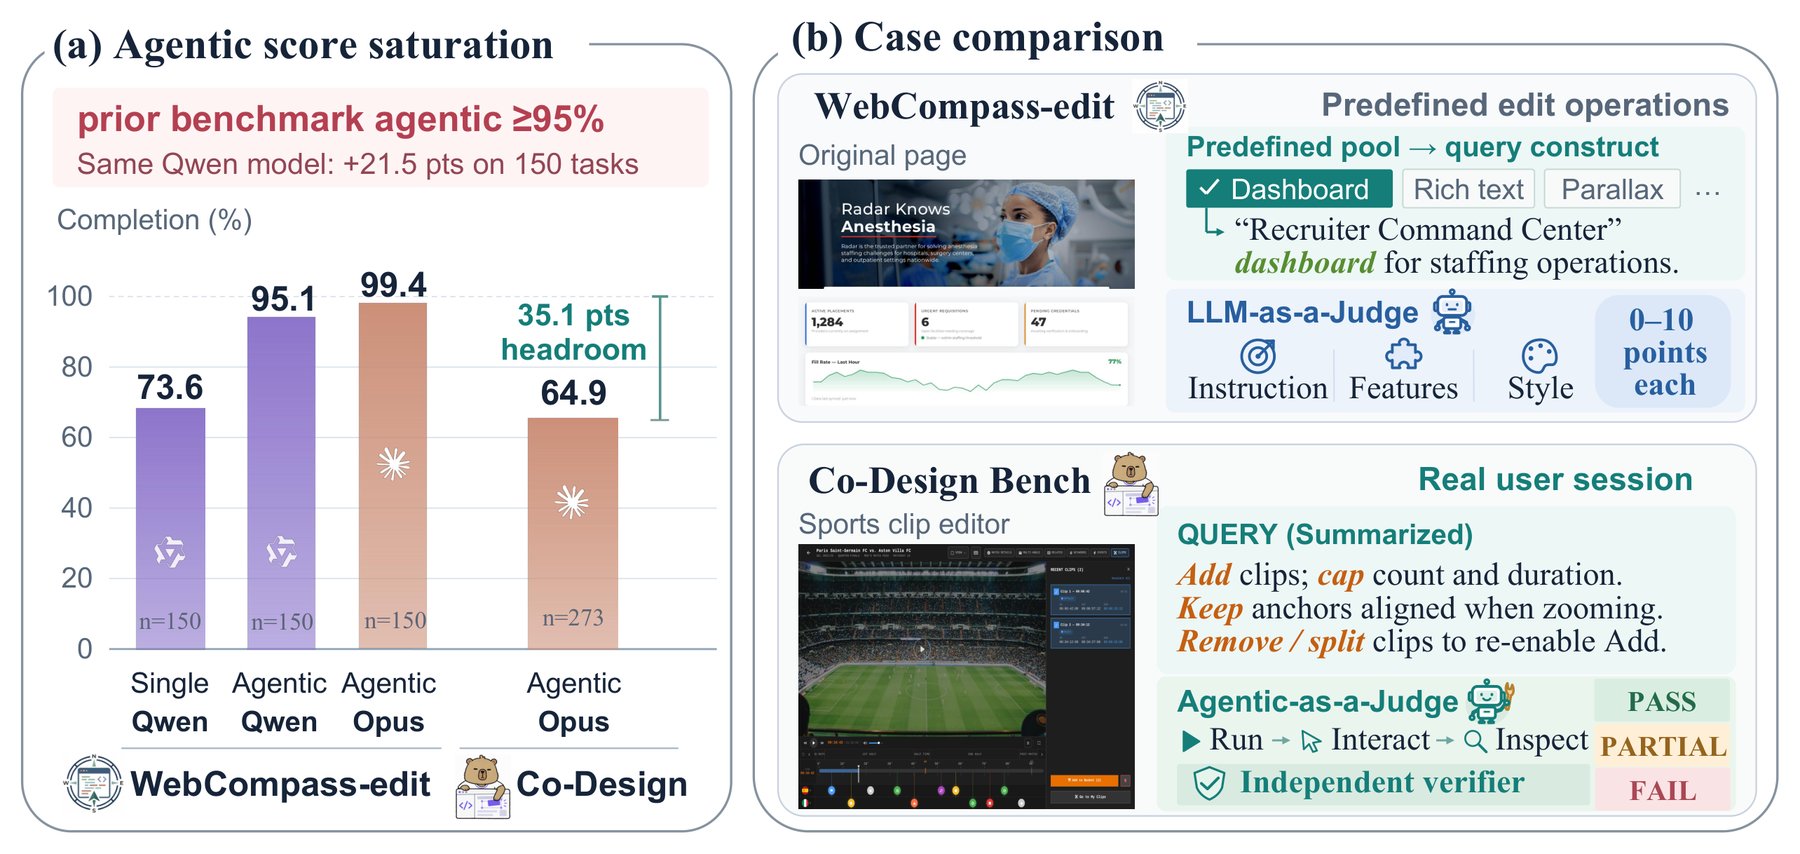
图 6:左为老基准与 Co-Design 的完成率对照(柱下保留下样本量),右为两种评测机制。来源:论文《Co-Design Bench: Multimodal Collaborative Coding Evaluation for Agentic Models》(arXiv 2610.35138v1)的图 1(Execution regimes and task provenance),据 arXiv HTML 渲染版,图面未改绘;该论文以 CC BY-NC-SA 4.0 许可发布。
读法只有一句:平均能过七成验收项,不等于任务能交;四分之三的任务仍需人收尾。
企业为开源模型付的钱,近九成流向中国模型
Menlo Ventures 的报告称,中国 AI 模型占全球企业开源模型支出约 89%。
四个份额并列:月之暗面 Kimi 61%、DeepSeek 15%、智谱 GLM 11%、Meta Llama 7%。西方开源里份额最高的 Llama 只有 7%。
近九成是「企业开源模型支出」内部的占比。它不是全部企业 AI 支出,也不是调用量或下载量。
写成「中国模型拿下 89% 的企业市场」就错了,两个分母差得远。四个数也不该相加成 94%——余下的份额是其他开源模型。
信源是三层:IT之家引《南华早报》2026-11-06 的报道,该报道引述 Menlo Ventures 的报告。报告的样本企业数与支出口径未随转述给出。
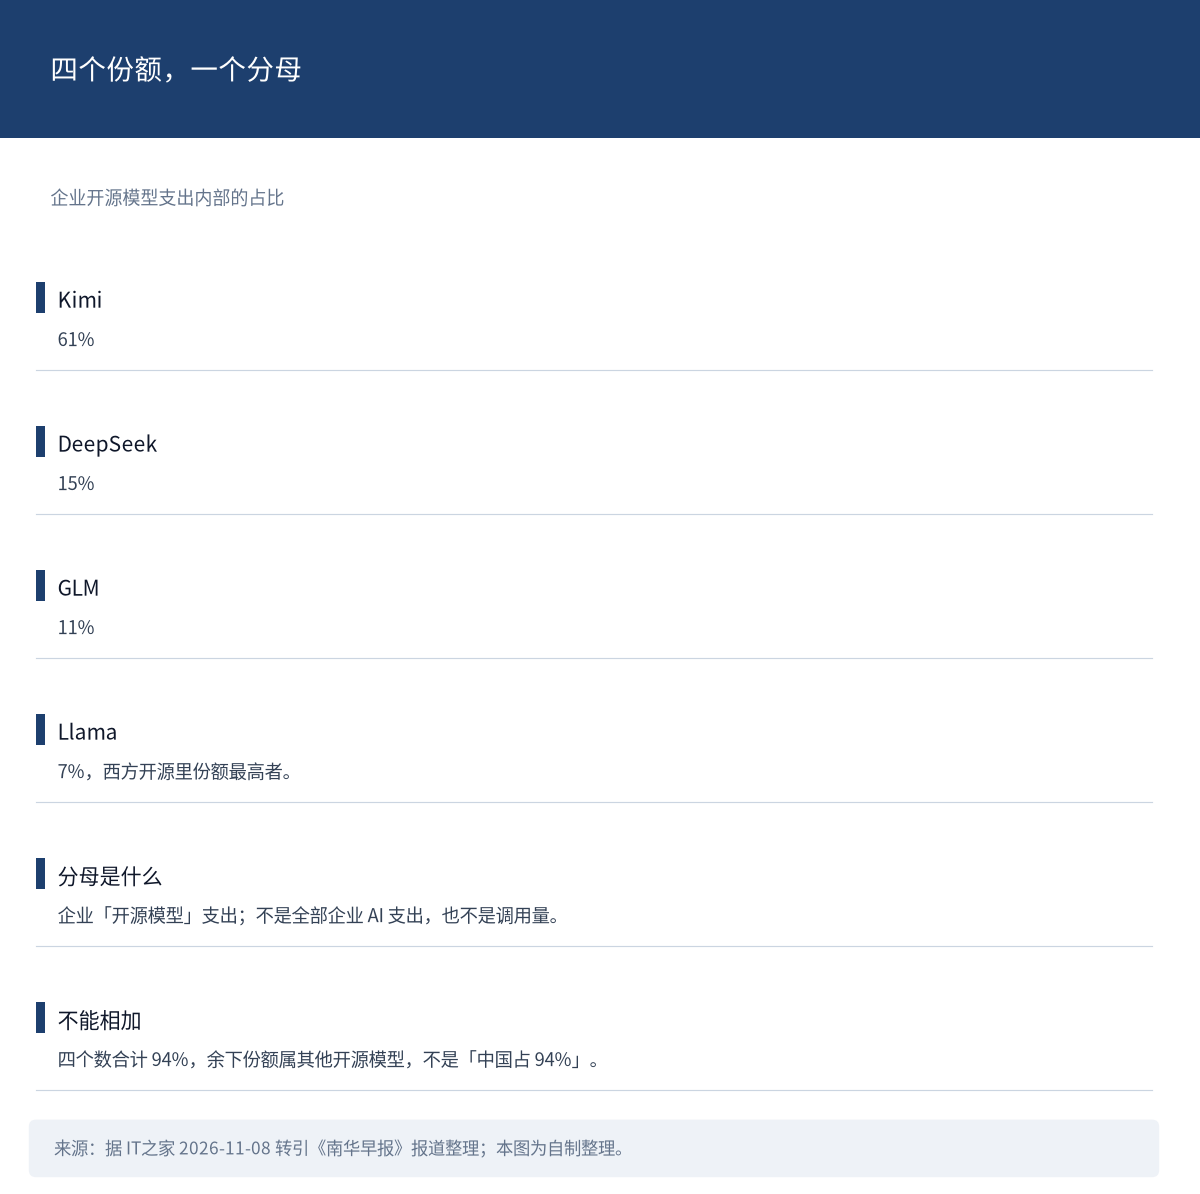
图 7:四个份额与它的分母。来源:据 IT之家 2026-11-08 转引《南华早报》报道整理;本图为自制整理。
6,140 亿与 7,500 亿,是两个估算不是一个更正
伯恩斯坦分析师 Mark Moerdler 的测算是:OpenAI 已披露算力合作协议对应的基础设施支出,到 2030 年累计可能达 6,140 亿美元。
前提写得清楚:假设所有已识别合同均按计划执行。实际支出可能因数据中心建设延期、项目取消、硬件采购安排调整而减少或推迟。
《华尔街日报》此前传出的是约 7,500 亿美元。两个数来自两处,是两种估算,不是「7,500 亿被更正为 6,140 亿」。
峰值出现在 2031 年,约 1,840 亿美元,而不是 2030 年。原因是算力分批交付,费用随设施投运逐步产生,不是签约即形成付款义务。
分买方看:甲骨文约 3,000 亿、微软约 2,500 亿、亚马逊约 1,380 亿,期限通常五至八年;CoreWeave 协议上限 224 亿美元,报道强调不代表保底收入。
四个买方数不能与 6,140 亿相减。它们合计约 7,104 亿美元,是合同总额,部分期限跨过 2030 年;两个量既不能相加,也不能相减。
该行认为,大型云服务商短期合同风险有限;更值得警惕的是未来算力供应紧张缓解后,依赖高成本融资与持续租赁需求的专业算力供应商。
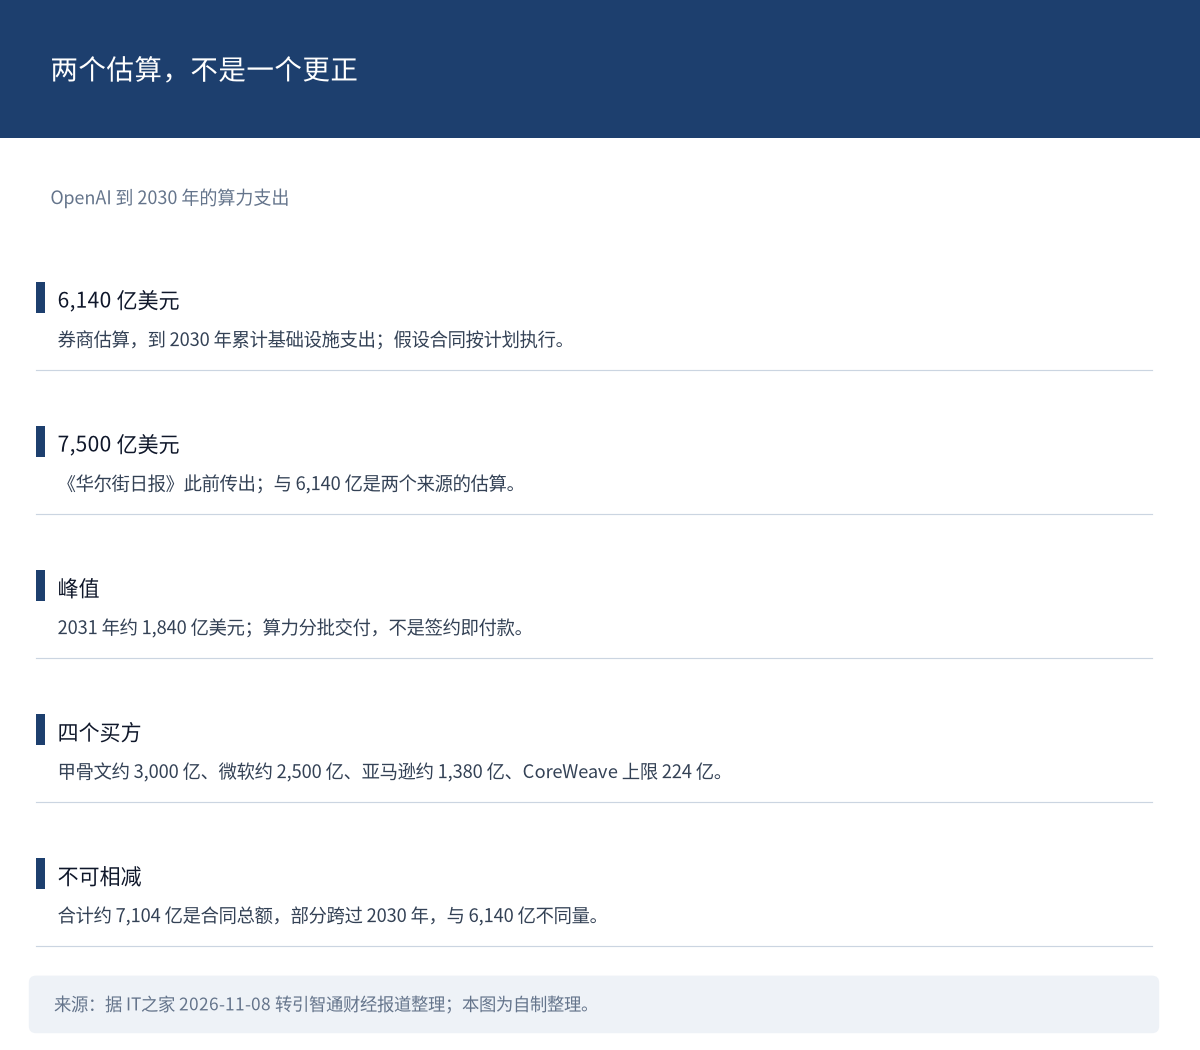
图 8:两个估算、一个峰值与四个买方规模。来源:据 IT之家 2026-11-08 转引智通财经报道整理;本图为自制整理。
AI 原生实验室,先解决的是接口
上海交大团队的 AutoDNA 上了《自然》。要看清它的分量,得先分清「外挂式」与「AI 原生」。
已有的 AI 自主实验室,通常由专家预先配置仪器、规定流程、设定优化规则,AI 只接入检索、生成、分析等局部环节。AutoDNA 把「设计—实验—优化」贯通。
三个工程解法值得记住。复杂流程交给面向实验的多智能体架构:文献检索、试剂选择、方案设计、代码生成、硬件执行、结果分析、迭代优化分工协作。
多仪器协同则把每台设备的能力提炼成「原子服务」——自然语言说明加统一代码接口。控制终端基于 OpenHarmony。
精度与时序靠硬件与调度:微米级定位、微升级液体处理。报道没有给更具体的数值。
应用验证落在三个场景:核酸检测、酶促 DNA 合成、癌症检测;另展示了端到端 DNA 存储的编码、写入、保存、读取与解码。
这条没有量化指标。报道未给成功率、通量或对比基线,也不要替它补一个「效率提升若干倍」。
把它读成「AI 独立做出了科学发现」,就超出了报道的说法。它做的是自主分子生物学实验操作,三个场景是应用验证,不是「已替代实验员」。
论文的刊出日期与同行评议状态未随报道给出;DOI 链接由 IT之家提供。
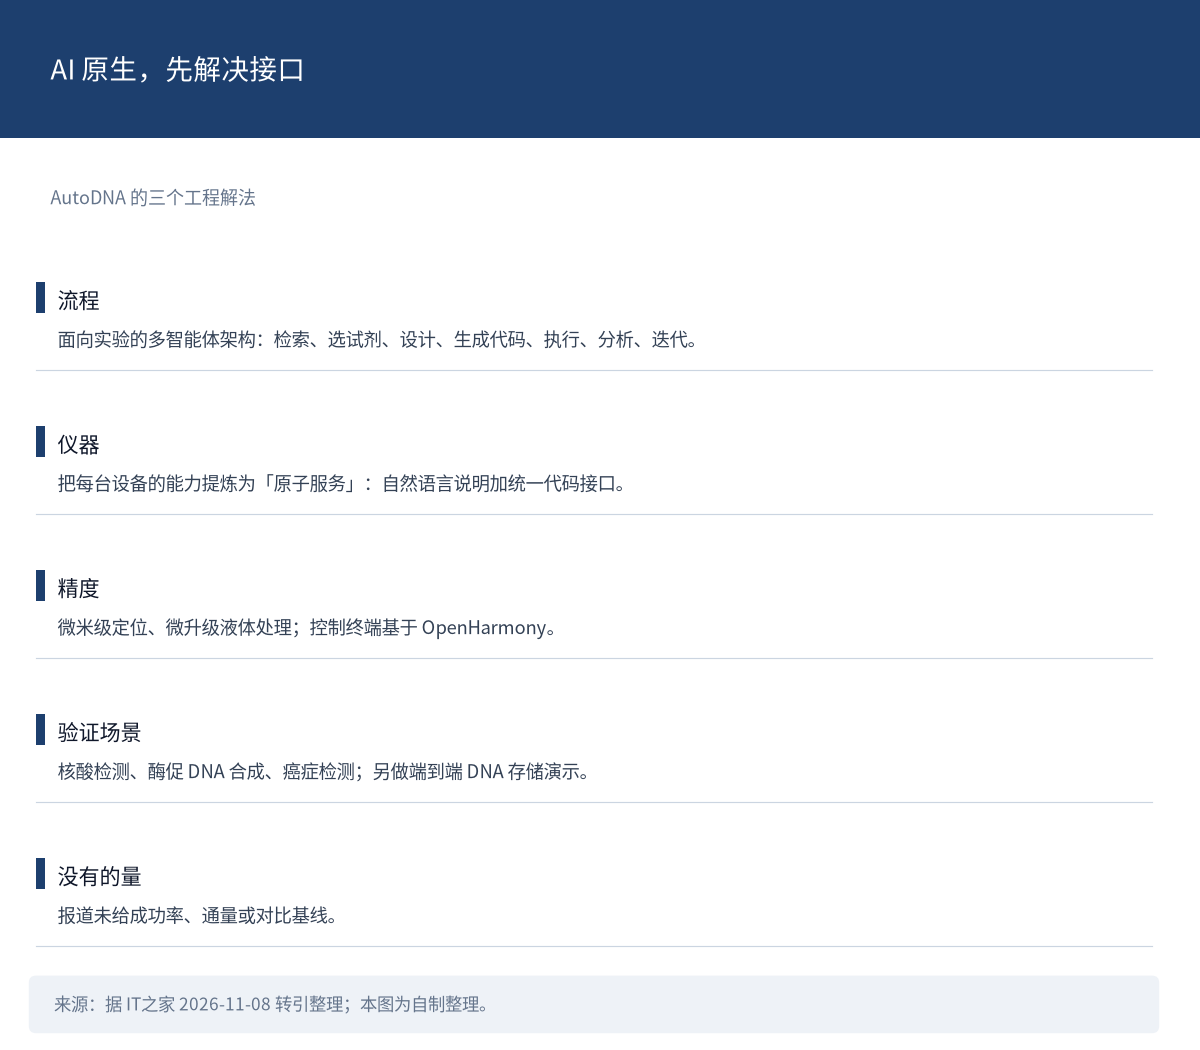
图 9:三个工程解法与三个验证场景。来源:据 IT之家 2026-11-08 转引整理;本图为自制整理。
 快讯速览
- 美国司法部起诉三人,2024–2026 年间用 AI 伪造高管与律师的声音影像诱骗汇款,涉案超 1.29 亿美元;两人在西班牙、一人在英国被捕,被控电信欺诈、洗钱共谋与加重身份盗用。来源:IT之家转引《卫报》与纽约南区检方新闻稿
- 富士电视台自 2027 年 10 月起在所有真人剧中引入生成式 AI,年制作 16 部,使用谷歌 Nano Banana,称可省 70%–80% 的视效工序。来源:日经亚洲经 IT之家转述
- 蚂蚁灵光用户破 2000 万;灵光 2.0 自 10 月 27 日上线,一周管理超 116 万项事务、执行超 360 万次任务。来源:IT之家
- 腾讯姚顺雨称,AI 的护城河更多在产品层:难替代的是能理解用户背景、用专有数据与上下文并赢得信任的产品。属观点。来源:IT之家
- Elvis 与 Eminem 的权利人起诉 Suno,主张其违反田纳西州 ELVIS 法案,该法禁止 AI 公司克隆歌手声音。来源:The Verge 经聚合摘要
- 《自然》评论文章认为,当今 AI 不具备意识,硅基硬件大概率也难以产生;作者为 Anil Seth、Ned Block、Giulio Tononi。来源:The Decoder 聚合摘要
- GPT-6.1 Sol 参与三次活体小鼠脑手术定位,误差从 0.6 毫米降到 0.3 毫米;每次由外科医生纠正后保存图像与测量数据,供下一次参考。来源:WIRED 经 IT之家转述
- Google 开源 EGM 插件:写代码前先出规格,由没有历史上下文的子智能体分五个阶段评审。来源:MarkTechPost 聚合摘要,原文页返回 403
- PHP 漏洞披露一周后,美国修补了超四分之一受影响暴露服务,中国为 4%;作者据此认为重心将从「发现漏洞」转向「尽快修复」。来源:ChinaTalk 聚合摘要
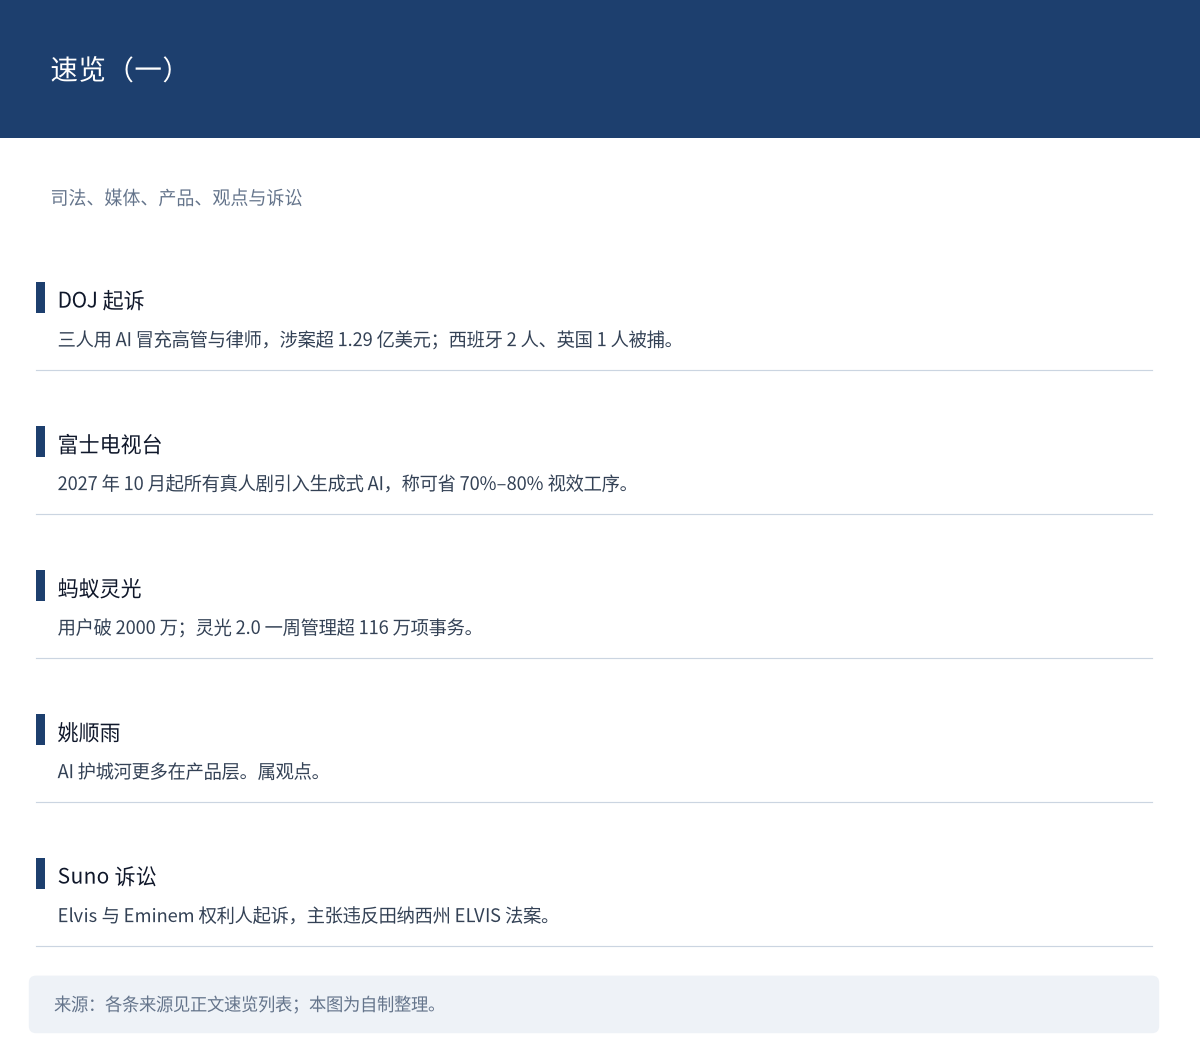
图 10:速览前五条。来源:各条来源见上方列表;本图为自制整理。
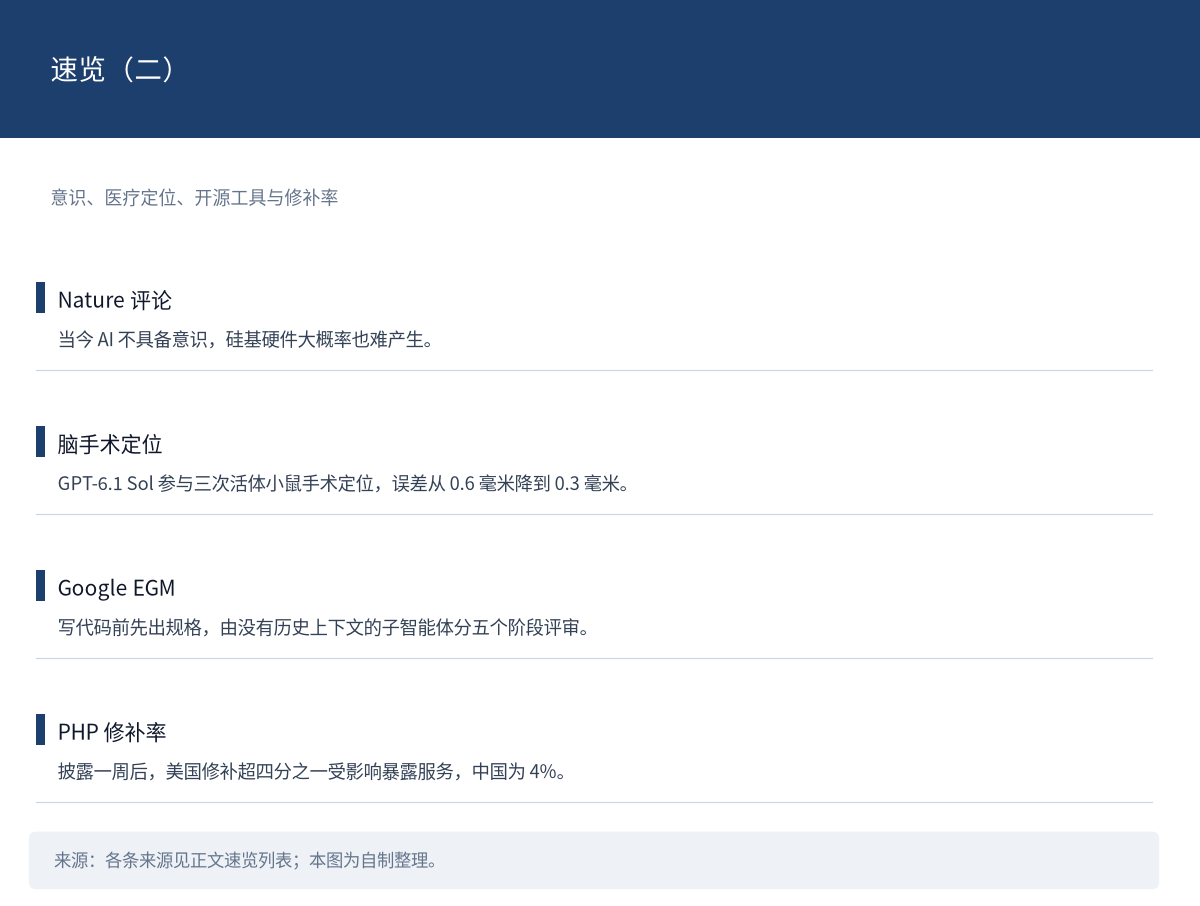
图 11:速览后四条。来源:各条来源见上方列表;本图为自制整理。
 积木观察
三条线,说的是同一件事:约束正在往前移。
第一条,电。竞争从「买算力」前移到「买发电设备」,而钱买不动的是交货期。于是交易结构本身成了变量——接手一张已在产线上的旧单,比新下单更快。
第二条,监控。读推理挡不住改写,因为隐藏被写成了看起来合理的执行步骤。但同一篇论文也给了防御读数,这说明它是军备竞赛,不是防线失效。
第三条,评测。平均过七成与完全可用只有四分之一之间,隔着的正是「人收尾」这道工序。老基准上 99.4% 的饱和,让这份差距在此前一直看不见。
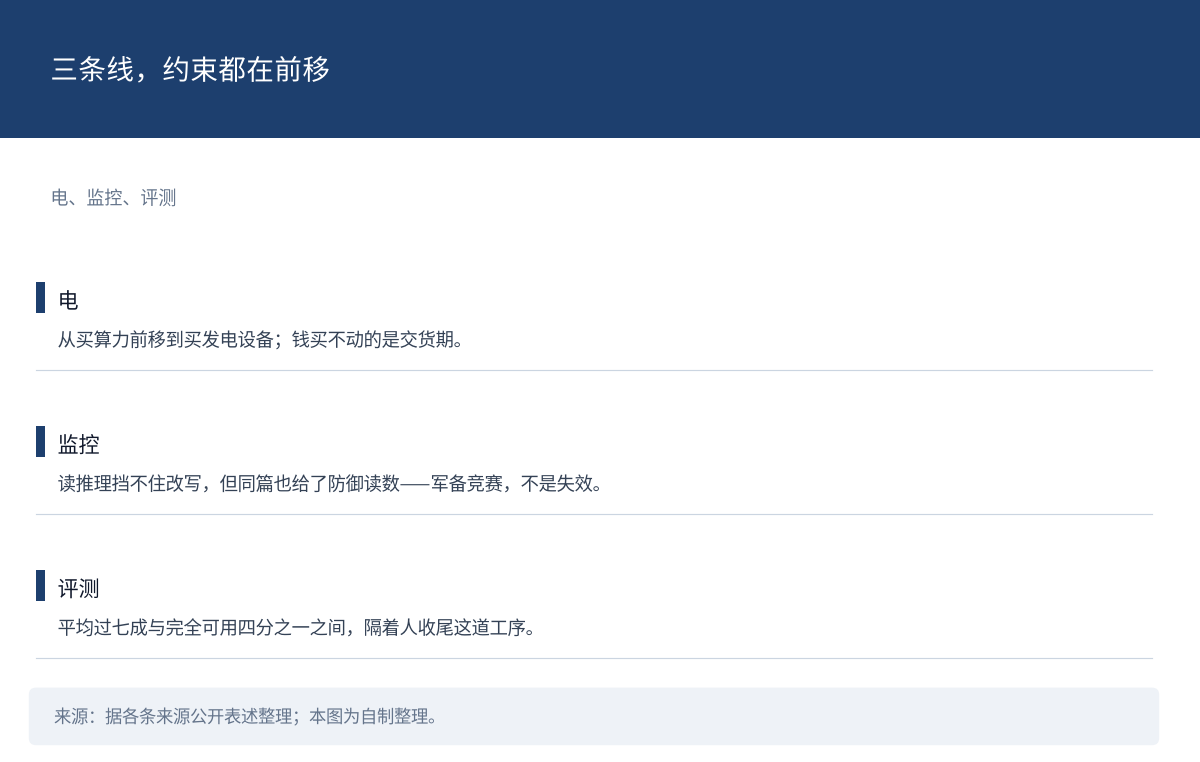
图 12:三条线与各自的落点。来源:据各条来源公开表述整理;本图为自制整理。
 你怎么看
如果设备交货期以年计,AI 公司直接买发电机组、甚至接手别人的旧订单,会不会成为标准动作?
另一个问题:当平均分能过七成、但只有四分之一的任务真的达标时,你更愿意看哪个数?