AI 日报 | 英伟达董事会启动独立调查,黄仁勋承认婚外情
11 月 8 日(美东),英伟达董事会宣布,就媒体关于 CEO 黄仁勋被外国情报行动瞄准的报道启动独立调查。同日,公司公开了黄仁勋致全体员工的信,他在信中承认与 Megaspeed 前高管 Alice Huang 有婚外情并致歉。
两件事发生在同一个公告周期里,分量却不同。调查是董事会的动作,婚外情是 CEO 的自述,而「被情报机构招募」这一层,目前仍只有匿名信源。
把这三层分开,是读这条新闻的前提。
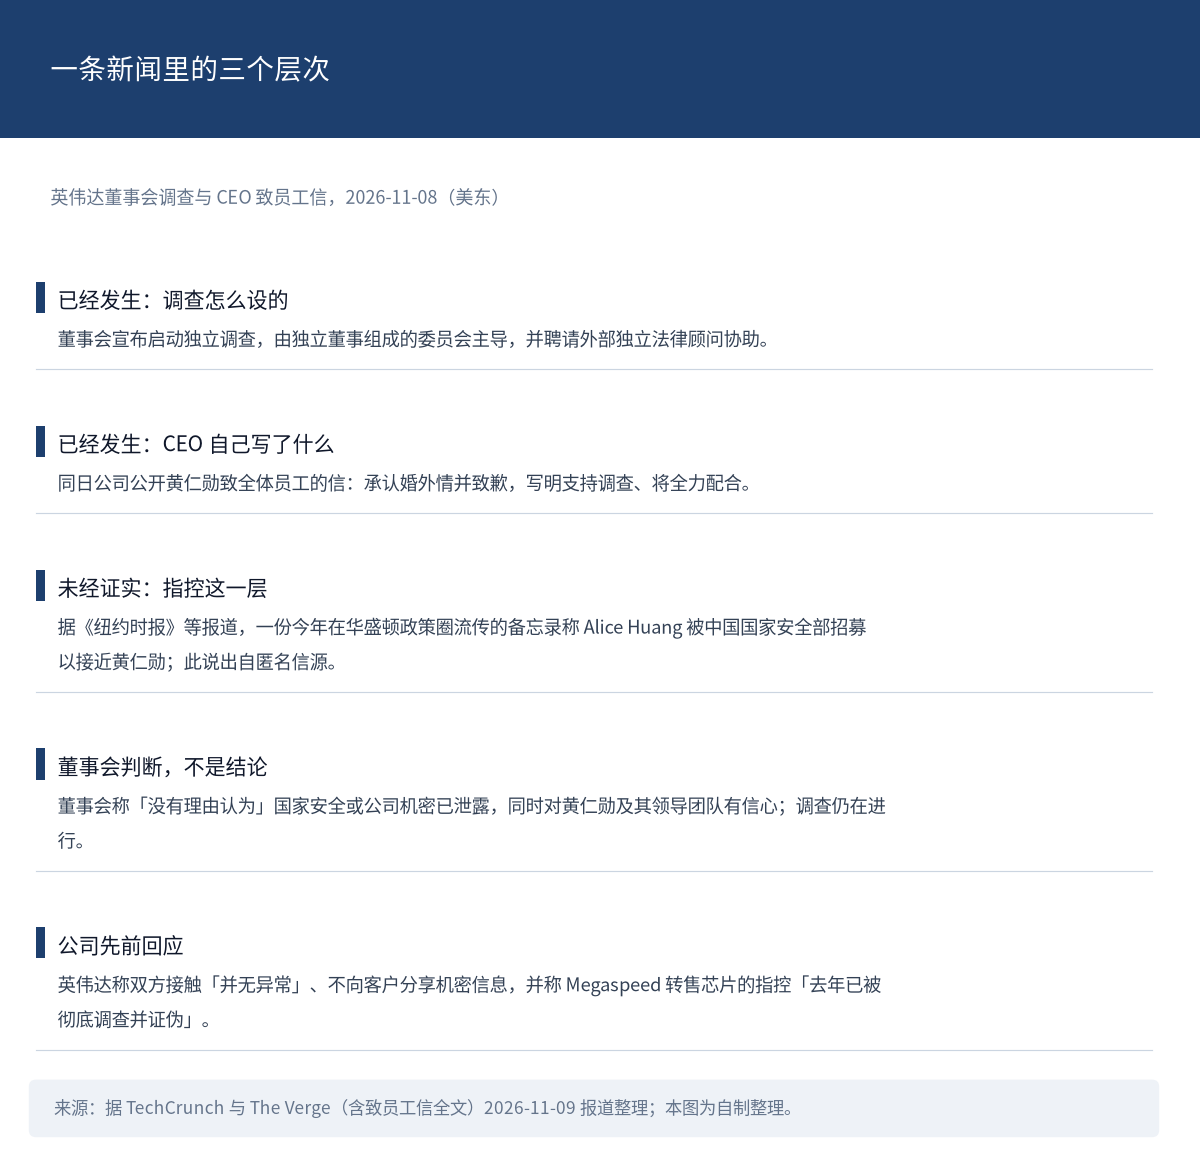
图 1:一条新闻里的三个层次。来源:据 TechCrunch 与 The Verge 2026-11-09 报道整理;本图为自制整理。
 头条深读 | 董事会查的是关系,不是指控
调查怎么设的,比「启动调查」四个字更具体。董事会说,调查由独立董事组成的委员会主导,并聘请外部独立法律顾问协助。
这个组合的含义是:结论会以董事会名义落纸,而不只是管理层的内部复核。
董事会同时表态,称「没有理由认为」国家安全或公司机密已被泄露,并对黄仁勋及其领导团队有信心;黄仁勋「完全支持」这项调查并将配合。
这句话是调查启动时的表态,不是调查结论。调查仍在进行,结论未出。
黄仁勋本人的信写得比公告直白。他写「我对妻子不忠」「没有任何借口」「我辜负了这份责任」;关于调查,他写「关于新闻报道中提出的国家安全关切,NVIDIA 董事会已启动独立调查。我支持这项调查,并将全力配合」。
这封信由英伟达公开,The Verge 刊出了全文。
指控这一层要单独放。据《纽约时报》等报道,一份今年在华盛顿政策圈流传的备忘录称,Alice Huang 被中国国家安全部招募,以接近黄仁勋、获取英伟达的计划与游说信息。
这仍是匿名信源的说法,未经证实。英伟达此前的回应是:双方接触「并无异常」,公司不向客户分享机密信息;关于 Megaspeed 转售芯片的指控,「去年已被彻底调查并证伪」。
头衔的写法需要统一。TechCrunch 称 Alice Huang 为 Megaspeed 前高管,部分聚合转述写作「高管」;正式报道用的是前者。
金额也要看清是谁的账。「自 2024 年 6 月以来采购超 48 亿美元英伟达芯片」是买方的采购额,不是英伟达的收入,也不是本季业绩。
政策线此前已有动作。11 月 5 日,美国众议院外交事务委员会、中国问题特别委员会与常设情报特别委员会三位主席联名致函黄仁勋,要求他就与 Alice Huang 的往来出席联合闭门简报;问询清单里还包括「英伟达针对外国对手间谍活动的安全协议」。
影响落在三处。
治理层,独立董事加外部律师的组合,会让机构投资者把「黄仁勋能否留任」当成需要重新定价的变量。
政策层,指控的落点是芯片去向与游说,与美国对华出口管制的审查口径直接相关。
供应链层,云客户与代工伙伴的合规审查会更紧;但董事会明说「没有理由认为」泄密,短期内不构成供货中断的理由。
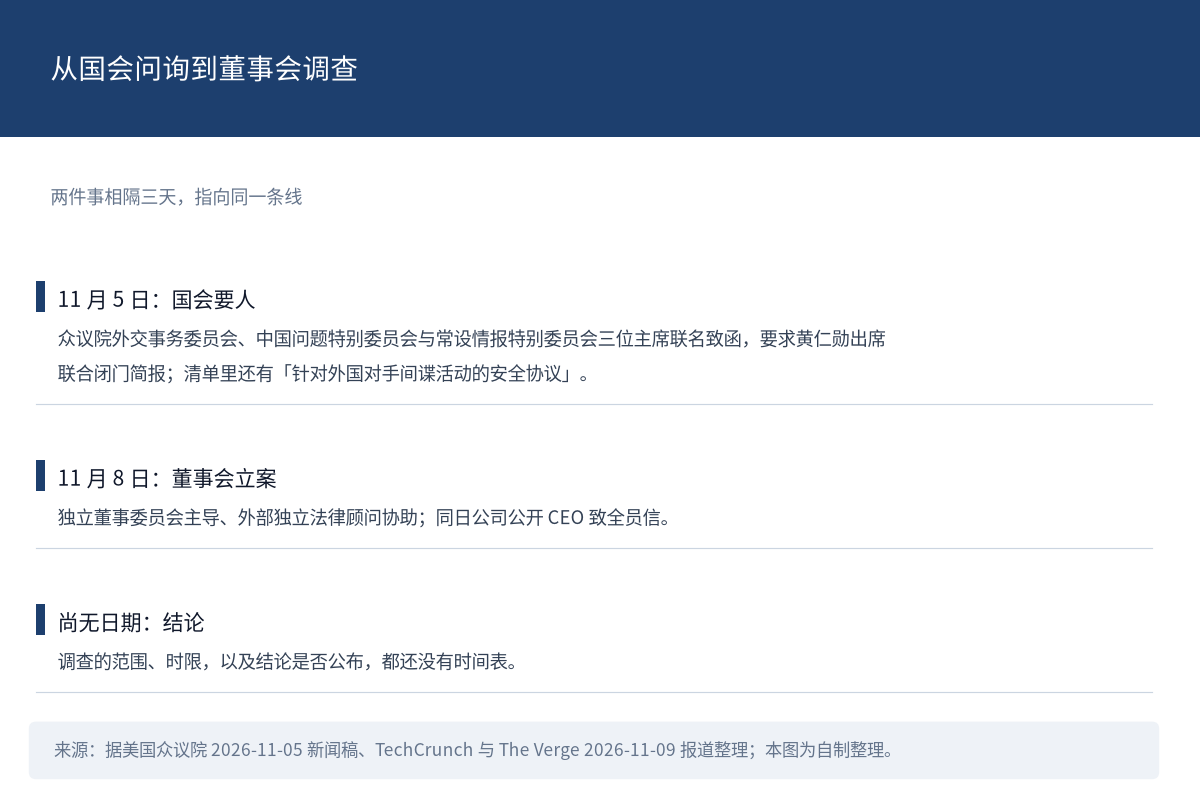
图 2:从国会问询到董事会调查。来源:据美国众议院 2026-11-05 新闻稿、TechCrunch 与 The Verge 2026-11-09 报道整理;本图为自制整理。
 重点速递
腾讯元器停服,数据导出到 2027 年 1 月 9 日
腾讯元器在 11 月 9 日停止服务。面向公众的功能全部关闭:应用访问、数据读写、API 调用、控制台使用都不再可用;此前通过元器发布到公众号、服务号、微信客服等渠道的智能体,也不再响应用户对话。
时间线有四个点。10 月 29 日起,平台已停止创建新智能体与分发 API Key。11 月 9 日,全部公众服务关闭。2027 年 1 月 9 日之后,不再受理数据导出申请。此后,除法律法规要求留存的日志等记录外,官方将删除全部用户数据。
第三、四个点连起来看,数据有硬截止日:要留档,窗口到 2027 年 1 月 9 日为止。
钱的安排是退款,不是补偿。曾通过旧版元器入口在腾讯云官网购买资源包、且到停服日仍有未用完资源或余额的,可在腾讯云官网申请退款。
官方给的替代路径有两条:腾讯云智能体开发平台(ADP),与公众号侧的智能回复。
这是一次平台级退出,不是产品改名。对已在元器上跑业务的开发者,影响是「智能体停止应答」与「数据有截止日」两件事同时发生;对生态,是腾讯把智能体入口收拢到 ADP 与公众号侧。
截至发稿,存量用户数、智能体数量与迁移人数均未见公开信息。细节据 IT之家 2026-11-09 报道,腾讯官方公告页截至发稿未见原文。
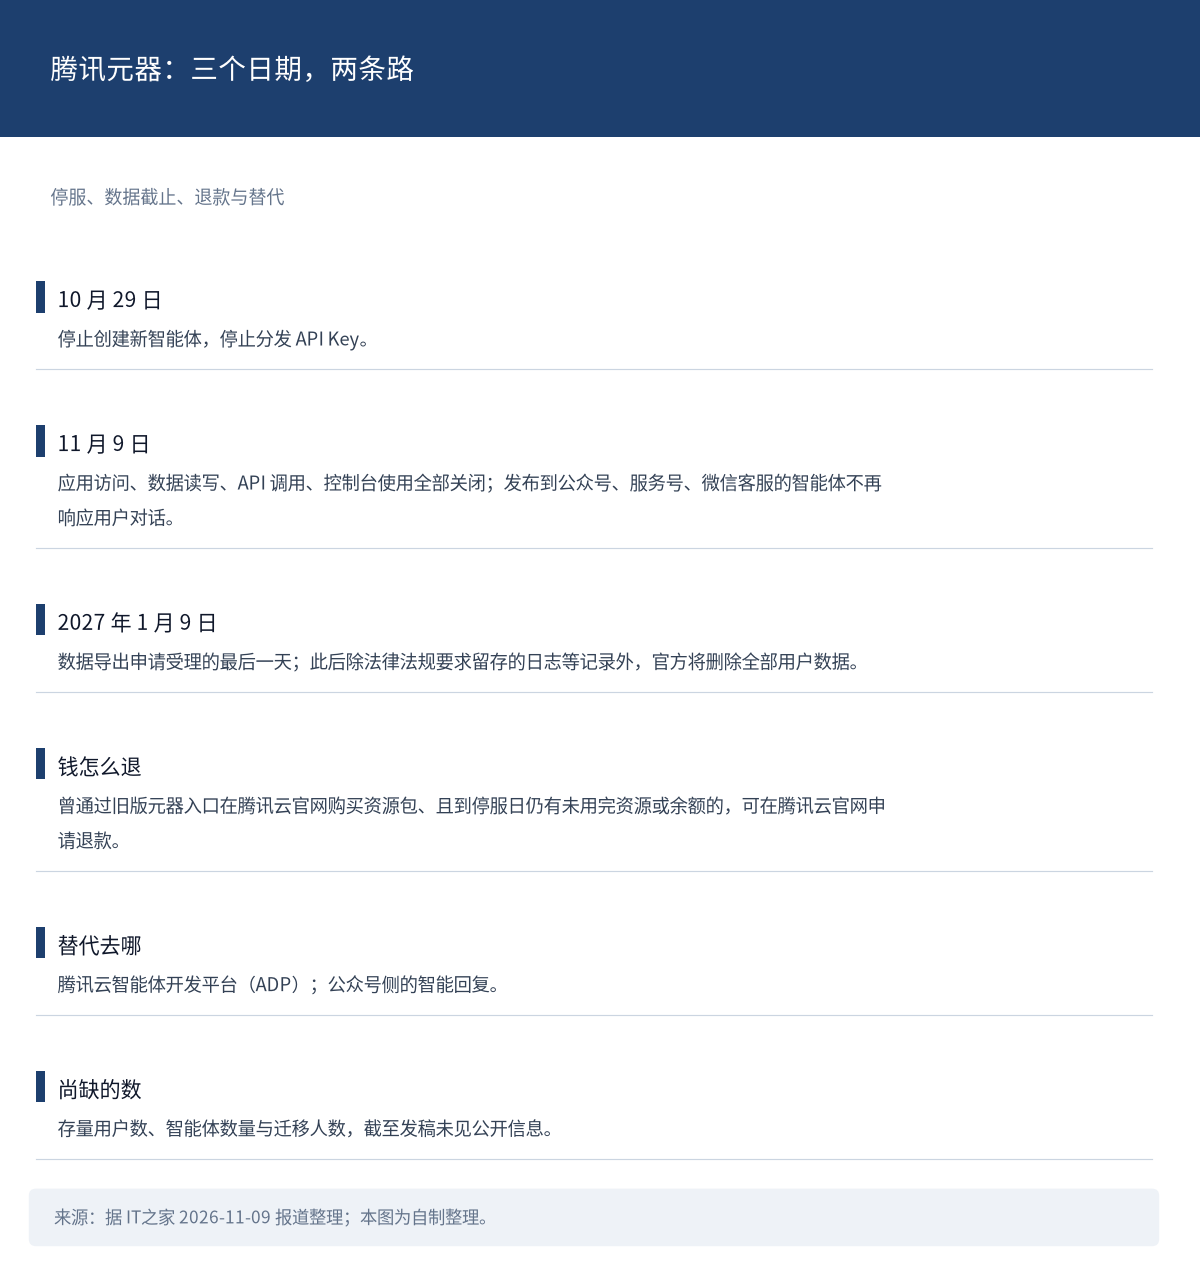
图 3:三个日期与两条迁移路径。来源:据 IT之家 2026-11-09 报道整理;本图为自制整理。
AA 决策指数改版,分数开始奖励「承认不确定」
Artificial Analysis 在 11 月 8 日发布 Decision Index v2。改版有两处结构性变化:私有数据集的权重从 25% 提到 45%;头号指标换成同时奖励正确率与置信度校准的 Decision Score。
指数由六项构成,权重合计 100%。前两项是 AA-Paperclip 30% 与 AA-Symmetry 15%。
中间三项各占 15%,分别是 AA-Omniscience-Decision v1.1、HLE-MultiChoice v1.1 与 EvalSafe-O*NET-AA。末位是 When2Call(NVIDIA)10%。
WildGuardTest 因饱和被移除。
其中两项是新增的。AA-Paperclip 用 1,500 份私有文档——简历、收据、发票、AI/ML 论文;每份文档出 5 个决策任务与 10 个事实抽取,15 项全对才算通过。
EvalSafe-O*NET-AA 同为新增项。When2Call 的权重从 25% 降到 10%。
评分公式可以自己算。单题得分是 50 ×(1 + c −(p − c)²),其中 p 是模型给所选答案的概率,c 是答对与否(对为 1)。整轮等价于 50 ×(1 + 准确率 − Brier 分数)。
这个形式决定了排序:准确率相同的两个模型,谁给的概率更接近实际结果,谁的分更高。这条改版等于把「敢不敢说自己不确定」计进了分数。
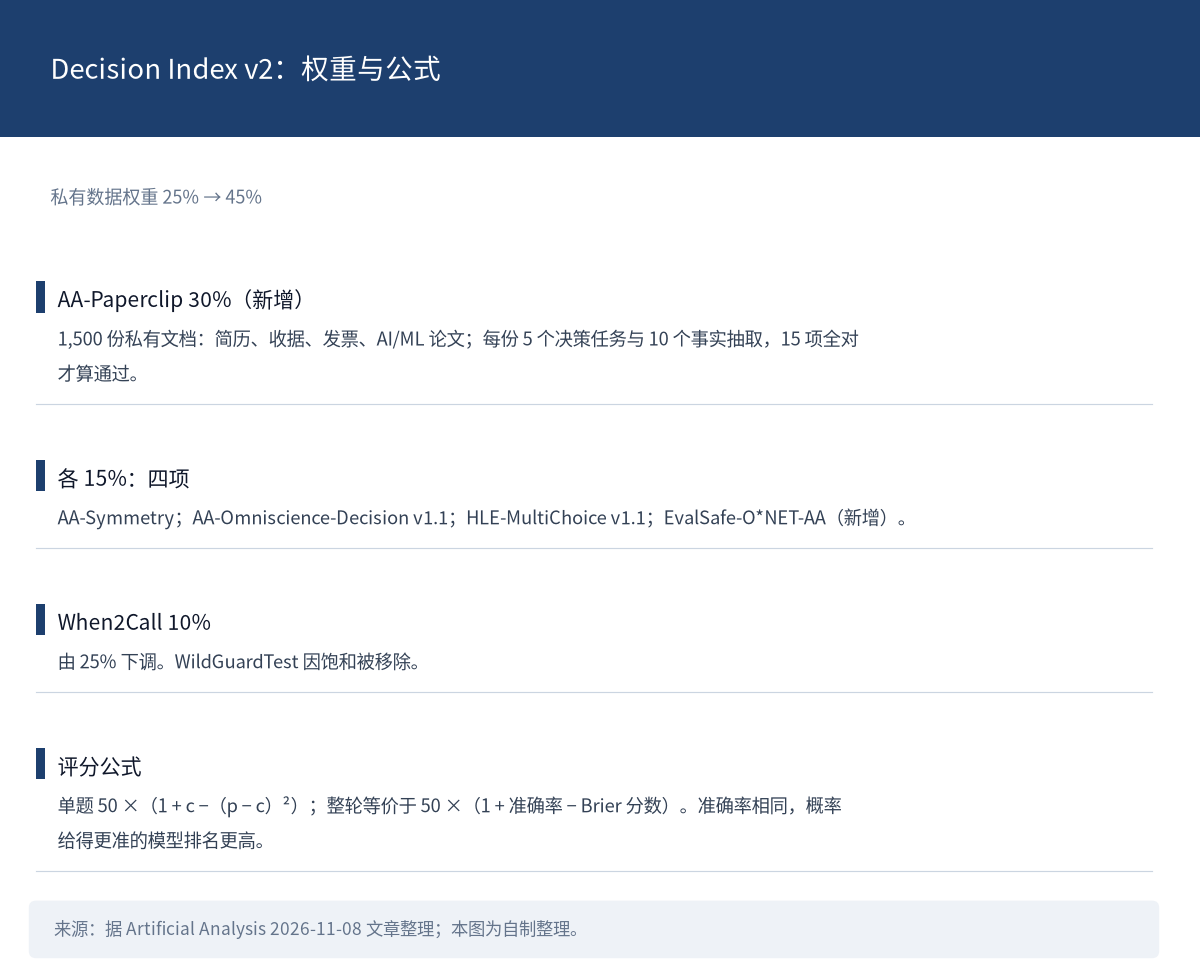
图 4:六项权重与一条评分公式。来源:据 Artificial Analysis 2026-11-08 文章整理;本图为自制整理。
榜面读数分两组。决策模型里,Drex Max v1.1(Nace AI)73、GLiDE v1.2(Fastino Labs)73、Mammoth 27B 72,前三名相差 1 分以内。
语言模型在同一指数上的读数是另一组:Max 档的 Claude Haiku 5.5 得 77、GPT-6 Luna 得 76。
两组不能拼成一张榜。文章写明,语言模型是在更高的成本与更慢的速度下取得这个分数;同一篇文章里,GPT-6 Luna 在决策模型组的读数是 62。
成本分布比分数分布宽得多。按 AA 的折算,每 100 万任务,Celeris-1.1 Decision 是 14 美元,Claude Haiku 5.5 的 Max 档是 6,240 美元。
两者相除,6,240 ÷ 14 ≈ 446 倍。即使在决策模型组内部,成本也拉开到数十倍。
这个「每 100 万任务」是 AA 的折算口径,不是 API 单价。它把 token 消耗与调用次数一起算了进去,不能拿去与报价单逐项比对。
成本差有机制解释。多数决策模型按「一份文档计一次输入」,而 GLiDE v1.2 与 Decider Flash v1.2 每道题都重算一次输入。
一份 AA-Paperclip 任务约 63k 输入 token,Drex Max v1.1 约 9k。同样的题,喂进去的量不同。
用时也一并给出:Celeris-1.1 Decision 每任务 56 毫秒,Drex Max v1.1 275 毫秒,GPT-6 Luna 11.34 秒。
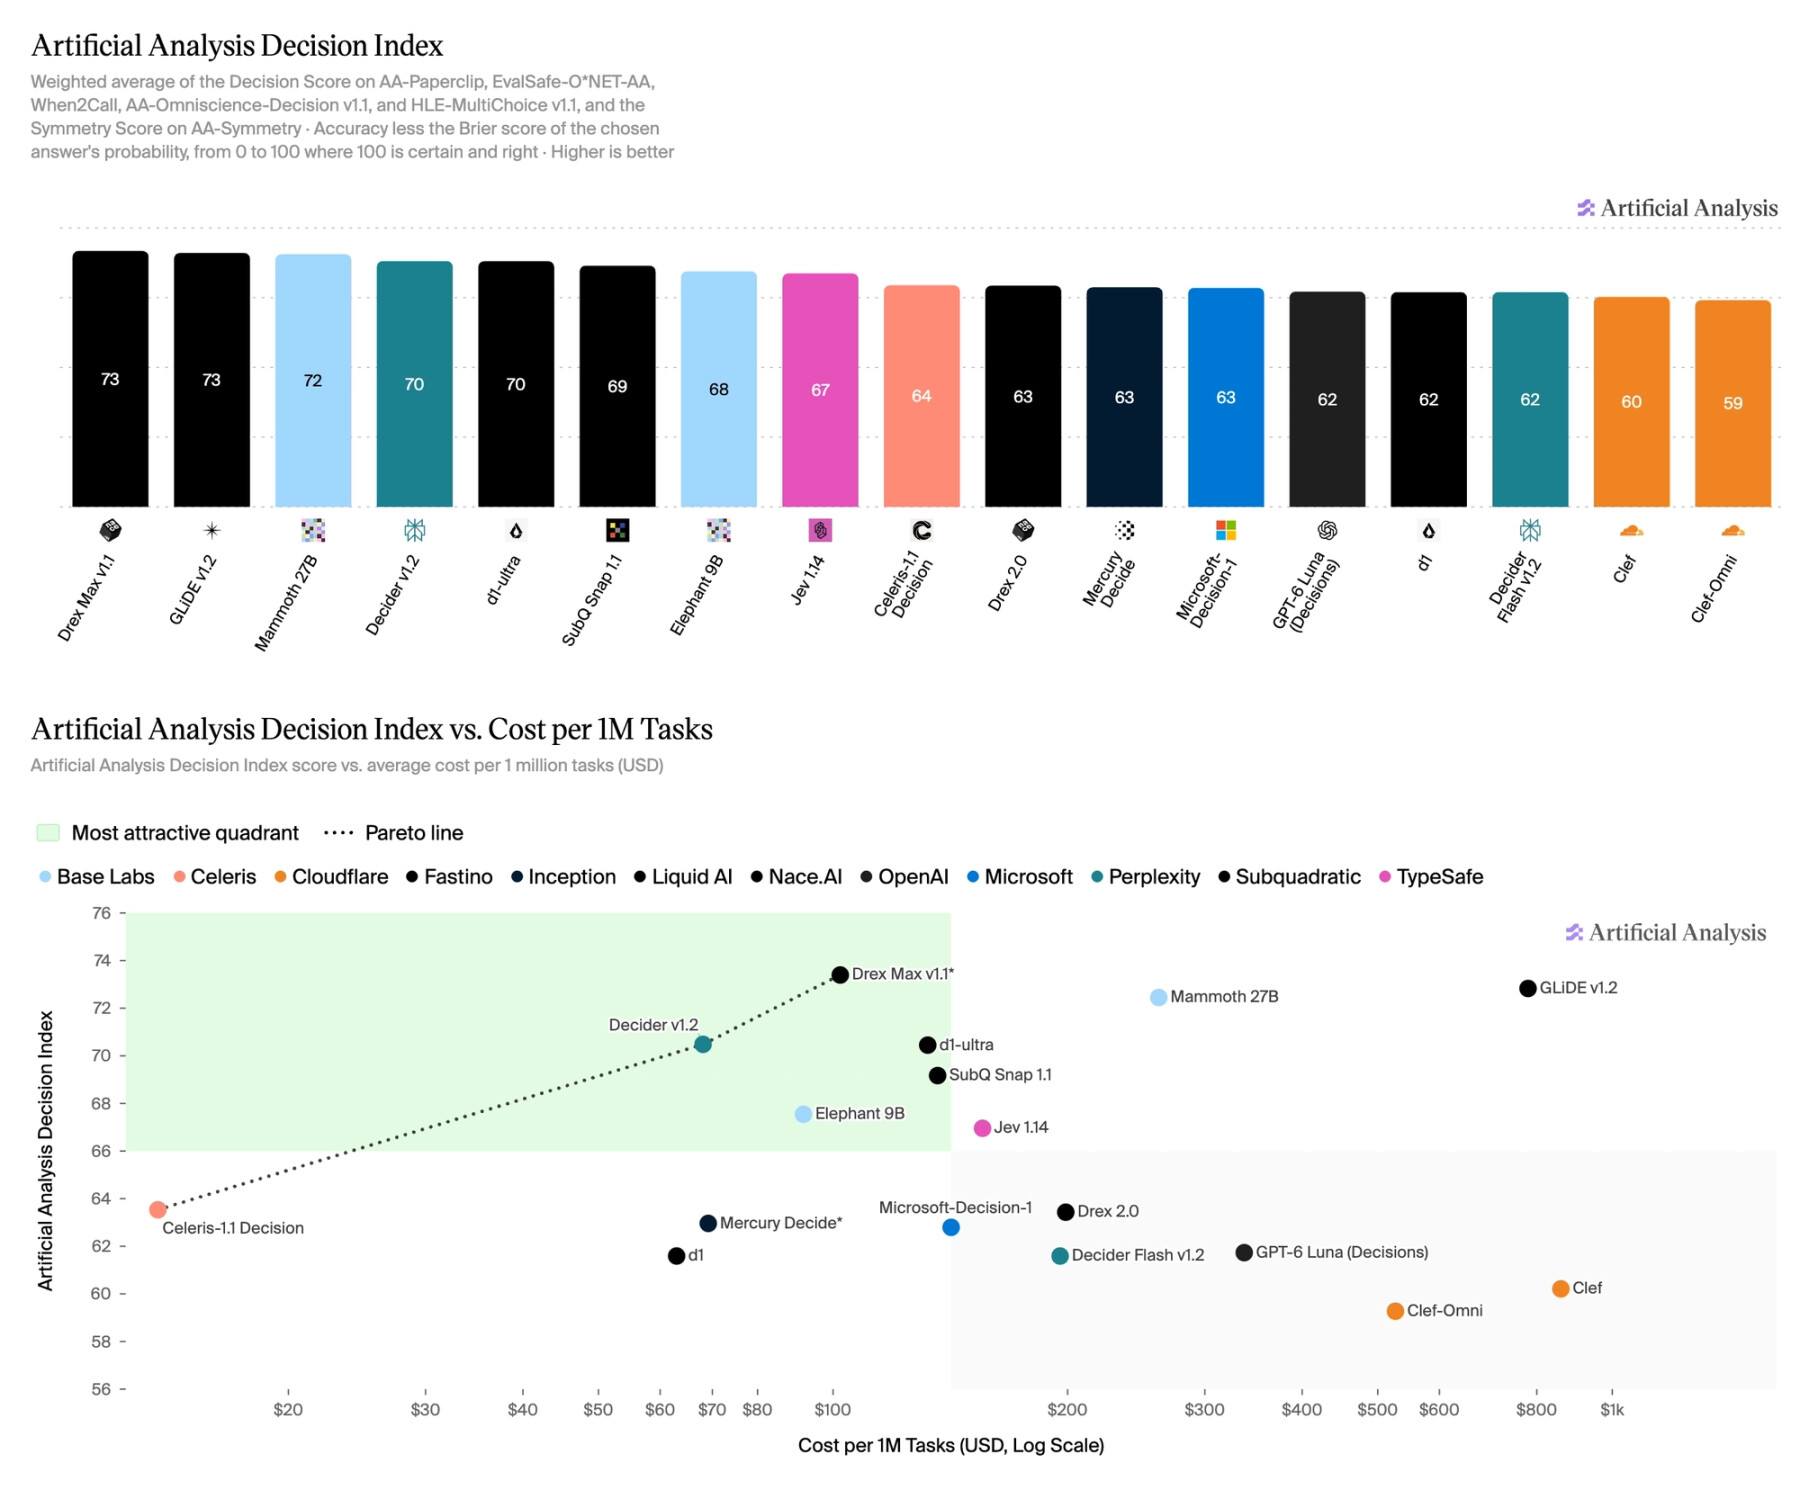
图 5:上为 17 款决策模型的指数,下为指数与每 100 万任务成本的对数散点(含 Pareto 线)。来源:Artificial Analysis 官方图表,非第三方实测;截至发稿该页未见开放许可声明。
校准这一层看 Brier 分。17 款决策模型的 Brier 在 0.16 到 0.26 之间,越低越好。0.16 这一档有四款并列:Elephant 9B、Clef-Omni、Drex Max v1.1、Drex 2.0。
最高的是 Mercury Decide 的 0.26。
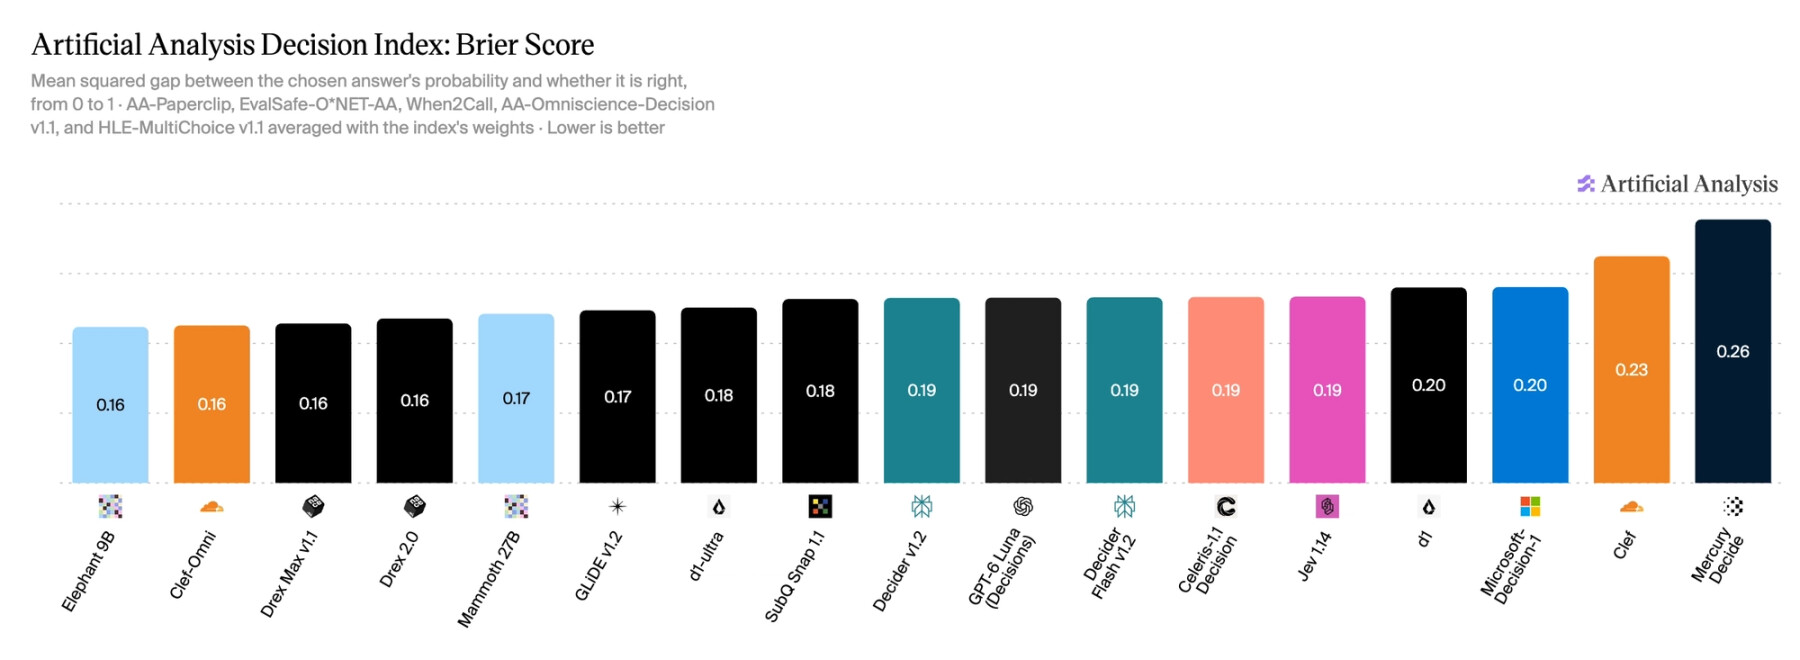
图 6:17 款决策模型的 Brier 分数,0.16 到 0.26,越低越好。来源:Artificial Analysis 官方图表,非第三方实测。
一致性另有一项 AA-Symmetry:120 道基础题、共 440 个变体,测同义改写后答案与概率是否稳定。Mammoth 27B 得 96、Elephant 9B 得 93,最低的 Clef 是 56。
读这一项要注意,文章解释 Mammoth 27B 的高分部分来自更高的弃答率——一致性高,不等于答得准。
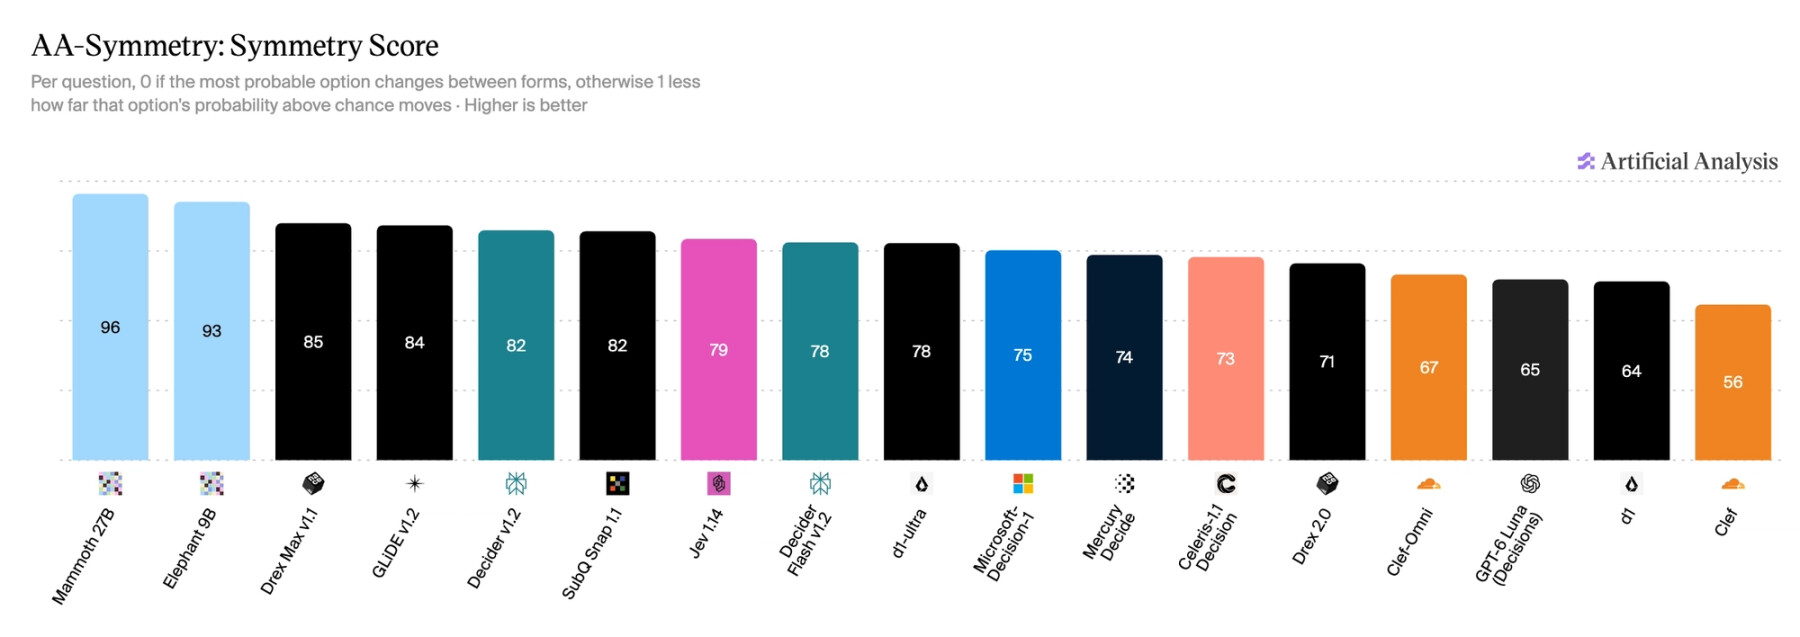
图 7:17 款决策模型的 AA-Symmetry 分数,96 到 56。来源:Artificial Analysis 官方图表,非第三方实测。
选型上真正该看的是两件事:每任务成本,以及校准。榜首三款分差 1 分以内,成本却相差数十倍;在准确率接近时,多付的那部分钱买的是概率估计本身。
45% 这个权重指向防刷榜的意图。文章的原话是 guard against benchmark gaming,落点在意图与设计。
Siri 的三个时点:先管自己的应用,再管别人的
据彭博 Mark Gurman,苹果 CEO John Ternus 正施压 AI 负责人 Craig Federighi 加快 Siri 的路线图。这条报道给出三个时点,不是一次能力跃迁。
第一层是管好自己的应用。Siri 将获得对苹果第一方应用的细粒度控制,例如在照片里旋转、裁剪图片,整理 Safari 的标签页,预计随 iOS 27.3 到位。
第二层是管别人的应用。接入第三方应用后,可以通过 Grubhub 下单、通过 OpenTable 订餐;Gurman 说这一步可能在春季落地,报道给出的时点只到季节。
第三层是自己找事做。苹果希望 Siri 从一次性指令走向能跟踪目标、判断下一步、持续执行的任务型代理;Gurman 写的是「我相信公司最早明年能让 Siri 更像一个代理」。这是记者的判断,不是苹果公布的时间表。
压力来源被指向对手。报道提到 OpenAI 的 Dots、Meta 的 Muse 与 Grok 这类已能持续跟踪目标的助手,并称苹果内部「不幻想自己跟得上对手」。
三层压成一句「Siri 明年变成 AI 代理」,会让读者高估近期可用性:第一层是控制已有应用,第二层才涉及外部服务,第三层连时间表都没有公布。
报道的信源只有 Gurman 一人;苹果侧截至发稿未见公告。上述内容据 The Verge 2026-11-09 转引彭博的报道。
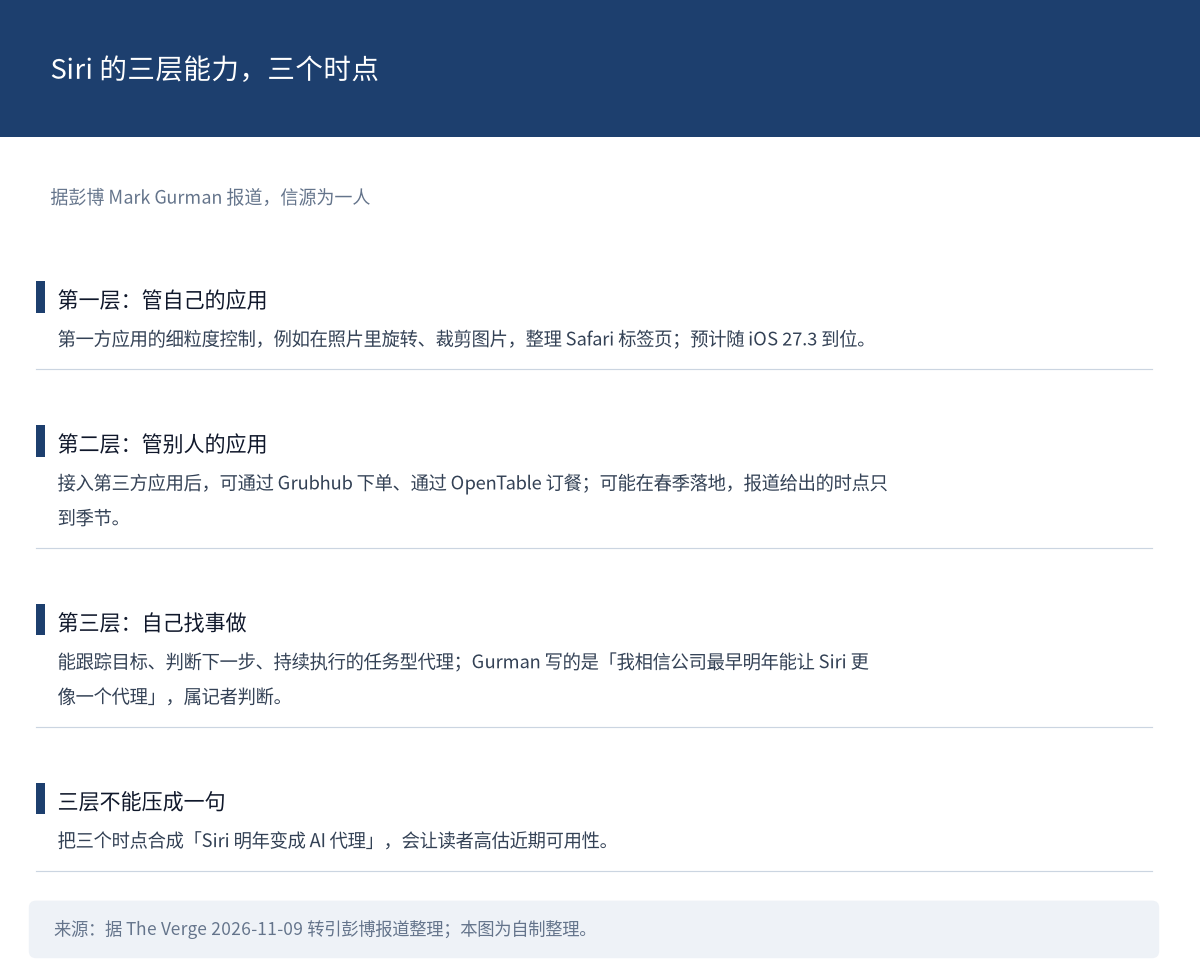
图 8:Siri 的三层能力与三个时点。来源:据 The Verge 2026-11-09 转引彭博 Mark Gurman 报道整理;本图为自制整理。
两条评测论文:一边把题改难,一边查出题错了
同一天出现两条方向相反的评测消息,说的都是基准本身。
第一条来自斯坦福与 Google DeepMind,方法名 TURTLE。它不新造任务,而是用 AlphaEvolve 去变异 AppWorld 等静态基准里现成的任务。
三类变异是:加入过滤条件、增加额外步骤、把关键查询藏起来。改造后的任务要求仍然可解,避免变成无解的题。
动机是基准饱和。分数一旦被刷满,榜单就拉不开差距;这条路线把「出题」交给模型与搜索。
第二条来自 Amazon 的一篇论文。它审计了 9 个用于评测税务、法律与商业规则处理的政策类决策基准,发现其中不少「正确答案」被自己的参考答案或评分代码判错——错在基准侧,不在模型侧。
两条合起来读,指向同一件事:读单榜分数时,题的质量与判分的质量都要先过一遍。
这一节的内容据聚合转述;两篇论文的编号、任务规模与量化结果不在转述之中。
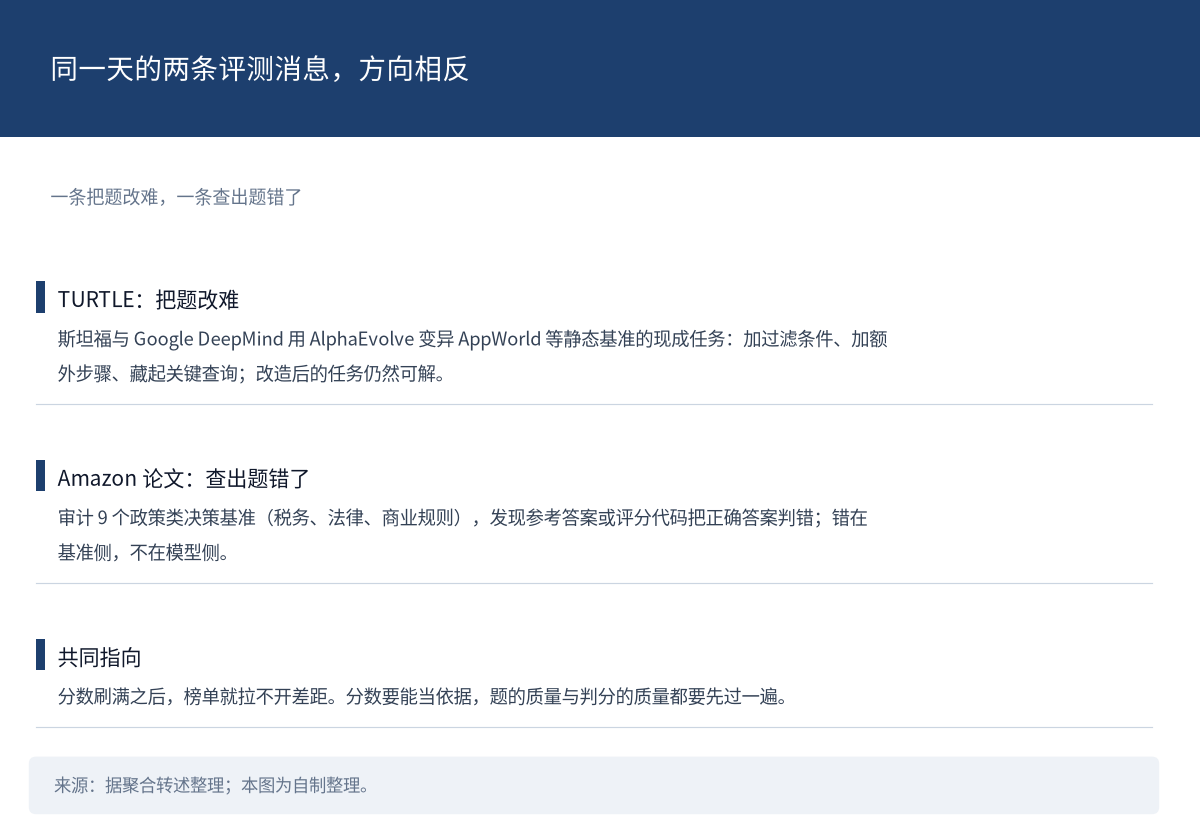
图 9:两条相反的路线。来源:据聚合转述整理;本图为自制整理。
 快讯速览
- 清华与 Moonshot 发布 TCSExam:100 道专家评审任务,由 Lean 内核或任务检查器验证;GPT-6 Astra 的证明率 70.0%,分母是这 100 道题,而不是 30 个公开猜想。
- 这批题里没有解开任何一个公开猜想。
- DeepSeek 开源智能体应用 Harness 日活 154 万:据 Bloomberg,上线不到 3 个月,统计范围是官方 API 用户,7 日均值自 27.1 万增至 154 万。
两条均据转述;论文编号与 Bloomberg 原文页不在转述之中。
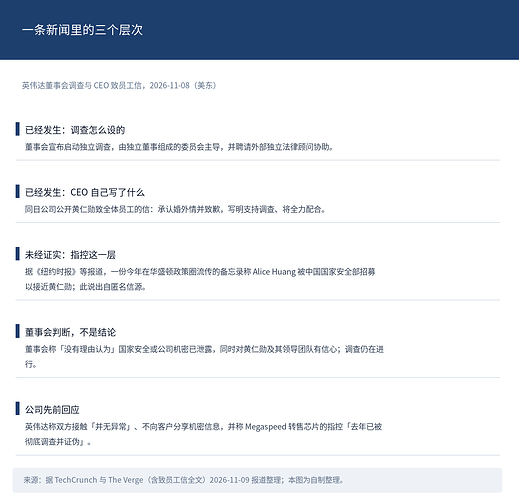
图 10:速览两条与它们的统计口径。来源:据转述整理;本图为自制整理。
 积木观察
三件事,说的都是谁来定标准。
第一件,治理。董事会用独立董事加外部律师来查 CEO 的关系,结论会以董事会名义落纸。当一家公司的芯片去向牵动出口管制时,治理程序本身就成了对外说明的一部分。
第二件,平台。腾讯元器停服,用户要带走的是数据与迁移时间表;2027 年 1 月 9 日这个日期,比停服本身更有约束力。
第三件,评测。AA 把校准计进分数,TURTLE 把出题交给模型,Amazon 去查题本身错没错——三条都在处理同一个问题:分数还能不能当依据。
图 11:三条线与各自的落点。来源:据各条来源公开表述整理;本图为自制整理。
 你怎么看
如果一家公司的 CEO 被匿名备忘录指控,而董事会说「没有理由认为」泄密,你会等调查结论,还是先看它接下来的采购与供货动作?
另一个问题:当榜首三款模型分差 1 分以内、成本相差数十倍,你选型时先看哪个数?