 阿里 Qwen 团队 8 月 26 日开源 Qwen3.8-Flash-Next:125B 总参数、每个 Token 仅激活 6B,以约 1/9 的 Qwen3.7-Plus 训练成本跑赢上一代多项基准,是下一代 Qwen4 架构的公开预览。
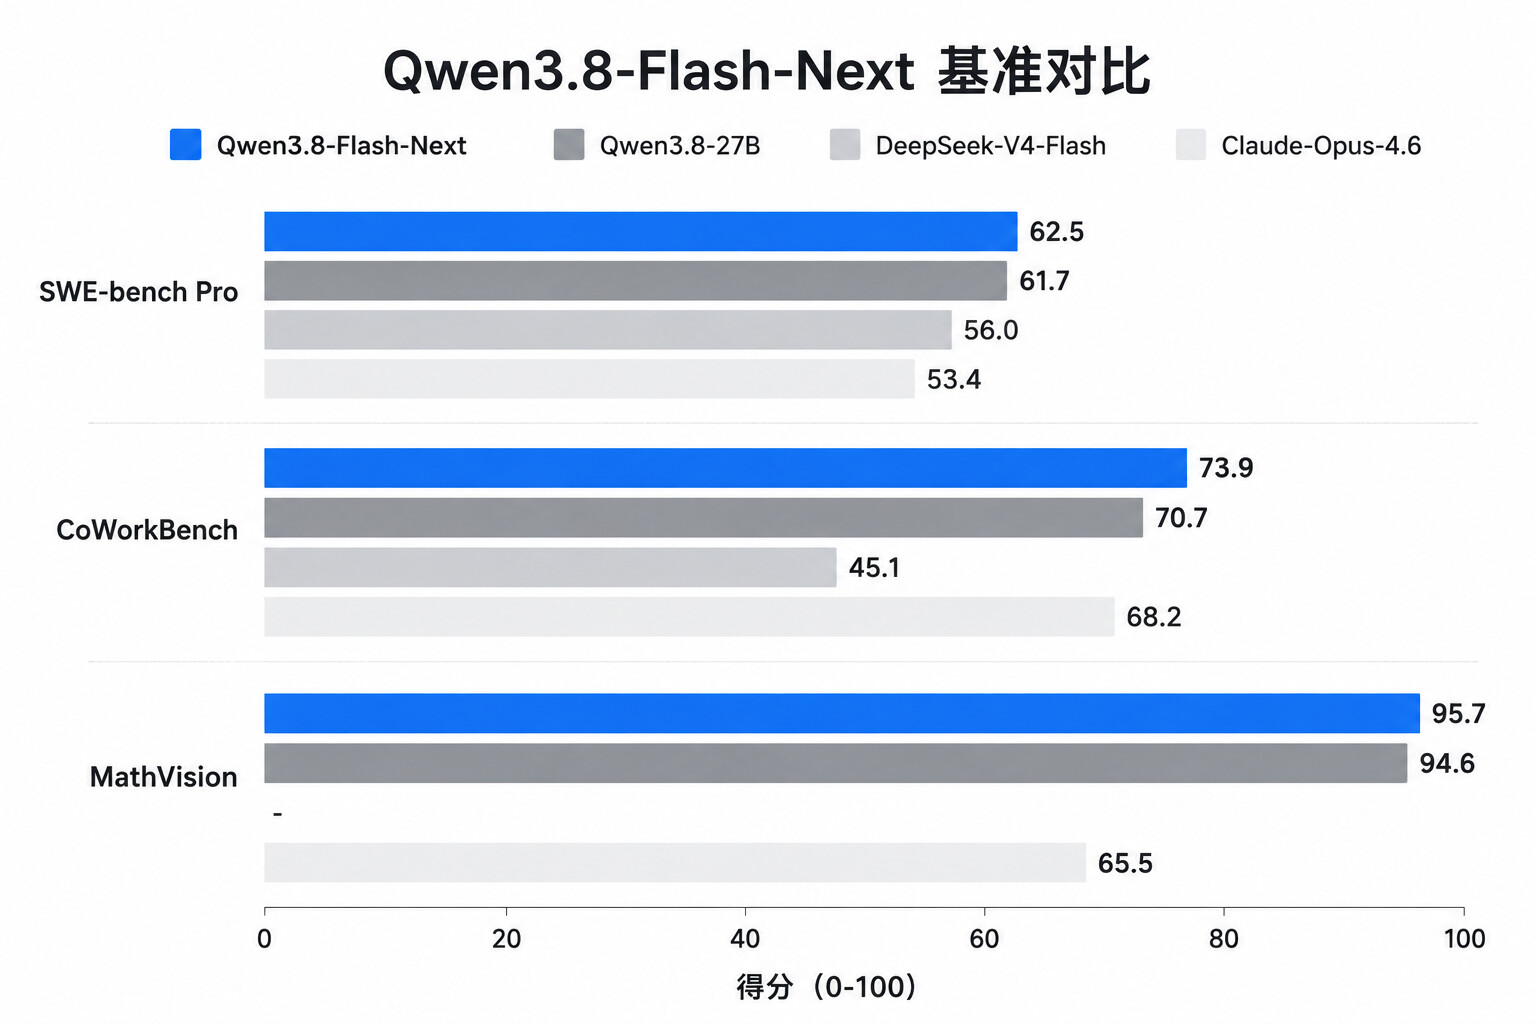
这是千问首次把「下一代的架构」提前拿出来给社区玩——不是发布一个新旗舰,而是把 Qwen4 的技术路线做了一次可落地的预演。
关键细节
-
架构换新,省到极致:Gated DeltaNet + Qwen 稀疏注意力(QSA,微块级选择替代逐 token 选择,大幅降低长上下文延迟)、Gated Residual 残差门控、N-gram Embedding(新增 51B 参数仅用于索引,低成本扩展参数量)、Muon 优化器 + 精简训练配方(省去 batch-size warmup)。一句话:用更少的钱,跑出更高的分。
-
训练成本约为 Qwen3.7-Plus 的 1/9,能力反而全面反超:编码、办公 agent 任务均反超上一代,生产版 Qwen3.8-Flash 即将上线 QwenCloud API。
-
超长上下文:原生 262K 上下文,经 YaRN 可扩展到 1M;这是首个采用该架构的开源权重发布。
参数 / 性能对比
| 项 | Qwen3.8-Flash-Next | Qwen3.8-27B | Qwen3.7-Plus | DeepSeek-V4-Flash-0731 | Claude-Opus-4.6(Max) |
|---|---|---|---|---|---|
| 总参数 | 125B(+51B n-gram+4B MTP) | 27B | 397B | 284B | 未公开 |
| 激活参数/Token | 6B | 27B | 17B | 13B | — |
| DeepSWE 1.1(编码) | 58.7 | 42.2 | 16.5 | 54.4 | — |
| SWE-bench Pro | 62.5 | 61.7 | 55.8 | 56.0 | 53.4 |
| SWE-bench 多语言 | 81.0 | 73.8 | 75.8 | — | 77.5 |
| CoWorkBench(办公 agent) | 73.9 | 70.7 | 65.1 | 45.1 | 68.2 |
| JobBench | 55.7 | 33.4 | 27.6 | 41.3 | 36.6 |
| AndroidWorld(多模态) | 84.5 | 81.9 | 81.0 | — | 62.0 |
| MathVision (with CI) | 95.7 | 94.6 | 88.7 | — | 65.5 |
| RealWorldQA | 88.5 | 85.9 | 86.9 | — | 73.9 |
| HLE(推理) | 35.9 | 30.8 | 34.7 | 33.8 | 40.0 |
(加粗为该行最佳;数据来自官方 model card,Claude 用官方公布值)
价格对比
| 模型 | 输入 /M token | 输出 /M token |
|---|---|---|
| Qwen3.8-Flash(生产版,即将上线) | $0.16 | $0.47 |
| Qwen3.8-Max(旗舰,已上线) | $2.00 | $6.00 |
Qwen3.8-Flash 价格约为旗舰 Qwen3.8-Max 的 1/12(输入)/ 1/13(输出),主打极致成本效率。横向看,它与同月智谱 GLM-5.3-Flash($0.15/$0.50,9/9 前半价 $0.075/$0.25)构成国产 Flash 级模型的正面对垒——两家都在把「1M 上下文 + 多模态 + 低价开源」往下沉。
影响评估
国内开源模型在「成本效率」维度再下一城:6B 激活即可对打海外闭源旗舰,1M 上下文 + 多模态 + 极低价格的组合,将显著降低自主部署与 API 调用成本,加速开源生态在 agent、办公、长文档场景的落地。Qwen4 架构提前定调,QSA 稀疏注意力有望成为下一代长上下文模型的标配。
来源
- 官方 model card:https://huggingface.co/Qwen/Qwen3.8-Flash-Next
- 官方博客:https://qwen.ai/blog?id=qwen3.8-flash-next
- 官方技术报告:GitHub - QwenLM/Qwen3.8-Flash-Next: Qwen3.8-Flash-Next is the foundation model developed by Qwen Team, Alibaba Group. · GitHub
- 路透:https://whbl.com/2026/08/26/alibabas-qwen-launches-qwen3-8-flash-ai-model-with-lower-training-costs/
- Hacker News 讨论:https://news.ycombinator.com/item?id=49448210