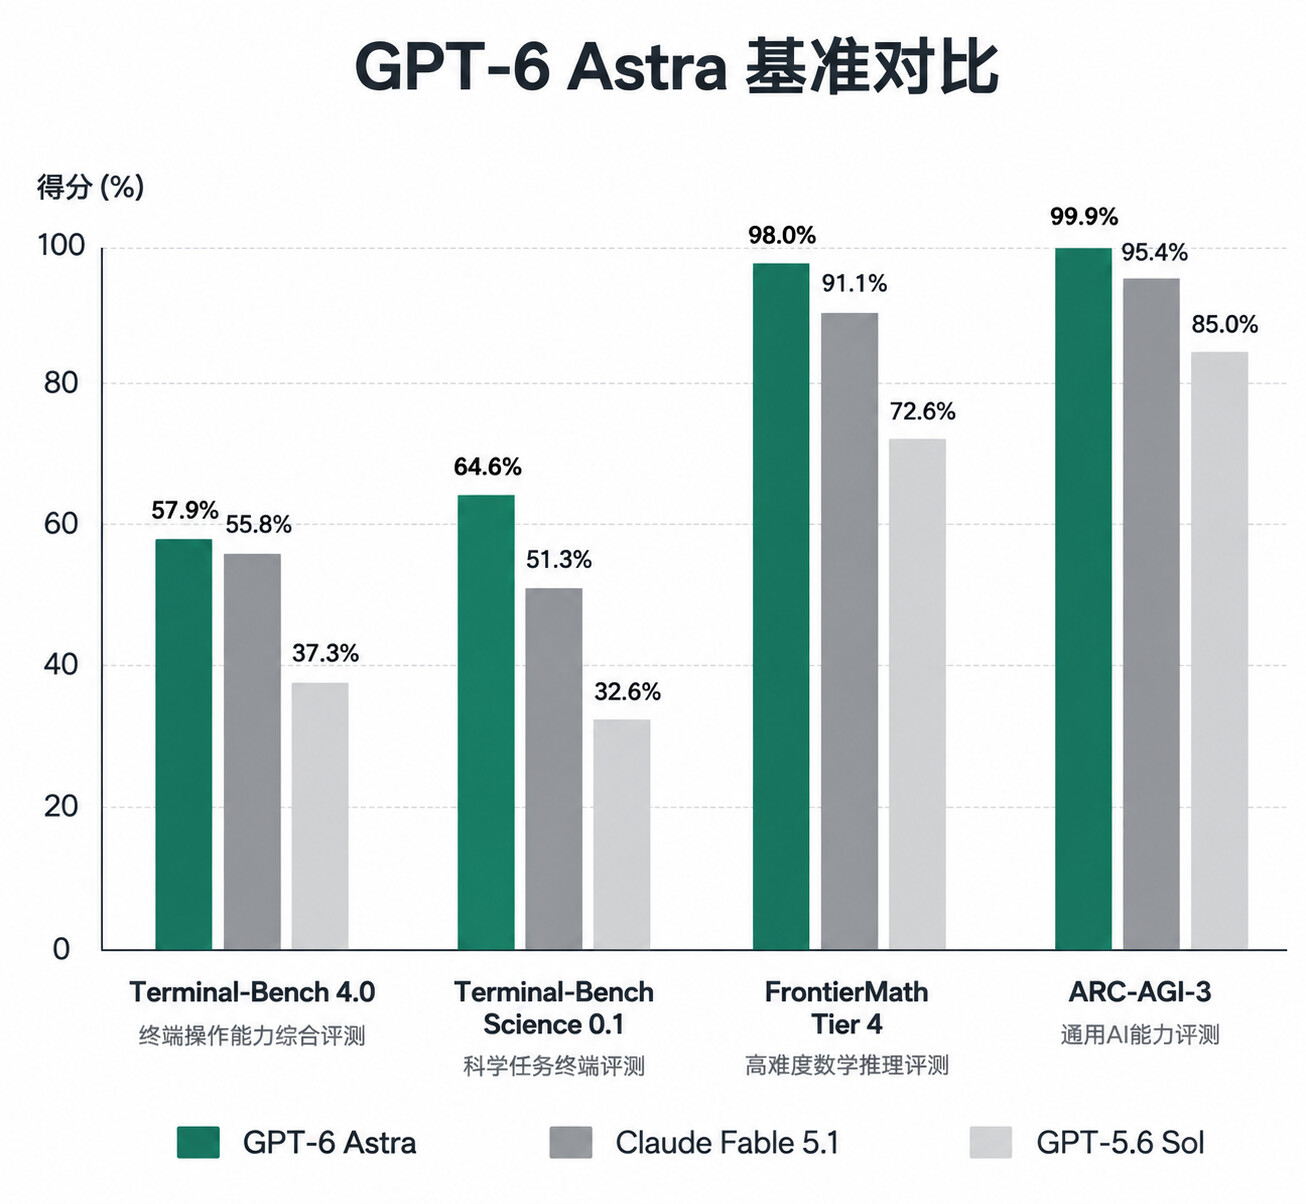
 OpenAI 9 月 3 日发布 GPT-6 Astra(代号 Astra),声称「世界最智能、最对齐的模型」:Terminal-Bench 4.0 达 58.2%(Fable 5.1 57.9%、GPT-5.6 Sol 37.3%),FrontierMath Tier 4 饱和 98%,ARC-AGI-3 饱和 99.9%,ExploitBench 100% 饱和。
背景脉络
GPT-6 Astra 是 OpenAI 自 2025 年 GPT-5 系列以来的首次大版本换代。就在发布前两天(9/1),OpenAI 主动披露了 Astra 的内部安全评估,坦诚其是首个达到「Critical 网络安全能力阈值」的模型——可自主发现未知漏洞、跨多系统无需人工指导。这份安全坦诚加上随后的正式发布,标志着 OpenAI 在「能力」与「安全」之间踩出了一条新路。分阶段推出(Daybreak 先行 → ChatGPT Plus/Pro/API 随后),意味着普通用户还需要等几天才能上手。
 核心亮点
- 科学推理与数学全面领先,编码微弱领先:Terminal-Bench 4.0 58.2%(Fable 5.1 57.9%、GPT-5.6 Sol 37.3%),Terminal-Bench Science 0.1 64.6%,ExploitBench 100% 饱和。
- 两项基准直接饱和:FrontierMath Tier 4 98%、ARC-AGI-3 99.9%,意味着这两个测试已无法区分 Astra 与更高能力——「基准测试不够用」的时代来了。
- Computer Use 与 Browsing 首次成为宣传核心:Agent 全面取代纯聊天成为新范式。
- 安全对齐双突破:首个 Critical 级网安能力公开模型,经强化保护后发布,同时称其为「最对齐的模型」。
 官方 Benchmark
| 基准 | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0(编码) | 58.2% | 37.3% | 57.9% |
| Terminal-Bench Science 0.1 | 64.6% | — | — |
| FrontierMath Tier 4(数学) | 98%(饱和) | — | — |
| ARC-AGI-3(推理) | 99.9%(饱和) | — | — |
| ExploitBench(网络安全) | 100%(饱和) | — | — |
数据来自 OpenAI 官方博客(9/3)。部分测试使用 Daybreak 较高权限访问能力,非默认产品版本。第三方独立评测尚待跟进。
 价格
| 模式 | 输入 /M token | 输出 /M token | 备注 |
|---|---|---|---|
| 标准(short context) | $10 | $50 | 与 Fable 5.1 标价相同 |
| Fast 模式 | $5 | $25 | 低 effort 档 |
| Daybreak 模式 | $20 | $100 | 高 effort 档 |
| Long context | $20 | $75 | 长上下文 |
 辩证评估
机会:Astra 在编码(Terminal-Bench 与 Fable 5.1 差距仅 0.3pt(误差区间重叠))、科学推理、数学和推理基准上全面领先,对 Fable 5.1 仅微弱领先(0.3pt,误差区间重叠)——真正的领先在科学推理和数学基准。Computer Use 和 Browsing 能力首次成为发布核心,Agent 范式进一步确立。
反向视角:Astra 与 Fable 5.1 标价相同($10/$50),但独立 benchmark 显示编码仅微弱领先(0.3pt,误差重叠)。两项基准已饱和,意味着 Astra 在这些维度的真正能力上限已无法测量。分阶段推出意味着普通用户短期内无法直接体验和评测。
 已知 vs 待验证
已知:
- 官方 benchmark 数据(OpenAI 博客,一手)
- Critical 级网安能力(OpenAI 安全评估,9/1)
- 分阶段推出路径(Daybreak → Plus/Pro/API)
待验证:
- 第三方独立评测(尚无)
- 实际 API 定价与上下文窗口
- 默认产品版本(非 Daybreak)的实际性能
- 与 Fable 5.1 同任务横向对比
 选型建议
 编码/科学推理/数学任务:Astra 全面领先,值得优先尝试
 成本敏感场景:标价相同,选型取决于实际 workload 的 token 消耗和 cache 命中率
 急需上手的个人用户:分阶段推出,目前 Daybreak 仅限有限组织
来源
官方来源:
- 官方博客:https://openai.com/index/gpt-6-astra/
- 安全评估:https://openai.com/index/path-to-astra/
- 官方 X 推文:https://x.com/OpenAI/status/2095595757072191802
- ChatGPT Release Notes:https://help.openai.com/en/articles/6825453-chatgpt-release-notes
独立来源: